Esta publicación es una adaptación de una presentación de Kevin Reedy, de Belly Card, en nginx.conf en octubre de 2014. Aunque fue hace un par de años, el contenido sigue siendo muy relevante hoy en día. Puedes ver una grabación de la presentación en YouTube.
Índice
0:00 Introducción Resumen Aviso legal1:16 ¿Qué es Belly? La pila tecnológica de Belly1:44 Versión 0: La Edad Oscura2:04 Versión 1: Una nueva esperanza2:35 Versión 2: Página de inicio y API separadas Palabra de moda del día: ¡arquitectura orientada a servicios! Habilitar la SOA NGINX sustituye a ELB Configuración de servidores ascendentes y virtuales Resultados4:43 Configuración con Chef Recetas Archivos Plantillas Libros de recetas6:49 Ejemplo: Chef para NGINX Instalación, configuración y optimización Enrutamiento del tráfico de la API9:46 Ejemplo real de Chef10:08 Versión 2: Despliegue de aplicaciones10:40 Versión 3: SOA para todo Entonces llegó Heartbleed SSL para todo12:25 Versión 4: Docker Ventajas Despliegue de contenedores15:45 Estrategias de despliegue17:43 Opciones de descubrimiento de servicios18:33 Arquitectura de Consul19:30 Funcionalidades de Consul22:07 Consul Template Comando para iniciar Consul Template Configuración de NGINX con Consul Template Gestión de la configuración con Consul Template24:35 Uso de Chef para desplegar Consul25:44 Consejos avanzados Búsqueda parcial de Chef DNS Cómo evitar configuraciones obsoletas30:35 Preguntas36:31 Información de contacto
0:00 Introducción
Buenos días a todos. Me llamo Kevin Reedy y trabajo para una empresa de Chicago llamada Belly Card. Tenemos unos cien empleados y veinte ingenieros. Hoy voy a hablaros de cómo gestionamos el balanceo de carga, concretamente en una infraestructura dinámica que cambia constantemente.
0:21 Descripción general
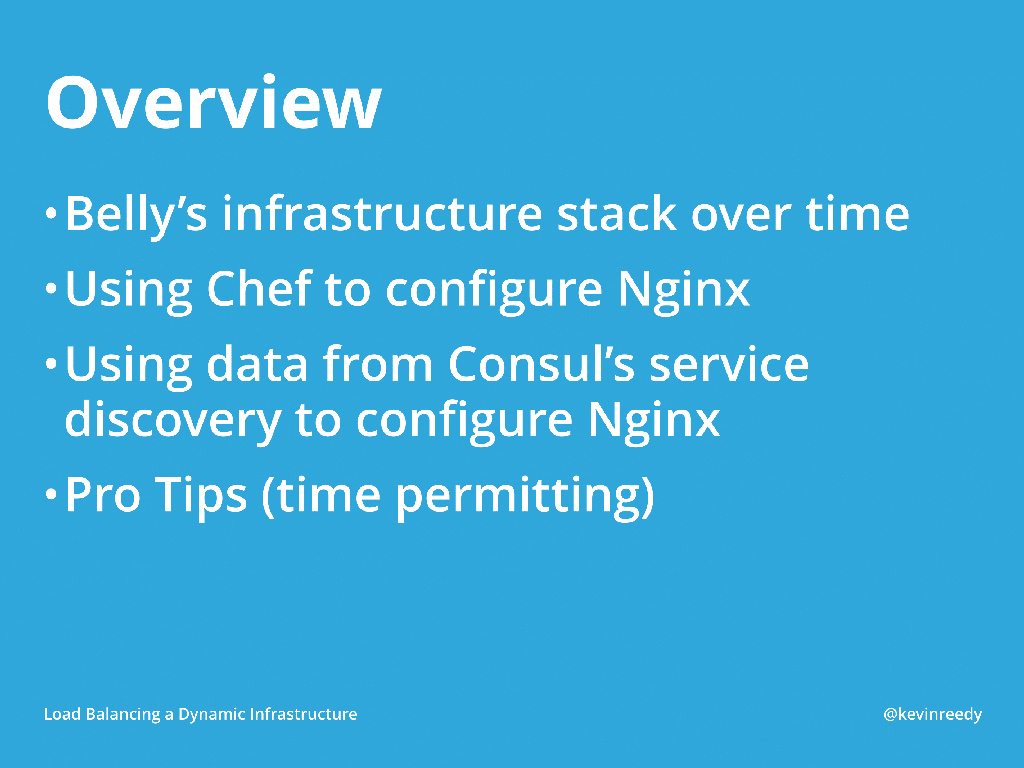
Primero voy a hablaros de cómo ha evolucionado nuestra pila de infraestructura, empezando por la versión 0, a la que llamo la Edad Oscura. Después veremos cómo utilizamos Chef para configurar NGINX. A continuación, hablaremos de cómo hemos dejado atrás ese enfoque para pasar a configurar NGINX con datos de una plataforma de descubrimiento de servicios llamada Consul. Si el tiempo lo permite, compartiré algunos consejos avanzados para configurar NGINX, especialmente en lo relativo a la gestión de la configuración.
0:49 Aviso legal
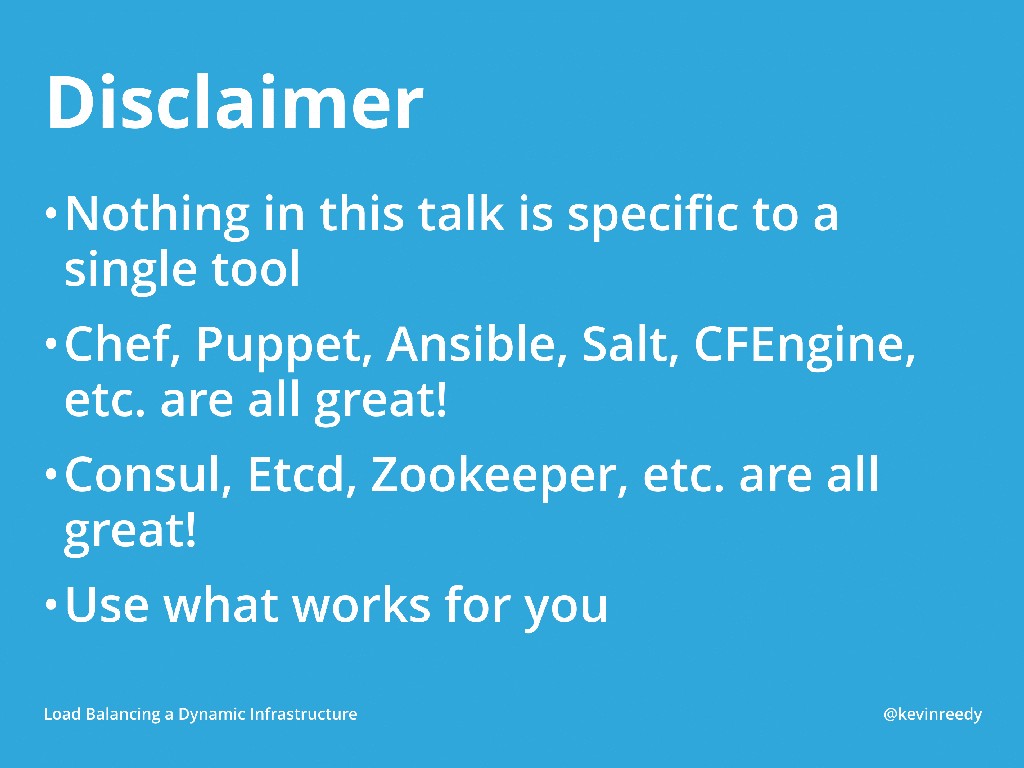
Así que, aunque voy a hablaros de Chef y Consul, quiero dejar claro que nada de lo expuesto en esta charla es específico de estas herramientas. Chef, Puppet, Ansible, Salt, CFEngine y todas las demás son productos excelentes, y deberíais utilizar alguno de ellos. A nosotros nos gusta Chef, y estoy seguro de que a muchas otras personas también.
Lo mismo ocurre con el descubrimiento de servicios. Consul, etcd y ZooKeeper son excelentes opciones, así que utiliza la que mejor te funcione.
1:16 ¿Qué es Belly?
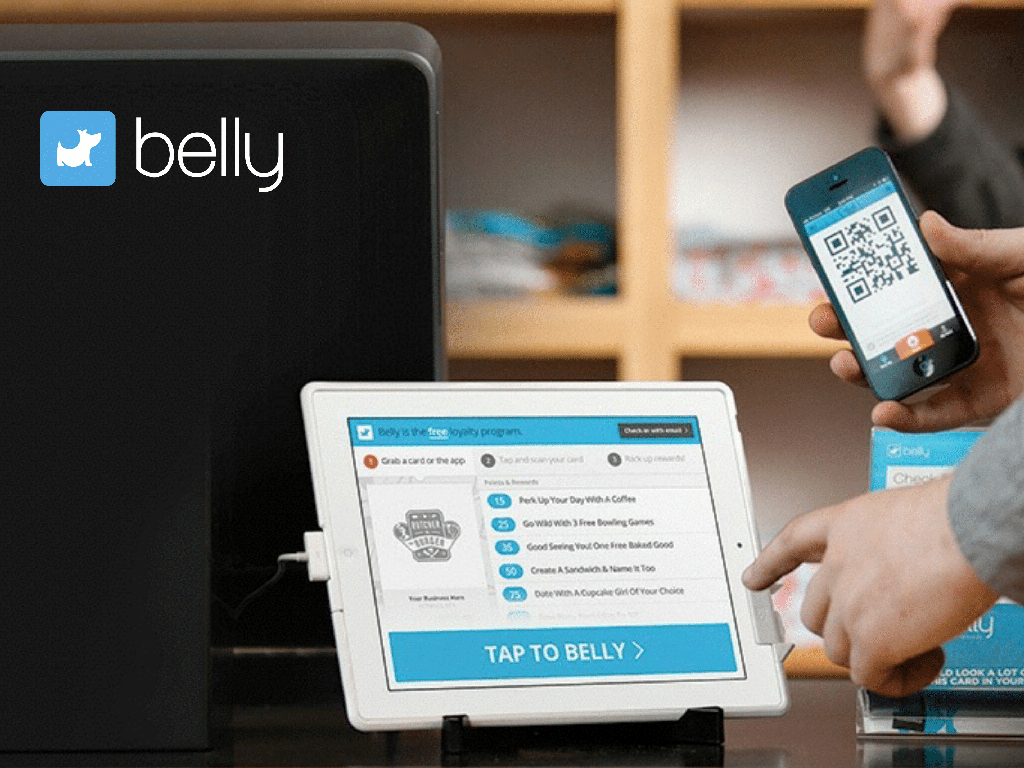
¿Qué es Belly? Básicamente, es el sustituto digital de la típica tarjeta de sellos de una cafetería, con la que compras diez bebidas y te regalan una. Instalamos un iPad en el establecimiento y los clientes escanean un código QR con su teléfono o con una tarjeta física. Nosotros registramos sus puntos, les damos las recompensas y, además, desarrollamos herramientas de marketing sobre esta base.
1:36 La pila tecnológica de Belly
Pero no estoy aquí para hablaros de belly como empresa. Si os interesa, podéis visitar nuestra página web. Voy a hablaros de nuestra infraestructura tecnológica.
1:44 Versión 0: La Edad Oscura
Empecemos por la versión 0. Cuando solo había tres desarrolladores y antes de que yo trabajara allí, Belly era una aplicación monolítica de Ruby on Rails, lo que significaba que todas las llamadas a la API y todas las partes de nuestro sitio web pasaban por una única aplicación Rails. Utilizaba MySQL, MongoDB y Memcached, y la desplegábamos en Heroku, que es un lugar estupendo para empezar.
2:04 Versión 1: Una nueva esperanza
Así que llegamos a la versión 1: Una nueva esperanza. Decidimos que Heroku ya no iba a satisfacer nuestras necesidades, así que empezamos a desplegar con una herramienta llamada Capistrano, que básicamente es «algo mejor que un script de shell» escrito en Ruby. Sirve para desplegar aplicaciones.
Teníamos unos seis servidores en Amazon Web Services EC2. Era una cantidad fija, pero la aumentábamos si sabíamos que iba a ocurrir algo importante y la volvíamos a reducir cuando era necesario. Delante teníamos AWS Elastic Load Balancer.
2:35 Versión 2: página de inicio y API separadas
Entonces surgió un proyecto en el que queríamos separar nuestra página de inicio del resto de la API. Queríamos hacerlo para poder avanzar más rápido con la página de inicio y que distintos desarrolladores trabajaran en ella.
2:47 Palabra de moda del día: ¡arquitectura orientada a servicios!
La gran palabra de moda de entonces —y que sigue siéndolo hoy— es la arquitectura orientada a servicios.
2:50 Implementar SOA
Así pues, la versión 2 de nuestra pila tecnológica tenía como objetivo permitir una arquitectura orientada a servicios. Nuestro primer plan consistía en separar la página de inicio de la API. Parece muy sencillo: solo tenemos www.bellycard.com y api.bellycard.com.
Pero resultó ser realmente complejo y nada sencillo, porque algunas de nuestras aplicaciones móviles estaban programadas de forma estática para utilizar www.bellycard.com/api y /api‑assets. Nuestros proveedores de correo electrónico y todos los enlaces de clic que ya se habían enviado por correo a los usuarios incluían /eo para «apertura de correo» y /ec para «clic en correo». Nuestra aplicación de Facebook estaba configurada para usar /facebook/callback.
3:28 NGINX sustituye a ELB
Eso significaba que AWS Elastic Load Balancer ya no nos ofrecía la flexibilidad que necesitábamos para dirigir este tráfico a distintas aplicaciones. Así que NGINX vino al rescate. En concreto, podíamos tener varios upstreams y reglas de reescritura para dirigir el tráfico a nuestras distintas aplicaciones.
3:44 Configuración de servidores upstream y virtuales
En este ejemplo tan básico, definimos un bloque upstream con seis servidores para la API y otro bloque con dos servidores para la página de inicio.
También hay dos bloques server [que definen servidores virtuales]. En uno escuchamos las solicitudes dirigidas a api.bellycard.com y enviamos todo ese tráfico a los servidores de la API. En el otro escuchamos en www.bellycard.com y dirigimos el tráfico según corresponda.
Resultados de las 4:02
Esto funcionó de maravilla. Permitió que nuestros desarrolladores avanzaran rápidamente. El equipo de frontend trabajaba en un proyecto sin verse bloqueado por nuestra API. Así que desplegamos un tercer servicio. Creo que era para la integración con Passbook de Apple. Después, un cuarto: trasladamos allí toda nuestra funcionalidad de Facebook. El quinto se encargaba de gestionar los eventos de los usuarios en nuestro sitio web.
Entonces, a alguien le pareció una idea estupenda escribirlo en Node.js, así que pasamos a tener cinco servicios distintos en dos lenguajes. Todos se desplegaban de forma independiente, sin apenas gestión de la configuración, y editábamos NGINX manualmente, que seguro que es como empieza mucha gente.
4:43 Configuración con Chef
Necesitábamos una forma mejor de ampliar este proceso, así que lo hicimos con Chef.
Chef es un conjunto de herramientas de gestión de la configuración. Está escrito en Ruby y permite escribir la propia gestión de la configuración en Ruby, por lo que resulta ideal para los desarrolladores. learnchef.com es un recurso fantástico para aprender sobre Chef; puede enseñarte mucho más sobre Chef de lo que yo podría en 45 minutos.
No obstante, repasaré algunos de los conceptos básicos para que todos estemos en la misma página.
Recetas de 5:17
El primer tipo de componente básico de Chef es una receta. Chef utiliza muchos nombres ingeniosos, como cuchillo para una herramienta y receta, y todo se guarda en un libro de cocina. Esto hace que resulte bastante divertido y fácil de entender, además de proporcionar una metáfora estupenda, pero también dificulta muchísimo buscar cualquier cosa en Google.
Esta es la receta más básica que se me ha ocurrido. Instala el paquete nginx e inicia y habilita el servicio nginx.
5:56 Archivos
También puedes tener recursos de archivo. Por ejemplo, quiero escribir el contenido «Hello World!» en el archivo /usr/share/NGINX/html/index.html.
6:08 Plantillas
También puedes integrarlo en un sistema de plantillas. Aquí tengo un par de variables, g y w, para Hello y Kevin, y puedo pasar estas variables a un archivo de plantilla en formato ERB (un script de plantillas de Ruby).
Así, en lugar de escribir el contenido manualmente, podemos crear una plantilla que indique qué leer y a quién saludar.
6:19 Recetarios
El último componente fundamental es un cookbook, es decir, una colección de recetas, archivos y plantillas. También incluye recursos, proveedores y bibliotecas, que son elementos más complejos. Hay multitud de cookbooks de código abierto y de otros tipos en https://supermarket.getchef.com, incluidos algunos para NGINX, MySQL, Java, apt y yum, e incluso para gestionar los archivos ssh_known_hosts. Prácticamente todos los componentes fundamentales que necesitas para la gestión de la configuración ya están disponibles en algún cookbook.
6:49 Ejemplo: Chef para NGINX
Vamos a ver un ejemplo muy rápido de NGINX con Chef, en el que instalaremos NGINX y lo configuraremos cambiando un par de variables. Usaremos Chef para averiguar dónde se está ejecutando nuestra aplicación y, a continuación, configuraremos NGINX para dirigir el tráfico hacia ella.
7:14 Instalación, configuración y optimización
Así pues, en este ejemplo, lo primero que hacemos es establecer algunos atributos del nodo. Para cada nodo, se pueden establecer los valores de los atributos añadiendo un documento JSON. Vamos a utilizar un cookbook de NGINX de terceros que busca la configuración de estos atributos. Vamos a asignar a worker_connections un valor determinado, configurar la directiva worker_rlimit_nofile, indicar qué tipo de event vamos a utilizar en NGINX e incluso configurar client_max_body_size.
Después, incluimos dos recetas del cookbook de NGINX. La primera es nginx::repo, que configura un repositorio de apt o de yum en función del sistema operativo. A continuación, [la receta nginx] instala NGINX. También se puede instalar NGINX desde el código fuente, pero usar paquetes es más rápido.
A continuación, aprovechamos las funciones de búsqueda de Chef. Al ejecutar Chef, puede hacerlo como un agente en la máquina o en modo independiente, que básicamente lo ejecuta como si fuera un script. Cuando hay un agente en una máquina, puede consultar el servidor de Chef para buscar nodos y otros atributos.
Aquí le pedimos a Chef que nos proporcione una lista de todos los nodos que tienen asociada la receta belly‑api. Después, generamos a partir de una plantilla un archivo de sitio llamado /sites‑enabled/api. Su origen es la plantilla [el archivo llamado api.erb que] mostraré a continuación. Las variables que le pasamos son los nodos que acabamos de buscar.
La última novedad aquí es una instrucción notifies para recargar el servicio nginx. Esto indica que, cada vez que cambie esta plantilla, se debe recargar este servicio.
8:54 Enrutamiento del tráfico de la API
Así que nuestro archivo de plantilla es bastante sencillo. Tenemos un upstream llamado api y en ERB recorremos todos los servidores que pasamos como variable, especificando cada servidor mediante su dirección IP y el puerto 8080. Incluso añadimos un comentario con el nombre del servidor. Cuando un operador quiera saber qué está ocurriendo con este servicio, este comentario le resultará útil.
También definimos un bloque server para escuchar en api.bellycard.com. Simplemente redirijo todo el tráfico al servidor ascendente api.
9:46 Ejemplo real de Chef
También quiero mostrar un ejemplo real. Puede que se vea demasiado pequeño para que podáis leerlo, pero al menos os permitirá haceros una idea de lo complejas que pueden llegar a ser vuestras recetas de Chef. Esta es la plantilla y la receta reales que utilizamos actualmente en algunos de nuestros servidores de producción.
10:08 Versión 2: Despliegue de aplicaciones
Volvamos ahora a nuestra pila tecnológica. Os comenté que habíamos desplegado unas cinco aplicaciones y que todo iba de maravilla. Ya teníamos una forma de dirigir el tráfico hacia ellas, así que nuestros desarrolladores aprovecharon esta posibilidad y, a día de hoy, contamos con unas 40 aplicaciones Ruby desplegadas en nuestros servidores mediante Chef. El tráfico se enruta de forma totalmente dinámica mediante NGINX.
Nuestros desarrolladores no tienen que hacer prácticamente nada, salvo editar una receta para incluir el nombre de su nuevo servicio. NGINX enruta todo el tráfico y Chef lo configura dinámicamente.
10:40 Versión 3: SOA para todo
También teníamos unas diez aplicaciones frontend de JavaScript que no eran más que archivos estáticos que desplegábamos en S3, con una CDN, [Amazon] CloudFront, por delante. Servíamos index.html desde el bucket de S3 y el resto de los recursos a través de CloudFront. También teníamos otras cinco aplicaciones, más o menos, que los desarrolladores habían subido directamente a Heroku porque eran proyectos puntuales que acabaron llegando a producción sin que nadie estuviera realmente al tanto.
11:10 Entonces ocurrió Heartbleed
[Las cinco aplicaciones de Heroku] estaban separadas —completamente al margen de nuestra infraestructura— hasta un buen día de abril en que se anunció el fallo Heartbleed. Mucha gente se apresuró a reaccionar. Heartbleed era un fallo de OpenSSL que podía permitir que otras personas extrajeran tus claves privadas.
Como utilizamos Chef, pudimos actualizar la infraestructura de OpenSSL en todos nuestros servidores en cuanto hubo un parche disponible. Creo que se desplegó en unos 20 minutos en toda nuestra infraestructura. Sin embargo, AWS (y, por tanto, Heroku) tardó unas 24 horas en aplicar el parche a sus balanceadores de carga elásticos.
Esto nos llevó a trasladar todo nuestro balanceo de carga y la terminación SSL a NGINX, independientemente de dónde estuviera desplegado, tanto en S3 como en Heroku. Esto conlleva una ligera penalización, pero al menos aquel día de abril nos mereció la pena.
11:57 SSL para todo
Así que la versión 3 de nuestra pila pasó de «SOA para todo» a «SSL para todo». Todo nuestro tráfico hacia bellycard.com y sus subdominios pasa por nuestros balanceadores de carga. En realidad, nuestros recursos siguen sirviéndose desde CloudFront en un dominio distinto para mejorar el rendimiento. No queremos la sobrecarga que supone SSL y, además, solo contamos con un centro de datos en la costa este.
12:25 Versión 4: Docker
Versión 4: la palabra de moda de la que todo el mundo habla este año es Docker. Desde que Docker estaba, creo, en la versión 0.5, nuestros desarrolladores estaban deseando empezar a utilizarlo.
12:38 Ventajas
Las razones [para usar Docker] son sencillas.
Simplifica enormemente el despliegue de aplicaciones. No hay que escribir recetas. No tienes que preocuparte por cómo vas a compilar los recursos. No importa si estás desarrollando tu aplicación en Ruby mientras otra persona desarrolla la suya en Python.
En esencia, separa las responsabilidades de Desarrollo y Operaciones. Los desarrolladores pueden centrarse en el código, en qué bibliotecas utilizar e incluso en qué paquetes de Linux instalar. El equipo de Operaciones puede ocuparse de cuestiones como: ¿dónde voy a desplegar esto? ¿Cómo voy a recopilar sus registros? ¿Cómo lo superviso? Una vez resueltos esos problemas operativos, cualquier aplicación funcionará, independientemente del lenguaje en el que esté escrita.
Otra ventaja es que permite a nuestros desarrolladores poner en marcha fácilmente servicios dependientes en sus propios portátiles. Como ya he mencionado, contamos con unas 55 aplicaciones diferentes, muchas de las cuales se ejecutan ahora en contenedores Docker.
Supongamos que estás trabajando en un nuevo servicio para enviar campañas de correo electrónico. Este depende del servicio de correo electrónico. Así que, en tu máquina de desarrollo, normalmente descargarías el código, ejecutarías bundle install, lo iniciarías en segundo plano y pensarías: «Ah, pero resulta que este depende de otro servicio, el servicio de usuarios».
Ese servicio depende de otros componentes, que a su vez dependen de otros. Así que, en realidad, el nuevo servicio de campañas de correo electrónico depende de unos cinco servicios más, además de MySQL, Elasticsearch, Redis, y la lista continúa.
Con Docker podemos crear esos contenedores a partir de las mismas recetas de Chef que utilizamos en producción y proporcionar a nuestros desarrolladores contenedores que pueden descargar con gran rapidez.
Así se agilizan el despliegue y el desarrollo.
14:23 Despliegue de contenedores
Así, en la versión 4 pasamos de desplegar nuestras aplicaciones con Chef a desplegarlas en contenedores. Hay muchísimas soluciones para hacerlo y estoy seguro de que surgirán aún más.
La primera opción es CoreOS y Fleet. CoreOS es un sistema operativo Linux reducido que ejecuta un motor de descubrimiento de servicios llamado etcd. Fleet permite definir cosas como «Quiero que un contenedor se ejecute cinco veces y no quiero que se ejecute en las mismas máquinas que este otro servicio».
Hay otra plataforma llamada Deis que se parece a Heroku porque cuenta con una interfaz basada en Git Push. También están Mesos, de Apache, y Kubernetes, de Google; Flynn es otra que acaba de aparecer recientemente. De hecho, desarrollamos nuestra propia solución porque, cuando emprendimos este viaje, la mayoría de estas herramientas aún no estaban lo bastante maduras como para que pudiéramos utilizarlas.
El nuestro se llama Jockey y nos ha funcionado realmente bien porque nuestro proceso de despliegue sigue unas pautas muy definidas. Lo mejor de Docker es que, en esencia, proporciona un conjunto de API comunes para la contenerización. No tenemos que preocuparnos por muchas de las cosas que sí tendríamos que tener en cuenta si solo utilizáramos los contenedores LXC de Linux.
Tenemos previsto publicarlo como código abierto, pero, como ya he mencionado, nuestro proceso de despliegue está muy condicionado por nuestras preferencias y puede que lo que nos funciona a nosotros no os funcione a vosotros.
15:45 Estrategias de despliegue
Además, nuestra estrategia de despliegue cambió un poco cuando migramos a Docker. Antes realizábamos despliegues sin tiempo de inactividad instalando una nueva versión de la aplicación sobre la existente. Esto significa que, si teníamos ese servicio de fax para usuarios en cuatro máquinas, utilizábamos Chef para descargar la nueva versión, instalarla sobre [la versión anterior] y, a continuación, enviar una señal al servidor web para que se recargara. Unicorn es un excelente motor de Ruby para hacer esto.
Sin embargo, los contenedores son inmutables. Una vez que tienes un contenedor en ejecución, si quieres crear una nueva compilación, debes crear un contenedor nuevo. Puedes conectarte a él, ejecutar comandos adicionales y guardarlo después, más o menos como harías en Git. Pero, en realidad, si quieres sacar el máximo partido a Docker, tu contenedor debe ser completamente inmutable.
Eso significa que tuvimos que idear una nueva estrategia de despliegue, porque ya no podemos desplegar directamente sobre el entorno existente. Hay varias opciones. Una interesante es el despliegue azul-verde. Consiste en que, si tienes una aplicación ejecutándose en cuatro máquinas, la pones en marcha en otras cuatro máquinas nuevas y haces que el balanceador de carga dirija el tráfico hacia ellas. Cuando te aseguras de que todo funciona como esperabas, puedes retirar el entorno azul y el verde pasa a ser el azul. Amazon ofrece herramientas excelentes para hacer esto con AWS.
También existen los despliegues «canary», en los que despliego una versión en una máquina nueva, la superviso y, si supera las comprobaciones de métricas y de estado, puedo continuar con el despliegue.
La diferencia con los contenedores en este caso es que vas a eliminarlos y crear otros nuevos, por lo que necesitas algún tipo de sistema que permita localizar cada aplicación que se ejecuta en tu infraestructura.
Chef se está convirtiendo en una forma realmente eficaz de hacer esto. Se está integrando un cookbook llamado Chef Metal que permite tratar los contenedores como cualquier otro recurso de la infraestructura de Chef.
17:43 Opciones de descubrimiento de servicios
También está el descubrimiento de servicios. ZooKeeper es una herramienta muy popular que se utiliza en todo Hadoop. [Airbnb] tiene un producto excelente llamado SmartStack que permite realizar despliegues y hacer un seguimiento de ellos en ZooKeeper.
He mencionado etcd, que es básicamente un almacén distribuido de pares clave-valor con una interfaz REST. Esto supone una gran ventaja frente a ZooKeeper, que es más bien una biblioteca cliente de Java, porque ahora puedes comunicarte con etcd desde cualquiera de tus aplicaciones. Muchas de esas plataformas como servicio de código abierto que he mencionado antes —como Deis y Flynn, e incluso Kubernetes de Google— utilizan etcd. Si utilizas CoreOS, etcd ya viene integrado y listo para usar.
También ha aparecido otra opción, también basada en REST, llamada Consul. La han publicado los responsables de HashiCorp, creadores de Vagrant, Packer y muchas otras herramientas fantásticas. De hecho, Consul es la opción que decidimos utilizar.
18:33 Arquitectura de Consul
Este diagrama muestra los fundamentos de Consul. Como puede verse, hay varios centros de datos, cada uno con tres servidores. En el centro de datos 1 también hay clientes. Lo interesante es que, entre los agentes de servidor, se elige un agente principal y todos los clientes conocen no solo todos los servidores, sino también todos los demás clientes. A continuación, utilizan un protocolo de difusión para comunicarse con el resto de los agentes.
Me recuerda a un antiguo anuncio de AT&T en el que se lo cuentas a dos amigos, que a su vez se lo cuentan a otros dos, y estos a otros dos, de modo que el mensaje se propaga por toda la red de nodos. [Editor – Bueno, casi: era un anuncio del champú Faberge Organics.] Esto contrasta con etcd o ZooKeeper, donde básicamente solo hay agentes de servidor y los clientes se conectan a ellos.
Con el enfoque de Consul, se ejecutaría un cliente de Consul prácticamente en todos los servidores, en todos los lugares donde desplegamos Docker y donde ejecutamos nuestros balanceadores de carga. De este modo, siempre se puede acceder a esa API a través del puerto 8500 de localhost.
19:30 Funcionalidades de Consul
Al igual que etcd, [Consul] es un almacén distribuido de pares clave-valor. Puedes establecer y obtener claves, y se mantendrá la linealizabilidad para garantizar que sean siempre coherentes. Hay algunos aspectos que conviene tener en cuenta, pero su documentación sobre estos posibles problemas es extraordinaria. Sin embargo, a diferencia de etcd, consideran el descubrimiento de servicios una funcionalidad de primer nivel.
Además de pares clave-valor, también puedes registrar servicios, por ejemplo, una API. Cuando registras un servicio, indicas a Consul en qué nodo se está ejecutando. Esto significa que, cuando desplegamos un contenedor, también indicamos a Consul que registre la API de este servicio en dicho host.
Además, Consul dispone de comprobaciones de estado distribuidas, por lo que ahora puedes definir comprobaciones de estado al estilo de Nagios directamente en tu plataforma de descubrimiento de servicios. Al consultar Consul, puedes solicitar una lista de todas las ubicaciones en las que se está ejecutando el servicio de API. Puedes enviar un indicador para obtener «todos», «solo los que superan la comprobación» o «solo los que presentan problemas».
También admite varios centros de datos. Como ya he mencionado, deberías ejecutar ese cliente de Consul en todas partes. Al iniciarlo, debes pasarle un parámetro que especifique el centro de datos. Si tienes un centro de datos Este y otro Oeste, puedes consultar tu cliente local de Consul para solicitar una dirección o algo similar sin tener que saber en qué centro de datos te encuentras.
De hecho, utilizamos el centro de datos como límite entre nuestros entornos de preproducción y producción. La configuración de una aplicación en preproducción podría indicar: «dime dónde está MySQL.services.consul». Tanto si se ejecuta en un nodo de preproducción como en uno de producción, obtendrás el valor correcto sin tener que saber en ningún momento en qué centro de datos o entorno se encuentra.
Otra de sus grandes ventajas (también presente en etcd) es que su interfaz HTTP admite sondeo de larga duración. Esto significa que puedes realizar una consulta para obtener una lista de todos los servidores que ejecutan este servicio y, al mismo tiempo, mantener la conexión abierta durante 60 segundos para recibir una notificación inmediata si se produce algún cambio. De hecho, el tiempo de sondeo puede llegar hasta los 10 minutos. Esto te permite recibir notificaciones instantáneas de cualquier cambio en tu infraestructura.
La otra cosa que ya he mencionado es que puedes dotar a tus agentes de capacidad de escalado horizontal teniendo clientes en todas partes. Esto es estupendo porque siempre puedes comunicarte con localhost.
Sin embargo, la gran pregunta es: ahora que tengo estos datos en una plataforma distribuida de descubrimiento de servicios, ¿cómo configuro NGINX a partir de ellos?
22:07 Plantilla de Consul
Por suerte, existe una herramienta llamada Consul Template. Se publicó literalmente ayer, lo que me obligó a cambiar a partir de aquí las diapositivas de mi presentación de hoy. Antes se llamaba «Consul HAProxy», un nombre pésimo porque, en realidad, no era específica de HAProxy.
Consul Template ofrece una interfaz muy sencilla para crear plantillas que se suscriban a los cambios en los servicios, a las comprobaciones de estado de dichos servicios e incluso a un almacén de pares clave-valor. De este modo, puedes guardar ajustes como [el número de] procesos de trabajo de NGINX en el almacén de pares clave-valor y volver a generar la configuración cuando cambien.
La principal ventaja aquí es la posibilidad de generar archivos a partir de plantillas, algo muy similar a lo que hacíamos antes con Chef. La diferencia más importante es que utiliza el lenguaje de plantillas de Golang en lugar de ERB, que es de Ruby. Al modificar un archivo, se puede ejecutar opcionalmente un comando tras el cambio, por ejemplo, «service nginx reload».
22:59 Comando para iniciar Consul Template
Este es un ejemplo de cómo ejecutar Consul Template desde la línea de comandos. Debes dirigirlo a tu host de Consul real, que en este caso es consul‑prod.example.com. En un entorno de producción real, recomendaría ejecutar Consul en todas partes y conectarse a localhost.
A continuación, se especifica un archivo de plantilla, que es una plantilla de Golang. En nuestro caso, especificamos /etc/consul‑templates/api. Después, se indica el archivo en el que se escribirá el resultado; en nuestro caso, /etc/NGINX/sites‑enabled/api. Por último, el comando que se ejecutará: service nginx reload.
23:32 Configuración de NGINX con Consul Template
La plantilla de Consul se parece mucho a una diapositiva que mostré antes, salvo que, en lugar de ERB, utiliza Golang. Así que aquí definimos dos servidores upstream. Uno se llama api y el otro se llama homepage. Tenemos una instrucción range para la API del servicio, y hay variables integradas para obtener la IP y el puerto donde se está ejecutando realmente dicho servicio.
23:54 Gestión de la configuración con Consul Template
Lo mejor de Consul Template y de usarlo de esta forma es que la convergencia ante los cambios en los servicios es rápida. Antes de empezar a desplegar con Docker, ejecutábamos Chef aproximadamente cada 5 o 10 minutos, dependiendo de la máquina. Para nosotros era lo bastante rápido porque realizábamos los despliegues in situ.
Ahora que estamos creando un sistema de despliegue más avanzado, necesitamos recibir notificaciones de esos cambios en cuestión de segundos, en lugar de minutos. De hecho, las recibimos en cuestión de milisegundos, con una media de unos 200 milisegundos.
Sin embargo, la gestión de la configuración sigue siendo necesaria para generar plantillas. No podemos sustituir Chef por Consul sin más. Aún tenemos que determinar cómo vamos a desplegar Consul, Consul Template y todo lo demás.
24:35 Uso de Chef para desplegar Consul
En realidad, utilizamos plantillas de Chef para desplegar nuestras plantillas de Consul, lo que parece un poco enrevesado. Lo primero que hacemos en nuestra receta de Chef es consultar a nuestro host de Consul para obtener una lista de todos los servicios. A continuación, generamos una plantilla de Consul [con las sentencias template y source] y le pasamos las ubicaciones de nuestro certificado SSL y nuestra clave, y recargamos consul‑template. [Editor: el Sr. Reedy se refirió inicialmente a consul‑haproxy, que aparece en la primera sentencia notifies de la diapositiva. Después se corrigió y aclaró que la diapositiva es anterior al lanzamiento de Consul Template.]
También generamos un archivo de configuración para Consul Template y le pasamos [variables que especifican] el host de Consul, el origen, el destino y el comando de recarga. Esta es, en esencia, la clave de cómo utilizamos Chef y Consul conjuntamente para actualizar al instante nuestras configuraciones de NGINX.
25:44 Consejos profesionales
A continuación, tengo algunos consejos profesionales sobre Chef, Consul y la configuración de NGINX en general.
25:52 Búsqueda parcial de Chef
El primer consejo es que, si utilizas la búsqueda de Chef para averiguar dónde se están ejecutando tus servicios, deberías plantearte usar la búsqueda parcial de Chef. El problema de la búsqueda de Chef es que crea una copia del nodo completo, incluidos todos sus atributos. Si guardas muchos datos en los atributos del nodo, tendrás que transferirlos por la red al comunicarte con tu servidor de Chef y, además, almacenarlos en memoria.
Si la búsqueda de Chef devuelve cientos o miles de servidores, es fácil ver cómo la receta que se está ejecutando podría quedarse sin memoria. La búsqueda parcial permite devolver únicamente las claves que interesan.
Por ejemplo, al principio teníamos
nodes = search(:node, 'recipe:belly-api')Esa búsqueda devuelve absolutamente toda la información sobre cada objeto. Esto incluye información sobre su espacio en disco, RAM, CPU y todas las aplicaciones que han escrito sus propios atributos de nodo.
En su lugar, podemos usar una búsqueda parcial, para lo cual creamos un nuevo hash llamado search_keys y le proporcionamos una lista de las claves que nos interesan; en este caso, solo el nombre y la dirección IP. A continuación, llamamos a una API muy similar denominada partial_search y le pasamos el parámetro adicional [keys].
26:53 DNS
El segundo problema con el que nos encontramos al implementar el balanceo de carga delante de S3 y Heroku es que NGINX utiliza DNS para resolver los nombres de host de los bloques upstream únicamente cuando se recarga la configuración. Esto significa que, si configuras como servidor upstream s3.amazonaws.com o anything.herokuapp.com y su dirección cambia, el balanceador de carga no conoce la nueva dirección IP hasta la siguiente recarga.
La forma en que hemos solucionado esto consiste en realizar la resolución DNS en Chef y, cuando cambia, activar la recarga de NGINX. Esto dio lugar a un segundo problema: [el orden de las direcciones en una respuesta DNS] no siempre es el mismo, así que asegúrate también de ordenar la respuesta antes de escribirla en la plantilla.
27:36 Cómo evitar configuraciones obsoletas
El otro problema que surge cuando empiezas a desplegar un montón de servicios es que quieres evitar que la configuración quede obsoleta. [Editor: el Sr. Reedy hace una breve pausa en la presentación para responder a una pregunta del público.] En Apache, NGINX y otros sistemas UNIX, un patrón de configuración habitual consiste en tener una carpeta conf.d y cargar todo su contenido. Así, si despliego los servicios A, B y C, creo los archivos service-a.conf, service-b.conf y service-c.conf.
Entonces decido sustituir el servicio B por el D, y ahora tengo cuatro archivos de configuración en la carpeta de configuración de NGINX, aunque el servicio B ya no existe. Podrían surgir conflictos entre B y D porque tienen nombres de host similares.
En el pasado, hemos intentado hacer esto [eliminar configuraciones obsoletas] de dos maneras. Con las plantillas se puede añadir una función :delete, pero este método se volvió bastante difícil de gestionar muy rápidamente. Básicamente, teníamos una lista de servicios antiguos que siempre intentábamos eliminar si existían. Este enfoque no era realmente escalable.
Otra opción es volcar todas las configuraciones de tus sitios en un único archivo. Mucha gente se ha referido a esto como «subir la idempotencia de nivel». Básicamente, en lugar de tener una configuración de NGINX que se cargue desde varias fuentes, ponlo todo en tu archivo nginx.conf.
Eso sí hace que resulte un poco engorroso cuando accedes directamente al servidor, pero esperemos que estemos llegando al punto en el que ya no tengas que solucionar problemas de un archivo de configuración directamente en producción. Si aun así sigue siendo un poco engorroso en tus recetas de Chef, lo que hacemos nosotros es tener un único archivo nginx.conf que carga una serie de sitios distintos. Por ejemplo, uno de nuestros archivos de configuración de sitios incluye unos 30 servicios; luego tenemos uno para Heroku, otro para todos los de S3, etc.
Así que, si generas todas las configuraciones de tus sitios en un único archivo o en un número reducido de archivos, no tienes que preocuparte de limpiar después. Si, desde el punto de vista de Chef, un servicio deja de existir, Chef simplemente deja de incluirlo en el archivo correspondiente.
30:35 Preguntas
P: ¿Qué tal os ha funcionado Consul hasta ahora?
R: Consul nos ha encantado, y lo que más me gusta de él en comparación con algo como etcd es que se siguen desarrollando servicios sobre esta plataforma. No tengo que preocuparme por el descubrimiento de servicios. De hecho, si tienes aplicaciones heredadas e implementas, por ejemplo, tus servidores MySQL mediante Consul, Consul también proporciona una interfaz DNS.
Tu aplicación no necesita conocer Consul; basta con que consulte «¿qué dirección obtengo de mysqldb.services.consul?». En este caso, Consul es el servidor DNS. Configuras tu infraestructura DNS para que, si el TLD [dominio de nivel superior] termina en .consul, la consulta se dirija a Consul.
Nos ha funcionado de maravilla al escalar. Tenemos unos 3 nodos en producción para los agentes de servidor y unos 60 clientes. No hemos tenido ningún contratiempo. No paran de añadir funcionalidades y mantienen la compatibilidad con versiones anteriores, así que las actualizaciones siempre han ido muy bien.
P: ¿Utiliza NGINX Plus?
R: No. Lo estudiamos precisamente para esto cuando empezamos a trabajar con Consul. Si no necesitáramos un sistema de plantillas, sería estupendo, porque podríamos tener simplemente un script que escuchara ese sondeo HTTP de larga duración y se comunicara con la API de NGINX en vuestro nombre. El único problema es que probablemente también querríais un sistema de plantillas por si NGINX se reiniciara. Así, volvería a cargar en ese momento las configuraciones de los servidores upstream.
También hay trabajos realizados por otras personas en NGINX Lua para consultar Consul directamente. Aún no he visto una buena implementación, porque suelen adoptar uno de estos dos enfoques. El primero consiste en consultar Consul con cada solicitud HTTP, lo cual es lento. El segundo consiste en cargarlo al procesar la configuración, con lo que se acaba teniendo el mismo problema que con DNS. Así que, por ahora, lo mejor es usar plantillas, aunque no me sorprendería que en el futuro apareciera una forma de hacerlo con NGINX Lua.
P: ¿Os plantearíais dejar de usar Chef alguna vez?
R: Consul no incorpora una forma realmente eficaz de mantener esas plantillas, y ya estamos desplegando NGINX con Chef. A estas alturas, nuestras recetas relacionadas tienen cientos, si no miles, de líneas debido a todo lo demás que hacemos con NGINX, como el registro, el rastreo y algunas funciones de OAuth. No creo que vayamos a dejar de usar Chef en nuestra infraestructura y sustituirlo, pero Consul es un complemento excelente y una buena forma de recibir notificaciones rápidamente.
P: ¿Cuánta sobrecarga genera Chef?
R: Como la mayoría de nuestras máquinas realizan una única tarea, la sobrecarga real de Chef es bastante baja. El uso de RAM es reducido mientras está inactivo. En realidad, permanece a la espera de un temporizador y puede crear un proceso secundario. Otras personas también lo ejecutan mediante una tarea de cron si no les preocupa la rapidez con la que converge. Observamos un pequeño aumento del uso de la CPU en algunas de nuestras recetas más exigentes, pero nada que no podamos solucionar desplegando otro servidor.
P: ¿Cuánto has trabajado con CloudFormation?
R: Todavía no utilizamos CloudFormation. Lo tenemos en mente, pero uno de los cambios que hemos hecho es utilizar muchos más grupos de Auto Scaling. Funcionará de la siguiente manera: cuando se inicie una instancia, tendrá datos de usuario que contendrán su lista de ejecución de Chef.
Una máquina nueva se incorporará a un clúster con una clave ya incluida en su imagen, por lo que podrá comunicarse con nuestro servidor Chef, registrarse y descargar los cookbooks que necesite. Esto nos permite prescindir en gran medida de CloudFormation, ya que no utilizamos muchas de las otras herramientas de AWS que suelen emplearse junto con él.
P: ¿Cómo gestionáis la destrucción de un servidor?
R: Si un servidor deja de estar disponible en un grupo de Auto Scaling, puedes usar Amazon SNS [Servicio de notificaciones simples] para recibir una notificación. Tenemos un servicio muy sencillo que escucha esas notificaciones y, a continuación, realiza la limpieza correspondiente en el servidor de Chef.
P: ¿Has utilizado OpsWorks de AWS?
R: No. Llevamos usando Chef alojado desde el principio y nos ha funcionado de maravilla. No estoy del todo seguro, pero creo que OpsWorks se parece más a Chef Solo, ya que se utiliza únicamente para el aprovisionamiento. Seguimos ejecutando Chef Agent en casi todas nuestras máquinas y usamos esas mismas recetas de Chef para generar contenedores Docker para desarrollo.
36:31 Información de contacto
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.