El mercado de la gestión de API (APIM) está muy saturado. El último Cuadrante Mágico de Gartner para la gestión del ciclo de vida completo de las API clasifica a 22 proveedores, 7 de ellos en el cuadrante de líderes. Competir en un mercado existente exige establecer un posicionamiento sólido para diferenciarse y destacar frente a la competencia. Entonces, ¿qué hace diferente a la solución de gestión de API de NGINX?
En NGINX, nuestro objetivo es crear software ligero y de alto rendimiento. NGINX Open Source se ha convertido en el servidor web de referencia para los sitios web con más tráfico del mundo porque su arquitectura basada en eventos ofrece una mayor escalabilidad que los servidores web que crean un proceso o hilo para cada conexión. NGINX Open Source es también la puerta de enlace de API más utilizada del sector, un componente de infraestructura que procesa el tráfico de API en soluciones de APIM como las de Apigee, Axway, IBM DataPower, Kong, Red Hat 3scale y Torry Harris.
El módulo de gestión de API de NGINX Controller es una solución de APIM de alto rendimiento. En este blog compararemos su rendimiento con el de Kong, un competidor conocido por su alto rendimiento. Kong se basa en NGINX y utiliza Lua para implementar sus funciones de API, mientras que el módulo de gestión de API se apoya íntegramente en funcionalidades nativas de alto rendimiento implementadas como módulos de NGINX Plus. La solución de gestión de API de NGINX se basa en una arquitectura innovadora que desacopla el plano de datos del plano de control. NGINX Plus, que actúa como puerta de enlace de API (plano de datos), gestiona directamente todas las llamadas a la API sin necesidad de interactuar con el plano de control. Esto permite mediar el tráfico de API con un alto rendimiento, tanto para el tráfico norte-sur como para el tráfico este-oeste.
Un adelanto de los resultados: el módulo de gestión de API de NGINX Controller ofrece el doble de rendimiento que Kong.
Un agradecimiento especial a Intel por proporcionar el hardware y el espacio de laboratorio utilizados para realizar estas pruebas. Encontrará todos los detalles sobre las pruebas y el hardware en el Apéndice.
Latencia añadida a una única solicitud
En esta prueba comparamos la latencia adicional que el gestor de API introducía en una única solicitud para archivos de 0 KB y 1 KB. Utilizamos curl para enviar la solicitud HTTP única (detalles).
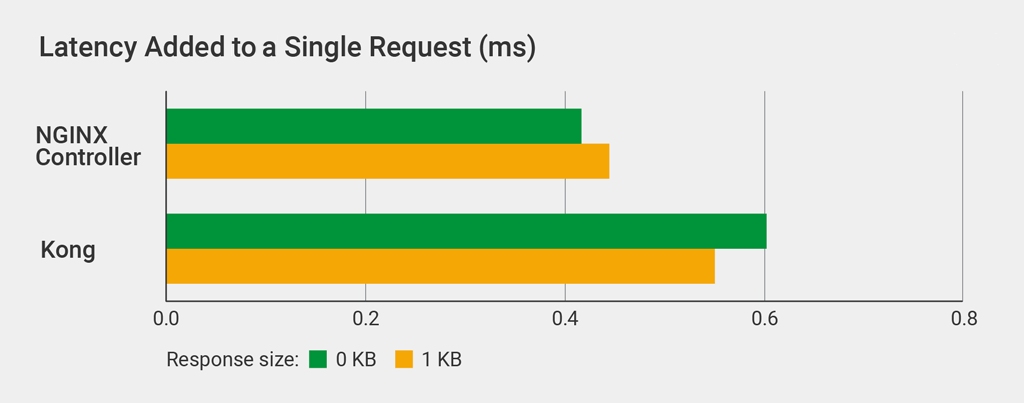
Kong aumenta la latencia en comparación con el módulo de gestión de API: un 44 % para un archivo de 0 KB y un 24 % para uno de 1 KB.
Llamadas a la API por segundo
Una métrica estándar de escalabilidad HTTP es el número de solicitudes por segundo (RPS). La métrica equivalente en el contexto de APIM es el número de llamadas a la API por segundo. Utilizamos wrk para enviar un flujo continuo de solicitudes de un archivo de 0 KB o 1 KB, mediante 300 conexiones durante 3 minutos (detalles).
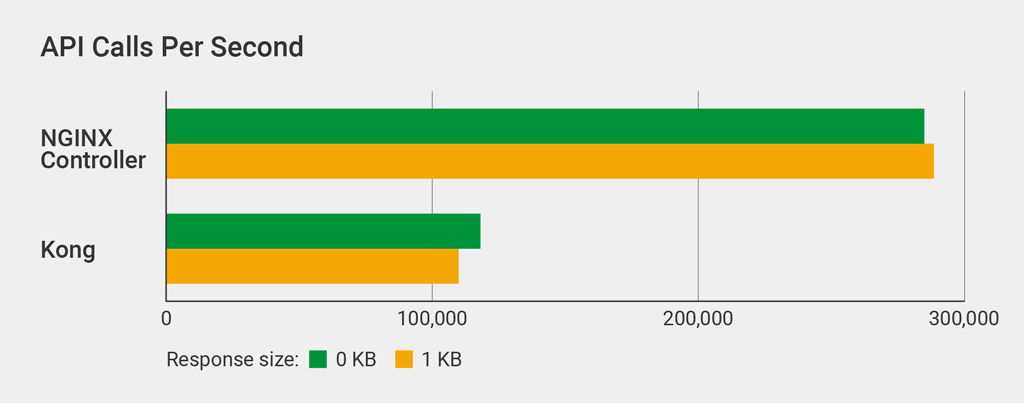
El módulo de gestión de API superó a Kong, ya que gestionó 2,6 veces más llamadas a la API por segundo para respuestas de 1 KB.
Uso de la CPU
El módulo de gestión de API introduce menos latencia y gestiona más llamadas a la API por segundo que Kong porque utiliza la CPU de forma más eficiente. Medimos el uso de la CPU con un número creciente de llamadas a la API por segundo. Utilizamos un solo núcleo, por lo que el número absoluto de llamadas a la API por segundo es mucho menor que en la prueba anterior, en la que utilizamos 22 núcleos (detalles).
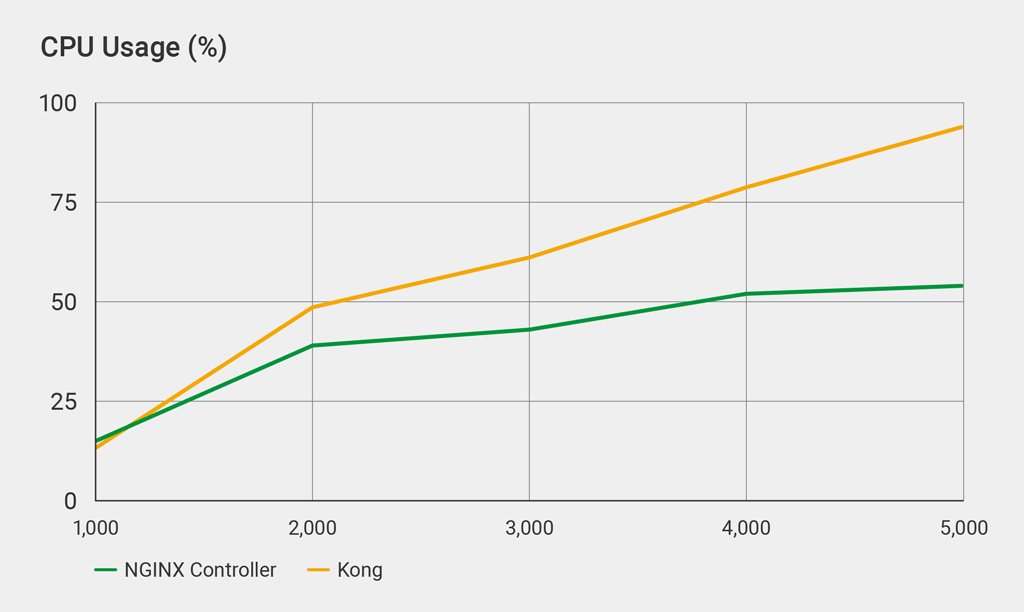
Kong alcanza en la práctica su límite en 5.000 llamadas a la API por segundo; con volúmenes superiores, la latencia aumenta notablemente, lo que indica que el sistema está completamente saturado. Con 5.000 llamadas por segundo, el uso de la CPU es del 93 %, un 73 % superior al del módulo de gestión de API.
Llamadas a la API por segundo con JWT
La prueba final mide la eficacia con la que cada puerta de enlace de API valida los tokens web JSON (JWT), el método preferido para autenticar las solicitudes de API. Es probable que los endpoints más importantes de su API requieran autenticación, por lo que esta prueba se aproxima más a una configuración real.
Usamos el mismo JWT, firmado con HS256, con ambas puertas de enlace (detalles).
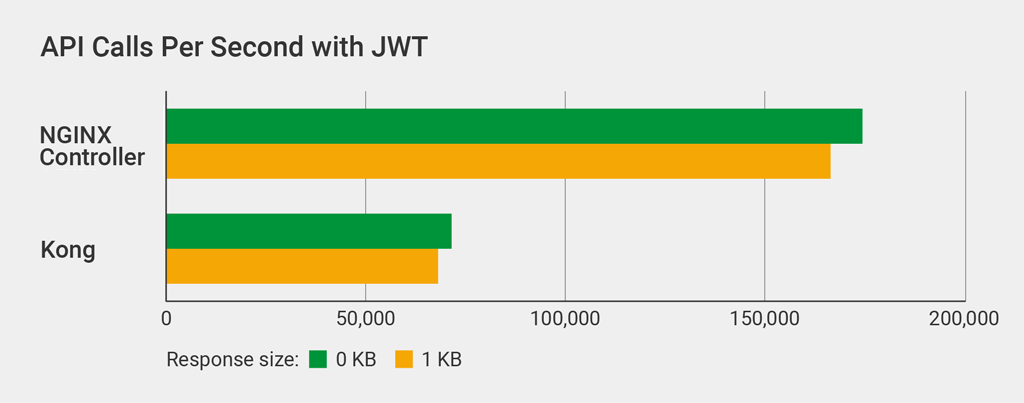
El módulo de gestión de API procesa por segundo más del doble de llamadas a API autenticadas mediante JWT que Kong.
Cómo funciona NGINX Controller
NGINX Controller es una solución de plano de control que gestiona el plano de datos de NGINX Plus. NGINX Controller permite gestionar todo el ciclo de vida de NGINX Plus como equilibrador de carga, puerta de enlace de API o proxy en un entorno de malla de servicios. Con el módulo de gestión de API de NGINX Controller, puede definir, publicar, proteger, supervisar y analizar API.
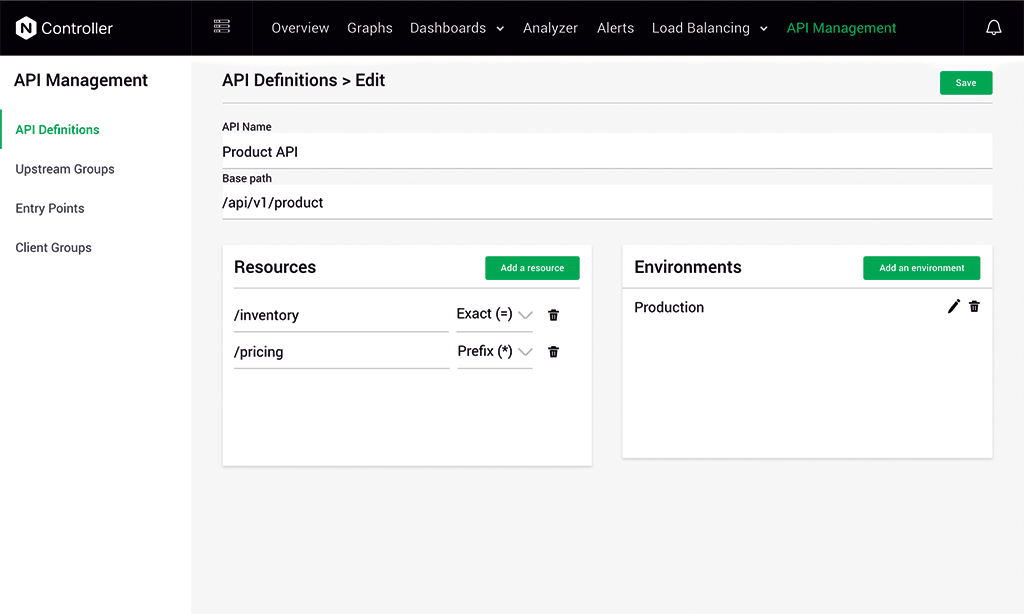
Internamente, NGINX Controller genera una configuración de NGINX Plus que se publica en el plano de datos subyacente de NGINX Plus. El cargador de configuración principal cuenta con un mecanismo muy eficiente para almacenar configuraciones en memoria, lo que permite al módulo de gestión de API ofrecer un alto rendimiento para las API.
Conclusión
Muchas empresas ya utilizan NGINX Open Source como puerta de enlace de API. Capital One ha logrado escalar hasta superar las 12 000 millones de llamadas a la API al día mediante NGINX Open Source. De hecho, muchos de nuestros competidores, incluido Kong, utilizan NGINX Open Source como base de sus soluciones de gestión de API (APIM). Nuestro diseño ligero, basado en la configuración nativa de alto rendimiento de NGINX junto con los módulos de NGINX Plus, permite que el módulo de gestión de API escale mejor que las soluciones de la competencia derivadas de NGINX.
La latencia es una de las métricas más importantes para la experiencia del usuario final. Una latencia elevada reduce la capacidad de respuesta de las aplicaciones, lo que genera frustración entre los usuarios. El módulo de gestión de API añade entre un 20 % y un 30 % menos de latencia a las solicitudes de los usuarios que Kong. Además, utiliza los recursos del sistema de forma más eficiente, ya que consume un 40 % menos de CPU que Kong con la misma carga de trabajo.
Apéndice
Topología
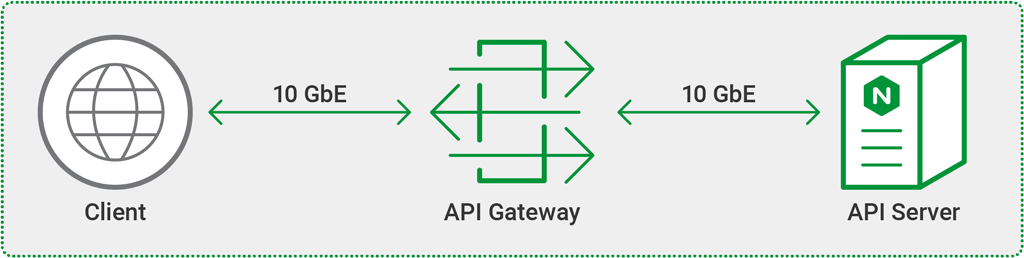
Todas las pruebas se realizaron utilizando tres máquinas independientes conectadas mediante enlaces de 10 GbE en una red de capa 2 sencilla y plana.
Hardware utilizado
Para las pruebas se utilizó el siguiente hardware. Las tres máquinas eran idénticas. No se utilizó Hyper-Threading. En pruebas anteriores no observamos una diferencia significativa de rendimiento al utilizar Hyper-Threading.
| CPU | Red | Memoria |
|---|---|---|
| CPU Intel® Xeon(R) E5‑2699 v4 a 2,20 GHz, 22 núcleos | Controlador Ethernet Intel X540‑AT2 de 10 gigabits | 128 GB |
Software utilizado
Para realizar las pruebas, se utilizó el siguiente software:
- Módulo de gestión de API de NGINX Controller, versión 2.
- Kong Open Source versión 1.0.0. No probamos Kong Enterprise, pero ninguna de sus funciones adicionales es relevante para nuestras pruebas (por ejemplo, Kong Open Source y Kong Enterprise utilizan el mismo complemento JWT).
curlversión 7.61.0.- Docker versión 18.09.1. Para facilitar la gestión, ejecutamos tanto Kong como el módulo de gestión de API dentro de contenedores Docker. Comprobamos que Docker reduce el rendimiento aproximadamente un 30 %, pero, dado que estábamos comparando el rendimiento relativo, las ventajas de usar Docker compensaban la pérdida de rendimiento.
mpstaten la versión 12.0.1 del paquetesystat.wrkversión 4.1.0, instalada siguiendo estas instrucciones.
Configuración de NGINX
Para las pruebas se utilizó la siguiente configuración de NGINX.
upstream my_upstream { keepalive 60; server API-server:80; keepalive_requests 3000000; keepalive_timeout 300;}server { listen 8000; access_log off; keepalive_requests 3000000; keepalive_timeout 300; tcp_nodelay on; location /test { set $apimgmt_environment 4; set $apimgmt_definition 3; set $upstream my_upstream; set $upstream_protocol http; rewrite ^ /_devel_4 last; } location = /_devel_4 { internal; set $apimgmt_definition_name my_api; set $apimgmt_environment_name devel; proxy_intercept_errors on; proxy_http_version 1.1; proxy_set_header Connection ""; proxy_pass $upstream_protocol://$upstream/0kb; # 0-KB file #proxy_pass $upstream_protocol://$upstream/1kb.bin; # 1-KB file }}Aplicamos los siguientes ajustes para maximizar el rendimiento. Como se detalla en la siguiente sección, aplicamos ajustes similares en la configuración de Kong.
keepalive_requestsykeepalive_timeoutse configuraron con un valor alto para minimizar la sobrecarga derivada del establecimiento de conexiones TCP.tcp_nodelayse habilitó, lo que mejoró ligeramente el rendimiento al desactivar el algoritmo de Nagle.access_logse deshabilitó. Habilitarlo reduce el rendimiento aproximadamente un 10 %.- Utilizamos las dos directivas
proxy_passpara solicitar el tamaño de archivo adecuado.
Configuración de Kong
Añadimos las siguientes directivas de configuración a «kong.conf.default», de acuerdo con los ajustes de la configuración de NGINX descritos en la sección anterior.
nginx_http_tcp_nodelay=onnginx_http_keepalive_requests=3000000nginx_http_keepalive_timeout=300proxy_access_log=offEjecutamos las siguientes llamadas a la API de Kong para crear una ruta al servidor de la API. El primer comando crea un servicio llamado test y el segundo crea la ruta /test que apunta al servidor.
$ curl -X POST http://localhost:8001/services/ --data 'name=test' --data 'url=http://API-server:80/0kb'$ curl -X POST http://localhost:8001/services/test/routes --data 'paths[]=/test'Los siguientes comandos muestran la configuración del servicio y de la ruta, respectivamente. Redirigimos la salida a la herramienta jq para facilitar la lectura de la salida JSON.
$ curl localhost:8001/services/ | jq '.'{ "next": null, "data": [ { "host": "172.20.40.32", "created_at": 1556770191, "connect_timeout": 60000, "id": "f4629d56-550b-4b37-aa59-66d931aa6f37", "protocol": "http", "name": "test", "read_timeout": 60000, "port": 80, "path": "/0kb", "updated_at": 1556770191, "retries": 5, "write_timeout": 60000 } ]}$ curl localhost:8001/services/test/routes | jq '.'{ "next": null, "data": [ { "created_at": 1556770191, "methods": null, "id": "a7b417af-ccd4-48f7-b787-ae19490194dc", "service": { "id": "f4629d56-550b-4b37-aa59-66d931aa6f37" }, "name": null, "hosts": null, "updated_at": 1556770191, "preserve_host": false, "regex_priority": 0, "paths": [ "/test" ], "sources": null, "destinations": null, "snis": null, "protocols": [ "http", "https" ], "strip_path": true } ]}Metodología de pruebas
Latencia añadida a una única solicitud
Utilizamos curl para las pruebas de latencia de una sola solicitud. Para establecer una referencia, primero enviamos una solicitud al servidor de la API sin una puerta de enlace de API delante. Después, enviamos la misma solicitud con cada puerta de enlace de API delante del servidor de la API para medir la latencia que introducían.
$ curl -w "@curl-latency.txt" -o /dev/null -s http://target-serverEl contenido de curl-latency.txt:
time_namelookup: %{time_namelookup}n time_connect: %{time_connect}n time_appconnect: %{time_appconnect}n time_pretransfer: %{time_pretransfer}n time_redirect: %{time_redirect}n time_starttransfer: %{time_starttransfer}n ----------n time_total: %{time_total}nEl gráfico de Latencia añadida a una sola solicitud muestra time_total, en milisegundos. Este es un ejemplo de salida:
$ curl -w "@curl-latency.txt" -o /dev/null -s http://192.0.2.1/api-endpoint time_namelookup: 0.000035 time_connect: 0.000364 time_appconnect: 0.000000 time_pretransfer: 0.000401 time_redirect: 0.000000 time_starttransfer: 0.001701 ---------- time_total: 0.001727Llamadas a la API por segundo
Probamos las llamadas a la API por segundo con wrk, una herramienta escalable de evaluación comparativa que utilizamos a menudo. Probamos varias combinaciones de parámetros, y esta fue la que maximizó el rendimiento tanto del módulo de gestión de API como de Kong:
$ wrk -t 22 -c 300 -d 180 http://target-serverEl comando crea 22 hilos de wrk (uno por núcleo) y un total de 300 conexiones distribuidas entre los hilos. El parámetro -d especifica la duración de la prueba, en nuestro caso 180 segundos (3 minutos). Ejemplo de salida:
$ wrk -t 22 -c 300 -d 180 http://192.0.2.1/api-endpointRunning 3m test @ http://192.0.2.1/api-endpoint 22 threads and 300 connections Thread Stats Avg Stdev Max +/- Stdev Latency 13.96ms 7.84ms 279.85ms 77.37% Req/Sec 0.96k 298.23 1.88k 68.55% 3769861 requests in 3.00m, 36.25GB readRequests/sec: 20934.34Transfer/sec: 206.16MBUso de la CPU
Probamos el uso de la CPU con mpstat (una herramienta estándar de Linux para ese fin) mientras ejecutábamos el comando wrk para medir las llamadas a la API por segundo. Ejemplo de salida (distribuida en dos líneas para facilitar la lectura):
$ mpstatLinux 4.18.0-13-generic (nbdw38) 04/29/2019 _x86_64_ (88 CPU)03:34:50 PM CPU %usr %nice %sys %iowait %irq %soft %steal ...03:34:50 PM all 0.04 0.00 0.02 0.00 0.00 0.03 0.00 ... ... %guest %gnice %idle ... 0.00 0.00 99.91Llamadas a la API por segundo con JWT
Probamos el rendimiento de los JWT con el comando wrk para medir las llamadas a la API por segundo, añadiendo el parámetro -H para insertar el JWT en la cabecera HTTP Authorization: Bearer. Generamos el JWT y las claves web JSON (JWK) siguiendo las instrucciones de esta entrada del blog, y guardamos el JWT en un archivo llamado test.jwt.
$ wrk -t 22 -c 300 -d 180 -H "Authorization: Bearer `cat test.jwt`" http://target-serverSobre el autor

Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.