La observabilidad es fundamental al ejecutar aplicaciones nativas de la nube, cuya funcionalidad surge de la interacción entre un gran número de microservicios que se ejecutan en distintas ubicaciones. La naturaleza débilmente acoplada de las aplicaciones basadas en microservicios puede hacer que cada microservicio informe de sus actividades a su manera. Sin una herramienta que recopile y correlacione esos datos de telemetría, resulta sumamente difícil —si no imposible— realizar un seguimiento del procesamiento de una solicitud de principio a fin, algo crucial para solucionar problemas.
Al buscar una herramienta de observabilidad multifuncional, el equipo responsable del proyecto NGINX Modern Apps Reference Architecture (MARA) eligió OpenTelemetry. Dado que nuestro equipo de software de código abierto ha apostado por este proyecto emergente, queremos profundizar en él. En GlueCon 2022, me reuní con Granville Schmidt, arquitecto de la Oficina del CTO de F5, para hablar sobre por qué nos entusiasman el estado actual y las futuras prestaciones de OpenTelemetry. A continuación puede ver nuestra conversación y, en este blog, descubrir por qué OpenTelemetry es un recurso tan valioso para el ecosistema de aplicaciones nativas de la nube.
OpenTelemetry impulsa la Observabilidad 2.0
Anunciado por primera vez en la KubeCon 2019 de Barcelona, OpenTelemetry ha atraído a un entusiasta grupo de colaboradores. Es el segundo proyecto más popular de la Cloud Native Computing Foundation (CNCF) por número de contribuciones y, en los últimos seis meses, el ritmo de contribución ha sido más alto que nunca. Este gran número de colaboradores demuestra que OpenTelemetry ha madurado y está empezando a salvar la brecha entre los primeros usuarios (dispuestos a adelantarse a las tendencias) y los pragmáticos (que buscan productos maduros).
OpenTelemetry se centra en los datos; concretamente, en los datos y el flujo de datos (telemetría) necesarios para comprender mejor nuestras aplicaciones, solucionar sus problemas y mejorarlas. Los datos solo son útiles si se pueden agregar, analizar y visualizar a gran escala. Aunque OpenTelemetry no ofrece indicaciones sobre cómo visualizar los datos, nos permite dejar de preocuparnos por qué datos podemos obtener y centrarnos en lo que podemos hacer con ellos.
OpenTelemetry también permite correlacionar de forma natural esas fuentes de datos, en lugar de obligarnos a intentar establecer esa correlación por nuestra cuenta. La capacidad de OpenTelemetry para correlacionar eventos entre aplicaciones nos está llevando a la Observabilidad 2.0, un nuevo referente para medir la actividad de las aplicaciones en la nube. Los datos ya están correlacionados, lo que cambia nuestra forma de contemplar el entorno de nuestras aplicaciones. Ya no nos limitamos a saber si la aplicación está en funcionamiento o no; ahora podemos comprender el recorrido que sigue cualquier solicitud a través de nuestras aplicaciones.
Antes de OpenTelemetry hubo dos proyectos de código abierto destacados: OpenTracing (OT) y OpenCensus (OC). Ambos asumieron el reto de estandarizar el formato de los datos de trazas para que pudiéramos obtener la información necesaria y comprender cómo afectaba a nuestras aplicaciones modernas. Aunque ambos proyectos presentaban similitudes, competían por los recursos y las empresas a menudo tenían que elegir solo uno. En marzo de 2019, los dos proyectos anunciaron su fusión para crear OpenTelemetry con el objetivo de unificar la forma en que se generan y formatean los datos de trazas. El proyecto OpenTelemetry también está definiendo estándares para recopilar otros tipos de datos de observabilidad (métricas y registros) a través de los mismos canales de telemetría que las trazas, lo que aporta una mayor integración y claridad.
A continuación, veamos dos interesantes aspectos funcionales de OpenTelemetry: el rastreo distribuido y la inteligencia de aplicaciones.
Por qué el rastreo distribuido es necesario en las arquitecturas de aplicaciones modernas
Aunque el rastreo distribuido existe desde hace años, muchos de los cambios producidos en la última década han hecho que sea cada vez más necesario. Mediante el marco Cynefin, podemos destacar algunos de los cambios y retos a los que nos enfrentamos actualmente en las aplicaciones modernas:
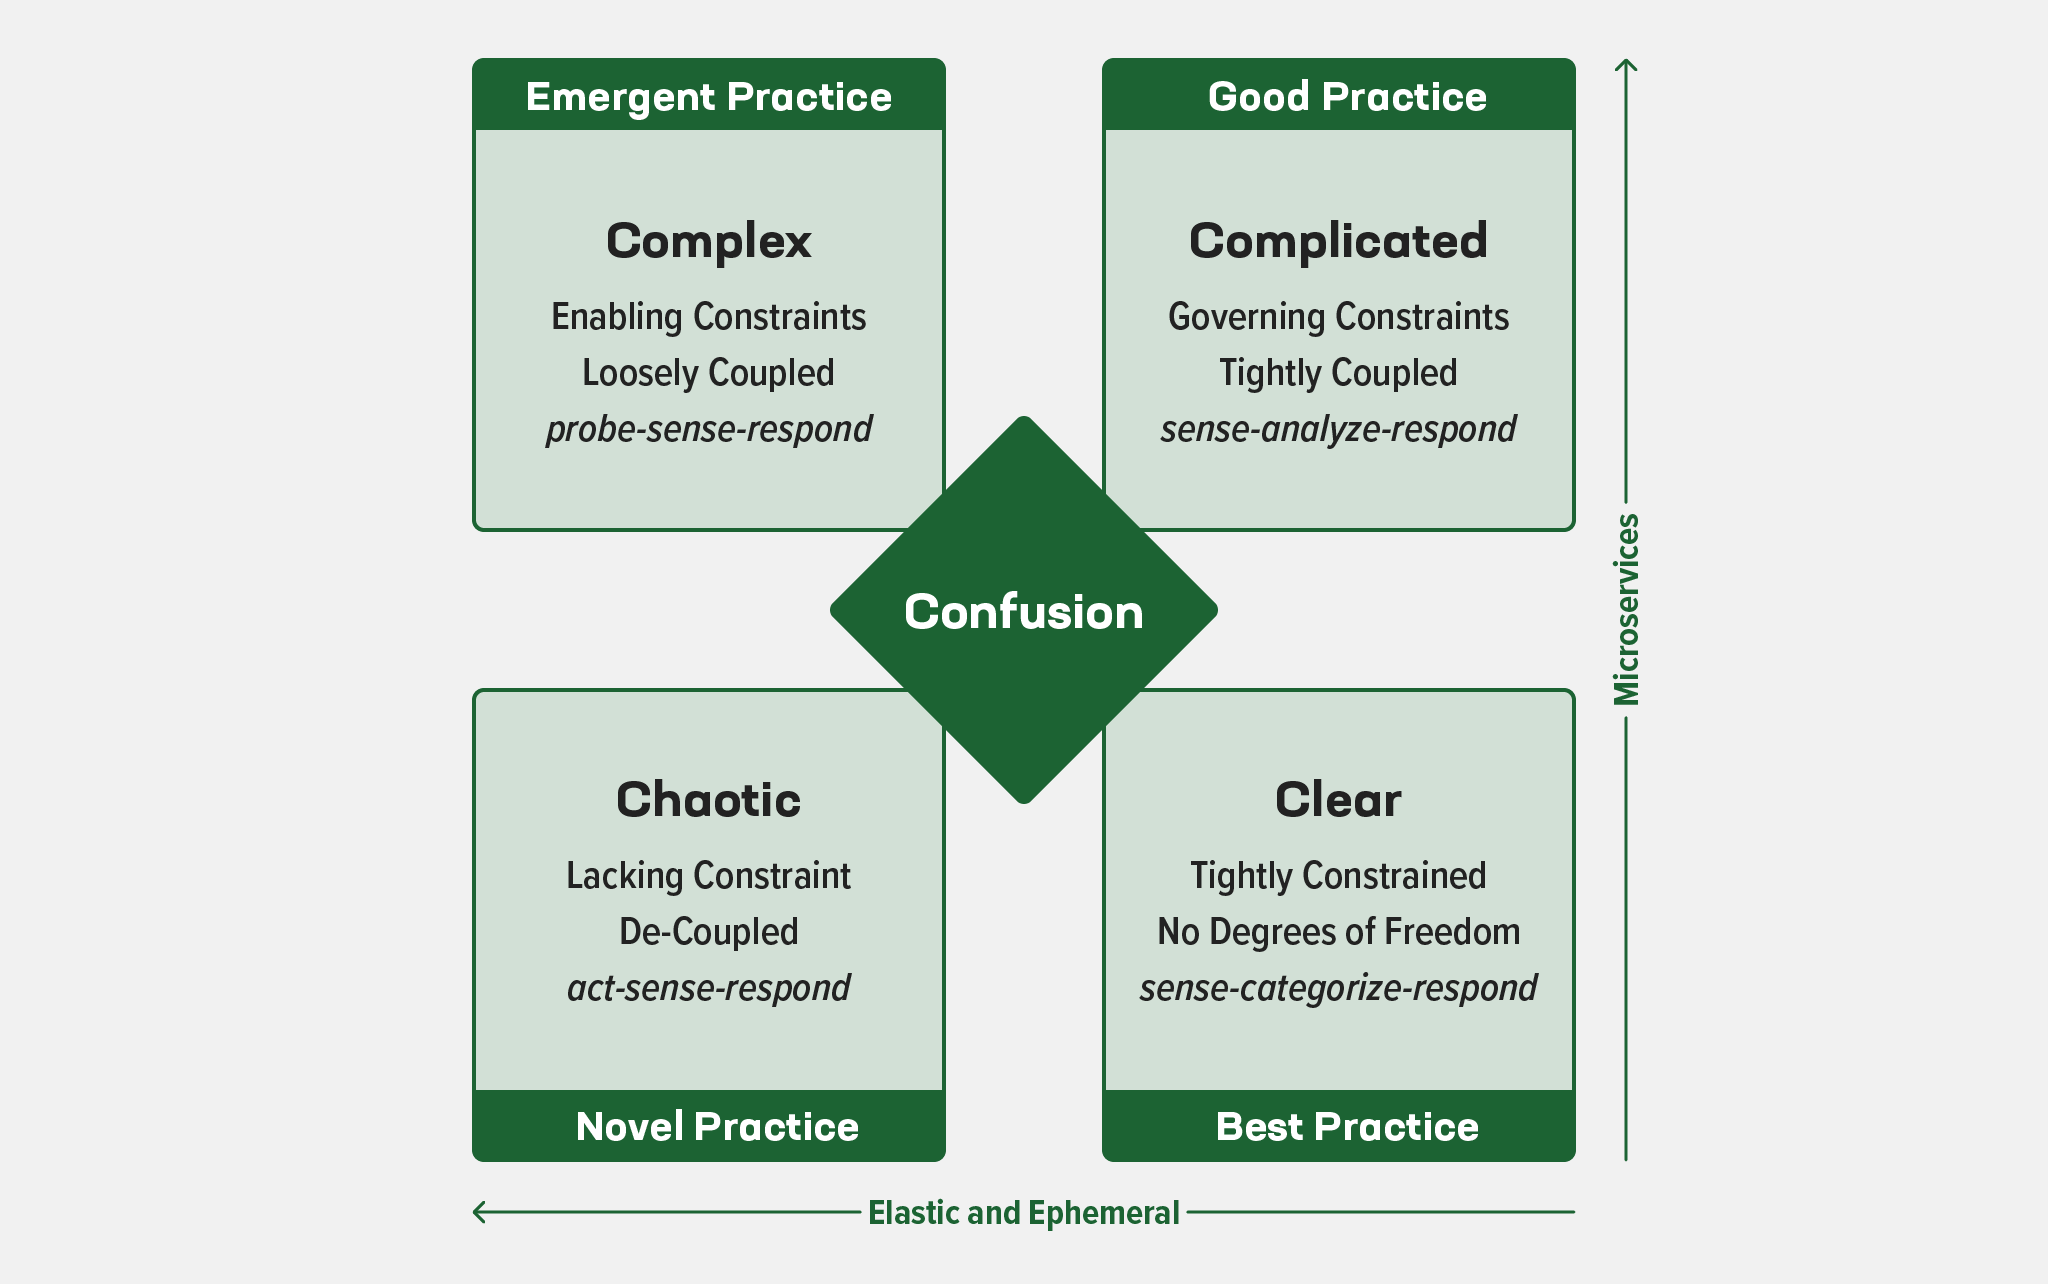
El marco Cynefin ilustra cómo podemos cambiar nuestras prácticas a medida que pasamos de lo simple a lo complejo. El reto es que avanzamos por dos caminos distintos, cada uno con sus propias características, e intentar tomar un atajo directamente de lo simple a lo complejo suele generar desorden y un progreso incompleto.
Identifiquemos qué elementos conforman los caminos de nuestro recorrido hacia las aplicaciones modernas y los entornos nativos de la nube. En el primer camino (el eje Y del diagrama de Cynefin), tenemos aplicaciones modernas que suelen basarse en arquitecturas de microservicios, donde cada aplicación desempeña una función específica. En el segundo camino (el eje X), nuestro entorno complicado es efímero, ya que las instancias de microservicios se inician y se detienen en función de la demanda, y se trasladan a distintos hosts cuando surgen problemas de red.
También debemos tener en cuenta la aparición y el enorme crecimiento de entornos en la nube como Amazon Web Services (AWS), Microsoft Azure y Google Cloud Platform (GCP). Una de las ventajas de estas nubes es su respuesta elástica, es decir, la capacidad de ampliar o reducir los recursos para adaptarlos al nivel de demanda actual. Si a esto añadimos el impacto de la orquestación de contenedores (normalmente mediante Kubernetes), empezamos a observar un comportamiento caótico a medida que el número y la ubicación de los recursos cambian con el tiempo. (Incluso esta perspectiva relativamente limitada resulta caótica, y elementos como las funciones sin servidor pueden acentuar aún más ese caos).
En una arquitectura moderna, con numerosos componentes independientes que generan la telemetría necesaria para supervisar y mantener nuestras aplicaciones, el volumen de datos es enorme y complejo. Es posible que los problemas no se repitan de forma predecible o que no sea fácil reproducirlos, ya que no controlamos por completo la infraestructura ni las vías de comunicación. Necesitamos una tecnología que nos permita realizar un seguimiento de todas las actividades y los elementos relacionados para poder comprender y analizar nuestros entornos cambiantes.
Ahí es donde entra en juego OpenTelemetry.
El futuro del rastreo distribuido con OpenTelemetry
El rastreo distribuido está provocando grandes cambios en el sector, especialmente en la forma en que las solicitudes generan una visión interna del rendimiento mediante métricas. Con el rastreo distribuido, podemos monitorizar nuevos tipos de métricas, aunque las más habituales son las relacionadas con el número de solicitudes por unidad de tiempo, el número de errores por unidad de tiempo y el tiempo que tarda una solicitud agregada durante esa unidad de tiempo.
Las métricas existen desde hace tiempo: son fáciles de gestionar y almacenar, se pueden agregar con facilidad y se prestan al análisis matemático. En OpenTelemetry, todas las aplicaciones que generan métricas pueden enviarlas a un punto de recopilación común mediante una capa de telemetría (transferencia), lo que ayuda a armonizar los datos de los servicios débilmente acoplados que las generan. Esto incluye su armonización con la infraestructura subyacente. En resumen, OpenTelemetry facilita la obtención y el envío de métricas.
OpenTelemetry también puede ayudar a resolver el problema de la deriva y el desfase de las marcas de tiempo, que dificultan la correlación de eventos. OpenTelemetry asigna a cada solicitud un TraceId, pero los datos aún pueden verse afectados por la deriva y el desfase, que suelen darse en las arquitecturas nativas de la nube. La deriva y el desfase pueden deberse a rutas de notificación con distintas duraciones o a una sincronización insuficiente entre los relojes de los distintos hosts. Al realizar un seguimiento de la comunicación entre los componentes durante el procesamiento del tráfico, el rastreo distribuido permite a OpenTelemetry medir los spans individuales —las unidades de trabajo y los componentes básicos de una traza— sin necesidad de instrumentar en profundidad la aplicación asociada.
La combinación de estas tres señales (categorías de telemetría) nos permite corregir los problemas y devolver nuestras aplicaciones a un estado apto para producción:
- Métricas – «¿Hay algún problema?»
- Trazas – «¿Dónde está el problema?»
- Registros – «¿Cuál es el problema?»
Aquí es donde retomamos la Observabilidad 2.0. La capacidad de obtener trazas y ver de inmediato qué métricas corresponden a cada traza nos proporciona un gran potencial. Por ejemplo, cuando las métricas indican un problema, el rastreo distribuido permite remontarse hasta la solicitud concreta que causó el problema inicial y seguir su progreso a lo largo de cada etapa de su procesamiento. Dado que nuestra traza se compone de los segmentos en el orden en que se producen, podemos seguir la solicitud en cada etapa de su recorrido. Comprender qué ocurrió y en qué orden —desde el evento inicial hasta el problema detectado y el resultado final— nos permite identificar exactamente «dónde» debemos centrar nuestra atención dentro de nuestras aplicaciones.
Por sencillo que parezca, el rastreo distribuido de OpenTelemetry puede ofrecernos una visión muy valiosa de lo que experimentan nuestros usuarios, ya que sirve como indicador del éxito de las solicitudes y de sus tiempos de ejecución. Como usuario, me importa mi solicitud. Como ingeniero de fiabilidad de sitios (SRE), me importan las solicitudes agregadas. OpenTelemetry me ofrece ambas perspectivas, además de la posibilidad de pasar de los datos agregados a los detalles, ya que está diseñado para que todos los datos necesarios estén disponibles en todas las aplicaciones.
Inteligencia de aplicaciones con IA y aprendizaje automático
Este nuevo flujo de datos de OpenTelemetry también nos permite adaptar y automatizar nuestra respuesta en materia de desarrollo y operaciones. Con todos estos datos acumulados, podemos dotar de mayor inteligencia a nuestra aplicación. Actualmente, F5 se centra en ayudar a sus clientes en el proceso de desarrollar e implementar lo que denominamos «aplicaciones adaptativas». Las aplicaciones adaptativas son exactamente lo que su nombre indica: aplicaciones que ajustan su comportamiento de forma automática e inteligente en respuesta a los cambios en su entorno.
Por eso cada vez vemos más inteligencia artificial (IA) y aprendizaje automático (AA) en diversas soluciones. Pero no se debe únicamente a que sean términos de moda: la IA y el AA son útiles porque ahora disponemos de suficientes datos para extraer conclusiones precisas sobre la causalidad y diseñar respuestas adecuadas.
Al hacer que los datos de telemetría sean accesibles y estén estandarizados, OpenTelemetry facilita considerablemente el camino hacia las aplicaciones adaptativas. A medida que distintos tipos de productos empiezan a generar métricas similares, y gracias al uso de las convenciones semánticas establecidas en OpenTelemetry, resulta más fácil correlacionar sus acciones durante el procesamiento de solicitudes y proporcionar esa información a algoritmos de aprendizaje automático e inteligencia artificial para que las aplicaciones y la infraestructura puedan adaptarse dinámicamente.
Cuando comprendes la ciencia de datos que hay detrás de todo y te aseguras de que tus datos de telemetría estén relacionados con tu IA y aprendizaje automático, es entonces cuando la naturaleza basada en datos de las aplicaciones adaptativas puede evolucionar y brillar.
Resumen
La codificación de la telemetría supone una ventaja evidente tanto para los usuarios de OpenTelemetry como para las aplicaciones que la utilizan como canal de telemetría. Los datos pueden recopilarse de múltiples fuentes y enviarse a cualquier herramienta compatible de agregación y análisis. Además, OpenTelemetry Collector evita que los proveedores tengan que implementar sus propios recopiladores. De este modo, pueden centrarse en mejorar su código para realizar análisis relevantes y tomar decisiones inteligentes, así como crear nuevas herramientas que ayuden a comprender este nuevo mundo complejo y caótico. De hecho, OpenTelemetry Collector —respaldado por la innovación del código abierto— tiene una enorme capacidad para trabajar con casi todos los formatos existentes y, al mismo tiempo, tender un puente hacia la tecnología del futuro.
Al centrarse en las principales clases de datos que necesitamos para comprender nuestras aplicaciones, OpenTelemetry ha hecho posible que estas nos proporcionen información más detallada tanto sobre el rendimiento como sobre los problemas del complejo mundo de las aplicaciones modernas. Al correlacionar nuestros datos y ajustarse a convenciones semánticas y estándares, OpenTelemetry facilita la transición hacia las aplicaciones modernas. Y, a medida que el proyecto sigue madurando y su adopción continúa creciendo, OpenTelemetry se consolida como la opción más clara para profundizar en nuestro conocimiento y aplicar técnicas de IA y aprendizaje automático que nos permitan comprender esa complejidad.
Para obtener más información sobre cómo utilizan OpenTelemetry los ingenieros de software de código abierto de NGINX, pruebe la arquitectura de referencia para aplicaciones modernas y la aplicación de ejemplo (Bank of Sirius).
Publicaciones relacionadas
Sobre los autores
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.