Este artículo explica cómo Volterra ayuda a los usuarios a gestionar sus aplicaciones e infraestructura como una flota. Explicaremos cómo nuestro enfoque basado en el plano de control facilita la gestión de una gran flota de clústeres de aplicaciones y lo compararemos con otros enfoques de plano de gestión multiclúster, como Google Anthos, Azure Arc, Rancher, etc.
A estas alturas, quizá se pregunte si no estaremos dándole un giro de marketing a la gestión multiclúster al llamarla «operaciones de flota». Los enfoques de gestión multiclúster y de operaciones de flota responden a casos de uso distintos y presentan arquitecturas fundamentalmente diferentes. Un enfoque multiclúster está diseñado para situaciones en las que hay relativamente pocos clústeres y el usuario desea gestionar estos clústeres de infraestructura mediante un modelo operativo coherente. En cambio, el enfoque de flota está pensado para situaciones en las que existe una gran cantidad de clústeres (por ejemplo, clústeres de K8s en robots, vehículos, pasarelas industriales, decenas de regiones de nube pública, etc.) y el usuario desea desplegar la misma aplicación y la misma configuración de red y seguridad en todos ellos. En las dos secciones siguientes se describen y comparan con mayor detalle los enfoques de gestión multiclúster y de operaciones de flota.
Enfoque multiclúster
Un enfoque de gestión multiclúster está diseñado para abordar casos de uso en los que un único equipo gestiona un número relativamente reducido de clústeres. Algunos ejemplos de estos escenarios incluyen decenas de clústeres distribuidos entre varias zonas de disponibilidad para reducir el radio de impacto. Del mismo modo, los usuarios pueden optar por tener varios clústeres distribuidos entre varias regiones para cumplir los requisitos normativos.
Los dos ejemplos siguientes muestran, a grandes rasgos, cómo funcionan las soluciones multiclúster:
Configuración
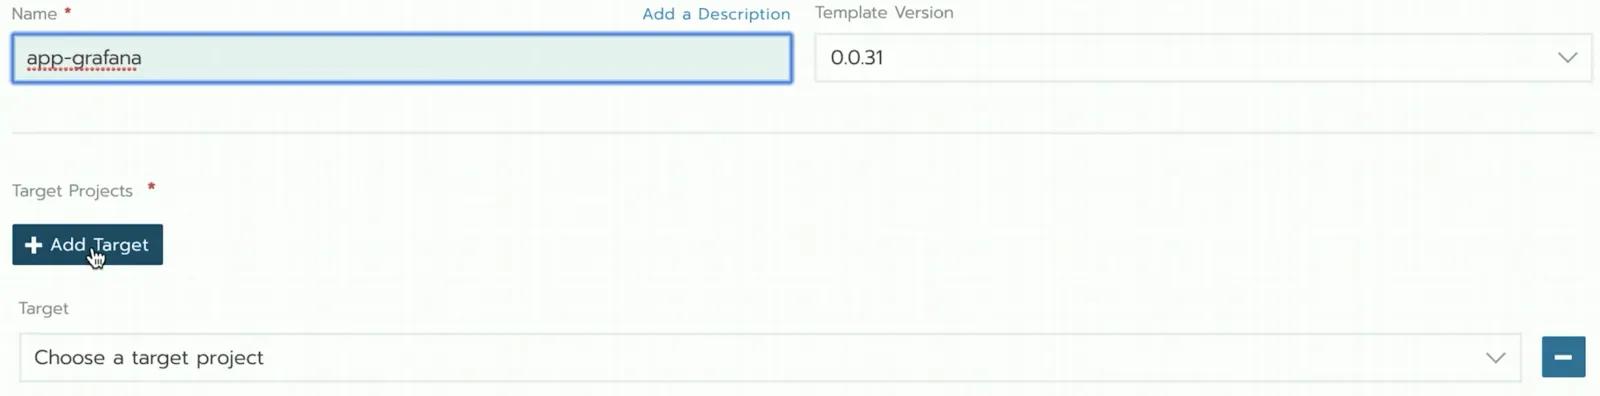
Veamos un ejemplo de despliegue de una aplicación mediante el enfoque multiclúster de Rancher, como se muestra en la Figura 1. En un enfoque multiclúster, el cliente selecciona uno a uno los sitios de destino para el despliegue de la aplicación. Este método de selección individual funciona cuando se dispone de unos pocos clústeres. Sin embargo, no está diseñado para gestionar, por ejemplo, mil clústeres.
Observabilidad
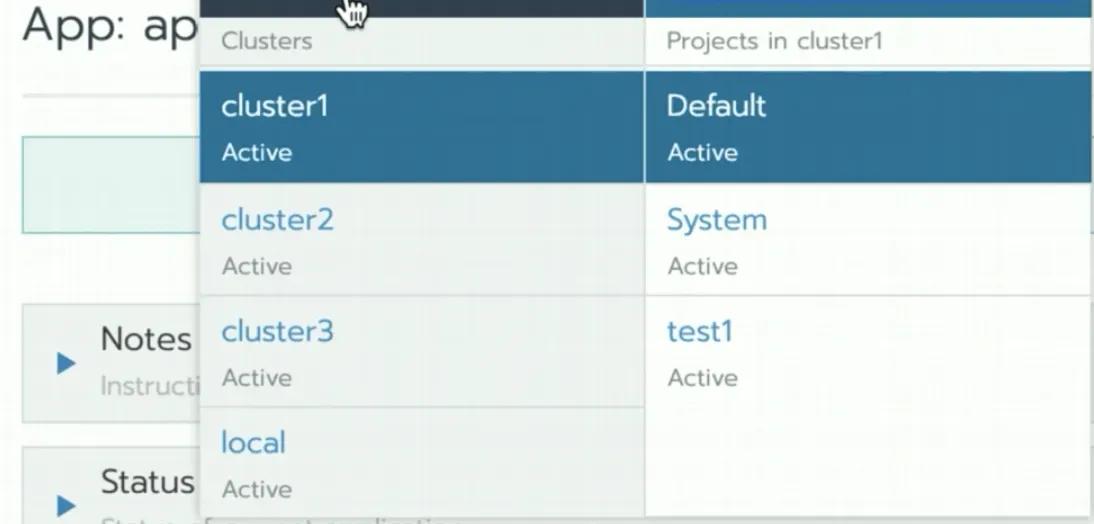
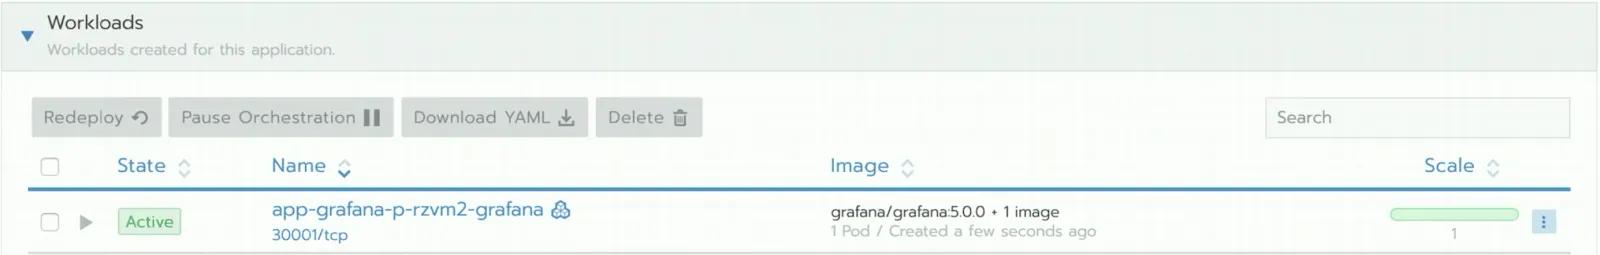
La figura 2 muestra cómo funciona la observabilidad en un enfoque multiclúster, utilizando Rancher como ejemplo. En un enfoque multiclúster, el cliente debe hacer doble clic en cada clúster, uno por uno, para consultar el estado de los pods desplegados y el uso de los recursos de CPU y memoria. Este enfoque, que consiste en supervisar los sitios de destino uno por uno, resulta adecuado para un número reducido de clústeres, pero no para gestionar una gran cantidad de ellos.
Clúster 1:
Clúster 2:

Un enfoque obvio para resolver el problema descrito en el primer ejemplo sería crear algún tipo de automatización que repitiera las tareas en cada uno de los clústeres. Por ejemplo, cada vez que se añadiera un nuevo clúster, el script podría realizar la siguiente operación para desplegar una nueva aplicación (por ejemplo, checkoutservice).
export KUBECONFIG=~/Documents/kubeconfig/ce01-ashburn-aws-staging
kubectl apply -f checkoutservice.yaml
Sin embargo, será necesario desarrollar una automatización para cada operación: despliegue, actualización, políticas, reserva de recursos, etc. Esta automatización no solo tendrá que ejecutar cada operación en numerosos clústeres, sino también gestionar las situaciones de error. Además, cuando se den escenarios complejos —por ejemplo, pruebas beta en un subconjunto de clústeres o actualizaciones graduales en todos ellos—, la automatización será cada vez más compleja. Nos dimos cuenta de ello al principio del proceso y creamos un plano de control distribuido que ofrece toda esta funcionalidad mediante un enfoque de operaciones de flota, que se describe a continuación.
Enfoque de Volterra para las operaciones de flota
Operaciones de Flota significa que el cliente define de forma declarativa y una sola vez sus requisitos para la flota, y el sistema asume la responsabilidad de garantizar que los sitios afectados se ajusten a dichos requisitos. Algunos ejemplos son la versión del software de las aplicaciones, la versión del software de la infraestructura (por ejemplo, la versión del sistema operativo), la política de red, la política de seguridad y la reserva de recursos.
Una vez que la configuración deseada entra en vigor, el sistema permite a los usuarios consultar el estado y la salud de la flota. Esto significa que los usuarios obtienen una vista agregada de la salud de la infraestructura y las aplicaciones de todos los sitios de la flota en un único panel, lo que reduce la complejidad operativa para el equipo de operaciones del cliente. Los usuarios no tienen que acceder a cada sitio o clúster uno por uno para determinar su estado ni desarrollar herramientas de automatización para agregar la información.
El enfoque de Volterra para las operaciones de flota consta de tres componentes principales —segmentación, configuración y observabilidad—, que analizaremos en las siguientes secciones.
Segmentación de la flota
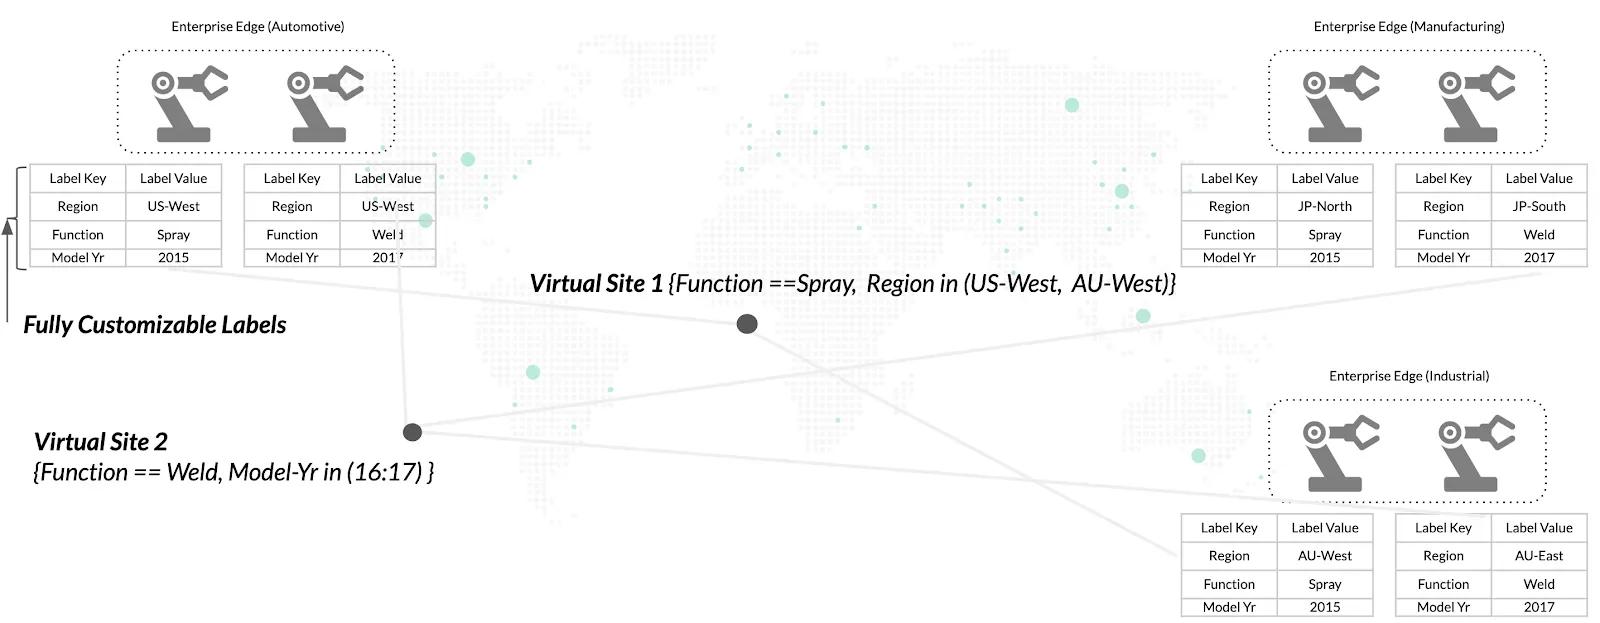
Los usuarios suelen tener en la flota una combinación de sitios de computación, como los de desarrollo, pruebas y producción. Las distintas cargas de trabajo deben implementarse en un segmento específico de sitios debido a políticas de la organización; por ejemplo, las cargas de trabajo de desarrollo solo pueden ejecutarse en sitios de desarrollo. Permitimos que los usuarios etiqueten los sitios de forma flexible mediante una etiqueta compuesta por dos partes: clave y valor. Algunos ejemplos son:
- Clave de etiqueta=región. Valor de etiqueta = Oeste de EE. UU., Norte de Japón, Sur de Japón
- año-modelo=(2015, 2016, 2017, 2018)
- function=(pulverización, soldadura)
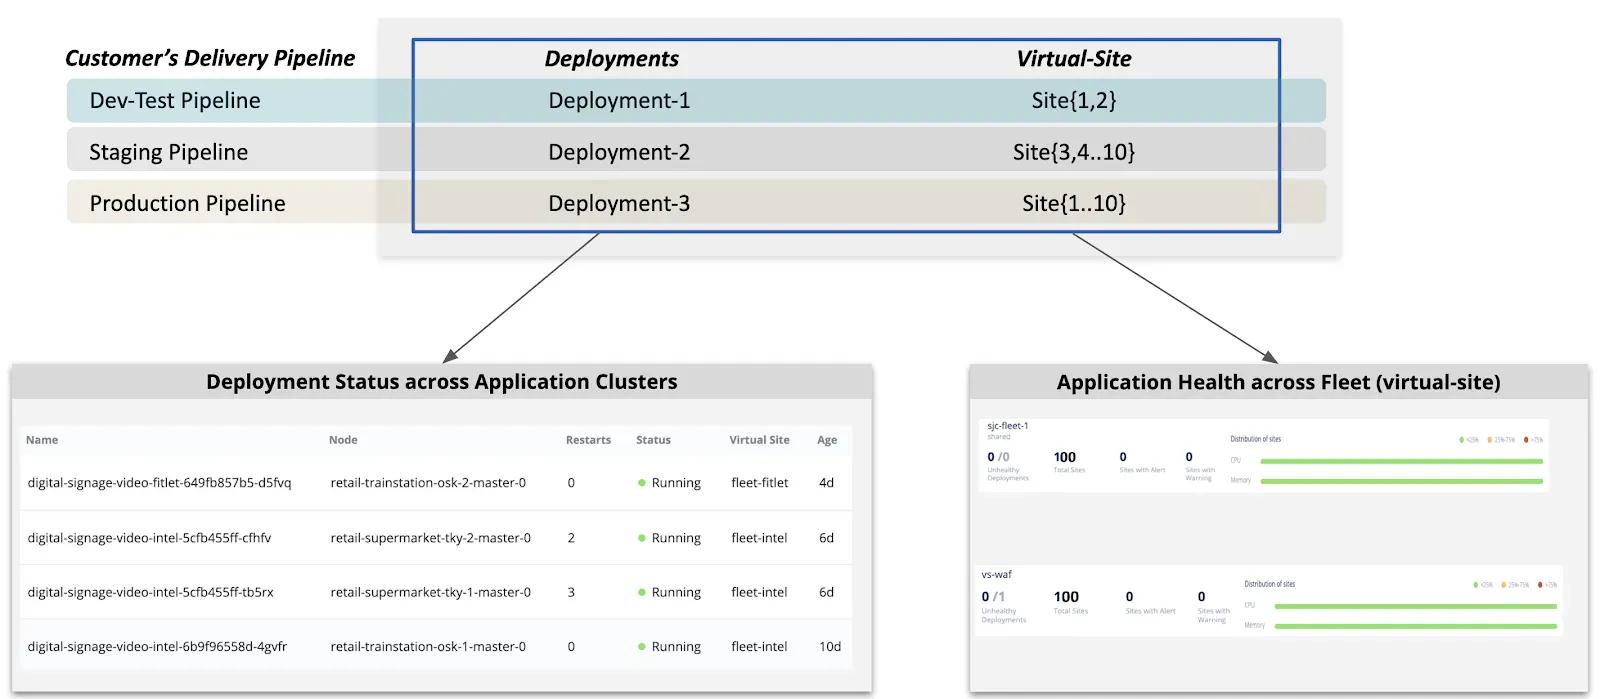
Una vez etiquetados los sitios, los usuarios pueden definir un «sitio virtual» mediante condiciones de clave-valor de las etiquetas. En un entorno multinube, por ejemplo, pueden etiquetar sus sitios como desarrollo, preproducción y producción. La figura 3 muestra un ejemplo de un caso de uso de robótica que utiliza los valores de clave de etiqueta descritos anteriormente.
A continuación se muestra un fragmento de configuración de Volterra en el que el usuario puede utilizar la sintaxis de blend/go-sdk para crear un sitio virtual. En este ejemplo concreto, los sitios individuales se etiquetaron con la clave de etiqueta key=ves.io/country y el valor de etiqueta ves-io-jpn.
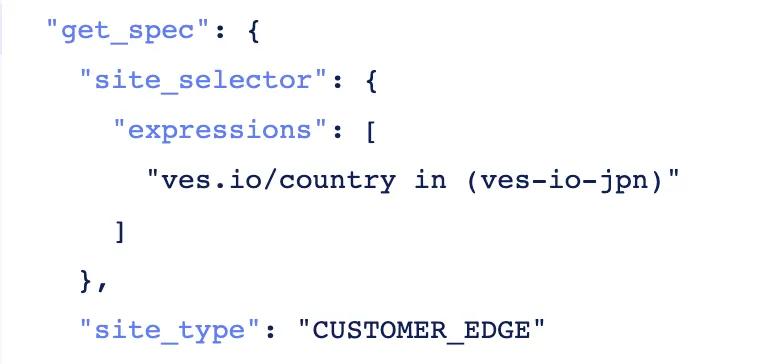
Los usuarios están acostumbrados a un modelo operativo en el que definen de antemano segmentos de su flota y, posteriormente, etiquetan sus sitios durante el aprovisionamiento para incluirlos en ella; los sitios virtuales encajan perfectamente con el modelo operativo existente de los usuarios. Cuando se aprovisiona un nuevo sitio con la etiqueta adecuada, este se incluye automáticamente en el sitio virtual definido previamente, sin necesidad de realizar pasos manuales adicionales. Además, Volterra detecta información preconfigurada, como el fabricante del hardware o el tipo de nube pública, para rellenar previamente las etiquetas del sistema. Los usuarios pueden optar por utilizar estas etiquetas detectadas automáticamente para definir sus sitios virtuales.
Configuración de la flota
Las capacidades de configuración de flotas se pueden describir mejor mediante los tres ejemplos siguientes:
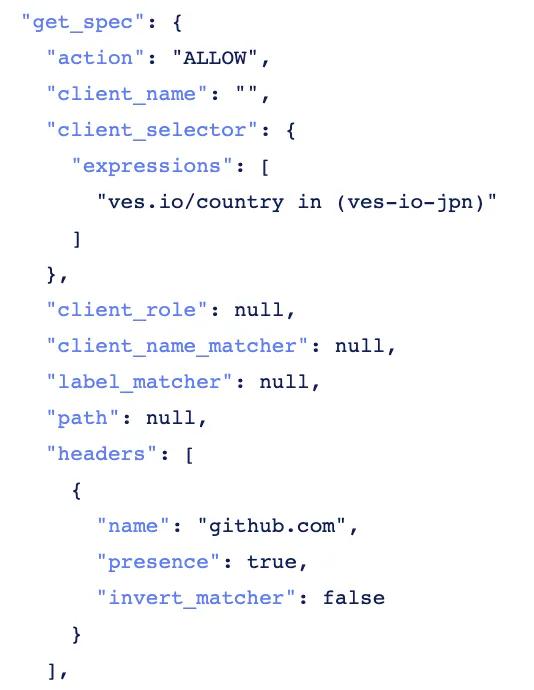
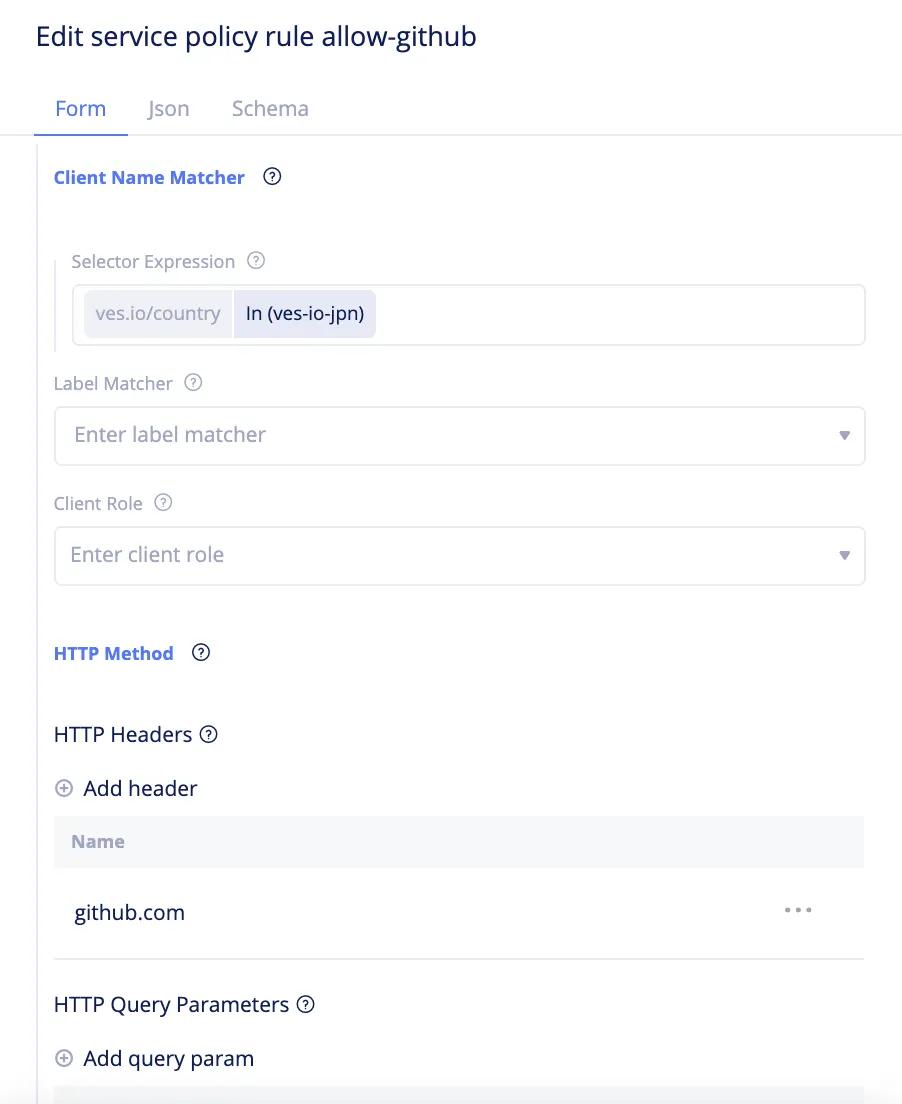
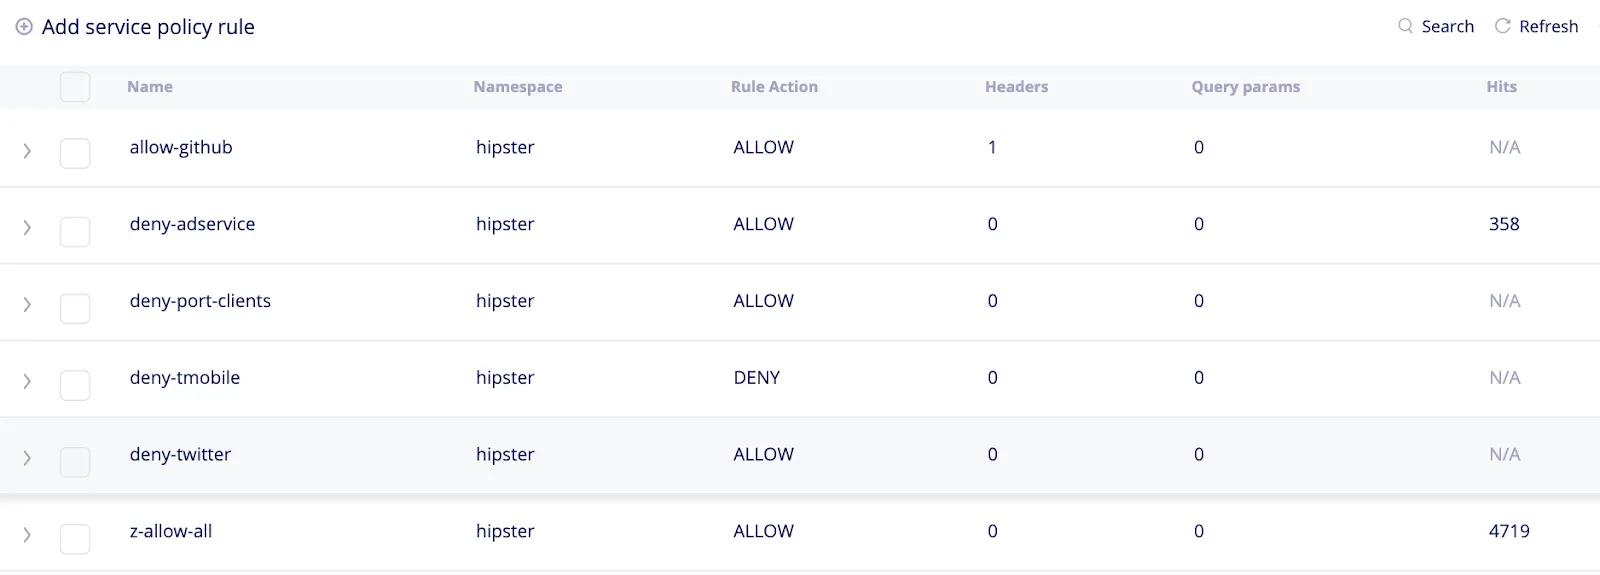
- Configuración de una política de red/seguridad -- Veamos el ejemplo de un cliente que está implementando un nuevo servicio que requiere que cada clúster pueda comunicarse con una URL específica, por ejemplo, github.com. Normalmente, los usuarios emplean listas blancas, lo que significa que los clústeres solo pueden acceder a destinos específicos. Por tanto, para implementar este nuevo servicio, los usuarios tendrían que acceder a cada clúster y modificar la política de red para añadir github.com a la lista blanca. Además, el cliente desea probarlo en algunos sitios de prueba antes de implementarlo en todos los sitios. Para lograrlo en Volterra, el cliente comienza definiendo en la consola SaaS de Volterra un sitio virtual de «prueba» que selecciona un segmento de la flota. A continuación, el usuario define una política de red, como una lista blanca de URL (github.com en este ejemplo), y la aplica al sitio virtual de «prueba». El plano de control distribuido de Volterra envía la política de red al plano de control local de cada sitio seleccionado por el sitio virtual (tal como se ha definido anteriormente). El plano de control local de cada sitio aplica la política de red y recopila estadísticas sobre las reglas activadas en cada sitio. Una vez que el cliente comprueba que el servicio funciona según lo previsto, puede aplicar la política de red al sitio virtual de «producción», que selecciona los sitios restantes de la flota. A continuación se muestra un fragmento de configuración en JSON y mediante la interfaz de usuario del sistema de Volterra.
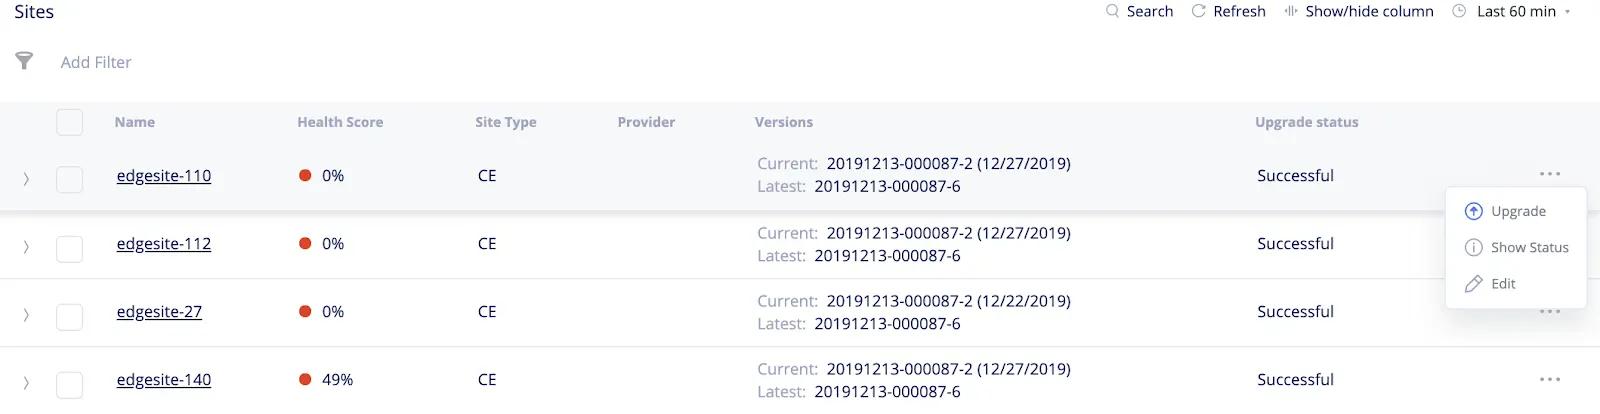
- Actualización del software de infraestructura -- La funcionalidad de configuración de flotas permite al usuario actualizar el software de infraestructura, por ejemplo, la versión del sistema operativo, en toda la flota (o en un segmento de ella). En primer lugar, el usuario especifica que desea actualizar el sistema operativo de la versión 1 a la versión 2. A continuación, define una estrategia de despliegue para la flota, como una actualización gradual o un despliegue azul/verde, entre otras. Una actualización gradual implica actualizar de forma secuencial el sistema operativo de cada sitio de la flota (o segmento de esta). Una estrategia de despliegue azul/verde permite al usuario probar la actualización en un conjunto de sitios «azules» (por ejemplo, sitios de desarrollo) y comparar su estado con el de los sitios «verdes» (por ejemplo, sitios de producción) que no se han actualizado. En ambos casos, el plano de control distribuido de Volterra envía el software de la versión 2 al plano de control local de cada sitio seleccionado por el sitio virtual y conforme a la estrategia de despliegue definida. El plano de control local de cada sitio actualiza el sistema operativo mediante un esquema A/B: crea una nueva partición, despliega la versión 2 en ella y permite al cliente evaluar su estado. Si la instalación de la versión 2 no se completa correctamente, el sistema revierte automáticamente a la versión 1 de la partición original. A continuación se muestran algunas capturas de pantalla que ilustran cómo puede el usuario actualizar el software de infraestructura mediante el portal SaaS de Volterra. Como se muestra en la siguiente figura, el usuario puede consultar la versión actual del software de infraestructura y la última versión disponible para todos los sitios. Asimismo, puede actualizar fácilmente sitios concretos o todos ellos, según lo establecido por el modelo operativo.
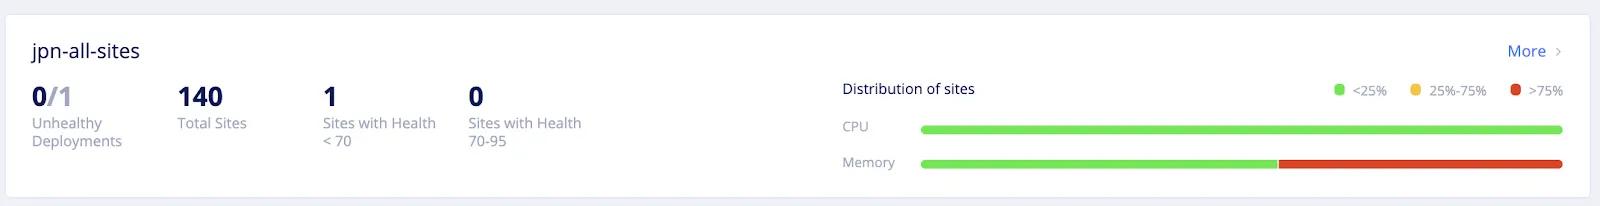
- Despliegue de aplicaciones en toda la flota -- Volterra proporciona un objeto denominado Virtual Kubernetes (vK8s) que permite a los usuarios gestionar aplicaciones en toda su flota mediante las API de Kubernetes. El usuario despliega sus aplicaciones utilizando métodos estándar de Kubernetes (es decir, un archivo Kubeconfig y las API de Kubernetes) con un archivo de manifiesto de despliegue e indica el segmento de sitios (o toda la flota) en el que debe desplegarse la aplicación. A continuación, Virtual Kubernetes (vK8s) de Volterra asume la responsabilidad de desplegar la aplicación en cada sitio de la flota (o del segmento). Si se produce algún error durante el despliegue de la aplicación, como fallos de conectividad o de infraestructura, Virtual Kubernetes de Volterra continúa reintentando el despliegue conforme al paradigma de Kubernetes de un modelo de consistencia eventual. La siguiente captura de pantalla muestra un ejemplo en el que el usuario despliega una aplicación denominada «kuard» (véase Kubernetes-up-and-running-demo-app) en un sitio virtual denominado «jpn-all-sites», que selecciona 140 sitios de la flota. Para añadir un nuevo despliegue, el usuario solo tiene que hacer clic en «Add Deployment» y especificar la ubicación del despliegue mediante el sitio virtual.
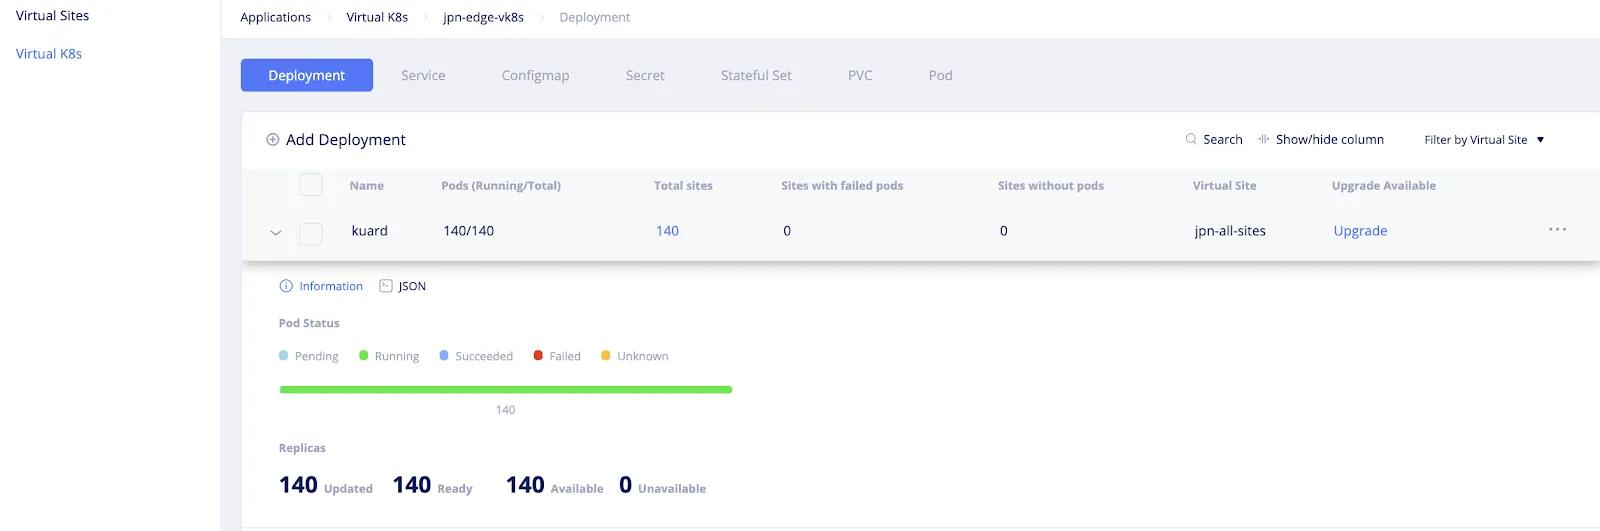
Si se añade un nuevo sitio a la flota con la etiqueta adecuada, este se incorpora automáticamente al sitio virtual (jpn-all-sites en este ejemplo) y la configuración de la flota (es decir, el despliegue de Kuard en este ejemplo) se aplica automáticamente al sitio recién añadido, lo que reduce la carga de trabajo de los equipos de operaciones y elimina los errores humanos.
Observabilidad de la flota
Los sitios virtuales y Kubernetes virtual (vK8s) no solo se utilizan para la configuración, sino también para agregar el estado de los sitios distribuidos de la flota. Se trata de una herramienta realmente potente en comparación con otras soluciones, en las que los usuarios tendrían que desarrollar herramientas para obtener el estado de cada sitio por separado y agregar la información. El sistema agrega automáticamente el estado de todos los sitios y lo muestra en un único panel, lo que reduce la complejidad operativa para el equipo de operaciones del cliente. El estado recopilado abarca numerosos aspectos, como el estado del despliegue de las aplicaciones, el estado de los sitios y el estado de las aplicaciones, entre otros.
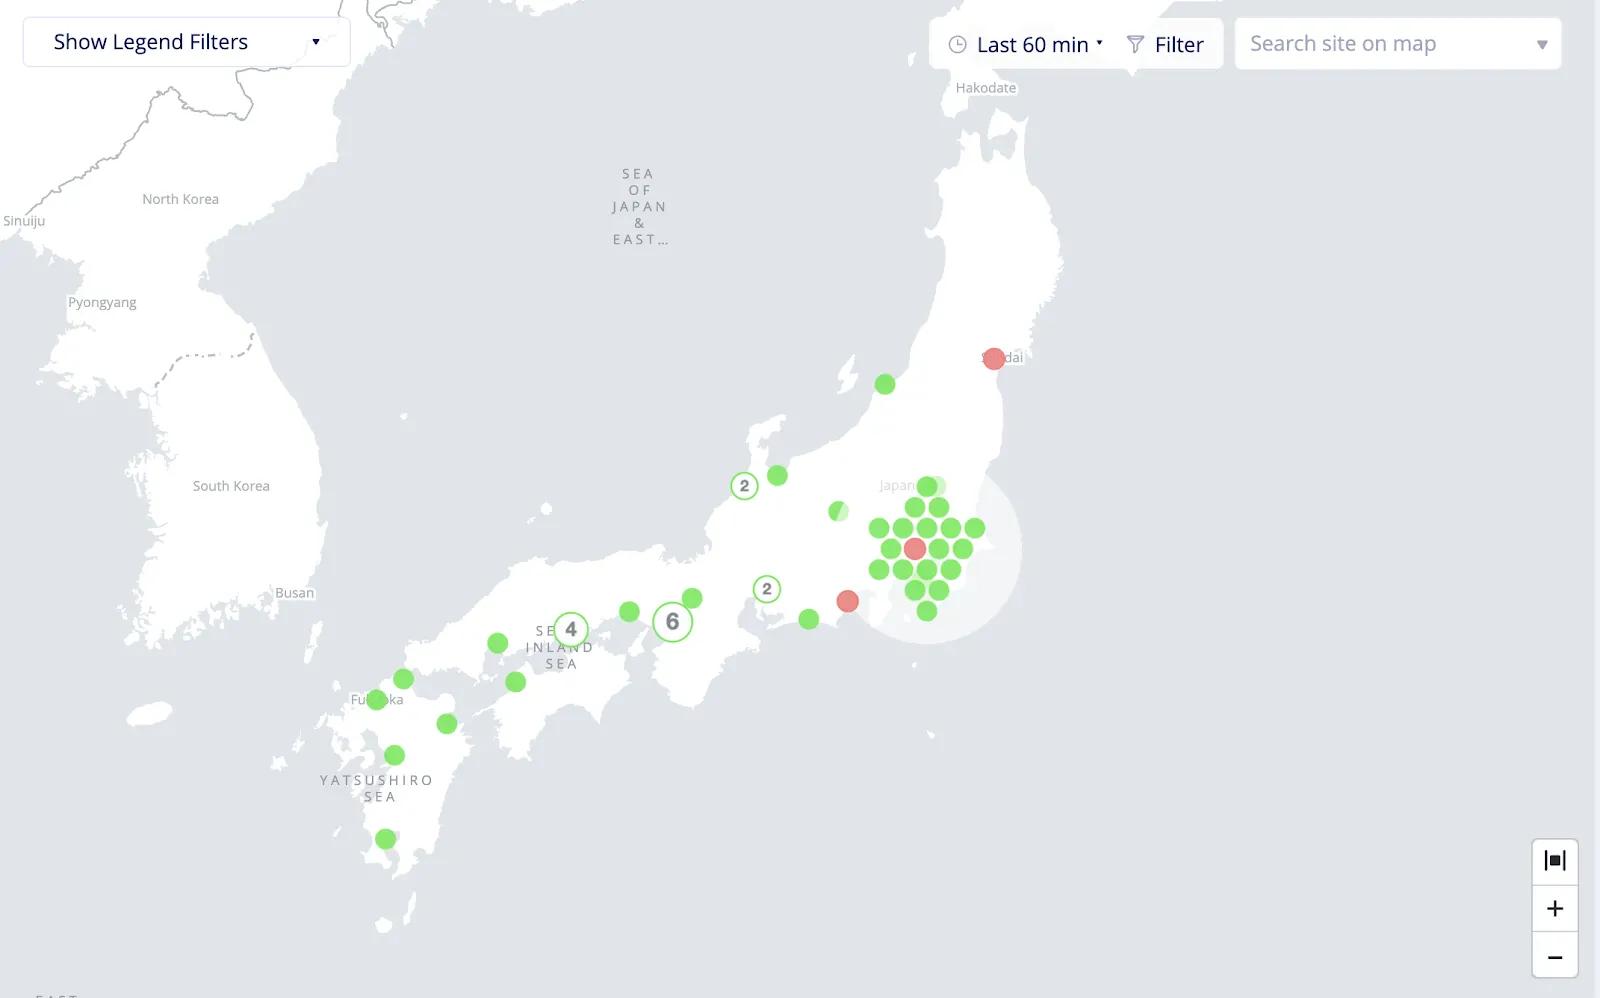
Los usuarios pueden obtener rápidamente una visión general del estado de todos sus sitios en un mapa, como se muestra en la siguiente captura de pantalla. El color indica si la puntuación de estado es superior a 75 (verde), está entre 40 y 75 (naranja) o es inferior a 40 (rojo). La puntuación de estado es una puntuación agregada que tiene en cuenta la conectividad, la fiabilidad, la seguridad y el rendimiento (es decir, el consumo de recursos).
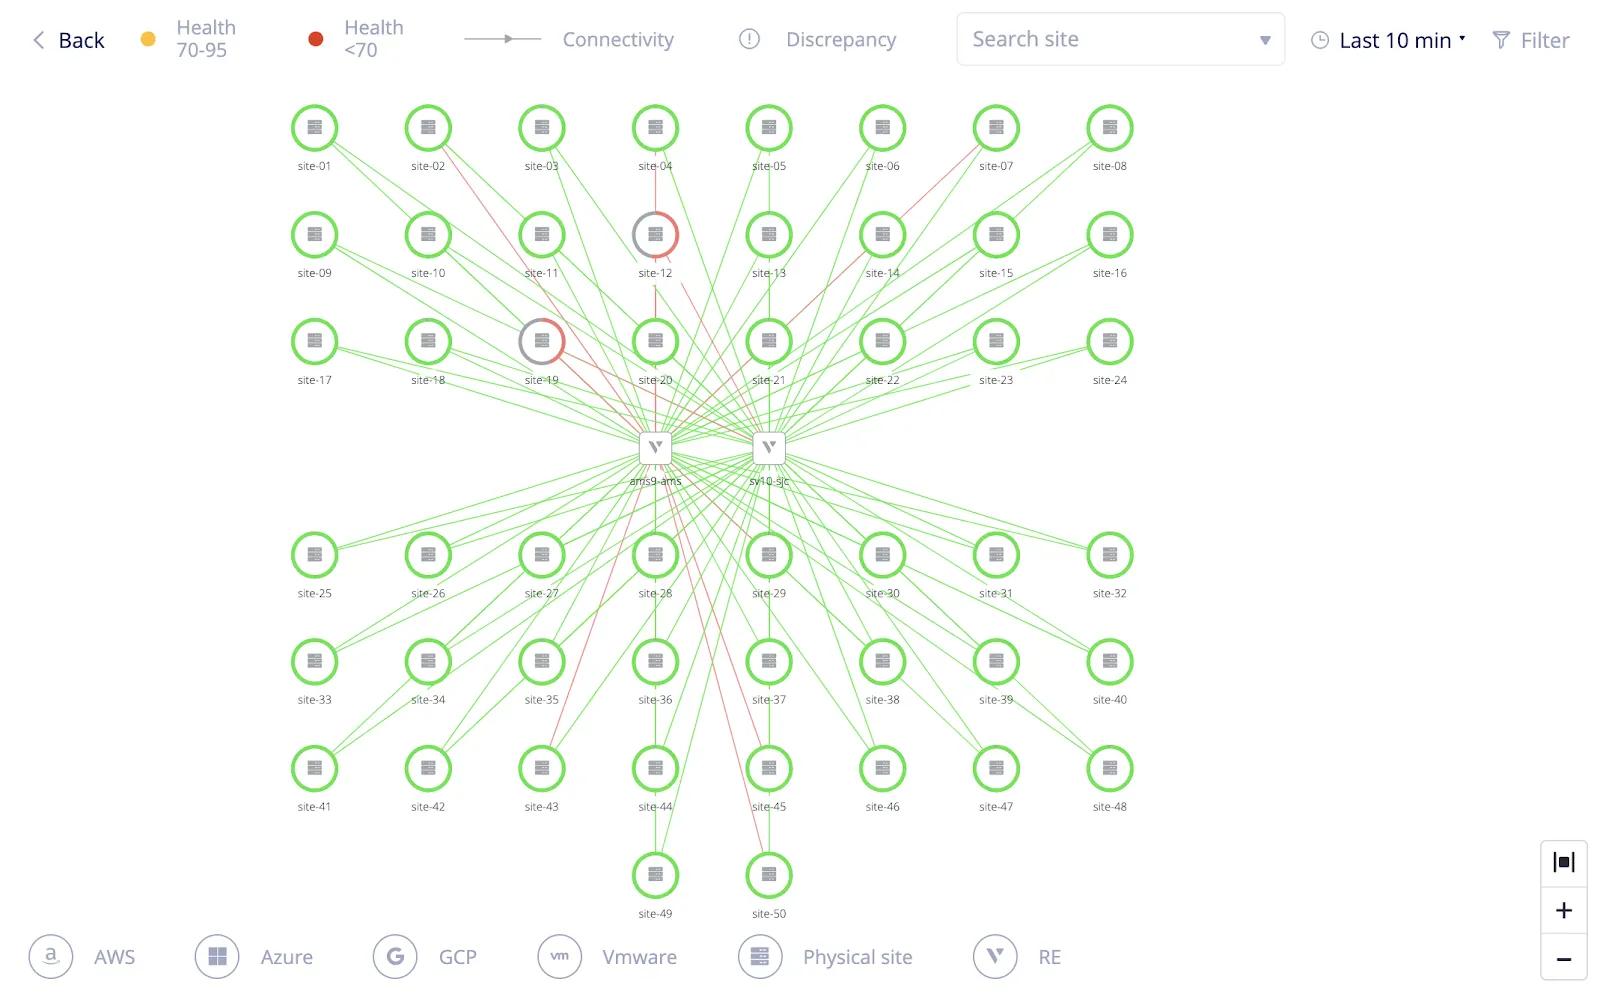
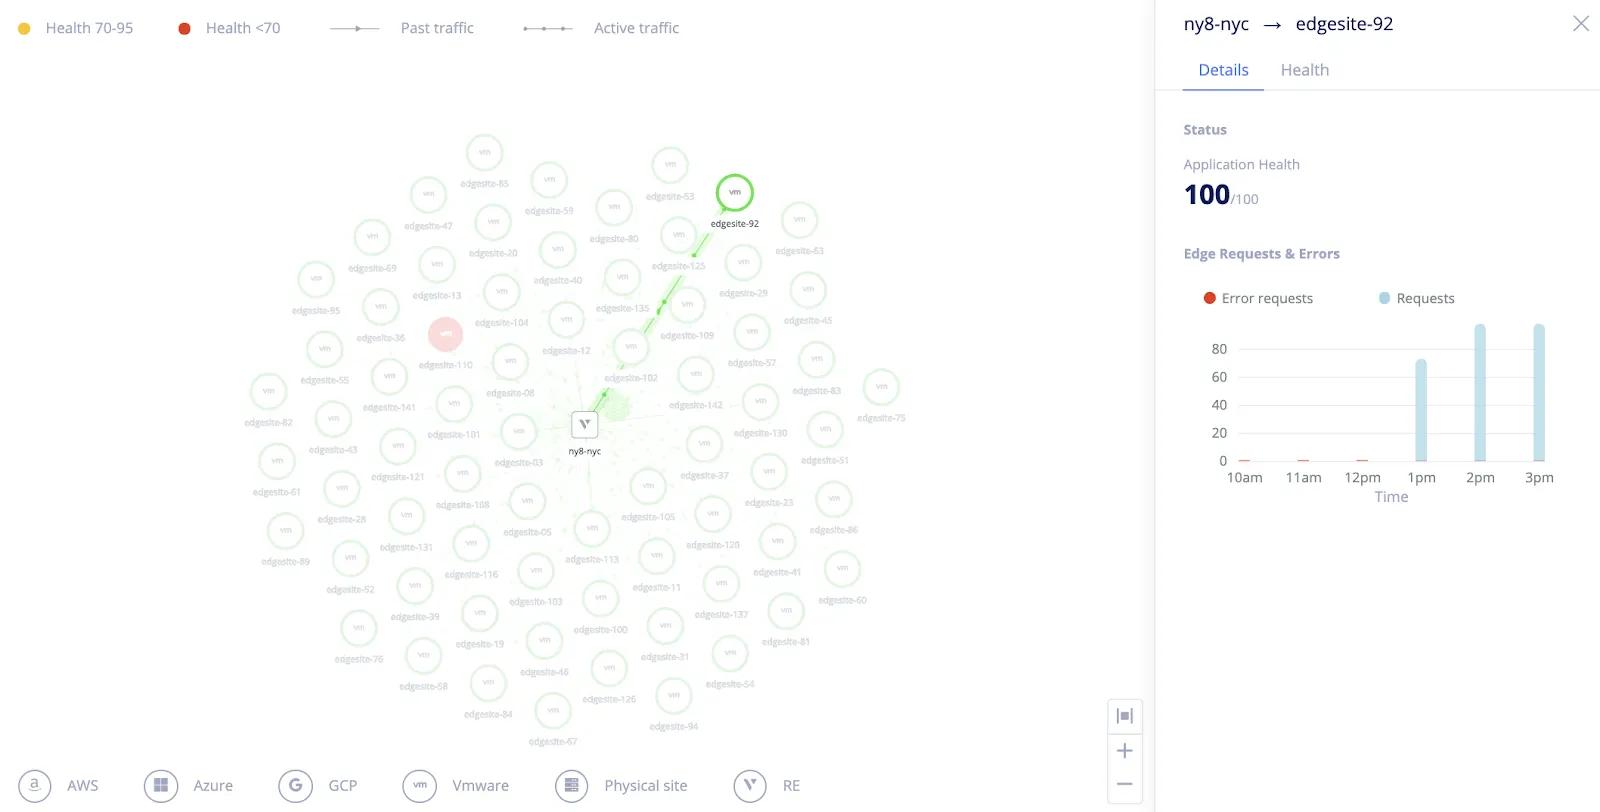
Los usuarios también pueden consultar una vista agregada de la conectividad de todos sus sitios, junto con el estado de estos. También se muestra el estado de la conectividad de cada enlace que conecta los sitios con la red troncal de Volterra, tal como se ilustra en la Figura 10. El usuario puede hacer clic en los enlaces con un rendimiento deficiente, según su estado, para consultar estadísticas detalladas sobre solicitudes y errores, así como solucionar cualquier problema de conectividad, tal como se muestra en la Figura 11.
A continuación, el usuario puede consultar información agregada de todos los sitios mediante la distribución de la carga de CPU y memoria entre ellos. Esta información resulta útil para que los administradores de TI o de los sitios identifiquen cuáles se están utilizando de forma intensiva y corren el riesgo de quedarse sin recursos. Los administradores de los sitios pueden configurar alertas para recibir notificaciones cuando el consumo de recursos supere determinados umbrales. En esta captura de pantalla, los usuarios pueden ver que la mitad de los sitios consume más del 75 % de la memoria disponible. No tienen que acceder a cada sitio por separado ni desarrollar herramientas adicionales para obtener esta información.
Las funciones de verificación continua del objeto de flota proporcionan el estado de los despliegues de POD: cuántos POD se han desplegado, cuántos están en curso y cuántos han fallado. Una vez desplegados, los usuarios también pueden consultar el estado de los Pods: si están en ejecución, esperando una imagen, sin memoria, etc.
Además, los usuarios pueden consultar una vista agregada de la eficacia de la política de seguridad y ver las detecciones de todos sus sitios, como se muestra en la siguiente captura de pantalla.
Resumen
Para obtener más información sobre cómo se utilizó el enfoque de Volterra para las operaciones de flotas a fin de gestionar una flota de 3000 clústeres, puede ver la presentación de Volterra en una conferencia de Kubernetes y leer este artículo de Jakub Pavlik
En el próximo artículo del blog, titulado «Time to Effect», explicaré cómo el plano de control distribuido y la red troncal de Volterra ayudan a propagar la configuración y garantizar su coherencia entre sitios distribuidos por todo el mundo en muy poco tiempo. ¡No os lo perdáis!
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.