
Los beneficios de una arquitectura de datos bien diseñada van más allá de los procesos operativos. Incluyen una mayor eficiencia operativa estratégica, un conocimiento más profundo del negocio y la capacidad de aprovechar oportunidades de negocio adyacentes, todo ello de una forma más ágil.
La aplicación de reparto de comida, seis meses después...
En un artículo anterior, presentamos un servicio hipotético de pedido y entrega de comida, así como varios flujos de trabajo clave para las operaciones diarias: el proceso de pedido del cliente, el flujo de recogida y entrega de comida y el procesamiento de pagos. Analizamos cómo una estrategia de datos deliberada en torno a los datos clave que alimentan estos flujos de trabajo da lugar a procesos empresariales más sólidos, ágiles y escalables.
En este artículo, me gustaría ir más allá de la eficiencia operativa cotidiana y mostrar las ventajas más estratégicas y a largo plazo de diseñar la arquitectura de datos con previsión. Si avanzamos seis meses desde nuestro escenario inicial y suponemos que nuestra aplicación ha tenido éxito, los responsables de la empresa ya habrán identificado algunas oportunidades nuevas y emergentes. Ahora preguntan a los especialistas en tecnología con qué rapidez y facilidad pueden ajustarse y adaptarse los sistemas subyacentes a determinadas oportunidades y a los retos asociados:
- El crecimiento del servicio se está acelerando y la empresa desea expandirse a otras ciudades.
- Como parte de la expansión, el servicio desea entrar en el lucrativo mercado de California, lo que añade requisitos adicionales de gobernanza de datos.
- Los tiempos de entrega han ido aumentando, a menudo como consecuencia de picos imprevistos de demanda. ¿Puede la tecnología ayudar a resolver este problema?
- La empresa se enfrenta a la competencia de nuevas startups, y algunos restaurantes se han planteado cambiarse a un servicio de la competencia. ¿Podemos demostrar que aportamos valor añadido a nuestros proveedores (los restaurantes) para ayudar a fidelizarlos?
Los cuatro retos de ejemplo enumerados pueden dividirse en dos grandes categorías:
En primer lugar, optimizar y mejorar la eficiencia de los procesos empresariales clave del día a día («tácticos»).
Dos, generar nuevos conocimientos que aporten valor a más largo plazo («estratégico») a la empresa, ya sea directa o indirectamente, a través de sus clientes.
Los dos primeros retos nuevos —la expansión territorial y los requisitos de cumplimiento asociados— están relacionados con procesos empresariales tácticos y, por tanto, son de carácter más operativo. Los dos últimos retos son de carácter más estratégico.
Veamos primero las cuestiones tácticas y operativas.
Mejoras de la eficiencia operativa
Con la expansión geográfica a otras ciudades, podemos encontrarnos con varios problemas. Un posible problema en el flujo de trabajo de las entregas es la ambigüedad de las direcciones postales: una misma dirección (por ejemplo, «100 Main St.») puede existir en varias ciudades. Otro posible problema es que las distintas ciudades pueden encontrarse en zonas horarias diferentes; si no se tiene esto en cuenta, una recogida a las 18:00 MDT podría entregarse con una hora de retraso en una ciudad vecina con horario PDT (a las 18:30 PDT). La arquitectura de datos descrita en nuestro artículo anterior incorporaba el concepto de una representación «normalizada» —única a nivel global— de los elementos de datos, lo que resuelve ambos posibles problemas y permite que la aplicación se adapte implícitamente a estos requisitos adicionales.
La segunda cuestión táctica es el cumplimiento de los requisitos adicionales de gobernanza de datos del estado de California. El conjunto completo de cuestiones relacionadas con la Ley de Privacidad del Consumidor de California (CCPA) daría para toda una serie de artículos, pero uno de sus aspectos consiste en poder recopilar todos los datos de un cliente, indicando cuándo se recopilaron y cuál es su fuente. Como ya se ha explicado, crear un marco de arquitectura de datos que permita a la canalización principal de ingesta de datos añadir anotaciones de metadatos —como marcas de tiempo— facilita el cumplimiento de requisitos adicionales de gobernanza de datos con un esfuerzo adicional mínimo.
Valor estratégico
Además del valor empresarial generado por las mejoras en los flujos de trabajo y procesos tácticos cotidianos de la empresa, otra ventaja —posiblemente más importante— es el valor estratégico que aporta la capacidad tanto de inclinar a nuestro favor el terreno de juego actual como de abrir nuevos ámbitos en los que participar.
Reimaginando los flujos de trabajo operativos para aplicaciones adaptativas
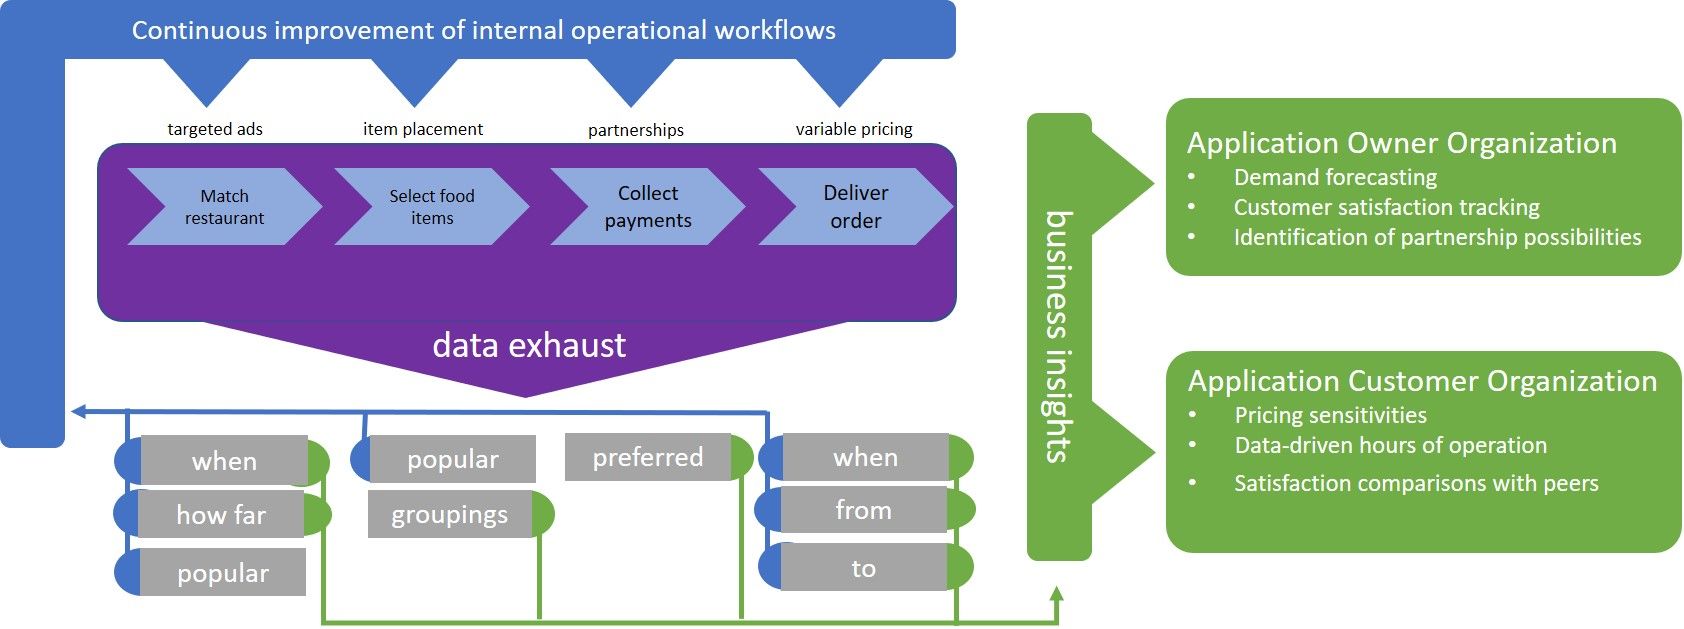
Una de las ventajas estratégicas consiste en la capacidad de «inclinar la balanza» modificando el diseño de los principales flujos de trabajo operativos. Esto va más allá de su mera optimización: implica replantearlos por completo. Una arquitectura de datos sólida y orientada al futuro permite aprovechar de forma ágil y eficiente las capacidades clave —la agregación y el análisis de datos— necesarias para abordar, mediante precios dinámicos, el problema antes mencionado del aumento de los plazos de entrega provocado por la variabilidad de la demanda.
Más concretamente, gracias a la planificación previa de la arquitectura de datos, esta:
- Conserva la marca de tiempo de cada pedido y entrega, utilizando una sintaxis y una semántica coherentes, incluso en varias tablas de la base de datos
- Mantiene un registro histórico tanto de las ubicaciones de recogida como de las de entrega, utilizando también una sintaxis y una semántica coherentes
Como resultado, los datos de dos flujos de trabajo diferentes —la realización de pedidos y la entrega— pueden correlacionarse, clasificarse y agregarse. Además, la arquitectura flexible de metadatos permite anotar los datos recopilados con información contextual enriquecida para su análisis. Pensemos en la latencia total de la entrega, es decir, el tiempo que transcurre desde que se toma el pedido hasta que se entrega la comida. Esta latencia puede calcularse correlacionando los flujos de trabajo de realización de pedidos y de entrega. Asimismo, dado que la representación de los datos de geolocalización en ambos flujos de trabajo también utiliza una sintaxis y una semántica coherentes, los cálculos y las correlaciones de la latencia de entrega pueden segmentarse por ubicación, por ejemplo, por código postal. Así, gracias a la planificación previa de la estrategia de datos, podemos crear con mayor facilidad un conjunto de datos sobre la latencia total de las entregas, con una granularidad por hora y código postal. Por último, aprovechando nuestro enfoque flexible de metadatos, las estadísticas horarias pueden anotarse con información contextual adicional, como las condiciones del tráfico y la precipitación acumulada.
En este punto, disponemos de información muy valiosa para alimentar un flujo de análisis de datos, que puede utilizar métodos de IA predictiva para identificar patrones relacionados con un aumento del tiempo total de entrega e incluso anticipar esas condiciones en el futuro.
Como último paso de este proceso, podemos imaginar que la empresa replantea ahora el flujo de trabajo de las entregas como un problema de oferta y demanda, utilizando los precios para equilibrarlas. Un ejemplo concreto sería permitir que la remuneración del repartidor se ajuste en función de la hora y la ubicación, ya sea mediante un calendario fijo o de forma dinámica, según las condiciones en tiempo real. Esto «cierra el ciclo» de los datos, al aprovecharlos para adoptar medidas concretas (ajustes de precios) con las que abordar una cuestión empresarial (gestionar el tiempo total de entrega) y utilizar la retroalimentación de ciclo cerrado (ajustes dinámicos de precios en función del tiempo observado) para que el flujo de trabajo sea «adaptativo».
Crear valor empresarial directamente monetizable a partir de los datos
Otro tipo de valor que se puede obtener de los datos consiste en utilizarlos para «abrir nuevos campos de actuación» y generar un valor empresarial que pueda monetizarse mediante un beneficio directo para los clientes. Un ejemplo aparece en nuestro escenario seis meses después: aportar valor a nuestros socios proveedores, los restaurantes. Una solución a la necesidad empresarial de ofrecer información útil a los clientes de nuestra aplicación consiste, una vez más, en aprovechar los datos recopilados por los flujos de trabajo operativos de la aplicación, esta vez como materia prima para extraer información empresarial útil para nuestros clientes y socios. Esta información puede adoptar diversas formas; algunos ejemplos son:
- Una predicción temprana de una demanda superior a la habitual, para que el socio pueda prepararse en consecuencia.
- Información sobre los precios que aplican a determinados platos de la carta, tanto para comprender la sensibilidad de la demanda como para comparar sus precios con los del conjunto de restaurantes similares.
- Datos cuantificables para facilitar la planificación estratégica del restaurante, como el impacto previsto en los ingresos de ampliar o reducir su horario de apertura.
El descubrimiento de estos conocimientos empresariales no es posible únicamente gracias a la existencia de un gran almacén de datos, sino también a la estrategia de datos que anota los datos recopilados de forma estructurada mediante un vocabulario de metadatos coherente.
Centrándonos en un caso concreto de obtención de información empresarial, veamos cómo podrían extraerse conclusiones sobre los precios de los menús. Partiendo de la materia prima —los datos recopilados operativamente durante el proceso de realización de pedidos—, el valor de una estrategia de datos anotados con metadatos se hace evidente de inmediato. En concreto, no solo se registra el precio de un artículo en un restaurante determinado, sino que también se conservan los metadatos relacionados. Pensemos en los atributos descriptivos adicionales de un alimento, como el tamaño de la porción, el «tipo» de alimento (por ejemplo, «refresco» o «hamburguesa») y las «características adicionales» especiales (por ejemplo, «incluye guarnición» o «picante»). Si la arquitectura de datos enriquece los datos de los alimentos con metadatos relativos a estos atributos, utilizando un vocabulario coherente de etiquetas de metadatos (por ejemplo, «onzas de la porción», «clase de alimento» y «características adicionales») y un conjunto normalizado de valores de metadatos, la información sobre los alimentos puede compararse entre distintos restaurantes. Por ejemplo, si lo único que se sabe a partir de la base de datos de códigos es que «Burger Basement» ofrece una Man Cave Burger y «Heart Attack Grill» ofrece la Double Bypass Burger, no hay ninguna base para realizar una comparación significativa. Sin embargo, si añadimos un vocabulario de anotación de metadatos, podemos realizar comparaciones y análisis: el sistema entendería que ambos artículos son comparables porque pertenecen a la «clase de alimento» «hamburguesa». Además, los análisis también pueden utilizar los demás campos de metadatos para normalizar el tamaño de la porción (es decir, la «Man Cave» puede pesar 8 onzas y la «Double Bypass», 12 onzas). Por último, también puede utilizarse un conjunto estándar de valores de «características adicionales», como «incluye queso», para realizar otros ajustes basados en similitudes o diferencias secundarias. Una vez más, la planificación previa de la arquitectura de datos —en este caso, de la estrategia de metadatos— ha permitido a la empresa aprovechar rápidamente nuevas oportunidades de negocio simplemente sacando partido de los datos residuales generados por los flujos de trabajo existentes.
Resumen
La mayoría de los líderes empresariales son plenamente conscientes de que su éxito depende de la planificación de sus flujos de trabajo operativos críticos, así como de la visibilidad sobre la ejecución de dichos flujos. Los buenos líderes empresariales también entienden que la capacidad de obtener esa información de forma rápida y eficiente y, a continuación, tomar medidas —tanto internas como externas— basadas en ella es clave para mantener su éxito.
Como profesionales de la tecnología, se nos pide que creemos soluciones que permitan alcanzar los objetivos empresariales de mejora continua de la eficiencia operativa y agilidad empresarial. Lamentablemente, con demasiada frecuencia los ingenieros se centran en los componentes de software de procesamiento de datos de la solución y no prestan suficiente atención a la propia arquitectura de datos. Esto suele traducirse en un esfuerzo considerable y en retrasos en los plazos de implantación de mejoras en los flujos de trabajo internos y del lanzamiento de nuevas ofertas derivadas para los clientes. Como demuestra este artículo, prestar atención desde el principio a la arquitectura de datos —el vocabulario de datos, las representaciones y la estrategia de metadatos— constituye la base tecnológica de una empresa ágil, sólida y orientada por los datos.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.