Principios fundamentales de Edge 2.0
Por Rajesh Narayanan, Michael Wiley
Introducción
La definición del edge siempre ha estado estrechamente ligada a la evolución de la arquitectura de los centros de datos. Durante la última década, la arquitectura de la infraestructura empresarial ha experimentado una rápida transformación, pasando de los centros de datos locales a las actuales arquitecturas de nube distribuida. Consideramos Edge 2.0 un cambio tecnológico que permitirá a las aplicaciones aprovechar una arquitectura de nube distribuida.
Cada persona, organización o entidad interpreta el edge de forma diferente. Algunos pueden considerar que el edge es una torre de telefonía móvil, mientras que otros pueden afirmar que su dispositivo móvil es el edge. Para los proveedores de servicios en la nube (CSP), el edge es una infraestructura gestionada que se integra perfectamente con sus sistemas de back-end. En aplicaciones militares, el edge es el teatro de operaciones, ya sea terrestre, marítimo o aéreo. Cada vez que leemos sobre el edge, su interpretación suele resumirse en las capacidades informáticas, de red y de almacenamiento de la infraestructura o en su ubicación, o en ambas cosas.
Pero también entendemos Edge 2.0 como la experiencia que ofrece a todas las partes interesadas del ecosistema, y no solo como el activo de infraestructura o su ubicación.
Este documento describe cuál debería ser la funcionalidad de Edge 2.0, independientemente de su infraestructura física o virtual, así como de dónde se ubique o implemente. Su objetivo no es explicar cómo crear una aplicación distribuida mejor, sino poner de relieve las capacidades que Edge 2.0 debe ofrecer para facilitar la creación de las aplicaciones distribuidas más adecuadas para cada requisito específico.
“Edge 2.0 se centra en la experiencia, no en la infraestructura ni en su ubicación.”
¿Qué es Edge 2.0?
Desde el punto de vista de una entidad que reside en esta nube distribuida, el extremo se encuentra allí donde esté ubicada la entidad en cada momento. Por tanto, proponemos una definición de Edge 2.0 centrada en la experiencia, que no esté vinculada únicamente a la ubicación o al tipo de infraestructura ni a la entidad que la controla.
Edge 2.0 se centra en mejorar las experiencias relacionadas con las aplicaciones, las operaciones y los desarrolladores. Edge 2.0 debe abordar las metapropiedades de la aplicación (como los SLA y los SLO) adaptándose a sus necesidades cambiantes. Edge 2.0 debe ser fácil de operar y evitar que los equipos de operaciones tengan que crear nuevas automatizaciones para cada aplicación distribuida. Edge 2.0 debe reducir las dificultades a las que se enfrentan los desarrolladores al desarrollar e implementar aplicaciones distribuidas a gran escala, ofreciendo una compatibilidad fluida con la seguridad, la gobernanza y los objetivos de nivel de servicio.
Tomemos como ejemplo una aplicación bancaria. El objetivo de Edge 2.0 no es mejorar la lógica de negocio de la transacción, sino hacerla más segura, rápida y privada, permitir su uso en todas las regiones geográficas (según sea necesario) y ampliar o reducir su capacidad en función de las necesidades para respaldar los objetivos empresariales.
Conceptos y afirmaciones
A continuación se presentan los conceptos y las afirmaciones clave de este artículo:
- Edge centrado en la experiencia: establece las bases de Edge 2.0 en torno a la experiencia que ofrece, en lugar de hacerlo en torno a un activo o sus ubicaciones.
- Consideraciones de diseño: Especifica las consideraciones de diseño clave para implementar correctamente la arquitectura Edge 2.0.
- Infraestructura heterogénea: Destaca que diseñar para una nube distribuida implica tener en cuenta el control descentralizado de la infraestructura.
- La telemetría como base: destaca la telemetría como un componente fundamental que debe ser compatible con todas las capas de la infraestructura. Sin telemetría, una estrategia centrada en los datos pierde fuerza.
- Desafíos entre clústeres: destaca que uno de los principales retos de Edge2.0 es la comunicación entre clústeres, en lugar de dentro de un mismo clúster.
- Interfaces adaptativas: presenta las interfaces adaptativas y ofrece una comparación clara con las interfaces declarativas e imperativas.
- Plataforma de aplicaciones Edge 2.0 (EAP): Presenta la EAP como un marco que permite a Edge 2.0 adaptarse a las necesidades de las aplicaciones.
Tema(s) no abordado(s)
Hay varios temas que aún no hemos abordado en este documento:
- Distribución de datos de aplicaciones: Este ámbito abarca numerosos subtemas, como las redes de distribución de contenidos (CDN), el almacenamiento distribuido, la distribución de datos, el almacenamiento en caché, etc. También existen tecnologías emergentes, como los tipos de datos replicados sin conflictos (CRDT). Un marco de Edge 2.0 debería incluir entre sus funciones la compatibilidad con la distribución de datos de aplicaciones.
- Distribución de funciones: El avance de la computación en el borde puede entenderse como el desplazamiento de las funciones y la lógica principales de la nube hacia ubicaciones más próximas al lugar donde se genera el evento o residen los datos. Dada la considerable capacidad de computación que está empezando a estar disponible en el borde, si queremos aprovecharla, debemos abordar problemas similares a los que suelen resolverse en las arquitecturas de nube tradicionales. Por ejemplo, las redes superpuestas, las cargas de trabajo de middleware y otros tipos de cargas interrelacionadas y más complejas que los casos de uso básicos observados en las primeras etapas de la computación en el borde, como los storlets, que son flujos sencillos sin estado diseñados para ejecutarse junto a los datos.
- Es probable que haya otras áreas que no se hayan abordado. El objetivo del marco es que sea extensible, de modo que puedan añadirse responsabilidades según sea necesario.
Evolución del edge
La figura 1 ilustra mejor la evolución conjunta de las arquitecturas del Edge y de los centros de datos. Edge 1.0 y 1.5 se basaban en el concepto de un sitio de origen y en trasladar los datos y servicios desde el origen hasta el consumidor. Edge 1.0 consistía en el despliegue de infraestructura de Internet centrada principalmente en optimizar el uso del ancho de banda mediante el almacenamiento en caché distribuido de contenidos, también conocido como redes de distribución de contenidos. Las CDN constituyen un patrón de diseño fundamental, ya que el volumen total de contenidos que se debe transferir siempre será superior al ancho de banda disponible.
A medida que los costes de la CPU y la memoria descendían rápidamente, surgieron granjas de computación junto a los nodos de las CDN. Las aplicaciones se consumían como servicios mediante arquitecturas orientadas a servicios (SOA). De ahí que se denomine Edge 1.5 «red de distribución de servicios».
“Cada entidad considera que, desde su punto de vista, se encuentra en el extremo.”
Una característica común de Edge 1.0 y Edge 1.5 es el concepto de sitio de origen. Antes del auge de la tecnología móvil, las personas, los dispositivos y los objetos se dedicaban principalmente a descargar contenido o actuaban como consumidores del servicio. El sitio desde el que se originaba el servicio seguía siendo distinto del sitio del consumidor.
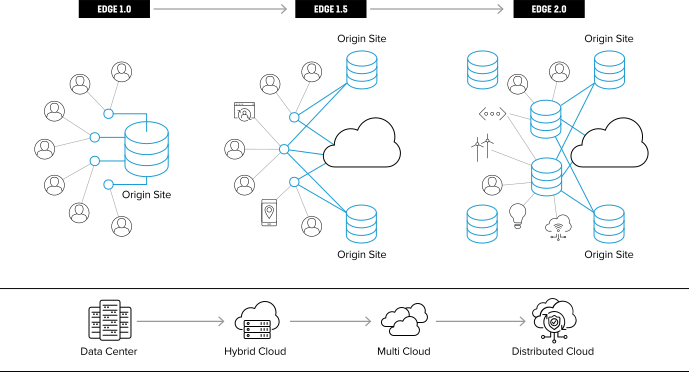
Sin embargo, en Edge 2.0, cualquier entidad puede actuar como sitio de origen o como consumidor. El flujo de tráfico ha cambiado. Las personas, los teléfonos y los dispositivos producen datos activamente al subir contenido o generar datos periódicos. Las aplicaciones se están convirtiendo en consumidoras, ya que dependen de otras aplicaciones. Todas las entidades pueden actuar como productoras o consumidoras de un servicio: API, personas, dispositivos IoT o aplicaciones web, de back-end y headless. Desde su propio punto de vista, cada entidad de la infraestructura considera que está en el edge.
La nube distribuida es la etapa más reciente en la evolución del centro de datos. La computación se ha vuelto verdaderamente omnipresente, desde los dispositivos móviles hasta su integración en objetos cotidianos conectados a la red. Paralelamente, las arquitecturas de software han evolucionado para hacer posibles aplicaciones distribuidas y escalables.
Consecuencias del edge: mayor complejidad
La abundancia y la hiperdistribución generalizadas de los recursos informáticos y de almacenamiento han brindado una oportunidad para la rápida transformación digital de las empresas. Sin embargo, esta rápida evolución tiene sus consecuencias.
La mayoría de las empresas suelen contar con una infraestructura heterogénea y entornos no uniformes. Para escalar estos entornos de forma eficaz, los sistemas implementados deben ofrecer funciones complejas de orquestación y automatización. Los cambios rápidos en las necesidades de la aplicación, como las variaciones en los requisitos de CPU y ancho de banda, aumentan la complejidad de las operaciones en una nube distribuida. Esto supone una presión adicional para los equipos de operaciones, que quizá no estén debidamente preparados para responder de forma eficiente a las necesidades cambiantes de la aplicación o del cliente final.
La consecuencia de estos problemas es una complejidad operativa que neutraliza cualquier posible beneficio para una empresa inmersa en un proceso de transformación digital.
A continuación, se destacan algunos de los problemas y elementos interrelacionados derivados de la complejidad.
“Los beneficios de la transformación digital se ven anulados si la tecnología presenta una gran complejidad operativa.”
Los modelos de seguridad deben mantenerse constantemente al día
Las nubes híbridas aumentan la superficie de ataque susceptible de verse comprometida debido a diversos vectores de ataque. Los distintos casos de uso plantean múltiples retos de seguridad y, a medida que evoluciona la infraestructura, nos vemos obligados a adaptarnos constantemente. Por tanto, la cuestión que se plantea es la siguiente: ¿cambiarán con frecuencia únicamente las recomendaciones tecnológicas o también los patrones de diseño para implementar la seguridad?
Estos son algunos de los problemas de los enfoques actuales:
- El perímetro definido por software (SDP) no se puede escalar fácilmente, ya que las soluciones más populares se basan en agentes, lo que dificulta la sencillez de los despliegues operativos.
- La implementación del acceso a la red de confianza cero (ZTNA) suele ser poco práctica, ya que las soluciones ZTNA requieren todo un conjunto de servicios de producción desplegados, como la inspección del tráfico, la gestión centralizada de registros, una infraestructura global de clave pública (PKI), la gestión de identidades y otros más.
- Secure Access Service Edge (SASE) combina la red como servicio y la seguridad como servicio, una sopa de siglas que engloba varias tecnologías cuya implementación no es trivial. Además, SASE suele centrarse en las redes de área extensa definidas por software (SD-WAN), por lo que solo aborda una pequeña parte de los casos de uso del perímetro de las redes empresariales.
- Las diferencias entre las infraestructuras de los distintos proveedores de nube pública y unos modelos de seguridad ya de por sí complejos, como la gestión de identidades y accesos (IAM), suelen llevar a los equipos a reforzar cada proveedor de forma fragmentaria y a adoptar configuraciones multinube difíciles de gestionar.
“La seguridad es como perseguir el disco de hockey.”
Desafíos de la automatización
Uno de los principales retos de la hiperdistribución de recursos informáticos de bajo consumo y bajo coste disponibles en el extremo de la red es la capacidad de orquestar y programar la infraestructura de manera uniforme. Los equipos de operaciones tienen dificultades para escalar y dar soporte a las aplicaciones que aprovechan la nube distribuida, ya que estas suelen incluir tecnologías heterogéneas con distintos requisitos de administración.
Aunque las plataformas de automatización como Terraform ofrecen medios avanzados para personalizar la automatización, los equipos de operaciones siguen teniendo que mantener scripts para múltiples combinaciones: por ejemplo, cinco configuraciones de computación distintas, cuatro tipos de cortafuegos y tres tipos de balanceadores de carga. El coste humano que supone gestionar y mantener los scripts de automatización no es escalable.
Esto hace que el cliente de infraestructura siga interactuando con los equipos de operaciones mediante sistemas basados en tickets, lo que supone un obstáculo para automatizar los flujos de trabajo existentes. El servicio de asistencia se ve desbordado por los tickets y se ve obligado a priorizar la seguridad y la estabilidad frente a la agilidad.
Proliferación de API
Las arquitecturas de microservicios ya se han convertido en el método de facto para crear nuevas aplicaciones con la evolución hacia entornos multinube. Las API se publican y pueden instanciarse cuando y donde sea necesario, lo que provoca su proliferación. El descubrimiento, la conectividad y la gestión autónoma de estas API se convierten en un gran reto.
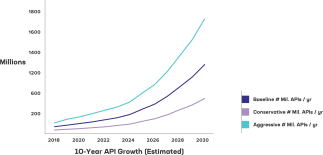
Es necesario un cambio de paradigma para abordar la proliferación de API. Nuestros modelos internos demuestran que incluso unas estimaciones moderadas de parámetros como el número de desarrolladores de API en todo el mundo, el número de API desarrolladas por cada desarrollador al año y la vida útil de las API dan como resultado cientos de millones (si no miles de millones) de API activas simultáneamente para 2030 (figura 2). El informe de 2021 sobre la proliferación de API ofrece una visión completa de este tema emergente.
Visibilidad deficiente del sistema de extremo a extremo
El aumento de la complejidad exige que las empresas dispongan de una visibilidad integral, detallada y significativa de todo el sistema. En los entornos de nube distribuida, las aplicaciones abarcan múltiples pilas de infraestructura heterogéneas gestionadas por entidades independientes.
Además, actualmente ninguno de los operadores tiene incentivos para ofrecer a sus clientes empresariales acceso a la telemetría nativa de su infraestructura. En la práctica, las empresas operan a ciegas cuando despliegan aplicaciones en una nube distribuida y deben recurrir a múltiples herramientas de observabilidad. Para subsanar estas carencias de visibilidad, suelen utilizar herramientas de distintos proveedores que operan en diferentes puntos de la infraestructura o de las pilas de aplicaciones.
Las métricas de infraestructura no estandarizadas agravan los problemas de las empresas. Por lo general, las métricas no están unificadas debido a los silos operativos y a otros factores, como la falta de uniformidad de la infraestructura entre los distintos entornos. Por ejemplo, las métricas varían de un proveedor de nube pública a otro, y las tecnologías de los centros de datos locales tampoco siguen ningún estándar de medición.
“Muchas empresas operan a ciegas debido a la falta de una «práctica de observabilidad».”
Resultado empresarial: experiencia deteriorada
Las cargas de trabajo que generan ingresos y los sistemas esenciales para la actividad suelen consumir la mayor parte de los recursos operativos y del presupuesto disponibles en una empresa. Por su parte, los proyectos más pequeños, aunque menos complejos, suelen constituir la mayoría de las aplicaciones de la empresa. La figura 3 representa esta situación como una distribución de cola larga del número de proyectos que probablemente tenga una empresa en relación con su complejidad operativa.
Aunque las aplicaciones más pequeñas pueden tener una menor complejidad operativa, en muchos casos los procesos y flujos de trabajo para ponerlas en producción siguen siendo manuales, y los tickets de servicio pueden tardar semanas en pasar satisfactoriamente por varios equipos de operaciones. Por ejemplo, para desplegar una aplicación que requiera recursos de red dedicados con políticas de seguridad granulares, puede ser necesario que los equipos globales de seguridad aprueben primero dichas políticas. A continuación, el ticket de servicio puede pasar al equipo de redes para que planifique las configuraciones necesarias de subredes y rutas. Por último, puede ser necesario que otro equipo de operaciones responsable de la gestión de los cortafuegos valide las reglas correspondientes.
Ahora imaginemos que es necesario abordar la complejidad descrita anteriormente para cada aplicación desplegada en una nube distribuida en la que la empresa no posee ninguna parte de la infraestructura subyacente. El enorme volumen de pequeños proyectos o aplicaciones que deben incorporarse y recibir soporte hace inviable que los equipos de operaciones puedan atenderlos todos, lo que plantea la necesidad de establecer prioridades y brinda una oportunidad para el autoservicio.
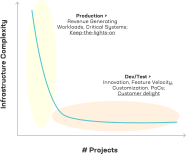
Este problema de priorización resulta especialmente evidente, ya que las inversiones de los equipos de infraestructura se centran en dar soporte a sistemas críticos y generadores de ingresos, lo que deja poco tiempo o presupuesto para proyectos totalmente nuevos que requieren su propio ciclo de desarrollo, pruebas y preproducción antes de pasar a producción. Esto reduce las capacidades y la inversión destinadas a agilizar el desarrollo de funcionalidades, la personalización y la innovación que sustenta nuevos productos, lo que acaba provocando el estancamiento de la empresa y de su oferta.
“Los equipos de infraestructura están abrumados por la complejidad.”
Espacio de soluciones para el edge
La evolución del ecosistema del edge amplía considerablemente el abanico de soluciones al brindar la oportunidad de abordar estos retos mediante una plataforma de aplicaciones.
La figura 4 muestra el espacio de soluciones de Edge 2.0. En este caso, afirmamos que todo lo que se engloba en una arquitectura de nube distribuida constituye la totalidad del espacio de soluciones.
Por tanto, en el contexto del espacio de soluciones, Edge 2.0 debe ofrecer la experiencia deseada por todos los siguientes:
- Todas las entidades incluidas en el ámbito de la solución: aplicaciones, personas y dispositivos que actúan como consumidores, así como aplicaciones web de backend y aplicaciones sin interfaz que conforman los servicios.
- Los equipos de SRE y los propietarios de estas aplicaciones, manteniendo al mismo tiempo las medidas de protección normativas y de seguridad que se esperan de la infraestructura.
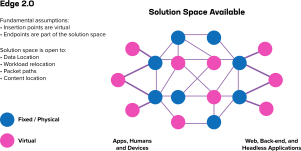
Edge 2.0 será sencillo de operar, seguro y conforme a la normativa, y ofrecerá una experiencia de alta calidad a todas las entidades del ecosistema que participen en él.
Consideraciones de diseño de Edge 2.0
Seguro de forma predeterminada
Una nube distribuida agrava este problema de seguridad a gran escala, ya que el número de puntos finales aumenta exponencialmente. A una escala tan enorme, también aumenta la complejidad de implementar una solución. La estrategia de seguridad debe partir de la premisa de que el entorno en el que está desplegada actualmente la aplicación ya se encuentra comprometido. Del mismo modo, la infraestructura no debe confiar en ninguna aplicación que se ejecute en ella.
La esencia de estas ideas queda recogida en los conceptos del enfoque de confianza cero, y el ejemplo de BeyondCorp1 demuestra su aplicación al caso de uso del acceso a aplicaciones. De cara al futuro, Edge 2.0 amplía este modelo basándose en los cinco principios fundamentales siguientes:
- La identidad es fundamental: En Edge 2.0, la identidad está profundamente integrada: cada instancia de entidad tiene su propia identidad única a nivel global, así como su lugar en la jerarquía de la organización y su nivel de privilegios. La identidad debe ser un aspecto clave no solo para el tráfico norte-sur, sino también internamente para el acceso este-oeste.
- Privilegio mínimo: Las acciones permitidas a un actor deben limitarse exclusivamente a aquellas que necesite para desempeñar su función en el sistema. Por ejemplo, se puede restringir, de acuerdo con las especificaciones de diseño, el subconjunto de cargas de trabajo que pueden comunicarse con el servidor de bases de datos.
- Autenticación continua: Toda declaración que realice un actor del sistema debe contar con un medio de verificación y debe verificarse explícitamente cada vez que se produzca. La autenticación no debe basarse únicamente en mecanismos explícitos, como secretos compartidos o cadenas de confianza, sino que también debe tener en cuenta patrones implícitos de comportamiento y metadatos contextuales.
- Supervisión y evaluación constantes: deben supervisarse las acciones de todos los actores del sistema, lo que refuerza el papel fundamental de las tecnologías de recopilación y almacenamiento de datos en una arquitectura Edge 2.0. Además, estas actividades deben evaluarse continuamente para detectar y mitigar los intentos de realizar acciones prohibidas o peligrosas. La evaluación debe llevarse a cabo prácticamente en tiempo real y a gran escala, lo que implica un uso generalizado de técnicas de automatización y aprendizaje automático.
- Presunción de brecha: Dados los recursos de los que disponen los sofisticados adversarios actuales, se debe asumir que cualquier sistema ha sido vulnerado de algún modo. Como consecuencia, las políticas totalmente deterministas basadas en las identidades de las cargas de trabajo y de los usuarios, que aplican el acceso basado en privilegios representado por a y b, suelen ser insuficientes para impedir todos los ataques. Por tanto, un sistema Edge 2.0 plenamente maduro también debe ser capaz de evaluar en tiempo real los riesgos y beneficios a partir de una supervisión y una evaluación continuas.
“Asuma siempre que la infraestructura ya está comprometida. El reto consiste entonces en implementar una aplicación en ella de forma segura.”
Proporciona observabilidad nativa
Edge 2.0 debe integrar la telemetría como un componente de primer nivel en las capas más profundas de la infraestructura, proporcionar un medio sencillo y escalable para recopilar telemetría entre las distintas capas de la infraestructura y ponerla a disposición en una plataforma común. Esto permite a los equipos de observabilidad consultar el «estado de la infraestructura» cuando sea necesario. Así, los equipos de aplicaciones pueden centrarse en la lógica de negocio sin tener que instrumentar explícitamente sus pilas de aplicaciones.
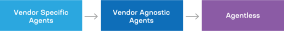
El estado actual de la tecnología de observabilidad ha sido, en gran medida, específico de cada proveedor y de carácter propietario. Esto ha dado lugar a numerosos agentes específicos de cada proveedor que recopilan señales similares y compiten por costosos recursos de memoria y CPU.
El siguiente paso lógico es utilizar un recopilador de telemetría independiente del proveedor que permita transmitir los datos de infraestructura y tráfico a una plataforma de datos centralizada.
A muchos equipos de producto les cuesta justificar la inversión en instrumentación, ya que el esfuerzo debe estar vinculado a una oportunidad de generar ingresos. La infraestructura debe instrumentarse como cualquier otra función o proceso empresarial, porque el equipo necesita comprender su comportamiento para optimizarla de acuerdo con los objetivos de la empresa. Por tanto, el debate debería centrarse más en qué se debe priorizar a la hora de instrumentar que en la necesidad de hacerlo.
Para obtener mediciones más detalladas y precisas del comportamiento de la aplicación, prevemos que la instrumentación se «desplazará a la izquierda» al incorporarla durante la fase de codificación (figura 5).
“La instrumentación debe desplazarse a la izquierda.”
Compatible con interfaces adaptativas
Siguiendo el modelo de nube distribuida, si profundizamos un par de capas, cada nube dentro de su ámbito (local o global) cuenta con su propio gestor, administrador, orquestador y otros componentes. Cada una funciona de forma independiente y toma sus propias decisiones, pero proporciona interfaces para que otras entidades las utilicen cuando sea necesario.
Así pues, el concepto de nube distribuida implica, en esencia, una administración y un control descentralizados. Es imposible obviar este hecho, y es importante reconocerlo para comprender mejor los matices de las interfaces adaptativas frente a las declarativas e imperativas.
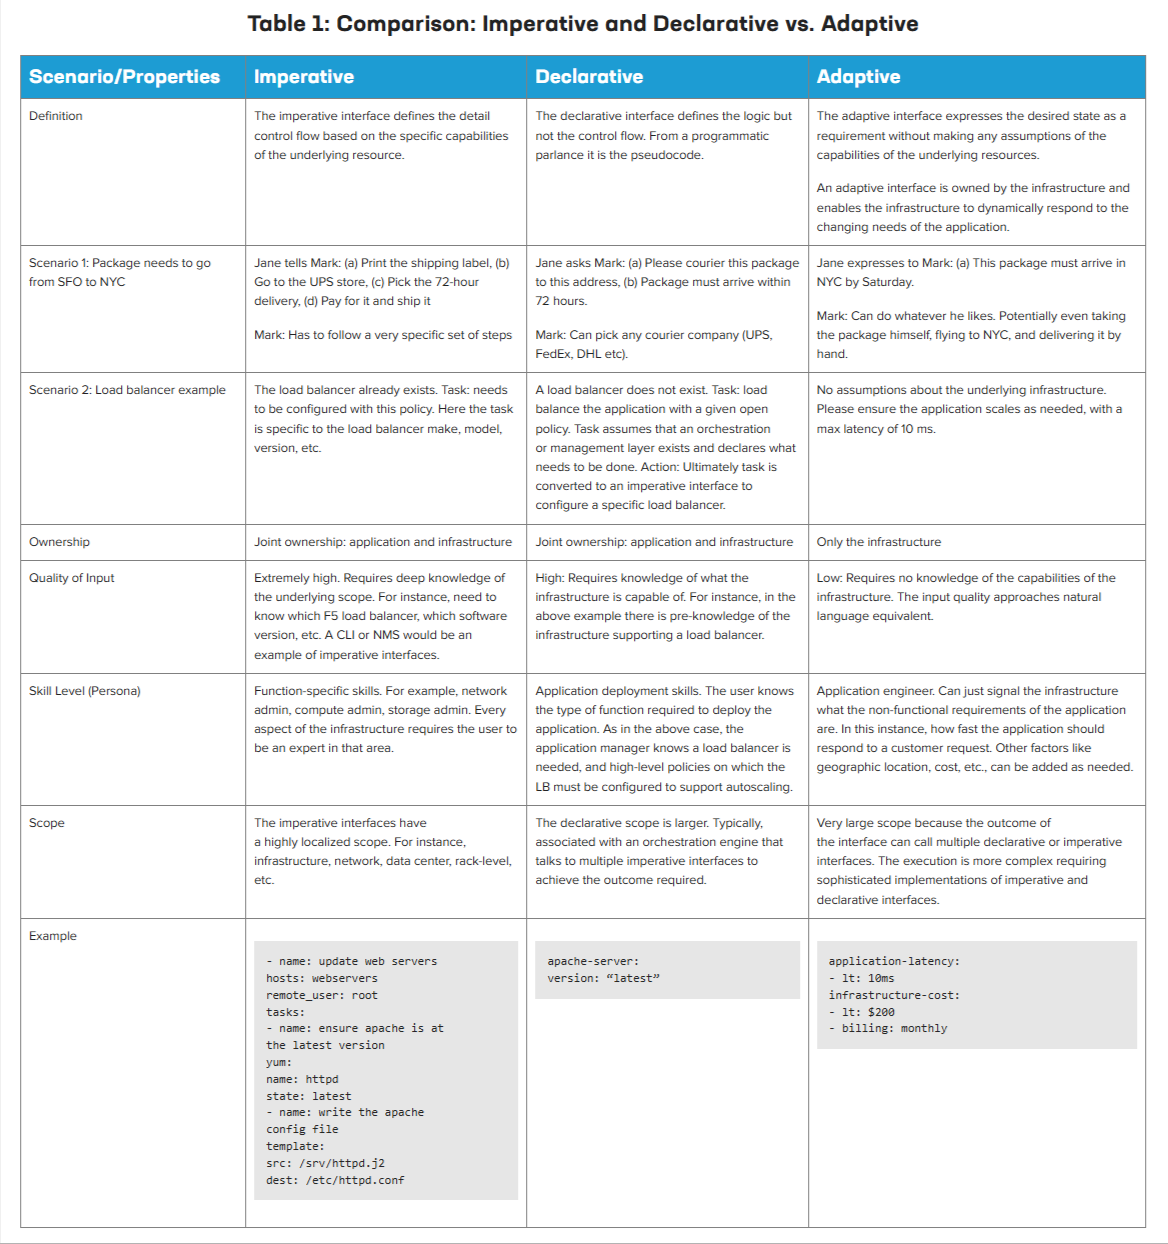
Para aprovechar eficazmente la infraestructura Edge 2.0, las interfaces imperativas y declarativas no son suficientes, ya que siguen dependiendo de artefactos elaborados manualmente que, en esencia, son estructuras estáticas incapaces de adaptarse con la suficiente rapidez a unas condiciones que cambian rápidamente.
Debemos avanzar hacia un enfoque basado en resultados, y los sistemas deben ser lo suficientemente inteligentes como para ajustar las políticas en toda la infraestructura (de extremo a extremo) a fin de alcanzar dichos resultados. A esto lo llamamos interfaces adaptativas.
Para que quede claro: las interfaces imperativas, declarativas y adaptativas no son mutuamente excluyentes:
Imperativa: Es muy prescriptiva y define detalladamente una serie de acciones para alcanzar el estado deseado. La configuración de un router, por ejemplo, es una acción imperativa. En el escenario anterior, las acciones prescritas serán precisas: qué centro de datos, cuánta CPU/memoria, el ancho de banda necesario, las rutas específicas y mucho más. La calidad de los datos de entrada del modelo es muy alta y, por tanto, requiere un conocimiento y una experiencia más profundos sobre la infraestructura. Se presupone el conocimiento tanto del modelo como de la estructura de la infraestructura.
Declarativo: El matiz del enfoque declarativo es que se centra en describir el estado deseado, en lugar de las acciones necesarias para alcanzarlo. La calidad de los datos de entrada es menor, aunque la aplicación sigue necesitando conocer, al menos, la estructura de la infraestructura subyacente.
Adaptativa: Es independiente de los enfoques imperativo y declarativo. Una interfaz adaptativa se centra en el objetivo o la meta deseados, en lugar de en el estado. Su finalidad es captar el objetivo de la parte interesada que desea desplegar la aplicación, en vez de centrarse en un conocimiento previo del sistema subyacente. El enfoque adaptativo es diferente porque no presupone cuáles son las capacidades de la infraestructura subyacente. No existen restricciones sobre cómo «hacer el trabajo» y, por tanto, constituye un enfoque independiente.
Con el enfoque adaptativo, el nivel de detalle de la entrada es bajo y se aproxima al lenguaje natural. Los propietarios de las aplicaciones pueden enviar una solicitud para indicar al controlador de la infraestructura qué resultado esperan, en lugar de tener que declarar la capacidad necesaria o configurar específicamente un recurso.
“Proclamación: declaramos que es imprescindible que Edge 2.0 admita interfaces adaptativas.”
Resuelve el problema entre clústeres
Una nube distribuida, por definición, admite todo tipo de arquitecturas de aplicaciones: monolíticas, de microservicios o sin servidor. Independientemente de la arquitectura, las aplicaciones utilizan API para ofrecer los servicios.
Los problemas relacionados con el descubrimiento de API, la conectividad y la seguridad de la red se resuelven en gran medida mediante el uso de una malla de servicios, pero esta solución solo es efectiva dentro del clúster (intraclúster).
Por otro lado, las aplicaciones Edge 2.0 utilizan APIs en una infraestructura de nube hiperdistribuida, es decir, en un entorno multiclúster. Las nuevas aplicaciones se desarrollan con APIs que atraviesan límites organizativos y geográficos. Algunas de estas APIs pueden ser privadas o de socios y encontrarse tras varias capas de cortafuegos, sin una ruta explícita entre ellas, aunque puedan detectarse. Este problema de clústeres heterogéneos (interclúster) carece de una solución práctica que sea elegante, ligera, escalable y segura.
Abordamos ampliamente las API en el informe «API Sprawl» de 2021², en el que respondemos a muchas de las preguntas que podrían surgir. La figura 6 muestra la diferencia entre la comunicación entre clústeres y dentro de un mismo clúster.
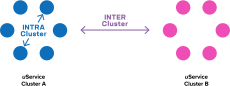
Dentro del clúster: En una arquitectura monolítica, puede haber muy pocas API expuestas, ya que la comunicación interna entre módulos se realiza mediante otros métodos de comunicación entre procesos. En cambio, una arquitectura de microservicios se divide en decenas, si no cientos, de API.
En cualquier caso, cada clúster de aplicaciones se desarrolla y gestiona siguiendo un enfoque definido. Por ejemplo, en una arquitectura de microservicios, un equipo podría utilizar cualquier tipo de malla de servicios, como Istio, Linkerd, Aspen Mesh u otras. Cada enfoque cuenta con sus propios mecanismos para gestionar y controlar las API dentro de su clúster; es decir, a nivel intraclúster.
Existen muchas soluciones en este ámbito, y el objetivo de Edge 2.0 no es reinventar la rueda ni obligar a las organizaciones o a los equipos de desarrollo a adoptar otra tecnología nueva.
Entre clústeres: A medida que aumenta el número de servicios ofrecidos mediante API, las nuevas aplicaciones se crean utilizando servicios que ya han sido desarrollados o adoptados por distintos equipos de aplicaciones de la empresa, ya que no es necesario reinventar la rueda.
También se están creando nuevas aplicaciones mediante distintas combinaciones de API públicas y privadas. Desde el punto de vista de la arquitectura, las aplicaciones modernas aprovechan los servicios proporcionados por otros clústeres. En una nube distribuida, estos clústeres se despliegan a escala mundial, por lo que pueden ubicarse en cualquier infraestructura capaz de alojar la aplicación o formar parte del clúster de aplicaciones.
Ámbito de un clúster de aplicaciones
En resumen, el ámbito de un clúster de aplicaciones no se limita únicamente a una organización. Los clústeres pueden abarcar dos redes, aplicaciones o silos organizativos cualesquiera, o incluso dos empresas.
El alcance abarca toda la gama de permutaciones y combinaciones posibles, lo que aumenta exponencialmente la complejidad de las operaciones. La figura 7 muestra las permutaciones del tráfico dentro del ámbito de despliegue de la aplicación.
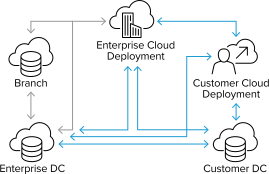
Una empresa típica tendrá distintas arquitecturas de aplicaciones. Puede haber diferentes variantes de malla de servicios, una aplicación web 2.0 basada en una arquitectura orientada a servicios o un despliegue de software monolítico, según el equipo que se encargue de su desarrollo y despliegue. Por tanto, las API están dispersas por toda la empresa, ya sean API privadas o API públicas utilizadas por esta. Este problema aún no se ha resuelto. La comunicación mediante API entre varias ubicaciones es fundamental y constituye un problema cuya solución resulta difícil de alcanzar para empresas de cualquier tamaño.
Existen varias soluciones para gestionar las API dentro de un clúster (por ejemplo, un controlador de entrada, una puerta de enlace de API, entre otras), pero la comunicación de API entre clústeres sigue sin resolverse de forma práctica, escalable y segura. Por ello, limitamos el alcance del control y la gestión unificados de las API a abordar únicamente los problemas entre clústeres.
Proporciona autonomía
Un valor poco reconocido de la nube es la autonomía que ofrece al «consumidor de la nube». Las empresas y los emprendedores pueden crear sus propias infraestructuras bajo demanda y disfrutar de una sensación de control total.
El principio de diseño fundamental que debe seguir una plataforma Edge 2.0 consiste en ofrecer una experiencia autónoma al cliente de la nube, al tiempo que se implementan las medidas de protección adecuadas. Dado que las entidades pueden aparecer en cualquier infraestructura (de confianza o no), estas medidas deben implementarse de forma que no supongan una carga para la unidad de negocio ni para el equipo de DevOps responsable de desarrollar la aplicación.
Resumen de los principios
El nuevo reto de Edge 2.0 será el descubrimiento, la identidad, la confianza y la observabilidad entre los distintos servicios.
Incluso en las medianas empresas, la cantidad de API creadas cada año sería considerable. ¿Cómo descubren los equipos estos servicios dentro de la empresa? Es más, ¿cómo pueden saber si los servicios siguen siendo válidos y quién es su propietario? ¿Pueden estar seguros de que se trata de un servicio validado y fiable? El problema se agrava cuando los equipos quieren consumir servicios creados por clústeres ubicados fuera de los límites de la empresa, por ejemplo, proveedores de SaaS o aplicaciones que se ejecutan en dispositivos periféricos totalmente ajenos al control administrativo de los equipos de infraestructura empresarial.
Plataforma de aplicaciones Edge 2.0
Teniendo en cuenta los retos expuestos en las secciones anteriores, debemos considerar toda la nube distribuida como una plataforma. A grandes rasgos, definimos el objetivo de la solución: descubrir de forma autónoma (sin intervención humana), escalar y proteger aplicaciones distribuidas en infraestructuras descentralizadas.
En esencia, podemos describir la función de la plataforma de aplicaciones Edge 2.0 (EAP) de la siguiente manera:
- Descubrimiento, identidad y confianza de las API
- Programación y orquestación de infraestructuras
- Conectividad segura de las aplicaciones
“Descubre, escala y protege de forma autónoma aplicaciones distribuidas en infraestructuras descentralizadas.”
Alcance del EAP
La infraestructura abarca la totalidad del espacio de soluciones, en el que los elementos de infraestructura pueden aparecer y desaparecer continuamente. La propiedad de la infraestructura y de sus recursos, por un lado, y la administración y el control de dichos recursos, por otro, son dos conceptos independientes. El propietario de una infraestructura puede asignar una infraestructura concreta o una instancia de esta a otra organización para que la gestione y configure, o bien recuperar el control cuando sea necesario. A su vez, la organización que gestiona y configura los elementos puede asignarlos a proyectos o aplicaciones específicos. Este concepto no es nuevo; por ejemplo, los proveedores de servicios en la nube ofrecen un control administrativo jerárquico que los equipos de TI de una empresa pueden utilizar para proporcionar, a su vez, infraestructura como servicio (IaaS) a unidades de negocio internas, equipos, etc. La principal cuestión para Edge 2.0 es cómo implementar este modelo a gran escala en una nube hiperdistribuida, que constituye el estado actual y futuro de la infraestructura del edge.
Aquí es donde entra en juego el ámbito del EAP. La figura 8 que aparece a continuación muestra el ámbito del EAP en el contexto de distintos tipos de interfaces. Cada EAP lleva a cabo la orquestación dentro de su ámbito local mediante interfaces declarativas e imperativas. En este caso:
- Las interfaces declarativas e imperativas serían las API de AWS, las API de Azure, etc.
- Las interfaces adaptativas serían completamente nuevas y tendrían que definirse caso por caso.
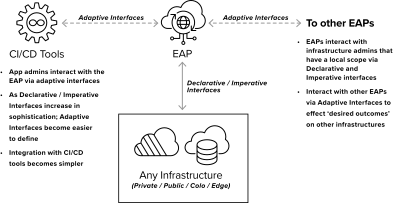
Para aprovechar las ventajas de la nube distribuida, el EAP debe tener la capacidad de utilizar todos los nodos y entidades disponibles a través de ella. El objetivo es que cada EAP llegue a ser equivalente al concepto de sistema autónomo3 de las redes IP, pero aplicado a la capa de aplicación.
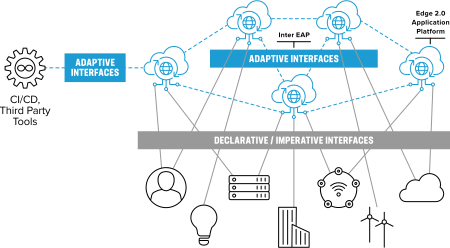
Al reunir todos estos elementos (véase la figura 9 a continuación), podemos obtener una visión general de cómo se pueden desplegar múltiples EAP en una infraestructura de nube descentralizada e interactuar entre sí de forma autónoma.
Las interfaces adaptativas también facilitan la integración de las plataformas de CI/CD y otras aplicaciones de gestión del ciclo de vida de las aplicaciones con la nube distribuida. Las plataformas de CI/CD pueden interactuar directamente con el EAP mediante interfaces adaptativas sencillas que solo especifican el resultado deseado.
Es importante señalar que la comunicación entre EAP también puede llevarse a cabo mediante interfaces adaptativas.
El marco de EAP
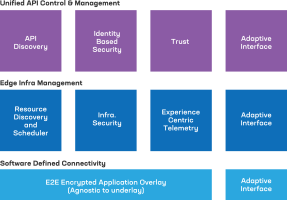
El marco EAP, como se muestra en la Figura 10, organiza las responsabilidades en función de las capacidades de cada instancia de EAP. La función del EAP es interactuar con los controladores de la infraestructura subyacente —ya sea infraestructura como servicio (IaaS), plataforma como servicio (PaaS) o software como servicio (SaaS)—, así como orquestar y programar los recursos adecuados según sea necesario.
Control y gestión unificados de API
El futuro estará marcado por una economía impulsada por las API, en la que estas serán mucho más que un simple enfoque de arquitectura de software simplificado mediante una malla de servicios. Una API se convertirá en el principal medio a través del cual cualquier entidad que participe en una nube distribuida prestará su servicio.
Como ya se ha establecido, en el plazo de una década habrá en todo el mundo cientos de millones, si no miles de millones, de API públicas y privadas disponibles. Las API transformarán nuestra economía, por lo que será necesario analizar más detenidamente qué debe implementar la EAP para sustentarla.
Descubrimiento de API
La inminente proliferación de API exige que cada API pueda detectarse tanto dentro como fuera de la EAP. Con la nube distribuida, las API pueden encontrarse en cualquier lugar de varios clústeres.
La premisa subyacente es que el problema de la detección de API es realmente una cuestión entre clústeres. El ámbito de una EAP puede abarcar numerosos clústeres de aplicaciones que utilizan distintos enfoques de software (desde microservicios hasta arquitecturas monolíticas), cada uno con su propia estrategia de puerta de enlace de API. Una EAP proporciona un repositorio común en el que todas las API pueden registrarse y detectarse dentro de su ámbito, no solo dentro de cada clúster. Esta distinción es clave para determinar las limitaciones de las estrategias actuales de puertas de enlace de API, como las empleadas, por ejemplo, en una malla de servicios.
El reto para la EAP consiste en facilitar el descubrimiento de una API, proporcionar la documentación adecuada sobre su uso y gestionar su ciclo de vida para garantizar la coherencia, la precisión y el control de versiones. La EAP implementa un mecanismo para informar a las entidades que utilizan sus API sobre el estado actual de las API específicas que estén usando. Esto podría hacerse simplemente estableciendo fechas de caducidad o enviando notificaciones explícitas mediante algún sistema de mensajería.
Seguridad basada en la identidad
La postura de seguridad adoptada parte de la premisa de que la infraestructura en la que está desplegada actualmente una aplicación ya se encuentra comprometida.
El pilar fundamental para implementar este enfoque de seguridad es la identidad. Cada endpoint de API debe tener una identidad única a nivel global. Las políticas y los controles de seguridad se gestionan por separado en un repositorio central.
Las API deben marcarse como públicas o privadas, lo que hará que los componentes de seguridad de la infraestructura subyacente se configuren automáticamente para la API específica.
Todas las comunicaciones entre aplicaciones parten de una política de denegación total. El hecho de que una API sea visible no significa que otra aplicación pueda invocarla. Esto debe configurarse explícitamente en la política de seguridad de la aplicación.
“Incluso la confianza tiene una vida limitada; debe verificarse periódicamente.”
Confianza: reputación a lo largo del tiempo
La EAP debe garantizar que todas las API incluidas en su ámbito sean fiables y, al mismo tiempo, que también lo sean todas las API externas utilizadas por los servicios incluidos en dicho ámbito.
«No puedes demostrar la confianza; eso es precisamente lo que la convierte en “confianza”» — De Traitors @ Netflix
La confianza es, en esencia, «reputación a lo largo del tiempo», y debe revalidarse continuamente para garantizar que no haya caído por debajo de un nivel aceptable. Este enfoque se ha vuelto cada vez más habitual a la hora de modelar e implementar la confianza en los sistemas, lo que exige evaluarla de forma continua en lugar de darla por sentada de manera estática al inicio de la ejecución.
La naturaleza cambiante de la confianza a lo largo del tiempo puede suponer un reto para algunas empresas que no disponen del tiempo necesario para establecer una reputación mutua entre sus sistemas y los de terceros. Tanto la infraestructura como las API pueden causar estragos si no se supervisa de cerca dicha reputación.
Suponiendo que un servicio incluido en el ámbito de la EAP acceda a una API externa, la plataforma debe implementar un mecanismo que permita al servicio que realiza la llamada cerciorarse de la exactitud de la respuesta recibida de dicha API. El hecho de que la respuesta de la API parezca válida no significa que sea fiable. La respuesta podría ser inexacta debido a problemas de calidad, o bien podrían haberse introducido inexactitudes deliberadamente para reducir la competitividad de la empresa. Esta capacidad de asignar un factor de confianza a cada API, ya sea interna o externa, es exclusiva del modelo EAP.
Una estrategia para implementar la confianza consiste en calcular su promedio durante el «periodo de tiempo» más reciente, en lugar de tener en cuenta todo el historial del servicio. Es como consultar las «Reseñas destacadas» en lugar de las «Más recientes» de un producto en Amazon. Puede que el producto tenga cuatro estrellas, pero si la mayoría de las valoraciones negativas se han publicado en los últimos seis meses, esto indica una pérdida reciente de confianza, mientras que una afluencia de comentarios positivos durante ese mismo periodo indicaría que el problema se ha solucionado o que la confianza se está recuperando.
El factor de confianza no se limita únicamente a si una API es una fuente conocida de datos falsos o engañosos. La reputación de una EAP también dependerá de lo bien que gestione y actualice las API de su ámbito. Además, la «confianza» también es relativa. El servicio A puede confiar en el servicio C, pero el servicio B puede haber tenido una experiencia diferente con el servicio C.
Gestor de infraestructura perimetral
Dado que una nube distribuida constituye la base de la infraestructura Edge 2.0, es imprescindible que los recursos incluidos en el ámbito de una EAP sean fáciles de detectar, estén protegidos y cuenten con la instrumentación necesaria. Lo que sigue puede interpretarse como un conjunto de recomendaciones sobre las capacidades que debe ofrecer el gestor de la infraestructura perimetral.
Descubrimiento y programación
Dentro de un EAP, los recursos pueden programarse según sea necesario. Pueden incorporarse nuevos recursos o dejar de estar disponibles de forma dinámica debido a la movilidad. Un EAP también puede enviar solicitudes a otros EAP o recibirlas de ellos para que descubran y programen recursos en su nombre según sea necesario.
Seguridad
Para reiterar el planteamiento de seguridad: la infraestructura en la que se despliega la aplicación ya está comprometida. Por tanto, la EAP debe garantizar la seguridad de la aplicación desplegada dentro de su ámbito.
Independientemente del nivel administrativo, el marco EAP debe tener en cuenta múltiples aspectos de la seguridad, como, entre otros:
Amenazas externas: Por ejemplo, ataques distribuidos de denegación de servicio (DDoS) y amenazas persistentes avanzadas (APT). Estos riesgos pueden mitigarse aplicando las mejores prácticas de seguridad existentes, como la prevención de ataques DDoS, el uso de cortafuegos, entre otras. Se recomienda que estas medidas sean obligatorias para todo el tráfico.
Ataque de intermediario: Todo el tráfico debe estar cifrado y no se puede dar por sentado que la capa de aplicación actuará correctamente. Esto garantiza la confidencialidad básica de los datos frente a cualquier dispositivo que espíe el tráfico y protege la integridad de los datos contra su manipulación durante la transmisión.
Amenazas internas: El alcance de la capa de infraestructura debe limitarse y orientarse principalmente a protegerse a sí misma. Se recomienda impedir que un recurso de la infraestructura lance un ataque interno contra el administrador de la infraestructura.
Telemetría centrada en la experiencia
Si Edge 2.0 se centra en la experiencia que ofrece y no en el activo ni en su ubicación, es lógico que la telemetría también deba centrarse en la experiencia.
La pregunta es: ¿a la experiencia de quién nos referimos? Se trata de la experiencia de cualquier entidad que resida en una infraestructura o la utilice para prestar o consumir un servicio: aplicaciones, dispositivos, personas, aplicaciones de back-end, bases de datos y mucho más. Por tanto, la experiencia se contempla desde el punto de vista de la entidad. Un servicio que una entidad presta o consume está directamente relacionado con los recursos informáticos, de almacenamiento y de red que tiene asignados.
Pero no basta con medir la experiencia; también debe haber una forma de mejorarla.
Cualquier entidad que consuma o preste un servicio puede determinar si está obteniendo la experiencia solicitada. Sin embargo, en entornos de nube distribuida, puede resultar prácticamente imposible explicar qué ocurrió en la capa de infraestructura y provocó una experiencia deficiente.
Las métricas de alto nivel, como el uso de la CPU, la memoria, el ancho de banda y las mediciones de latencia, no bastan para determinar por qué una aplicación no ofrece la experiencia solicitada3. Las métricas deben tener una granularidad temporal elevada y recopilarse en los niveles más profundos de la pila de aplicaciones y, siempre que sea posible, en las distintas capas de la pila de infraestructura.
Una estrategia sólida, escalable y ampliable de telemetría y datos es fundamental para la EAP. A partir de ahí, se pueden aprovechar estrategias de aprendizaje automático (ML) e inteligencia artificial (AI) para tomar la mejor decisión sobre la reserva de nuevos recursos o la optimización del uso de los existentes.
“Analogía con el océano: las redes subyacentes aspiran a ser como el fondo del océano, tranquilo, sereno y prácticamente inmutable con el paso del tiempo, pero, aun así, un entorno oscuro y sometido a una gran presión. Una red subyacente que intenta responder a cada requisito de cada aplicación no hace sino trasladar los torrentes turbulentos y los remolinos de la superficie al lecho marino.”
Conectividad de aplicaciones definida por software
Aunque se da por sentado que la conectividad y la accesibilidad son problemas resueltos, muchos equipos de redes siguen teniendo dificultades para adaptar su infraestructura de red a las necesidades dinámicas de la capa de aplicación. Una plataforma también debe abordar estos retos.
Argumentos para separar el plano de conectividad de las aplicaciones
El problema de los enfoques actuales es que trasladamos las necesidades de conectividad de las aplicaciones a la conectividad WAN empresarial, especialmente en una nube distribuida. Los enfoques para abordar una red de nube distribuida podrían utilizar distintas estrategias de SDN o métodos basados exclusivamente en el enrutamiento. Sin embargo, estas soluciones dependen en gran medida de la homogeneidad de la infraestructura y, por tanto, no logran ofrecer un comportamiento coherente.
La única forma de lograr una red para la aplicación que sea escalable a nivel global, segura y estable es separar el plano de conectividad de la aplicación de la red subyacente, como se explica a continuación.
Pila de conectividad propuesta
En la evolución hacia una arquitectura de nube distribuida, el modelo SDN emergente consiste en orquestar conjuntamente tanto las redes subyacentes como las redes superpuestas y permitir la programabilidad integral de la ruta de las aplicaciones.
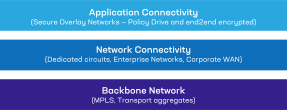
Con Edge 2.0, debemos aportar este mismo grado de estabilidad incluso al conectar redes empresariales. Proponemos que el plano de conectividad de las aplicaciones se separe de la conectividad de la red empresarial. El patrón de conectividad de las aplicaciones puede seguir o no la misma conectividad SDN que se observa en las redes superpuestas de los centros de datos (por ejemplo, VXLAN, NVGRE u otras), o patrones SDN basados en BGP.
No todas las redes se han separado en redes superpuestas y subyacentes. Los equipos de redes consideran ahora que esta capacidad de programación conjunta es un requisito importante para permitir la automatización integral, para la cual es fundamental separar la red subyacente de la superpuesta.
Separar el plano de aplicaciones de la red subyacente y del transporte elimina la necesidad de que los equipos de red respondan activamente a cada solicitud de las aplicaciones. Su ámbito se limita a proporcionar rutas robustas, estables y bien definidas, centrándose en optimizar el uso del ancho de banda agregado con las latencias más bajas.
Modelo de interfaz adaptativa
El principio fundamental de un EAP es que es independiente, autónomo y gestiona un subconjunto del espacio global de soluciones. Sin embargo, los EAP necesitan un medio para comunicarse y ofrecer sus recursos o solicitar recursos a otros EAP. Este enfoque presenta varias ventajas.
Interfaz simplificada
Una interfaz basada en resultados evita que el EAP tenga que conocer los detalles de la otra infraestructura. Supongamos que hay dos EAP: A y B. Cada EAP tiene un ámbito local de su infraestructura en el que puede programar y reservar recursos. EAP-A no necesita conocer los recursos proporcionados por EAP-B. Si, por ejemplo, EAP-A no puede satisfacer las necesidades de la aplicación y requiere recursos de la infraestructura que se encuentran dentro del ámbito de EAP-B, puede limitarse a comunicarle el objetivo deseado. A partir de ese momento, es responsabilidad de EAP-B invocar interfaces declarativas o imperativas para reservar, asignar y configurar recursos de su conjunto de recursos disponibles. EAP-B también es responsable de garantizar que se cumplan los SLO de ese servicio dentro de su infraestructura.
Aunque una sintaxis común será útil para poner en marcha un conjunto inicial de API adaptativas, la implementación se volverá más sofisticada y madura con el tiempo gracias al uso del procesamiento del lenguaje natural y la IA, lo que permitirá reducir los requisitos de calidad de los datos de entrada.
Características de EAP
- Multiinquilino: Aunque la malla de EAP que se muestra en la Figura 9 corresponde a un único despliegue, es posible disponer de varios EAP por nube. Otra aplicación podría comunicarse con un EAP diferente o con una malla de EAP.
- Diseñado para escalar: Cada malla es una red entre pares (P2P) y puede escalar horizontalmente. Los EAP pares pueden realizar un seguimiento independiente de qué EAP disponen de cada tipo de recurso y de cómo conectarse a él. La IA y el aprendizaje automático mejorarán aún más la forma en que cada EAP programa los recursos dentro de su propio ámbito o recurre a otros EAP cuando sea necesario.
- Redes integradas: Para que las aplicaciones puedan conectarse a través de la nube distribuida, el EAP debe admitir redes integradas independientes de la infraestructura subyacente.
Integración de todos los elementos
La figura 12 muestra la función de las distintas capas al implementar una aplicación en una nube distribuida.
Los aspectos más destacados de esta representación son:
- Cada EAP tiene un ámbito localizado, y no todas sus capacidades se muestran en la Figura 10. El EAP debe admitir las funciones de detección y planificación de recursos. Los EAP planifican los recursos interactuando con el controlador de infraestructura correspondiente mediante API adaptativas.
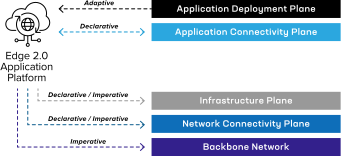
- La conectividad de las aplicaciones no es lo mismo que la conectividad de red: al igual que en el modelo de sidecar de la malla de servicios, los recursos necesarios para conectar aplicaciones en entornos multinube deben formar parte de la infraestructura de las aplicaciones. Se podría argumentar que el plano de infraestructura también proporciona conectividad de red a las aplicaciones y que, por tanto, debería situarse por debajo de la capa de red. Esto también sería técnicamente correcto, pero hemos optado por englobarlo dentro del plano de «conectividad de las aplicaciones», ya que se trata principalmente de funciones de red.
- El plano de infraestructura debe considerarse independiente del plano de aplicación.
- La conectividad de red es distinta del transporte, ya que, en esencia, hablamos de redes enrutables específicas que están separadas de la conectividad de las aplicaciones.
- El plano de transporte puede concebirse como un conjunto de redes troncales agregadas que pueden aprovisionarse, siempre que el proveedor de telecomunicaciones habilite los procesos y las API necesarios para conectar la capa de red superior.
Resumen
Este libro blanco pretende profundizar un poco más en el manifiesto original de Edge 2.0. Hemos introducido algunos temas nuevos con el objetivo de informar a las distintas partes interesadas, tanto dentro de las organizaciones como en el conjunto del sector.
Edge 2.0 se basa en el concepto de una nube distribuida en la que cada entidad puede participar tanto como origen como destino de los servicios. La idea principal es que Edge 2.0 se centrará en la experiencia, no en el activo ni en la ubicación.
La plataforma de aplicaciones en el edge (EAP) se presenta como un conjunto de capacidades que permite hacer realidad Edge 2.0 en una nube distribuida.
Se han omitido deliberadamente los detalles de implementación para ofrecer una visión independiente del proveedor.