Consideraciones sobre técnicas y tecnologías para la adopción de la confianza cero
Por Mudit Tyagi y Ken Arora
Partiendo del «porqué» —los principios rectores1 — de la confianza cero, la siguiente cuestión es el «cómo»: las técnicas y tecnologías utilizadas para aplicar dichos principios.
Desde una perspectiva más amplia, los principios de confianza cero pueden aplicarse a todo el ciclo de vida del desarrollo de aplicaciones, incluidos el diseño del sistema, las plataformas de hardware utilizadas y los procedimientos de adquisición.2 Sin embargo, este documento aborda los aspectos operativos de la implementación de la confianza cero para proteger las aplicaciones y los datos durante la ejecución.
Técnicas y tecnologías
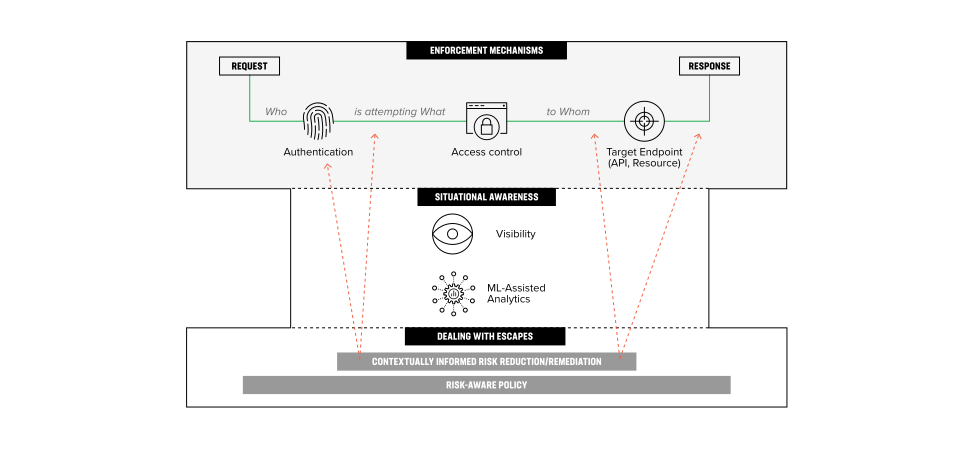
En términos generales, la seguridad de confianza cero utiliza tecnologías para alcanzar uno de estos tres objetivos distintos:
- Aplicar restricciones transaccionales: «Quién puede hacer Qué a Quién».
- Proporcionar al operador humano del sistema información sobre la situación.
- Llevar a cabo medidas más avanzadas de reducción o mitigación de riesgos, basadas en los indicadores de sospecha asistidos por aprendizaje automático (ML) y en el perfil de riesgo-beneficio de las transacciones en cuestión.
El siguiente gráfico representa este modelo transaccional general de seguridad de confianza cero. En las secciones siguientes se analiza en mayor profundidad cada clase de tecnologías.
Aplicación: autenticación y control de acceso
Motivaciones
Las dos primeras tecnologías —la autenticación y el control de acceso— están estrechamente relacionadas y se basan directamente en los principios de «verificar explícitamente» y «privilegio mínimo», ya que son fundamentales para determinar «Quién puede hacer Qué». Las implementaciones de autenticación más sofisticadas supervisan continuamente el comportamiento de un actor, reflejando así el principio de «evaluar continuamente».
Autenticación
Las tecnologías de autenticación tienen como objetivo generar confianza en una identidad acreditada: quién interviene en una transacción. El proceso de autenticación consta de tres componentes:
- Existe una declaración, o afirmación, realizada por el actor en la que indica su identidad.
- Existen ciertos datos, normalmente proporcionados por el actor, que demuestran la veracidad de la declaración.
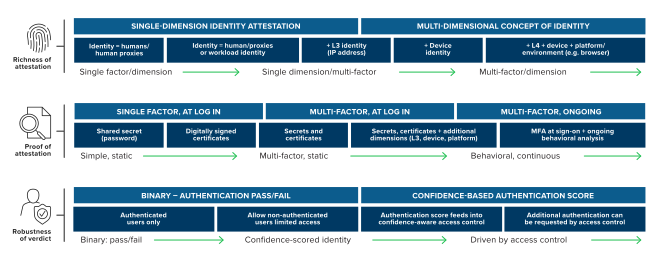
- El sistema emite un veredicto o toma una decisión sobre la probabilidad de que la declaración sea correcta, es decir, de que el actor sea quien afirma ser. El gráfico siguiente muestra los distintos aspectos de la autenticación y los modelos de madurez correspondientes a cada uno, seguido de un análisis más detallado de cada aspecto.
Atestación
La forma más básica de atestación suele denominarse «usuario»: una persona, o un agente que actúa en nombre de una persona, que desea realizar una transacción. Sin embargo, cuando se aplica la confianza cero dentro de una aplicación, un actor podría ser una carga de trabajo (como un proceso, servicio o contenedor), por lo que el concepto generalizado de identidad debería incluir a dichos actores. En otros casos, la noción de Quién incluye no solo a la persona o la carga de trabajo, sino también otras consideraciones o dimensiones de la identidad. Desde esa perspectiva, entre las dimensiones adicionales de la identidad podrían incluirse el dispositivo o la plataforma del usuario o de la carga de trabajo, el ecosistema utilizado para la interacción o la ubicación del agente. Por ejemplo, una usuaria llamada «Alice» podría estar utilizando un PC etiquetado como «ABC- 0001», con una instancia específica de un navegador identificada mediante su huella digital, y conectarse desde la dirección IPv4 10.11.12.13.
Prueba de identidad
Algunos sistemas permiten que los usuarios no autenticados, a veces denominados «invitados» o usuarios «anónimos», realicen un conjunto limitado de transacciones. En dichos sistemas, los pasos adicionales de demostrar la identidad y de que el sistema emita un veredicto no son pertinentes. Sin embargo, para cualquier identidad específica acreditada, suelen utilizarse los siguientes métodos para respaldar dicha acreditación:
- Conocimiento de un secreto compartido, como una contraseña.
- Algún tipo de credencial de un tercero de confianza, como un certificado firmado.
- Interrogación —ya sea automatizada (como la identificación de dispositivos mediante huellas digitales) o activa (como una prueba CAPTCHA)— del usuario, la carga de trabajo o la plataforma.
- Metadatos relacionados con el actor, como la geolocalización, la reputación de la IP o la hora de acceso.
- Análisis del comportamiento, como el análisis biométrico pasivo o los patrones de interacción con la aplicación dentro del flujo de trabajo.
A menudo, si se requiere un alto grado de confianza, se utilizan varios métodos. Esto queda patente en el modelo BeyondCorp de Google,3 que exige autenticación multifactor (MFA) antes de permitir transacciones de mayor valor. Las soluciones de autenticación más sofisticadas asocian un «nivel de confianza» a cada identidad y especifican un nivel de confianza mínimo para cada tipo de transacción, en función de su valor y riesgo.
Autenticación estática frente a dinámica
Por último, cabe señalar que algunos de estos métodos no son acciones estáticas y puntuales, sino que pueden y deben aplicarse de forma continua, de acuerdo con el principio de «evaluación continua». En estos casos, el nivel de confianza asignado a la acreditación de identidad puede aumentar o disminuir con el tiempo. Por ejemplo, la huella digital del navegador o la dirección IP pueden cambiar durante una misma sesión de usuario, lo que podría considerarse sospechoso y reducir la confianza. Asimismo, a medida que se recopilan más datos sobre el comportamiento del actor durante una sesión, el nivel de confianza puede aumentar o disminuir en función de cómo se compare el comportamiento actual con las observaciones anteriores.
La autenticación dinámica puede funcionar conjuntamente con el control de acceso en sistemas más avanzados. En un primer nivel de esta interacción, la política de control de acceso puede especificar una puntuación de confianza mínima para distintas clases de transacciones, como se ha mencionado anteriormente. En el siguiente nivel de interacción, el subsistema de control de acceso puede proporcionar información al subsistema de autenticación, normalmente solicitando una autenticación adicional para aumentar la puntuación de confianza hasta el umbral mínimo.
Control de acceso
Tras utilizar técnicas de autenticación para determinar quién interviene en una transacción, las siguientes preguntas son: ¿qué puede hacer ese actor? ¿Y sobre quién? De esto se ocupan las tecnologías de control de acceso.
Por establecer una analogía con la seguridad física, imagine que quisiera visitar una base militar. Una vez que los guardias hubieran determinado con certeza si es usted un civil, un político o un soldado, utilizarían esa información para decidir en qué edificios podría entrar y si podría llevar una cámara a cada uno de los edificios a los que tuviera permitido acceder. La política que rige esas decisiones podría ser muy general y aplicarse a todos los edificios (por ejemplo, «los políticos pueden entrar en cualquier edificio») o ser más específica (por ejemplo, «los políticos solo pueden entrar en los edificios <A> y <B>, pero únicamente pueden llevar cámaras al <A>»).
Aplicadas al contexto de la ciberseguridad, las técnicas de control de acceso deben incorporar el principio de «mínimo privilegio» de la confianza cero. En otras palabras, la política óptima de control de acceso permitiría únicamente los privilegios que el actor necesita y denegaría todos los demás. Además, una política sólida ideal estaría supeditada a un nivel mínimo específico de confianza en la autenticidad de la identidad del actor, con un umbral de confianza definido para cada privilegio permitido.
Por lo tanto, el valor de una solución de control de acceso puede determinarse en función de hasta qué punto se ajusta a estos ideales. En concreto, una solución de seguridad de confianza cero debe incluir un sistema de control de acceso, cuya tecnología debe evaluarse según las dimensiones que se muestran a continuación y se describen posteriormente.
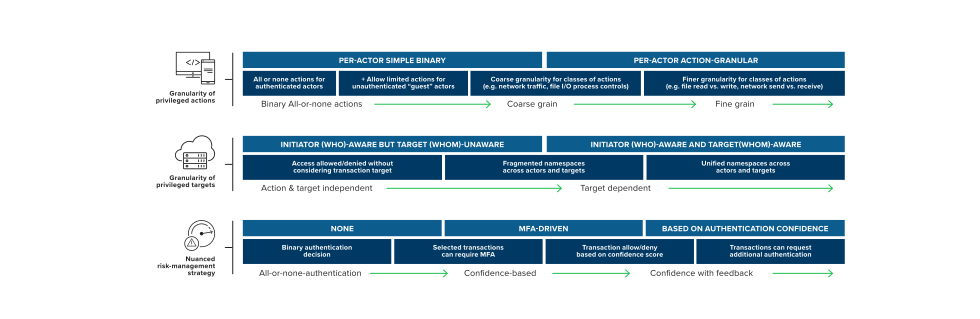
- ¿Qué nivel de granularidad tienen los privilegios de control de acceso?
- ¿Cuál es el nivel de granularidad de la acción, es decir, el «qué» de la transacción? ¿Se trata de:
- Binario: Permitir «todas» las transacciones o «ninguna». Siguiendo la analogía de la base militar, esto equivaldría a «todos los soldados pueden entrar en cualquier edificio y hacer lo que quieran» y «los civiles no pueden entrar en ningún edificio».
- Grueso: Granular a nivel del endpoint de la API o del «tipo» de transacción (como la E/S de archivos, la comunicación de red y los controles de procesos). En nuestro ejemplo, esto permitiría introducir cierto grado de matización en la acción permitida, como «los políticos pueden entrar en los edificios, pero no hacer fotos».
- Fino: A nivel de sub-API (es decir, en función de los parámetros o de la versión de la API) o de «subtipo» de transacción (como E/S de archivos de solo lectura o recepción TCP únicamente). Retomando nuestra analogía una vez más, esto permitiría controles más detallados, como «los civiles solo pueden entrar en edificios si van acompañados de un soldado».
- ¿Existe granularidad en cuanto al destinatario de la acción, es decir, el «quién» de la transacción? ¿Se trata de:
- Sin granularidad por objetivo: La política de control de acceso no tiene en cuenta el objetivo de la acción. En nuestro ejemplo, este enfoque equivaldría a permitir la entrada a unos edificios, pero no a otros, siendo los edificios el objetivo de la acción «entrar».
- Granular por objetivo, a nivel de infraestructura: La política de control de acceso puede incluir el objetivo de la acción, pero utiliza alguna etiqueta específica de la infraestructura, como la dirección IP, el nombre DNS o el nombre del contenedor de Kubernetes (K8S) del objetivo. Esto permitiría que la política tuviera granularidad a nivel de edificio, pero cada base militar podría utilizar una convención diferente para nombrar los edificios.
- Granular a nivel de objetivo y con reconocimiento de identidad: La política de control de acceso puede incluir el objetivo de la acción e identificarlo mediante el mismo espacio de nombres de identidad (por ejemplo, SPIFFE) utilizado para el actor (el «quién»). La ventaja respecto al enfoque anterior es que todas las bases militares utilizarían un sistema coherente para identificar los edificios, lo que facilitaría la portabilidad de la política.
- ¿Cuál es el nivel de granularidad de la acción, es decir, el «qué» de la transacción? ¿Se trata de:
- ¿Cómo aborda la solución de control de acceso el concepto de acciones de menor o mayor riesgo?
- No tiene en cuenta el riesgo: La solución de control de acceso trata todos los privilegios de control de acceso de la misma manera a la hora de decidir si permite o deniega la acción.
- Gestión de riesgos mediante MFA: La solución de control de acceso gestiona el riesgo permitiendo que la política especifique que determinadas transacciones autorizadas sigan requiriendo autenticación multifactor, en función del actor (Quién), la acción (Qué), o el destinatario (A quién) implicado en la transacción.
- Gestión de riesgos mediante el nivel de confianza: La solución de control de acceso gestiona el riesgo permitiendo que la política especifique que cualquier transacción puede requerir un nivel mínimo de confianza en la autenticidad del actor, en función de la acción (Qué) y del destinatario (A quién) de la transacción. La MFA puede aumentar el nivel de confianza, aunque también pueden utilizarse otros medios; en otros casos, la transacción puede denegarse por completo si es de alto valor y existe suficiente incertidumbre sobre la autenticidad del actor.
Teniendo en cuenta el principio de «evaluar (y reevaluar) continuamente», el grado de certeza sobre la autenticidad del actor debe ajustarse con el tiempo. En una solución sencilla, podría tratarse simplemente de un tiempo de espera; en sistemas más sofisticados, el nivel de confianza podría variar en función de las observaciones del comportamiento del actor a lo largo del tiempo.
Conciencia situacional: motivaciones para la visibilidad y el análisis contextual asistido por aprendizaje automático
Si la autenticación y el control de acceso son aplicaciones de la mentalidad de «verificar siempre» y «privilegio mínimo», la visibilidad y el análisis contextual constituyen la base de los principios de «evaluación continua» y «presunción de vulneración».
La visibilidad es el requisito previo indispensable para el análisis: un sistema no puede mitigar aquello que no puede ver. Por tanto, la eficacia de la solución de seguridad de confianza cero será directamente proporcional a la profundidad y amplitud de la telemetría que pueda recopilarse de las operaciones del sistema y del contexto externo. Sin embargo, una infraestructura de visibilidad moderna podrá proporcionar muchos más datos, metadatos y elementos contextuales potencialmente útiles de los que cualquier persona sin asistencia podría gestionar a tiempo de forma razonable. Dado que se desea disponer de más datos y poder convertirlos en información útil con mayor rapidez, un requisito clave es que los operadores humanos cuenten con asistencia automatizada.
Esta asistencia suele implementarse mediante algoritmos automatizados que abarcan desde el análisis basado en reglas y los métodos estadísticos hasta algoritmos avanzados de aprendizaje automático. Estos algoritmos se encargan de transformar el torrente de datos sin procesar en información práctica y utilizable sobre la situación, que los operadores humanos pueden emplear para evaluarla y, si es necesario, aplicar medidas correctivas. Por este motivo, el análisis asistido por aprendizaje automático va de la mano de la visibilidad.
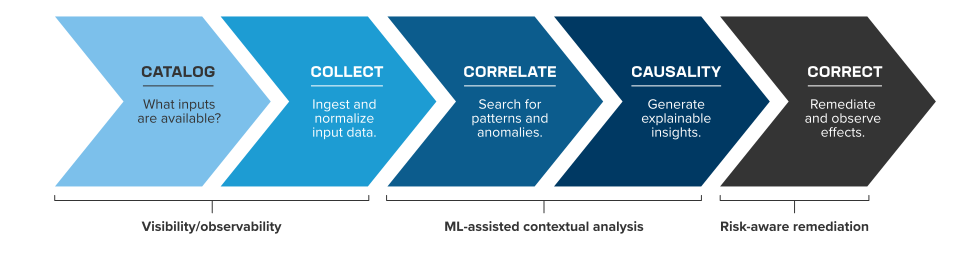
A continuación se muestra el flujo de trabajo general desde los datos sin procesar (visibilidad) hasta la acción (corrección):
Visibilidad
La visibilidad es la implementación —el «cómo»— del principio de confianza cero de «evaluación continua». Incluye mantener un inventario de las fuentes de datos disponibles (Catalogar), así como telemetría en tiempo real y la conservación de datos históricos (Recopilar).
La madurez de una implementación de visibilidad de confianza cero debe evaluarse teniendo en cuenta cuatro factores:
- Latencia: ¿Hasta qué punto se aproximan los datos al tiempo real?
La latencia establece el tiempo mínimo necesario para responder a una posible amenaza. La latencia de una solución de confianza cero debe medirse en segundos o menos; de lo contrario, es muy probable que cualquier análisis, por preciso que sea, llegue demasiado tarde para evitar las consecuencias del ataque, como la exfiltración o el cifrado de datos, o la falta de disponibilidad por agotamiento de recursos. Los sistemas más sofisticados pueden permitir mitigaciones tanto síncronas como asíncronas. La mitigación síncrona impediría que la transacción se completara hasta que se hubieran obtenido una visibilidad y un análisis completos. Dado que es probable que la mitigación síncrona añada latencia a la transacción, este modo de funcionamiento se reservaría para transacciones especialmente anómalas o arriesgadas, mientras que todas las demás podrían enviar telemetría y analizarse de forma asíncrona. - Facilidad de uso: ¿Con qué facilidad se pueden utilizar los datos?
Esta cuestión es relevante cuando los datos proceden de varias fuentes o de distintos tipos de sensores de datos, algo habitual. Este factor suele dividirse en dos aspectos.
En el plano sintáctico, se debe determinar cómo extraer y representar los datos. Por ejemplo, si la reputación de una IP de origen llega como un campo de texto (por ejemplo, «maliciosa», «sospechosa», «desconocida», etc.) en un mensaje syslog procedente de una fuente, y como un campo numérico con codificación binaria en un archivo de datos procedente de otra, debe definirse una representación canónica. Será necesario serializar los datos para extraer y transformar los datos entrantes en dicha representación.
En el plano semántico, las distintas fuentes pueden diferir no solo en su sintaxis y transporte, sino también en su semántica. Retomando el ejemplo de la reputación de una IP, un proveedor puede proporcionar una puntuación de amenaza numérica, mientras que otro puede clasificar la IP en una categoría como «nodo TOR», «control DNS» o «phishing». La solución de visibilidad también debe proporcionar un mecanismo para normalizar los datos entrantes y convertirlos a una sintaxis coherente. - Integridad: ¿Cuál es la amplitud y profundidad de los datos disponibles?
Una de las principales ventajas de una solución de visibilidad de alta calidad es la capacidad de detectar actividades sospechosas que puedan indicar una posible brecha de seguridad. Para hacerlo de forma eficaz, la solución debe recibir telemetría de todas las «capas» relevantes de la entrega de aplicaciones: la propia aplicación, por supuesto, pero también la infraestructura de la aplicación, la infraestructura de red, cualquier servicio aplicado a la aplicación o utilizado por ella, e incluso los eventos del dispositivo cliente. Por ejemplo, detectar que un usuario accede desde un dispositivo nuevo, nunca visto antes, puede resultar ligeramente sospechoso por sí solo; pero, al combinarlo con información de red (como la geolocalización GeoIP desde un país extranjero), el nivel de sospecha aumenta. Este nivel de sospecha se refleja en una puntuación de confianza más baja respecto a la identidad del usuario. En el contexto de una política de seguridad de confianza cero, cuando este actor intenta realizar una transacción de alto valor (como transferir fondos a una cuenta extranjera), la solución de control de acceso puede optar por bloquear la transacción debido al bajo nivel de confianza.
En lo que respecta al enfoque de confianza cero, cuanto más profunda y completa sea la solución de visibilidad, más eficaz podrá ser el sistema a la hora de limitar adecuadamente las transacciones y detectar brechas de seguridad. - Gobernanza: ¿En qué medida se cumplen los requisitos legales y de licencia relativos al uso de los datos?
Por último, toda recopilación de datos debe cumplir los requisitos legales y de licencia relativos a la seguridad, la conservación y el uso de los datos. Por tanto, una solución de visibilidad sólida debe abordar cada una de estas necesidades. Las restricciones sobre el uso de los datos derivadas de la gobernanza deben tenerse en cuenta en una solución de visibilidad de confianza cero. Por ejemplo, si una dirección IP se considera información de identificación personal (PII), el uso y la conservación a largo plazo de direcciones IP con fines de análisis deben ajustarse a los usos permitidos de dichas direcciones.
Análisis contextual asistido por máquinas
Además de la visibilidad, el otro mecanismo necesario para implementar la «evaluación continua» son las herramientas analíticas que permiten realizar una evaluación significativa; es decir, una evaluación que pueda aplicarse de forma operativa mediante una solución de confianza cero.
Un aspecto que debe tenerse en cuenta en el análisis es el alcance y la amplitud de los datos de entrada. Las entradas de los algoritmos de análisis pueden limitarse a un único flujo de datos procedente de una sola fuente, o bien abarcar varios flujos, incluidos los procedentes de diversas fuentes de datos y de todas las capas de la infraestructura y la aplicación.
- La contextualización más básica se limita al ámbito de un único «tipo» o «flujo» de datos (por ejemplo, un flujo de eventos de «información de inicio de sesión del usuario con la hora y la dirección IP de origen»), normalmente con contexto histórico o datos de varios usuarios. Este análisis puede aportar información básica, como «este usuario <X> nunca ha iniciado sesión a esta hora del día» o «este usuario <X> parece iniciar sesión siempre inmediatamente después que el usuario <Y>». Lo primero puede reducir la confianza en la identidad; lo segundo puede ser indicativo de algún patrón de nivel superior, quizá malicioso.
- Una contextualización más avanzada tiene en cuenta el alcance temporal y de múltiples instancias no solo para un único «tipo» de datos, sino que también establece correlaciones temporales entre distintos «tipos» o «flujos» de datos. Un ejemplo sería correlacionar los datos de inicio de sesión de los usuarios con acciones específicas en la capa de aplicación (como transferencias de dinero o actualizaciones de contactos de correo electrónico) o en la capa de red (como una consulta de geolocalización basada en la dirección IP).
Un segundo aspecto especialmente relevante del análisis en el marco de confianza cero es la gestión del volumen y la velocidad de los datos ingeridos, que superarán la capacidad de procesamiento de cualquier persona. Por tanto, se requiere algún tipo de asistencia automatizada para generar información que resulte comprensible para las personas. Una vez más, el grado de sofisticación de esta asistencia puede describirse como una progresión.
- Solo visualización: El primer paso consiste en presentar estadísticas y eventos sin procesar, normalmente mediante paneles de control disponibles en un portal de gestión. Los datos presentados se basan en los flujos de datos recopilados (por lo general, una serie temporal o un análisis transversal longitudinal de usuarios o transacciones dentro de un intervalo de tiempo fijo). Los paneles de control más avanzados permiten ordenar y agrupar los datos, así como profundizar en ellos mediante filtros. En este modelo, la persona se encarga de toda la exploración de datos, la priorización de eventos, el análisis y la corrección, mientras que la automatización ayuda principalmente a explorar los datos.
- Visualización con reglas estáticas configurables: La ampliación más habitual de la visualización consiste en permitir que una persona defina reglas estáticas, ya sea para generar alertas o para aplicar medidas correctivas. Algunos ejemplos serían «notificar a <John> si <la carga de la CPU supera el 80 % durante un periodo de 5 minutos>» o «exigir <MFA por correo electrónico> si <se invoca la API [Y] y el país no es [Estados Unidos]>». Estas reglas pueden limitarse a opciones predefinidas por el proveedor de la solución, aunque los subsistemas basados en reglas más avanzados también pueden permitir reglas personalizadas escritas por un ingeniero de SecOps. En cualquier caso, las reglas aplicadas suelen controlarse (y definirse, si es necesario) mediante la configuración.
- Visualización con asistencia de aprendizaje automático: El siguiente nivel utiliza técnicas más avanzadas que detectan anomalías de comportamiento o transacciones que coinciden con los patrones de transacciones maliciosas identificadas previamente. Aunque se utilizan muchas técnicas (y un análisis exhaustivo de las implicaciones técnicas y empresariales queda fuera del alcance de este documento), hay algunos aspectos clave que deben tenerse en cuenta:
- Esfuerzo humano necesario: Algunas técnicas de aprendizaje automático requieren «entrenamiento» (es decir, aprendizaje supervisado), lo que significa que un conjunto de datos de un tamaño razonable debe clasificarse previamente mediante un «clasificador» fiable y de confianza. A menudo, para garantizar que la clasificación sea fiable, el «clasificador» acaba siendo una persona o un grupo de personas. En esos casos, debe tenerse en cuenta el esfuerzo humano necesario. Otras técnicas (es decir, de aprendizaje no supervisado) detectan anomalías o reconocen patrones por sí solas, sin intervención humana.
- Explicabilidad: Los resultados de un sistema de aprendizaje automático se obtienen al evaluar los datos de entrada con respecto a un modelo. Este modelo puede basarse en una serie de preguntas sencillas y fáciles de responder, como: «¿Se ha visto a este usuario en este dispositivo durante el último mes?». También podría basarse en una similitud fácil de explicar, como: «Este usuario encaja en el patrón general que he observado en usuarios que nunca inician sesión durante el horario laboral». En otros casos, el modelo puede basarse en la aplicación de un conjunto complejo de operaciones de álgebra vectorial a los datos de entrada, sin una lógica de alto nivel fácilmente discernible. Este último caso es claramente menos explicable —se asemeja más a una «caja negra»— que los dos ejemplos anteriores. En algunos casos, la explicabilidad es un factor importante para facilitar la comprensión humana o la auditabilidad. En esos casos, se preferirá claramente un modelo explicable frente a uno inescrutable.
- Disponibilidad de una puntuación de confianza: Como se ha mencionado anteriormente, suele resultar muy útil disponer de una métrica que indique el grado de confianza del modelo en una decisión; en otras palabras, una estimación de la probabilidad relativa de que se produzca un falso positivo o un falso negativo. Algunos algoritmos generan de forma natural una métrica de confianza; en otros, como los basados en reglas, sería necesario especificar explícitamente un nivel de confianza como uno de los resultados. En cualquier caso, los algoritmos capaces de proporcionar una puntuación de confianza son más robustos que los que no pueden hacerlo.
Al igual que con el enfoque basado en reglas, la asistencia mediante aprendizaje automático puede utilizarse únicamente para la detección o vincularse a una corrección automática. Además, puede combinarse con un sistema basado en reglas, en el que el «veredicto» (u opinión o nivel de confianza) del modelo de aprendizaje automático se utilice como entrada para una regla, por ejemplo: «realizar la acción <X> si <el evaluador de aprendizaje automático [bot_detector_A] detecta un bot con un nivel de confianza superior al 90 %>».
Gestión de evasiones: mitigación automatizada basada en el riesgo
El último principio de la mentalidad de confianza cero es «presuponer una brecha». Para ser claros y ponerlo en perspectiva, los métodos de autenticación y control de acceso correctamente implementados son eficaces para evitar la inmensa mayoría de las transacciones maliciosas. Sin embargo, por un exceso de cautela, se debe asumir que los mecanismos de aplicación de la autenticación y el control de acceso serán vulnerados por algún adversario lo bastante motivado o afortunado. La detección de brechas, necesaria para responder a estas evasiones a tiempo, requiere visibilidad y análisis asistido por máquinas. Por tanto, dado que los demás mecanismos de aplicación serán vulnerados en ocasiones, las tecnologías de visibilidad que alimentan el análisis contextual asistido por aprendizaje automático son esenciales para sustentar la solución de último recurso de la seguridad de confianza cero: la remediación basada en riesgos.
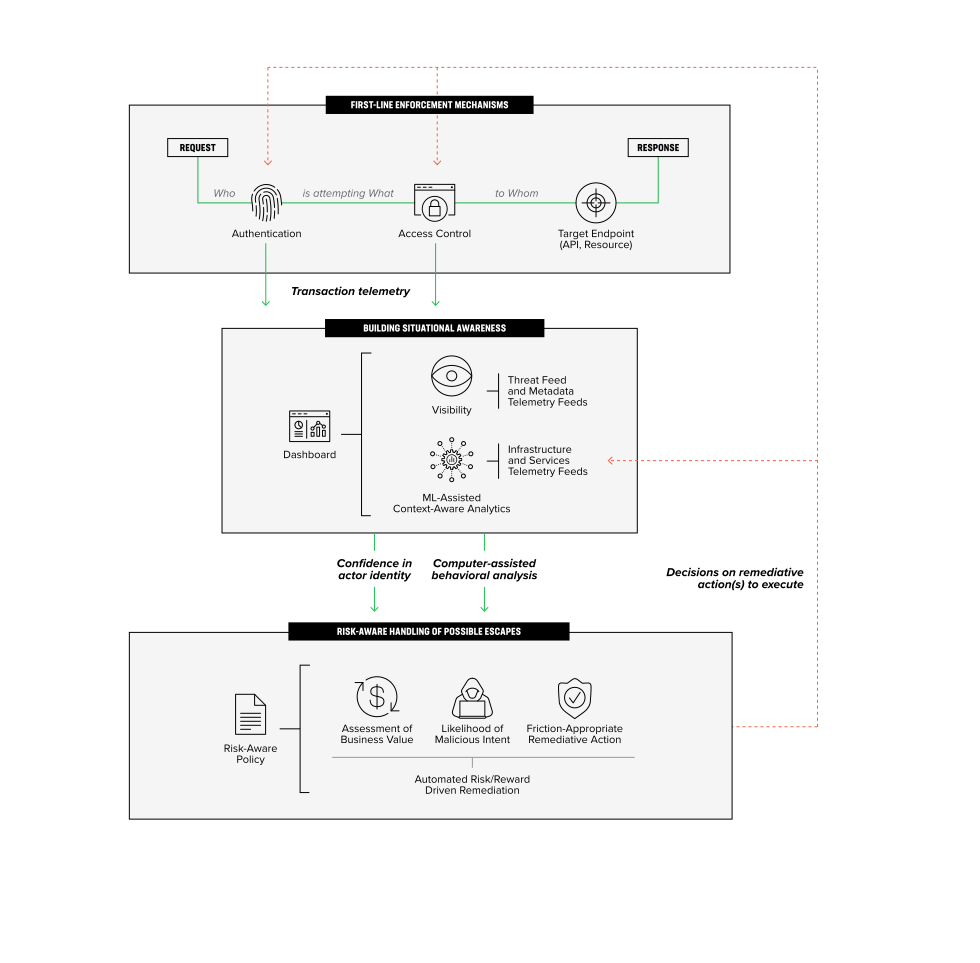
En los casos de «falsos negativos» en los que una transacción realmente maliciosa haya logrado eludir la autenticación y el control de acceso, debe utilizarse como último recurso el mecanismo de corrección automatizada basada en el riesgo. Sin embargo, dado que esta tecnología se aplica como último recurso a transacciones que han superado los controles de seguridad previos, existe un mayor riesgo de clasificar erróneamente lo que en realidad era un «verdadero negativo» (una transacción válida y deseable) como un «falso positivo» (una transacción identificada erróneamente como maliciosa). Para mitigar este riesgo, cualquier medida correctiva que se active ante la sospecha de una posible actividad maliciosa que, por algún motivo, no haya sido detectada por la autenticación o el control de acceso debe basarse en los tres factores siguientes:4
- Valor comercial de la transacción: Las distintas transacciones tendrán diferentes niveles de riesgo y beneficio. Por ejemplo, una transacción para consultar una cuenta bancaria entraña menos riesgo que una transacción para transferir dinero a una cuenta extranjera. Del mismo modo, para una aerolínea, la compra de un billete probablemente aporte un mayor beneficio comercial que una transacción para consultar los retrasos actuales de los vuelos. El valor comercial es el beneficio comercial potencial ponderado en función del perfil de riesgo de la transacción. Es más aceptable tolerar los efectos de posibles «falsos positivos» derivados de medidas correctivas preventivas en transacciones de bajo beneficio y alto riesgo que en transacciones de alto beneficio y bajo riesgo, que tienen un elevado valor comercial.
- Confianza en la creencia sobre la «intencionalidad maliciosa»: Por supuesto, no todas las propuestas de mitigación preventiva son iguales. En concreto, además de la relación entre riesgo y beneficio mencionada anteriormente, el otro factor clave es la confianza en las creencias relativas a esa transacción, como la confianza en la identidad acreditada del actor. A grandes rasgos, la probabilidad de que se produzca un «falso negativo» —es decir, de que los mecanismos de control no se hayan activado cuando deberían haberlo hecho— es inversamente proporcional a la confianza en el actor. Y dado que el objetivo de la mitigación basada en riesgos es reducir los «falsos negativos», cuanto menor sea la confianza, mayor deberá ser la predisposición del sistema a aplicar medidas de mitigación.
- Impacto de la medida correctiva: Por último, no todas las medidas correctivas se reducen a una decisión binaria: permitir o bloquear. De hecho, existen diversas técnicas de reducción de riesgos, desde algunas visibles para el usuario (por ejemplo, solicitar credenciales adicionales o autenticación multifactor, o plantear un desafío como un captcha) hasta otras que pasan prácticamente inadvertidas (realizar una inspección más exhaustiva del tráfico, como DLP, o llevar a cabo un análisis más avanzado que requiera un uso intensivo de recursos informáticos). Por tanto, el impacto de aplicar estas formas adicionales de reducción de riesgos —medido en función de las molestias que experimenta el usuario y de los costes operativos para la aplicación (por ejemplo, los derivados de DLP o de análisis que requieren un uso intensivo de recursos informáticos)— es el tercer factor que debe tenerse en cuenta. Se prefieren las medidas correctivas de bajo impacto y transparentes para el cliente frente a los desafíos de mayor impacto visibles para este, mientras que el bloqueo directo de la transacción es la opción menos atractiva. No obstante, el bloqueo puede ser adecuado cuando el grado de certeza es alto o en el caso de transacciones de riesgo en las que los demás mecanismos de reducción de riesgos no permiten aumentar suficientemente dicho grado de certeza.
Conclusiones
La seguridad de confianza cero es una evolución más moderna de enfoques de seguridad anteriores, como la defensa en profundidad, que amplía las prácticas existentes al adoptar una perspectiva de la seguridad centrada en las transacciones: quién intenta hacer qué a quién. Este enfoque permite proteger no solo el acceso externo a una aplicación, sino también sus componentes internos.5 Partiendo de esta perspectiva transaccional fundamental, la seguridad de confianza cero se basa en un conjunto de principios esenciales que se utilizan para proteger las aplicaciones en el entorno actual, más complejo y exigente. Estos principios se traducen, a su vez, en un conjunto de soluciones o métodos a nivel de subsistema que los materializan. A continuación, se resumen los principios esenciales y su correspondencia con los métodos de solución.
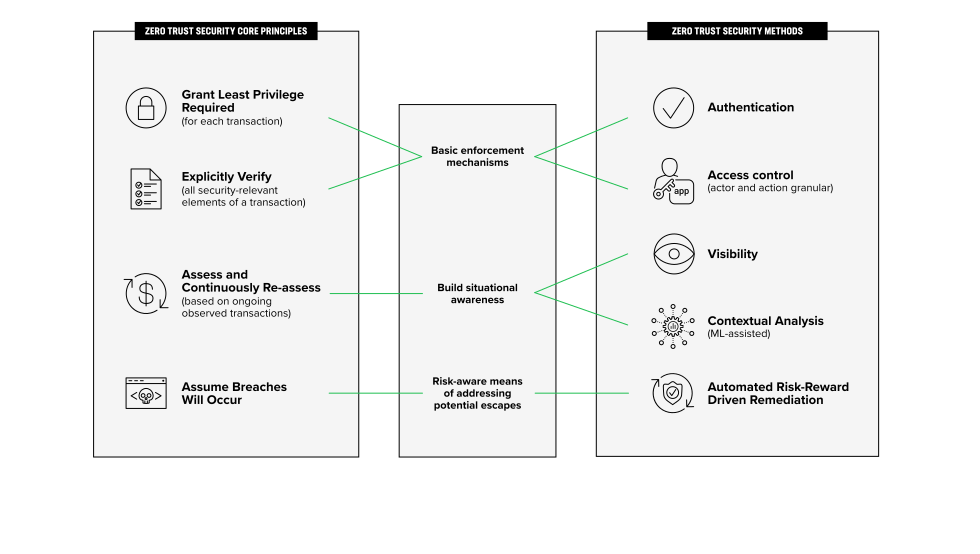
Estas herramientas —los métodos de autenticación, control de acceso, visibilidad, análisis contextual y corrección basada en el riesgo— son necesarias y suficientes para prevenir una amplia variedad de tipos de ataques.
Recursos
1 https://www.f5.com/services/resources/white-papers/why-zero-trust-matters-for-more-than-just-access
2 La confianza cero puede y debe aplicarse incluso «a la izquierda» de la canalización de CI/CD. Herramientas como las de evaluación de vulnerabilidades, el análisis estático, las bases de datos de CVE, las bases de datos de reputación del código abierto y los sistemas de supervisión de la integridad de la cadena de suministro son coherentes con el enfoque de confianza cero.
3 https://cloud.google.com/beyondcorp-enterprise/docs/quickstart
4 Tenga en cuenta que la línea divisoria entre el control de acceso contextual y basado en el riesgo y el tema general de la corrección basada en el riesgo no está claramente definida, por lo que existe cierto solapamiento.
5 A menudo denominada protección intraaplicación «este-oeste», en contraposición a la protección «norte-sur» de acceso a la aplicación.