
Introducción al balanceo de carga: conceptos básicos
Introducción
En el dinámico mercado actual, centrado en las aplicaciones, las organizaciones están sometidas a una presión cada vez mayor para ofrecer la información, los servicios y las experiencias que esperan sus clientes, y hacerlo de forma rápida, fiable y segura. Las funciones clave de red y de aplicaciones, como el equilibrio de carga, el cifrado, la aceleración y la seguridad, pueden proporcionarse mediante controladores de entrega de aplicaciones (ADC), dispositivos físicos o virtuales que actúan como proxies de servidores físicos. Ante el crecimiento explosivo de las aplicaciones y las exigencias que impone a las organizaciones el riguroso ciclo de integración continua y despliegue continuo (CI/CD), no es de extrañar que se prevea que el mercado de los ADC alcance los 2.900 millones de dólares anuales en 2020.1
Pero antes de adentrarnos en el futuro, veamos cómo hemos llegado hasta aquí. El equilibrio de carga basado en red es la base esencial sobre la que funcionan los ADC. A mediados de la década de 1990, los primeros dispositivos de hardware de equilibrio de carga comenzaron a ayudar a las organizaciones a escalar sus aplicaciones mediante la distribución de las cargas de trabajo entre servidores y redes. Estos primeros dispositivos eran independientes de las aplicaciones y se encontraban fuera de los propios servidores de aplicaciones, lo que les permitía equilibrar la carga mediante técnicas de red sencillas. En esencia, estos dispositivos presentaban una «dirección IP virtual» al mundo exterior y, cuando los usuarios intentaban conectarse, reenviaban la conexión al servidor físico más adecuado mediante una traducción bidireccional de direcciones de red (NAT).
Sin embargo, con la llegada de la virtualización y la computación en la nube, surgió una nueva generación de ADC de equilibrio de carga en forma de ediciones virtuales distribuidas como software y diseñadas para ejecutarse en hipervisores. Hoy en día, los dispositivos virtuales pueden prestar servicios de aplicaciones con la misma variedad de funciones que los que se ejecutan en hardware específico. Además, estas ediciones virtuales eliminan gran parte de la complejidad que conlleva trasladar servicios de aplicaciones entre entornos virtuales, en la nube e híbridos, lo que permite a las organizaciones poner en marcha servicios de aplicaciones de forma rápida y sencilla en entornos de nube privada o pública.
La última tendencia que ha llegado al centro de datos es la contenerización, un método de virtualización de aplicaciones que facilita la implementación y ejecución de aplicaciones distribuidas. Este proceso aísla las aplicaciones y las confina en espacios de memoria claramente delimitados dentro de un sistema operativo compartido, lo que no solo simplifica el desarrollo y la implementación de una aplicación en comparación con la creación de un dispositivo virtual, sino que también agiliza el proceso. Gracias a las importantes mejoras en portabilidad y rendimiento, la contenerización podría ofrecer a las empresas una mayor escalabilidad y agilidad. En el futuro, las arquitecturas de contenedores también podrían ayudar a las organizaciones a aprovechar mejor los distintos entornos de nube.
Los ADC actuales evolucionaron a partir de los primeros balanceadores de carga mediante el proceso de virtualización de servicios. Ahora, con las ediciones virtuales basadas exclusivamente en software, los ADC no solo pueden mejorar la disponibilidad, sino también ayudar a las organizaciones a ofrecer las aplicaciones escalables, seguras y de alto rendimiento que necesitan sus negocios. Sin embargo, en última instancia, todos estos servicios de aplicaciones virtualizados, despliegues de infraestructura compartida y funciones de enrutamiento inteligente no serían posibles sin la sólida base de la tecnología de balanceo de carga.
Para comprender cómo pueden las empresas afrontar mejor los complejos retos de un mercado en constante evolución, exploremos los fundamentos de la entrega de aplicaciones: introducción al balanceo de carga.
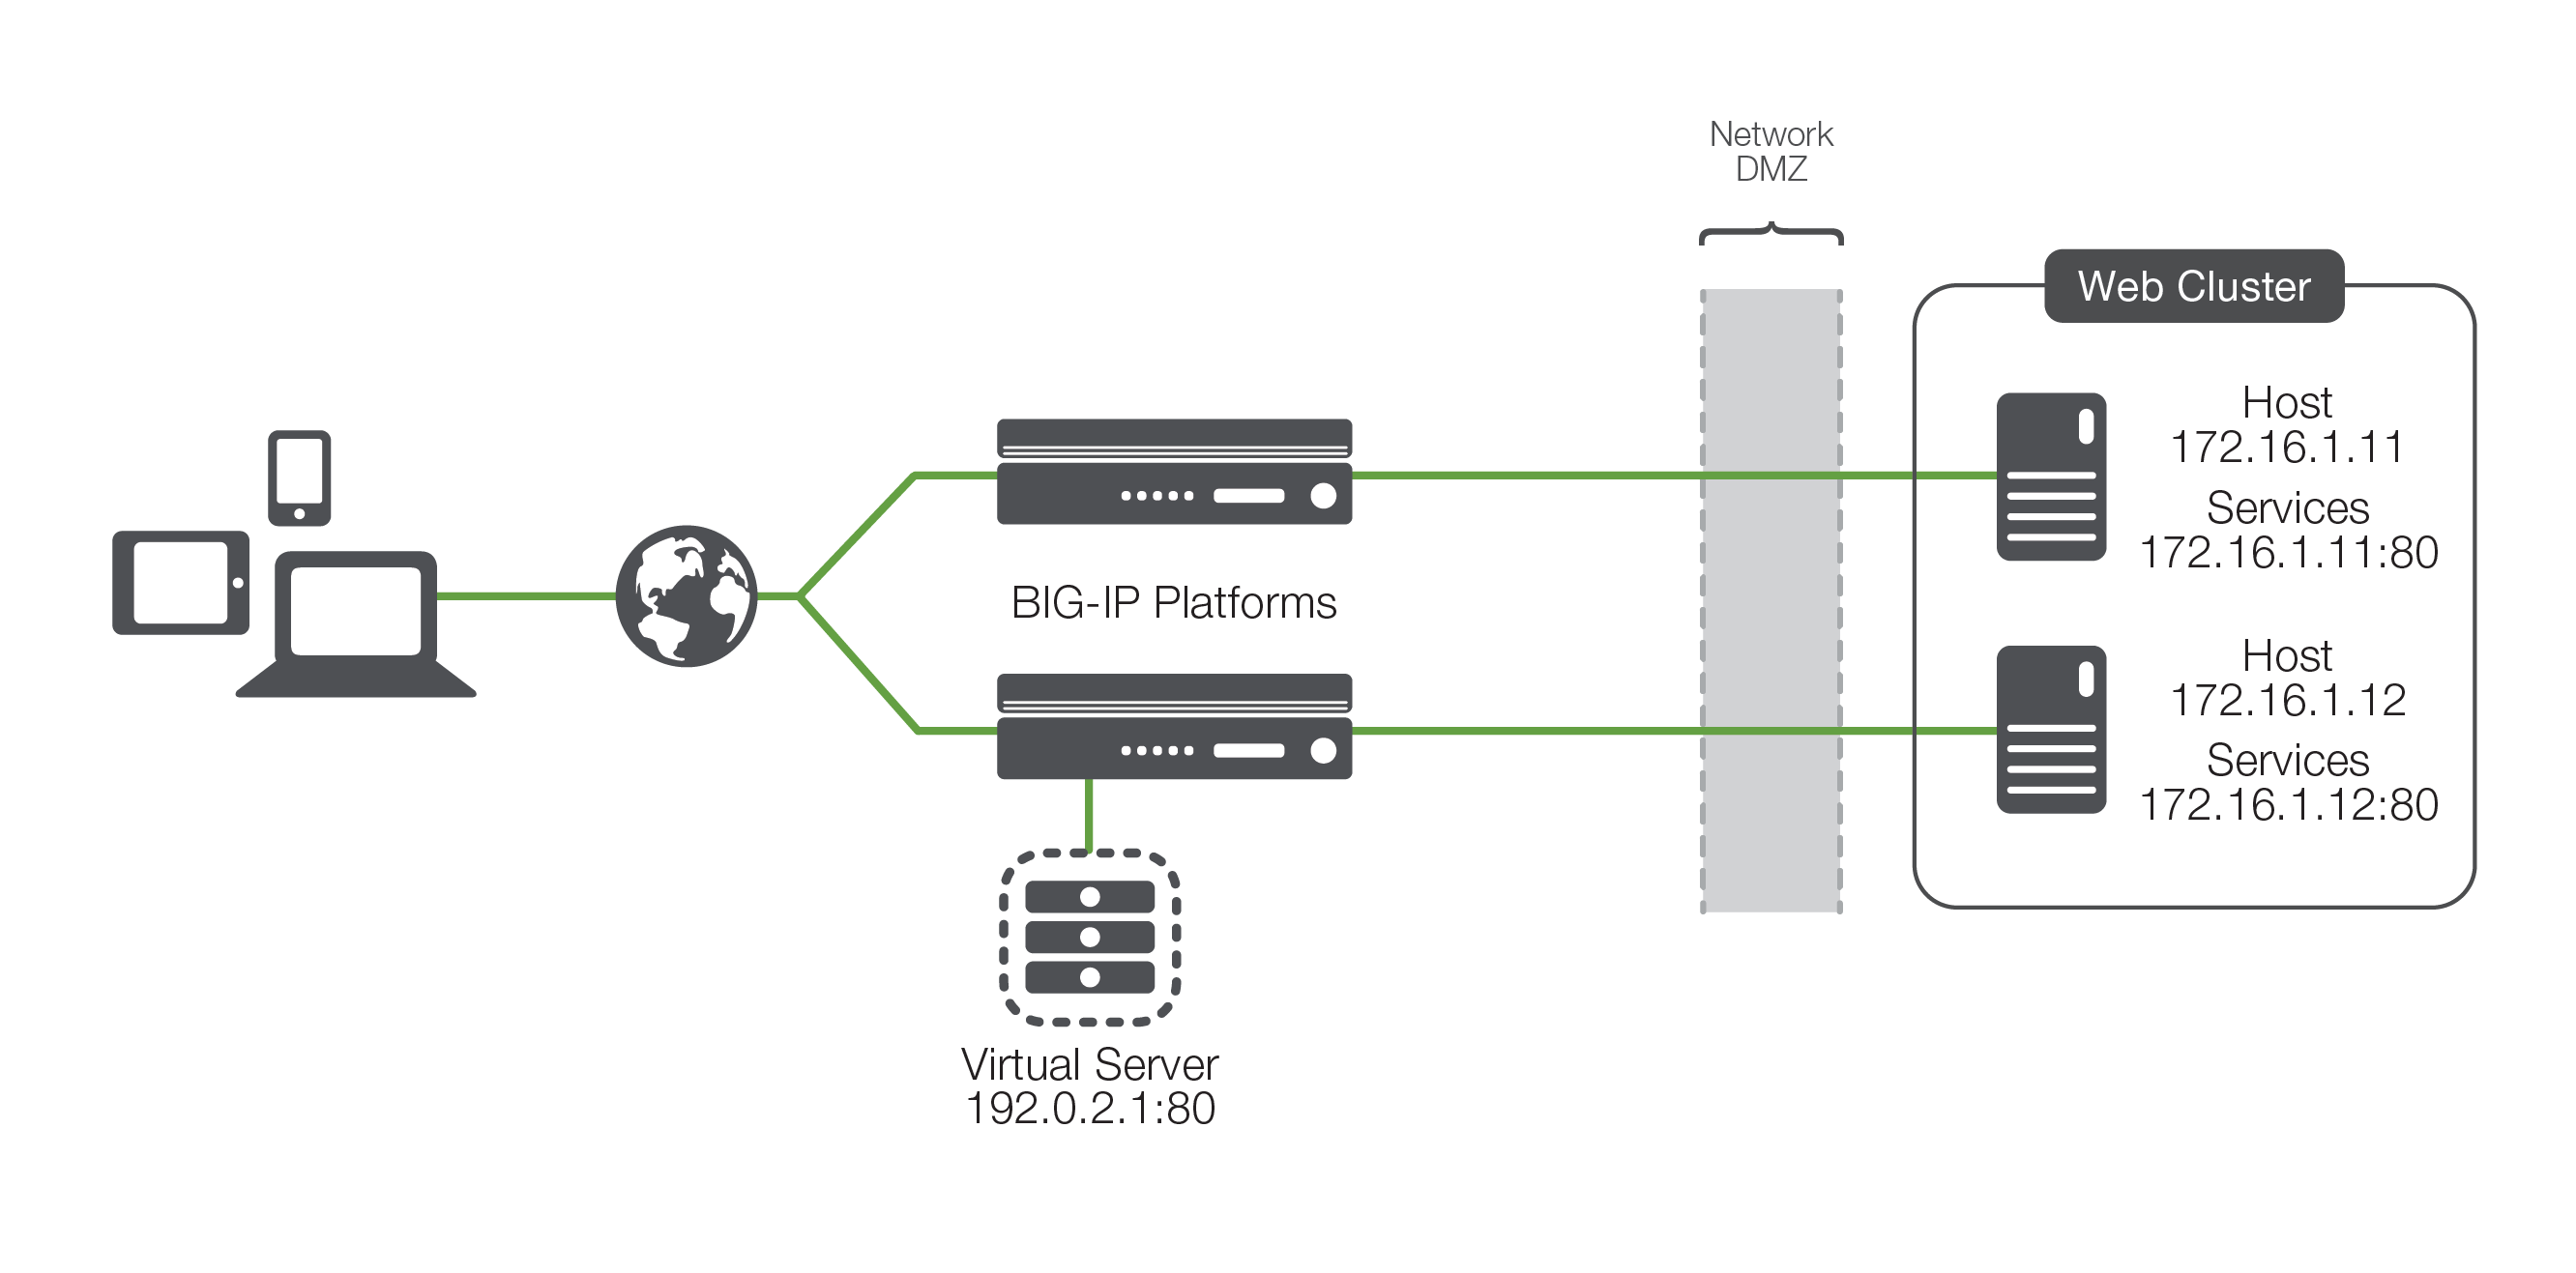
Conceptos básicos: terminología
Antes de empezar, repasemos la terminología básica del balanceo de carga. Esto sería más sencillo si todo el mundo utilizara el mismo vocabulario; por desgracia, cada proveedor de dispositivos de balanceo de carga (y, por extensión, de ADC) parece emplear una terminología diferente. Sin embargo, con una breve explicación podemos aclarar la confusión.
Nodo, host, miembro y servidor
La mayoría de los ADC de equilibrio de carga utilizan los conceptos de nodo, host, miembro o servidor; algunos emplean los cuatro, aunque cada uno tiene un significado distinto. Todos estos términos tratan de expresar dos conceptos básicos. Uno de ellos —normalmente denominado nodo o servidor— hace referencia al propio servidor físico o virtual que recibirá el tráfico del ADC. Este concepto equivale a la dirección IP del servidor físico y, si no hubiera un equilibrador de carga, sería la dirección IP a la que se resolvería el nombre del servidor (por ejemplo, www.example.com). En el resto de este documento, nos referiremos a este concepto como host.
El segundo concepto se expresa mediante el término «miembro» (que, por desgracia, algunos fabricantes también denominan nodo). Un miembro suele estar algo más definido que un host, ya que incluye el puerto TCP de la aplicación que recibirá el tráfico. Por ejemplo, un host denominado www.example.com puede resolverse en la dirección 172.16.1.10, que representa al host, y puede tener una aplicación (un servidor web) ejecutándose en el puerto TCP 80, por lo que la dirección del miembro sería 172.16.1.10:80. En pocas palabras, el miembro incluye tanto la definición del puerto de la aplicación como la dirección IP del servidor físico o virtual. En el resto de este documento, nos referiremos a este concepto como el servicio.
¿Por qué tanta complejidad? Porque distinguir entre un servidor y los servicios de aplicaciones que se ejecutan en él permite que el equilibrador de carga interactúe individualmente con las aplicaciones, en lugar de hacerlo con el hardware subyacente o el hipervisor, ya sea en un centro de datos o en la nube. Un host (172.16.1.10) puede tener más de un servicio disponible (HTTP, FTP, DNS, etc.). Al definir cada aplicación de forma única (por ejemplo, 172.16.1.10:80, 172.16.1.10:21 y 172.16.1.10:53), el ADC puede aplicar un equilibrado de carga y una supervisión del estado específicos (un concepto que abordaremos más adelante) en función de los servicios, en lugar del host.
Recuerde que la mayoría de las tecnologías basadas en el balanceo de carga utilizan un término para referirse al host, o servidor físico, y otro para referirse a los servicios disponibles en él; en este caso, simplemente host y servicios.
Pool, clúster y granja
El balanceo de carga permite a las organizaciones distribuir el tráfico entrante de las aplicaciones entre varios destinos de backend, incluidos los despliegues en nubes públicas o privadas. Por tanto, es necesario disponer del concepto de colección de destinos de backend. Los clústeres, como los denominaremos (también conocidos como pools o granjas), son colecciones de servicios similares disponibles en cualquier número de hosts. Por ejemplo, todos los servicios que ofrecen la página web de la empresa se agruparían en un clúster denominado «página web de la empresa», y todos los servicios que ofrecen funciones de comercio electrónico se agruparían en un clúster denominado «comercio electrónico».
Servidor virtual
Un servidor virtual es un proxy del servidor real (físico, virtual o contenedor). Junto con una dirección IP virtual, constituye el punto de acceso de la aplicación que se presenta al mundo exterior.
Integración de todos los elementos
Una vez comprendidos estos términos, ya conocemos los fundamentos del balanceo de carga. El ADC de balanceo de carga presenta servidores virtuales al mundo exterior. Cada servidor virtual apunta a un clúster de servicios alojados en uno o varios hosts físicos.
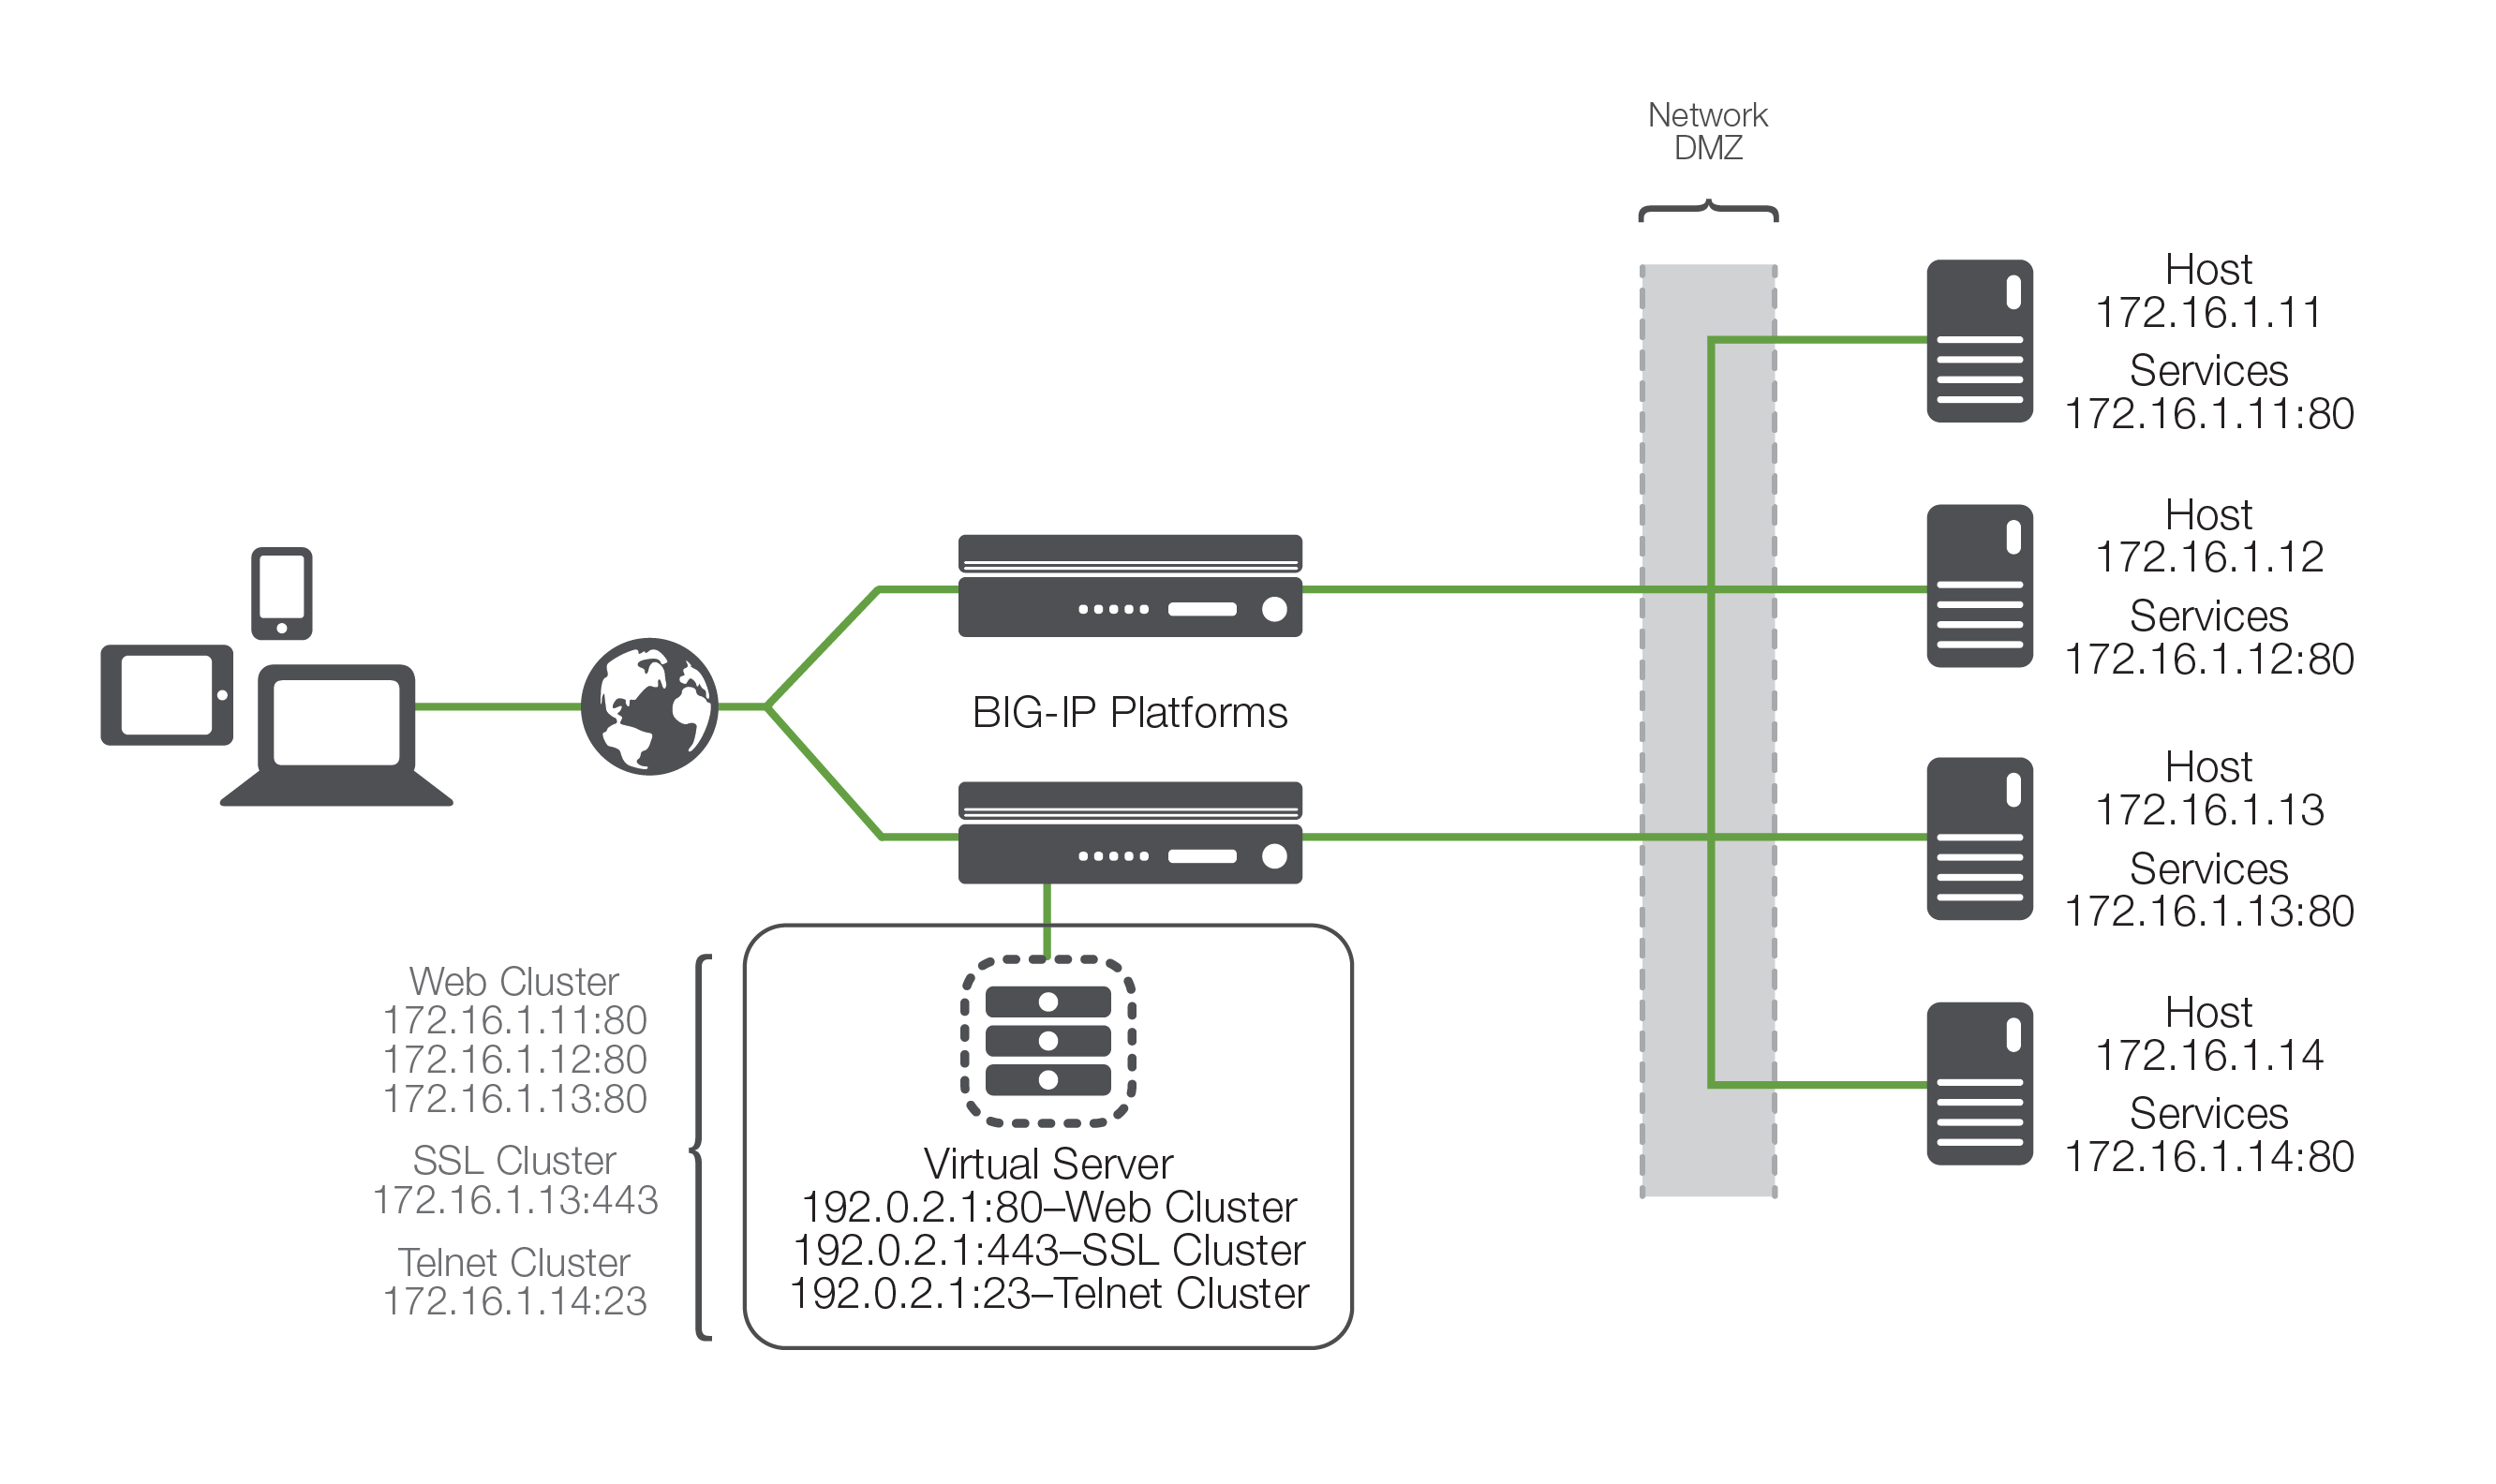
Aunque la Figura 2 puede no ser representativa de ninguna implementación real, sí proporciona la estructura básica para continuar analizando el proceso de equilibrio de carga y entrega de aplicaciones.
Cómo funciona el balanceo de carga
Una vez establecido este vocabulario común, examinemos el sencillo proceso mediante el cual se entrega la aplicación al cliente. Como se muestra, el ADC de equilibrio de carga suele situarse en línea entre el cliente y los hosts que proporcionan los servicios que este desea utilizar. Como ocurre con la mayoría de los aspectos de la entrega de aplicaciones, esta disposición no es una regla, sino más bien una práctica recomendada para cualquier tipo de implementación. Supongamos también que el ADC ya está configurado con un servidor virtual que apunta a un clúster formado por dos puntos de servicio. En este escenario de implementación, es habitual que los hosts dispongan de una ruta de retorno que apunte al equilibrador de carga, de modo que este procese el tráfico de retorno antes de enviarlo de vuelta al cliente.
La transacción básica de entrega de aplicaciones es la siguiente:
- El cliente intenta conectarse al servicio.
- El ADC acepta la conexión y, tras decidir qué host debe recibirla, cambia la IP de destino (y posiblemente el puerto) para que coincida con el servicio del host seleccionado (tenga en cuenta que la IP de origen del cliente no se modifica).
- El host acepta la conexión y responde al origen original, el cliente, a través de su ruta predeterminada, el ADC.
- El ADC intercepta el paquete de respuesta del host, cambia la IP de origen (y, posiblemente, el puerto) para que coincidan con la IP y el puerto del servidor virtual, y reenvía el paquete al cliente.
- El cliente recibe el paquete de respuesta, creyendo que procede del servidor virtual, y continúa el proceso.
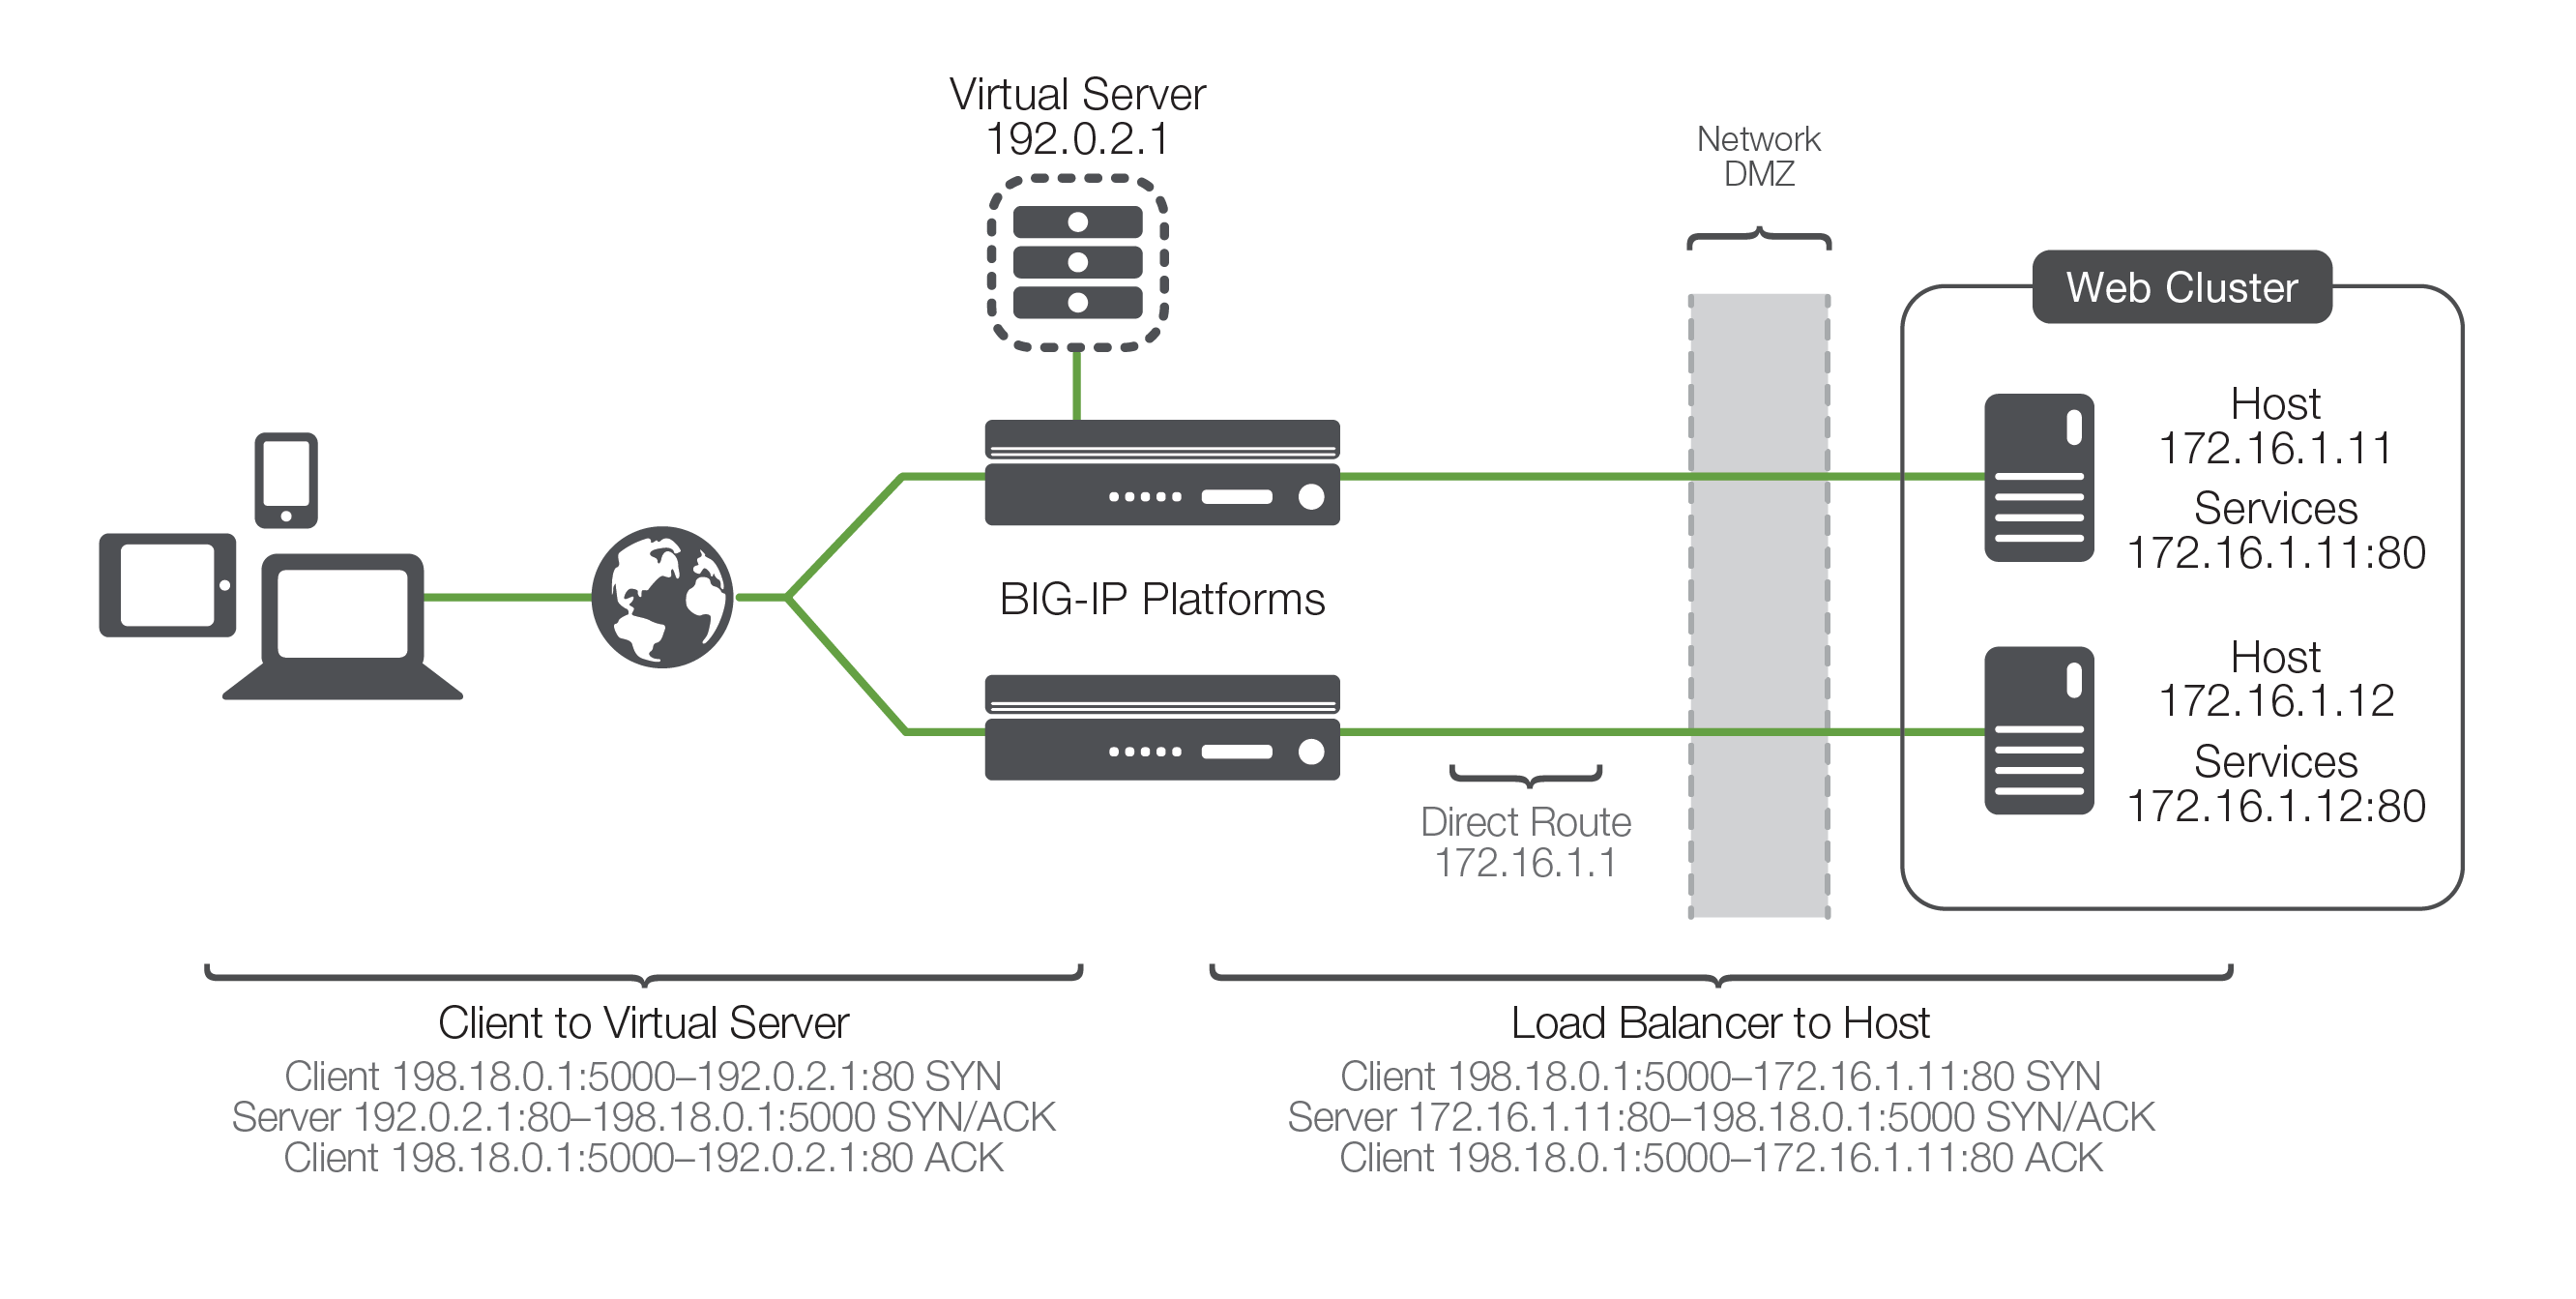
Este ejemplo tan sencillo es relativamente fácil de entender, pero hay un par de elementos clave que conviene señalar. En primer lugar, por lo que sabe el cliente, este envía paquetes al servidor virtual y el servidor virtual responde; así de simple. En segundo lugar, se realiza la NAT. En este punto, el ADC sustituye la IP de destino enviada por el cliente (la del servidor virtual) por la IP de destino del host al que ha decidido dirigir la solicitud para equilibrar la carga. En tercer lugar, está la parte del proceso que hace que la NAT sea «bidireccional». La IP de origen del paquete de respuesta del host será la IP del propio host; si no se cambiara esta dirección y el paquete simplemente se reenviara al cliente, este recibiría un paquete de alguien a quien no se lo había solicitado y lo descartaría sin más. En su lugar, el equilibrador de carga, que recuerda la conexión, reescribe el paquete para que la IP de origen sea la del servidor virtual, resolviendo así el problema.
La decisión de entrega de aplicaciones
Normalmente, llegados a este punto, surgen dos preguntas: ¿Cómo decide el ADC de equilibrio de carga a qué host enviar la conexión? ¿Y qué ocurre si el host seleccionado no funciona?
Analicemos primero la segunda pregunta. ¿Qué ocurre si el host seleccionado no funciona? La respuesta sencilla es que no responde a la solicitud del cliente y el intento de conexión acaba superando el tiempo de espera y falla. Evidentemente, esta situación no es deseable, ya que no garantiza una alta disponibilidad. Por eso, la mayoría de las tecnologías de balanceo de carga incluyen algún tipo de supervisión del estado para determinar si un host está realmente disponible antes de intentar enviarle conexiones.
Existen varios niveles de supervisión del estado, cada uno con un grado de detalle y un enfoque mayores. Un monitor básico se limitaría a enviar un ping al propio host. Si el host no responde al ping, cabe suponer que los servicios definidos en él probablemente no estén operativos y deban eliminarse del clúster de servicios disponibles. Por desgracia, aunque el host responda al ping, eso no significa necesariamente que el servicio en sí esté funcionando. Por tanto, la mayoría de los dispositivos pueden realizar algún tipo de «ping de servicio», desde simples conexiones TCP hasta la interacción con la aplicación mediante un script o una interacción inteligente. Estos monitores de estado de nivel superior no solo ofrecen una mayor garantía de que los servicios reales estén disponibles (a diferencia del host), sino que también permiten al balanceador de carga distinguir entre varios servicios de un mismo host. El balanceador de carga entiende que, aunque un servicio pueda no estar disponible, otros servicios del mismo host podrían funcionar perfectamente y deberían seguir considerándose destinos válidos para el tráfico de los usuarios.
Esto nos lleva de nuevo a la primera pregunta: ¿cómo decide el ADC a qué host enviar una solicitud de conexión? Cada servidor virtual tiene un clúster específico de servicios dedicado (que enumera los hosts que ofrecen ese servicio), el cual conforma la lista de posibilidades. Además, la supervisión del estado modifica esa lista para generar otra de hosts «disponibles actualmente» que prestan el servicio indicado. El ADC elige de esta lista modificada el host que recibirá una nueva conexión. La elección del host concreto depende del algoritmo de equilibrio de carga asociado a ese clúster en particular. Algunos de estos algoritmos son el de menor número de conexiones, el de proporción dinámica y el sencillo método round-robin, en el que el equilibrador de carga recorre la lista desde el principio y asigna cada nueva conexión al siguiente host; cuando llega al final, vuelve a empezar desde el principio. Aunque este método es sencillo y muy predecible, presupone que todas las conexiones tendrán una carga y una duración similares en el host de back-end, lo cual no siempre es cierto. Los algoritmos más avanzados utilizan factores como el número de conexiones actuales, el uso del host e incluso los tiempos de respuesta reales del tráfico existente dirigido al host para seleccionar el host más adecuado entre los servicios disponibles del clúster.
Los sistemas de entrega de aplicaciones suficientemente avanzados también podrán combinar la información de supervisión del estado con los algoritmos de equilibrio de carga para tener en cuenta las dependencias entre servicios. Esto resulta especialmente útil cuando un mismo host ofrece varios servicios y todos ellos son necesarios para atender la solicitud del usuario. En tal caso, no conviene dirigir al usuario a un host en el que un servicio esté operativo pero otro no. En otras palabras, si falla uno de los servicios del host, el otro también debe eliminarse de la lista de servicios disponibles del clúster. Esta funcionalidad cobra cada vez más importancia a medida que los servicios se diferencian más mediante HTML y scripts.
¿Balancear la carga o no balancearla?
La parte del balanceo de carga que consiste en seleccionar un servicio disponible cuando un cliente inicia una solicitud de transacción es solo la mitad de la solución. Una vez establecida la conexión, el ADC debe determinar si el tráfico posterior de ese usuario debe someterse a balanceo de carga. Por lo general, existen dos cuestiones específicas relacionadas con la gestión del tráfico posterior una vez balanceado: el mantenimiento de la conexión y la persistencia.
Mantenimiento de la conexión
Si el usuario intenta utilizar una conexión TCP de larga duración (puerto 21: FTP, puerto 23: Telnet u otro) que no se cierra inmediatamente, el equilibrador de carga debe garantizar que los distintos paquetes de datos transmitidos a través de esa conexión no se distribuyan entre otros hosts de servicio disponibles. Esto se denomina mantenimiento de la conexión y requiere dos capacidades fundamentales. La primera es la capacidad de realizar un seguimiento de las conexiones abiertas y del servicio de host al que pertenecen. La segunda es que el equilibrador de carga pueda seguir supervisando la conexión para actualizar la tabla de conexiones cuando esta se cierre. Se trata de una función bastante habitual en la mayoría de los ADC.
Persistencia
Sin embargo, cada vez es más habitual que el cliente utilice varias conexiones TCP de corta duración (por ejemplo, el puerto 80: HTTP) para realizar una única tarea. En algunos casos, como la navegación web convencional, esto no supone ningún problema y cada nueva solicitud puede dirigirse a cualquiera de los hosts de servicio de back-end. No obstante, hay muchas situaciones (XML, comercio electrónico, etc.) en las que es sumamente importante que las distintas conexiones de un mismo usuario se dirijan al mismo host de servicio de back-end y no se distribuyan mediante balanceo de carga. Este concepto se denomina persistencia o afinidad de servidor.
Hay varias formas de abordar esta cuestión, en función del protocolo y de los resultados deseados. Por ejemplo, en las transacciones HTTP modernas, el servidor puede especificar una conexión "keep-alive", que convierte esas múltiples conexiones de corta duración en una única conexión de larga duración, que puede gestionarse como las demás conexiones de larga duración. Sin embargo, esto solo ofrece un pequeño alivio, principalmente porque, a medida que aumenta el uso de los servicios web y móviles, mantener todas las conexiones abiertas más tiempo del necesario sobrecarga los recursos de todo el sistema. Por eso, hoy en día, en aras de la escalabilidad y la portabilidad, muchas organizaciones están optando por crear aplicaciones sin estado que se basan en API. Básicamente, esto significa que el servidor olvidará toda la información de la sesión para reducir la carga sobre los recursos y, en estos casos, el estado se mantiene mediante el envío de identificadores de sesión, así como mediante el concepto de persistencia.
Una de las formas más básicas de persistencia es la afinidad por dirección de origen, que consiste simplemente en registrar la dirección IP de origen de las solicitudes entrantes y el host de servicio al que se dirigieron mediante el balanceo de carga, y en enviar todas las transacciones futuras al mismo host. Dos formas de conseguirlo son mediante el uso de identificadores de sesión SSL y cookies. La persistencia SSL realiza un seguimiento de las sesiones SSL mediante identificadores de sesión SSL, lo que significa que, aunque cambie la dirección IP del cliente, el balanceador de carga reconocerá la persistencia de la sesión basándose en su identificador. La persistencia basada en cookies permite insertar una cookie en el equipo del cliente para identificar una sesión de forma unívoca y, posteriormente, hacer referencia a dicha cookie en las solicitudes, de modo que la conexión se dirija al servidor correcto.
Hoy en día, la inteligencia de los ADC permite a las organizaciones abrir los paquetes de datos y crear tablas de persistencia para prácticamente cualquier elemento que contengan. Esto les permite utilizar información única, como el nombre de usuario, para mantener la persistencia. Sin embargo, las organizaciones deben asegurarse de que esta información identificativa del cliente esté presente en todas las solicitudes, ya que los paquetes que no la incluyan no conservarán la persistencia y volverán a someterse al balanceo de carga, lo que probablemente provocará un fallo en la aplicación.
Conclusión
En sus inicios, el balanceo de carga se centraba en distribuir las cargas de trabajo por toda la red y garantizar la disponibilidad de las aplicaciones y los servicios. Sin embargo, a medida que la tecnología evolucionó, los balanceadores de carga se convirtieron en plataformas de entrega de aplicaciones, garantizando una alta disponibilidad y seguridad para las aplicaciones críticas de las organizaciones. Aunque el balanceo de carga básico sigue siendo la base de la entrega de aplicaciones, los ADC modernos ofrecen funcionalidades mucho más avanzadas.
Las empresas son conscientes de que el mero hecho de poder acceder a una aplicación no significa que esta sea utilizable, y las aplicaciones que no lo son suponen una pérdida de tiempo y dinero para la organización que las implementa. Aquí es donde entra en juego el ADC moderno, que permite a las organizaciones consolidar servicios de red como la descarga de SSL/TLS, el almacenamiento en caché, la compresión, la regulación de velocidad, la detección de intrusiones, los cortafuegos de aplicaciones e incluso el acceso remoto en un único punto estratégico que puede compartirse y reutilizarse en todos los servicios de aplicaciones y todos los hosts para crear una red virtualizada de entrega de aplicaciones. Esto permite a los equipos de redes, aplicaciones y operaciones responder mejor a las exigencias empresariales de plazos de entrega más cortos y una mayor escalabilidad, sin renunciar en ningún momento a la seguridad.
Si desea obtener más información sobre cómo funciona la entrega avanzada de aplicaciones y sobre el futuro de los ADC, lea La evolución de los controladores de entrega de aplicaciones y Más allá del simple equilibrio de carga.
1 http://www.strategyr.com/MarketResearch/Application_Delivery_Controllers_ADC_Market_Trends.asp
PUBLICADO EL 10 DE MAYO DE 2017