La vitesse est essentielle dans le paysage numérique actuel, où les consommateurs peuvent facilement se tourner vers un concurrent si les performances de votre application sont trop lentes. La rapidité d’une application repose en définitive sur des API réactives, robustes et adaptables. Or, l’un des facteurs déterminants de la réactivité des API est la latence induite par votre passerelle d’API. Mais toutes les passerelles d’API n’offrent pas le même niveau de performances.
Nous en avons pris toute la mesure l’automne dernier, lorsqu’un client de NGINX, acteur majeur du secteur du crédit à la consommation, nous a expliqué l’importance croissante des performances des API « en temps réel », alors que toujours plus d’applications et d’autres composants doivent communiquer pour offrir l’expérience numérique attendue par les utilisateurs. Nous avons été ravis d’apprendre que NGINX Plus était la seule passerelle d’API capable d’atteindre les temps de latence extrêmement faibles dont le client avait besoin, jusqu’à seulement 10 millisecondes (ms). De nombreux autres clients, tels que Capital One, nous ont également expliqué comment ils avaient réduit la latence et amélioré le débit en utilisant NGINX Open Source ou NGINX Plus comme passerelle d’API.
Nous avons décidé d’examiner plus en détail l’écosystème des API afin de déterminer ce qui rend une API « en temps réel ». En nous appuyant sur plusieurs facteurs, nous avons conclu qu’une API en temps réel doit traiter les appels d’API de bout en bout en moins de 30 ms à chaque centile jusqu’au 99e inclus (ce qui signifie qu’en moyenne, seul 1 appel sur 100 prend plus de 30 ms).
Comparaison des solutions de gestion d’API
Nos propres tests montrent systématiquement qu’il est facile d’obtenir des performances d’API en temps réel avec notre solution de gestion des API, qui associe NGINX Plus comme passerelle API pour traiter les appels d’API et le module de gestion des API de NGINX Controller pour gérer à la fois les instances NGINX Plus et vos API tout au long de leur cycle de vie, de leur définition à leur publication, leur gestion et leur supervision.
Mais nous comprenons que vous ne souhaitiez peut-être pas nous croire sur parole. Nous avons donc chargé GigaOm, un cabinet indépendant de recherche et d’analyse techniques, de réaliser une évaluation comparative objective et transparente de notre solution de gestion des API et d’autres solutions populaires du marché : deux solutions qui, comme NGINX, peuvent être déployées sur site ou dans le cloud, Apigee et Kong Enterprise, ainsi que deux offres cloud entièrement gérées, Amazon API Gateway et Kong Cloud.
Dans cet article de blog, nous résumons les résultats des tests réalisés par GigaOm (spoiler : NGINX Plus a fourni des API en temps réel dans toutes les conditions testées, contrairement aux autres solutions). Pour obtenir tous les détails sur les solutions, la méthodologie de test et les résultats, contactez un membre de notre équipe.
Remarque : Le contrat de licence utilisateur final (CLUF) d’Apigee interdit la publication des résultats de tests sans l’autorisation expresse de Google. Par conséquent, ni le rapport ni cet article de blog ne contiennent malheureusement d’informations sur Apigee.
Présentation du benchmark
GigaOm a utilisé l’outil de test de charge HTTP Vegeta pour générer des requêtes (appels d’API) et mesurer la latence — le temps nécessaire pour renvoyer la réponse à un appel d’API — ajoutée par la passerelle API à différents nombres de requêtes par seconde (RPS), que GigaOm appelle « taux d’attaque ». GigaOm a effectué des séries de tests avec des taux d’attaque commençant à 1 000 RPS, puis augmentant à 5 000, 10 000, 20 000, et ainsi de suite, jusqu’à ce que Vegeta signale des codes d’état d’erreur. Chaque série de tests a duré 60 secondes et a été répétée 3 fois. Comme le montrent les graphiques ci-dessous, GigaOm a relevé les latences aux 50e, 90e, 95e, 99e, 99,9e et 99,99e centiles, ainsi que la latence la plus longue observée pendant la série de tests (Max dans les graphiques).
Résultats : NGINX face à Kong Enterprise
GigaOm a réalisé deux tests comparatifs entre NGINX Plus (déployé à l’aide de NGINX Controller) et Kong Node (déployé à l’aide de Kong Enterprise). Lors du premier test, un seul nœud de traitement était utilisé (une instance de NGINX Plus ou de Kong Node). Lors du second, trois nœuds de traitement étaient équilibrés en charge par NGINX Open Source en mode Round‑Robin. (GigaOm souligne que l’utilisation de NGINX Open Source comme équilibreur de charge n’a pas avantagé NGINX Plus, et que Kong le recommande même comme équilibreur de charge pour les instances Kong Node en cluster.)
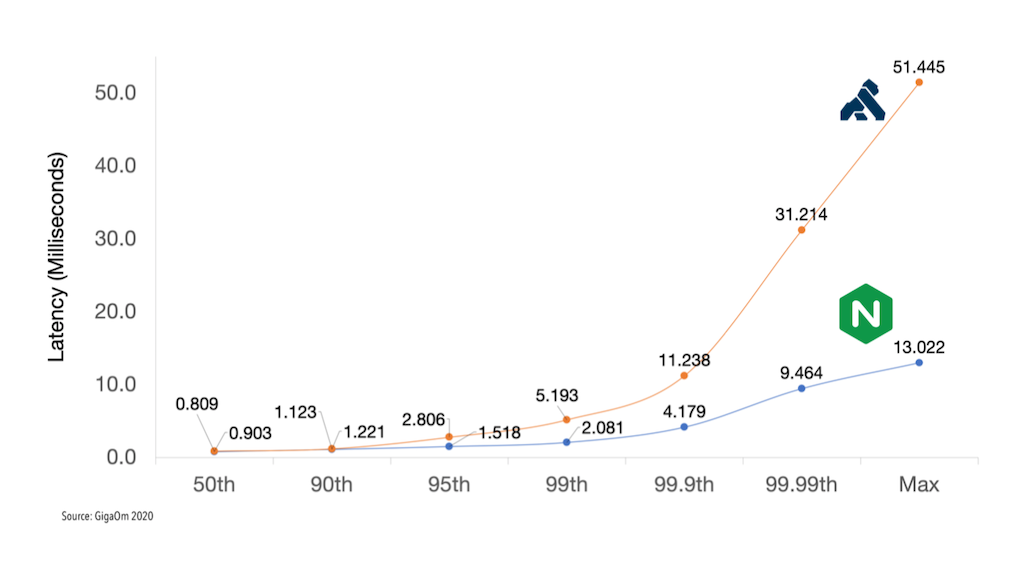
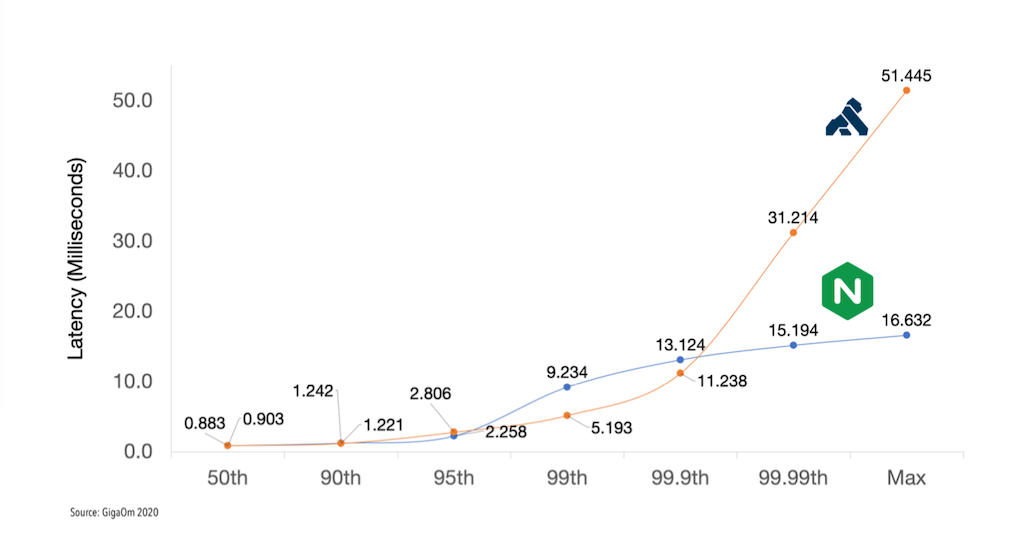
Comme le montrent les graphiques suivants, la différence de latence entre NGINX et Kong est négligeable jusqu’au 99e centile, seuil à partir duquel la latence de Kong commence à augmenter de manière exponentielle. Au 99,99e centile, la latence de Kong est respectivement trois fois et deux fois supérieure à celle de NGINX dans les deux tests comparatifs.
Le 99e percentile constitue une valeur minimale raisonnable pour qualifier une API de temps réel, mais GigaOm souligne que, dans les déploiements réels, il est « extrêmement important » de maintenir une faible latence à des percentiles plus élevés, tels que les 99,9e et 99,99e percentiles. Le rapport explique :
Les résultats de latence ont tendance à être multimodaux au fil du temps, les sommets des pics représentant des « ratés » dans les temps de réponse.
Ces ralentissements ont leur importance. Si le temps de réponse médian ou la latence médiane est inférieur à 30 ms, mais que des ralentissements d’une seconde ou plus se produisent, ils ont en réalité un effet cumulatif sur l’expérience des utilisateurs suivants. Par exemple, si vous vous rendez au drive d’un fast-food où le temps d’attente médian pour recevoir sa commande est d’une minute, vous estimerez probablement que l’expérience client est satisfaisante. Mais que se passe-t-il si le client devant vous rencontre un problème avec sa commande et qu’il faut 10 minutes pour le résoudre ? Votre temps d’attente sera alors de 11 minutes. Comme votre requête est arrivée dans la file après le ralentissement, le délai subi au 99,99e centile peut également devenir le vôtre.
L’effet négatif de latences anormalement élevées aux percentiles supérieurs devient encore plus important dans les applications distribuées, où une seule requête client peut en réalité déclencher plusieurs appels d’API en aval. Par exemple, supposons qu’une requête client génère 10 appels d’API vers un sous-système ayant 1 % de probabilité de répondre lentement. Il est possible de démontrer mathématiquement qu’il existe alors près de 10 % de probabilité que cette requête client soit affectée par une réponse lente. Pour plus de détails sur le calcul, consultez Qui a déplacé la latence de mon 99e percentile ?
La figure 1 présente les résultats obtenus pour un taux d’attaque de 30 000 requêtes par seconde avec un seul nœud de travail. Au 99,99e centile, la latence de Kong est plus de trois fois supérieure à celle de NGINX et dépasse le seuil de 30 ms fixé pour les API en temps réel. En revanche, NGINX Plus offre une latence compatible avec le temps réel à chaque centile : même sa latence la plus élevée enregistrée (Max), qui est de 13 ms, reste inférieure à la moitié du seuil fixé pour le temps réel.
La figure 2 présente des résultats très similaires pour le test de performance avec trois nœuds de travail, également soumis à un débit de 30 000 requêtes par seconde. Fait intéressant, Kong surpasse NGINX aux 99e et 99,9e percentiles, mais subit une nouvelle fois un énorme pic de latence au 99,99e percentile, atteignant cette fois une latence environ deux fois supérieure à celle de NGINX. Comme lors du premier test, NGINX reste sous le seuil de temps réel de 30 ms à tous les percentiles.
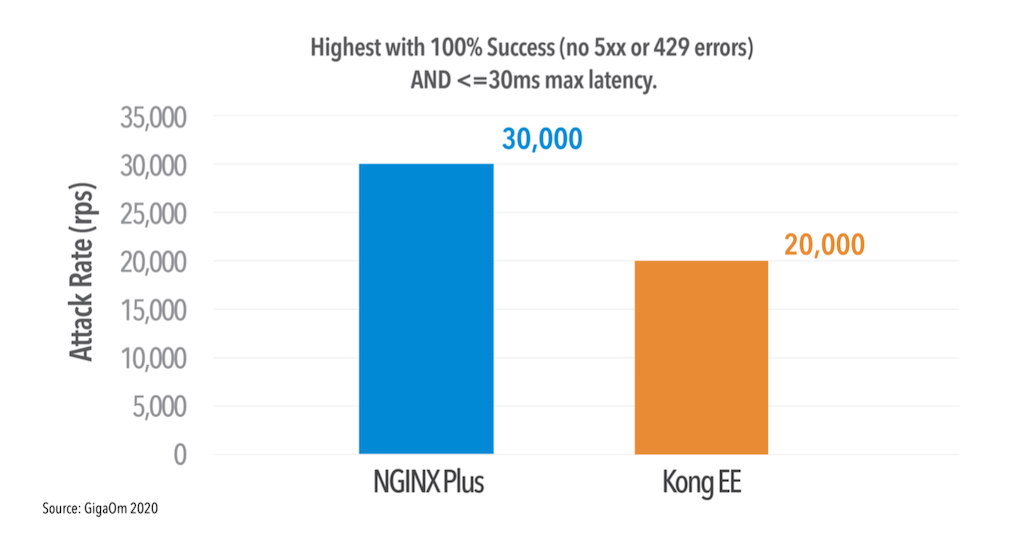
Une autre façon d’évaluer les performances d’une passerelle d’API consiste à déterminer le nombre maximal de RPS qu’elle peut traiter avec un taux de réussite de 100 % (sans erreurs 5xx ni 429 [Trop de requêtes]) et une latence inférieure à 30 ms pour tous les centiles, dans les configurations à un nœud comme à trois nœuds. La figure 3 montre que, selon ce critère, NGINX prend en charge un nombre de RPS supérieur de 50 % à celui de Kong : 30 000 contre 20 000.
Résultats : NGINX face à Kong Cloud et Amazon API Gateway
Dans la troisième série de tests comparatifs, GigaOm a comparé NGINX Plus à Kong Cloud et à Amazon API Gateway. GigaOm souligne qu’une comparaison directe est particulièrement délicate, car Kong Cloud et Amazon API Gateway sont des offres SaaS entièrement gérées, tandis que NGINX Controller est une offre PaaS qui n’est actuellement pas disponible en tant que SaaS. En particulier, aucune des deux offres SaaS ne précise le type d’instance, la puissance de calcul, la mémoire ou les capacités réseau qu’elle utilise. GigaOm a donc dû estimer au mieux les paramètres comparables à appliquer à NGINX Plus.
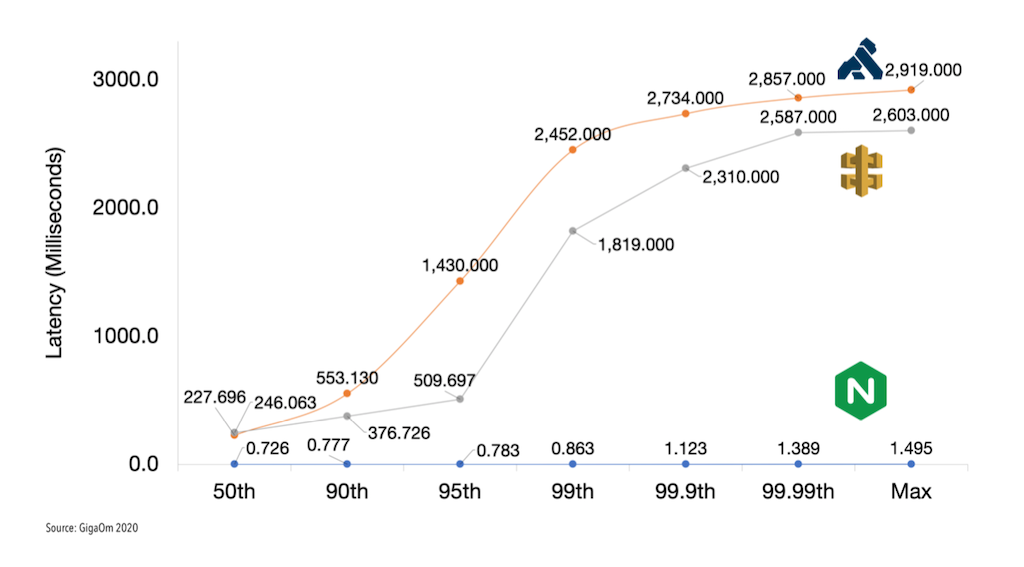
Même sans tenir compte de la comparaison avec NGINX Plus, il apparaît immédiatement que les offres SaaS ne peuvent pas fournir des API en temps réel, quel que soit le percentile testé, même au deuxième taux d’attaque le plus faible (5 000 RPS) présenté dans la Figure 4. Au 50e percentile, la latence des offres SaaS est déjà plus de 7 fois supérieure au seuil de 30 ms ; au 99,99e percentile, elle dépasse ce seuil de plus de 8 000 %. Il en découle clairement qu’il n’existe aucune condition dans laquelle Kong Cloud ou Amazon API Gateway atteint un taux de réussite de 100 % avec une latence inférieure à 30 ms.
Validation de NGINX comme seule solution d’API en temps réel
En résumé, NGINX est la seule solution testée par GigaOm qui répond aux critères de traitement des API en temps réel, avec une latence inférieure à 30 ms à chaque percentile. Kong Enterprise atteint des performances en temps réel au 99e percentile, mais sa latence augmente considérablement aux percentiles supérieurs, ce qui le rend peu adapté aux environnements de production nécessitant un volume même modéré de traitement des API en temps réel. Aucune des solutions SaaS testées ne peut être considérée comme fonctionnant en temps réel.
Le rapport de GigaOm confirme à la fois les résultats de nos précédents tests de performance et les retours de nos clients. NGINX Plus est la passerelle d’API la plus rapide du marché et la seule solution d’API capable de maintenir une latence inférieure à 30 ms à tous les centiles. En l’associant à NGINX Controller, vous bénéficiez d’une solution de gestion des API à l’architecture unique qui, grâce à un découplage soigneusement conçu, garantit que le plan de contrôle de la gestion des API (NGINX Controller) n’a absolument aucune incidence sur les performances du plan de données de la passerelle d’API (NGINX Plus).
Vous pouvez tester les performances de vos propres API grâce à notre outil de mesure de la latence rtapi. Découvrez-le et contactez-nous pour discuter de la manière dont nous pouvons vous aider à rendre vos API temps réel.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.