Les inscriptions à Microservices March 2023 sont désormais ouvertes. Consultez le programme et inscrivez-vous ici.
Éditeur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices (cet article)
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ».
Consultez également notre page de solutions Microservices.
Les microservices suscitent actuellement beaucoup d’intérêt dans les articles, les blogs, les discussions sur les réseaux sociaux et les présentations lors de conférences. Ils se rapprochent rapidement du pic des attentes démesurées du cycle de Gartner. Parallèlement, certains sceptiques de la communauté du logiciel considèrent que les microservices n’apportent rien de nouveau. Leurs détracteurs affirment qu’il s’agit simplement d’une nouvelle appellation de la SOA. Cependant, malgré cet engouement et ce scepticisme, le modèle d’architecture de microservices présente des avantages considérables, notamment parce qu’il permet le développement agile et la livraison d’applications d’entreprise complexes.
Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices. Vous découvrirez cette approche et la manière dont elle se compare au modèle plus traditionnel de l’architecture monolithique. Cette série décrira les différents éléments d’une architecture de microservices. Vous découvrirez les avantages et les inconvénients du modèle d’architecture de microservices, sa pertinence pour votre projet et la manière de le mettre en œuvre.
Commençons par voir pourquoi vous devriez envisager d’utiliser des microservices.
Développer des applications monolithiques
Imaginons que vous commenciez à développer une toute nouvelle application de réservation de taxis destinée à concurrencer Uber et Hailo. Après quelques réunions préliminaires et le recueil des exigences, vous créeriez un nouveau projet, soit manuellement, soit à l’aide d’un générateur fourni avec Rails, Spring Boot, Play ou Maven. Cette nouvelle application reposerait sur une architecture hexagonale modulaire, comme dans le schéma suivant :
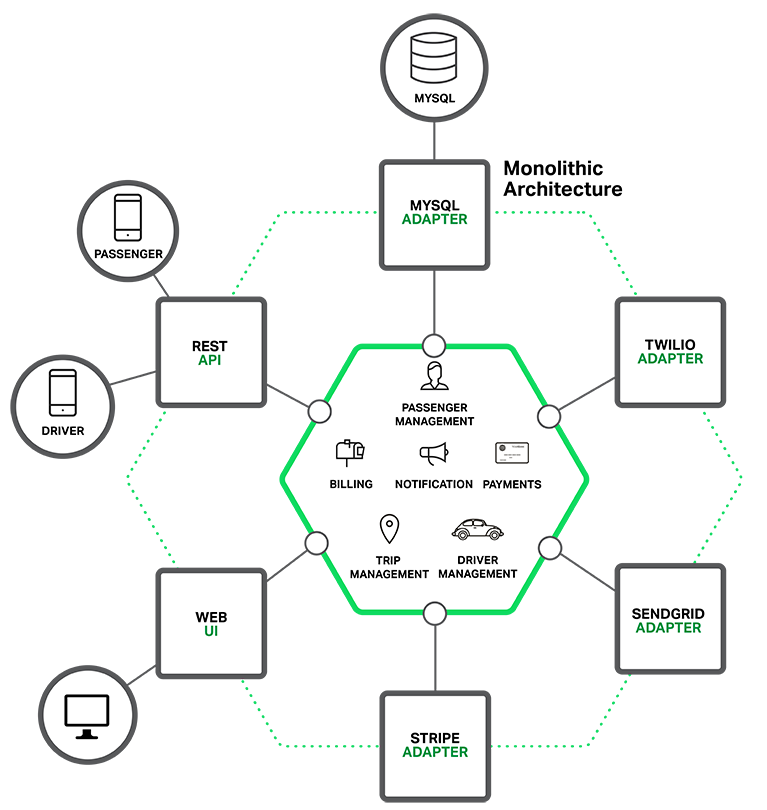
Au cœur de l’application se trouve la logique métier, mise en œuvre par des modules qui définissent des services, des objets de domaine et des événements. Autour de ce cœur se trouvent des adaptateurs qui assurent l’interface avec le monde extérieur. Parmi ces adaptateurs figurent notamment des composants d’accès aux bases de données, des composants de messagerie qui produisent et consomment des messages, ainsi que des composants web qui exposent des API ou mettent en œuvre une interface utilisateur.
Bien que son architecture soit logiquement modulaire, l’application est empaquetée et déployée sous forme de monolithe. Le format utilisé dépend du langage et du framework de l’application. Par exemple, de nombreuses applications Java sont empaquetées sous forme de fichiers WAR et déployées sur des serveurs d’applications tels que Tomcat ou Jetty. D’autres applications Java sont empaquetées sous forme de fichiers JAR exécutables autonomes. De même, les applications Rails et Node.js sont empaquetées sous forme d’une arborescence de répertoires.
Les applications conçues selon ce modèle sont extrêmement courantes. Elles sont simples à développer, car nos environnements de développement intégrés (IDE) et nos autres outils sont axés sur la création d’une application unique. Ces types d’applications sont également faciles à tester. Vous pouvez mettre en place des tests de bout en bout en lançant simplement l’application, puis en testant l’interface utilisateur avec Selenium. Les applications monolithiques sont également faciles à déployer. Il suffit de copier l’application empaquetée sur un serveur. Vous pouvez aussi faire évoluer l’application en exécutant plusieurs instances derrière un répartiteur de charge. Cette approche fonctionne bien durant les premières phases du projet.
En route vers l’enfer monolithique
Malheureusement, cette approche simple présente une limite majeure. Les applications qui rencontrent le succès ont tendance à se développer au fil du temps et finissent par devenir gigantesques. À chaque sprint, votre équipe de développement implémente quelques user stories supplémentaires, ce qui implique bien sûr l’ajout de nombreuses lignes de code. Au bout de quelques années, votre petite application toute simple sera devenue un monolithe monstrueux. Pour prendre un exemple extrême, j’ai récemment discuté avec un développeur qui créait un outil destiné à analyser les dépendances entre les milliers de fichiers JAR d’une application comptant plusieurs millions de lignes de code (LOC). Je suis certain qu’il a fallu les efforts conjugués d’un grand nombre de développeurs pendant de nombreuses années pour créer un tel monstre.
Une fois que votre application est devenue un monolithe vaste et complexe, votre organisation de développement se trouve probablement dans une situation extrêmement difficile. Toute tentative de développement et de livraison agiles est vouée à l’échec. L’un des principaux problèmes réside dans la complexité écrasante de l’application. Elle est tout simplement trop volumineuse pour qu’un seul développeur puisse la comprendre entièrement. Par conséquent, corriger les bogues et implémenter correctement de nouvelles fonctionnalités devient difficile et chronophage. Qui plus est, cette situation tend à créer une spirale descendante. Si la base de code est difficile à comprendre, les modifications ne seront pas effectuées correctement. Vous finirez par obtenir une monstrueuse et incompréhensible grande boule de boue.
La taille même de l’application ralentira également le développement. Plus l’application est volumineuse, plus son démarrage prend du temps. Par exemple, lors d’une enquête récente, certains développeurs ont indiqué des temps de démarrage pouvant atteindre 12 minutes. J’ai également entendu parler d’applications dont le démarrage pouvait prendre jusqu’à 40 minutes. Si les développeurs doivent régulièrement redémarrer le serveur d’applications, ils passeront une grande partie de leur journée à attendre, au détriment de leur productivité.
Un autre problème posé par une application monolithique volumineuse et complexe est qu’elle constitue un obstacle au déploiement continu. Aujourd’hui, l’état de l’art pour les applications SaaS consiste à mettre des modifications en production plusieurs fois par jour. C’est extrêmement difficile avec un monolithe complexe, car il faut redéployer l’intégralité de l’application pour en mettre à jour la moindre partie. Les longs temps de démarrage que j’ai mentionnés précédemment n’arrangent rien. De plus, comme l’impact d’une modification est généralement mal compris, il est probable que vous deviez effectuer de nombreux tests manuels. Par conséquent, le déploiement continu est pratiquement impossible à mettre en œuvre.
Les applications monolithiques peuvent également être difficiles à faire évoluer lorsque différents modules ont des besoins en ressources incompatibles. Par exemple, un module peut mettre en œuvre une logique de traitement d’images gourmande en ressources processeur et devrait idéalement être déployé sur des instances Amazon EC2 optimisées pour le calcul. Un autre module peut être une base de données en mémoire et être mieux adapté à des instances EC2 optimisées pour la mémoire. Toutefois, comme ces modules sont déployés ensemble, il faut faire des compromis dans le choix du matériel.
Un autre problème des applications monolithiques concerne leur fiabilité. Comme tous les modules s’exécutent au sein d’un même processus, un bug dans l’un d’eux, tel qu’une fuite de mémoire, peut potentiellement entraîner l’arrêt de l’ensemble du processus. De plus, toutes les instances de l’application étant identiques, ce bug affectera la disponibilité de l’ensemble de l’application.
Enfin, les applications monolithiques rendent extrêmement difficile l’adoption de nouveaux frameworks et langages. Imaginons, par exemple, que vous disposiez de 2 millions de lignes de code écrites à l’aide du framework XYZ. Réécrire l’intégralité de l’application pour utiliser le framework ABC, plus récent, serait extrêmement coûteux, tant en temps qu’en argent, même si ce dernier était nettement meilleur. L’adoption de nouvelles technologies se heurte donc à un obstacle majeur. Vous restez tributaire des choix technologiques effectués au début du projet.
En résumé, vous disposez d’une application critique pour l’entreprise qui rencontre un franc succès, mais qui s’est transformée en un monolithe tentaculaire que très peu de développeurs, voire aucun, comprennent. Elle repose sur une technologie obsolète et peu productive, ce qui complique le recrutement de développeurs talentueux. L’application est difficile à faire évoluer et manque de fiabilité. Par conséquent, il est impossible d’assurer un développement agile et une livraison rapide des applications.
Alors, que pouvez-vous faire pour y remédier ?
Microservices – Maîtriser la complexité
De nombreuses organisations, telles qu’Amazon, eBay et Netflix, ont résolu ce problème en adoptant ce que l’on appelle aujourd’hui le modèle d’architecture de microservices. Au lieu de créer une seule application monolithique démesurée, l’idée consiste à diviser votre application en un ensemble de services plus petits et interconnectés.
Un service met généralement en œuvre un ensemble de fonctionnalités distinctes, telles que la gestion des commandes, la gestion des clients, etc. Chaque microservice est une mini-application dotée de sa propre architecture hexagonale, composée d’une logique métier et de différents adaptateurs. Certains microservices exposent une API utilisée par d’autres microservices ou par les clients de l’application. D’autres peuvent proposer une interface utilisateur web. Lors de l’exécution, chaque instance prend souvent la forme d’une machine virtuelle dans le cloud ou d’un conteneur Docker.
Par exemple, le diagramme suivant illustre une décomposition possible du système décrit précédemment :
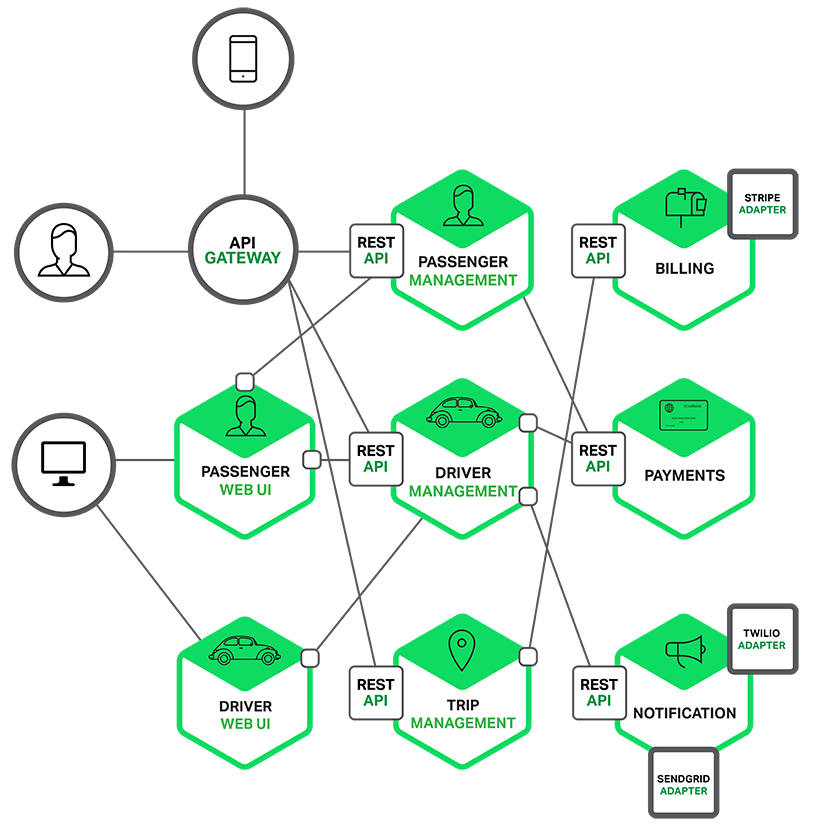
Chaque domaine fonctionnel de l’application est désormais pris en charge par son propre microservice. En outre, l’application web est divisée en plusieurs applications web plus simples (par exemple, une pour les passagers et une autre pour les chauffeurs dans notre exemple de service de réservation de taxis). Il est ainsi plus facile de proposer des expériences distinctes adaptées à des utilisateurs, des appareils ou des cas d’usage spécialisés.
Chaque service backend expose une API REST et la plupart des services utilisent les API fournies par d’autres services. Par exemple, le service de gestion des chauffeurs utilise le serveur de notifications pour informer un chauffeur disponible d’une course potentielle. Les services d’interface utilisateur font appel aux autres services afin de générer les pages web. Les services peuvent également utiliser une communication asynchrone basée sur des messages. La communication interservices sera abordée plus en détail dans la suite de cette série.
Certain API REST sont également mises à la disposition des applications mobiles utilisées par les chauffeurs et les passagers. Toutefois, ces applications n’accèdent pas directement aux services backend. La communication passe plutôt par un intermédiaire appelé « passerelle API ». La passerelle API assure notamment l’équilibrage de charge, la mise en cache, le contrôle d’accès, la mesure de l’utilisation des API et la surveillance, et peut être mise en œuvre efficacement avec NGINX ». D’autres articles de cette série aborderont la passerelle API.
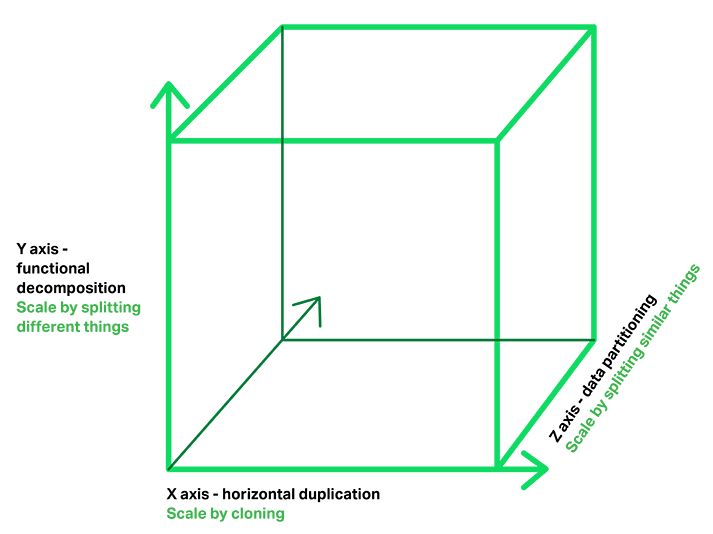
Le modèle d’architecture de microservices correspond à la mise à l’échelle selon l’axe Y du cube de mise à l’échelle, un modèle tridimensionnel de la scalabilité présenté dans l’excellent ouvrage L’Art de la scalabilité. Les deux autres axes sont la mise à l’échelle selon l’axe X, qui consiste à exécuter plusieurs copies identiques de l’application derrière un répartiteur de charge, et la mise à l’échelle selon l’axe Z (ou partitionnement des données), où un attribut de la requête (par exemple, la clé primaire d’une ligne ou l’identité d’un client) est utilisé pour acheminer la requête vers un serveur donné.
Les applications utilisent généralement les trois types de mise à l’échelle conjointement. La mise à l’échelle selon l’axe Y décompose l’application en microservices, comme illustré ci-dessus dans la première figure de cette section. Lors de l’exécution, la mise à l’échelle selon l’axe X exécute plusieurs instances de chaque service derrière un répartiteur de charge afin d’améliorer le débit et la disponibilité. Certaines applications peuvent également utiliser la mise à l’échelle selon l’axe Z pour partitionner les services. Le schéma suivant montre comment le service Trip Management peut être déployé avec Docker s’exécutant sur Amazon EC2.
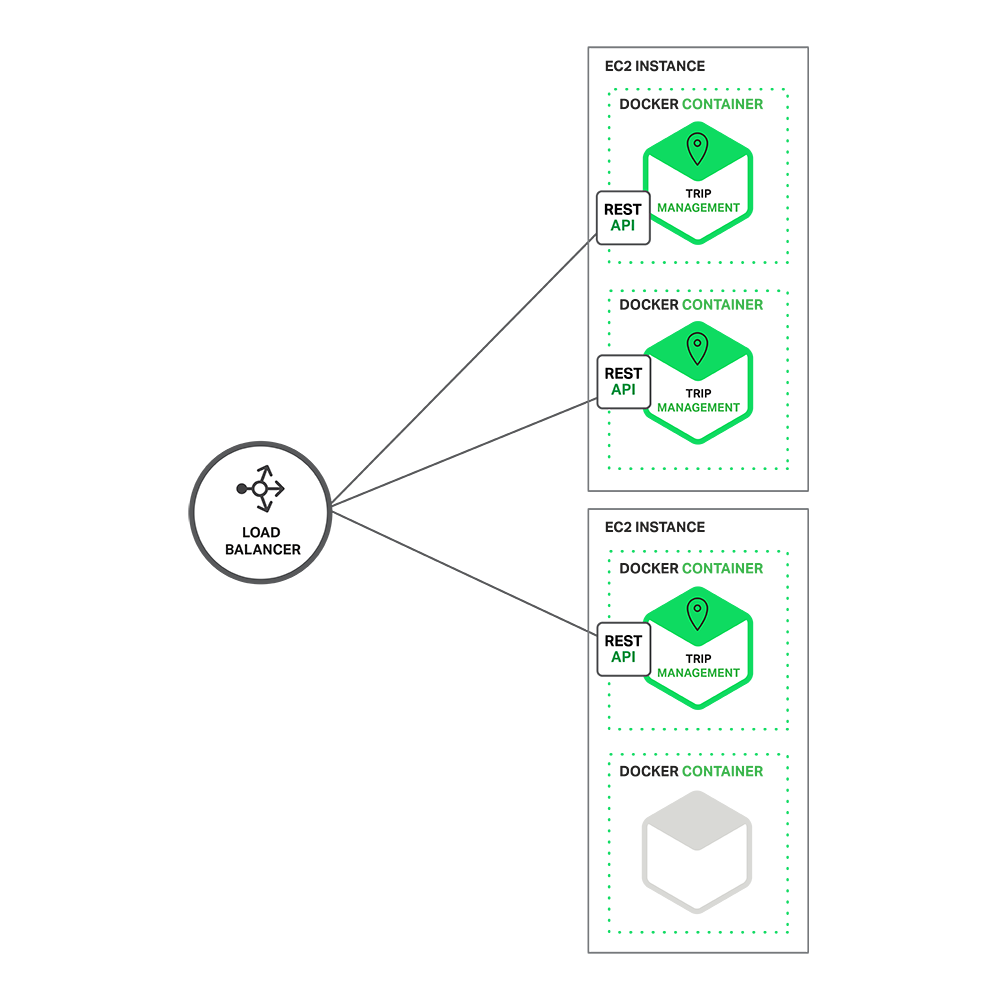
Lors de l’exécution, le service de gestion des trajets se compose de plusieurs instances de service. Chaque instance de service est un conteneur Docker. Afin d’assurer une haute disponibilité, les conteneurs s’exécutent sur plusieurs machines virtuelles dans le cloud. En amont des instances de service se trouve un équilibreur de charge tel que NGINX qui répartit les requêtes entre les instances. L’équilibreur de charge peut également prendre en charge d’autres fonctions telles que la mise en cache, le contrôle d’accès, la mesure de l’utilisation de l’API, ainsi que la surveillance.
Le modèle d’architecture de microservices a une incidence considérable sur la relation entre l’application et la base de données. Au lieu de partager un schéma de base de données unique avec d’autres services, chaque service possède son propre schéma. D’une part, cette approche va à l’encontre de l’idée d’un modèle de données à l’échelle de l’entreprise. Elle entraîne aussi souvent la duplication de certaines données. Toutefois, disposer d’un schéma de base de données par service est essentiel pour tirer parti des microservices, car cela garantit un couplage faible. Le schéma suivant illustre l’architecture de base de données de l’application donnée en exemple.
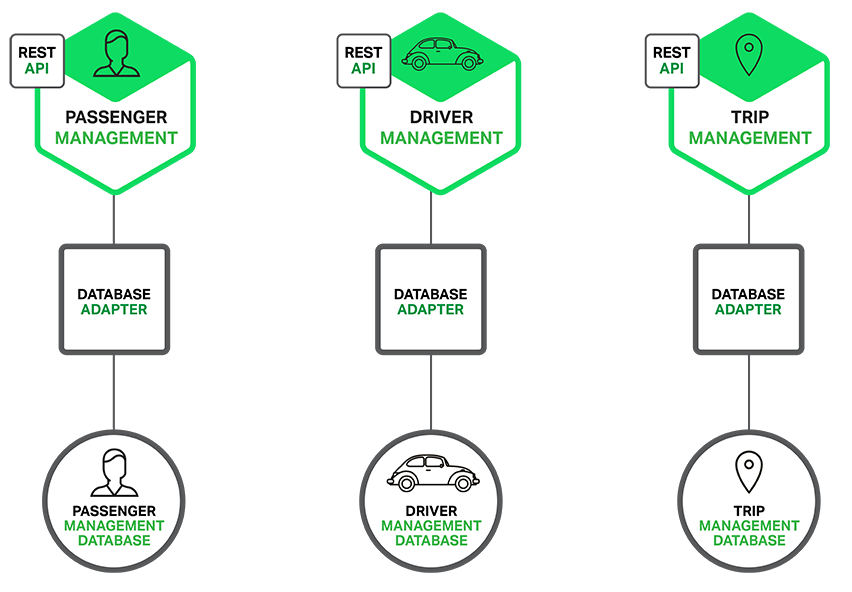
Chacun des services dispose de sa propre base de données. De plus, un service peut utiliser le type de base de données le mieux adapté à ses besoins, selon une architecture dite de persistance polyglotte. Par exemple, le service de gestion des chauffeurs, qui recherche les chauffeurs proches d’un passager potentiel, doit utiliser une base de données permettant d’effectuer efficacement des requêtes géospatiales.
À première vue, le modèle d’architecture de microservices est similaire à la SOA. Dans les deux approches, l’architecture se compose d’un ensemble de services. Toutefois, on peut considérer le modèle d’architecture de microservices comme une SOA dépourvue de la commercialisation et du poids généralement associés aux spécifications des services web (WS‑*) et à un bus de services d’entreprise (ESB). Les applications basées sur des microservices privilégient des protocoles plus simples et légers, tels que REST, plutôt que WS‑*. Elles évitent également autant que possible d’utiliser des ESB et implémentent à la place des fonctionnalités similaires à celles d’un ESB au sein même des microservices. Le modèle d’architecture de microservices rejette également d’autres aspects de la SOA, tels que le concept de schéma canonique.
Les avantages des microservices
Le modèle d’architecture de microservices présente plusieurs avantages importants. Tout d’abord, il permet de résoudre le problème de la complexité. Il décompose ce qui serait autrement une gigantesque application monolithique en un ensemble de services. Bien que l’ensemble des fonctionnalités reste inchangé, l’application est divisée en composants ou services faciles à gérer. Chaque service possède une frontière clairement définie sous la forme d’une API basée sur des appels RPC ou sur l’échange de messages. Le modèle d’architecture de microservices impose un niveau de modularité qui, en pratique, est extrêmement difficile à atteindre avec une base de code monolithique. Par conséquent, les différents services sont beaucoup plus rapides à développer, ainsi que bien plus faciles à comprendre et à maintenir.
Deuxièmement, cette architecture permet à chaque service d’être développé indépendamment par une équipe qui se consacre à ce service. Les développeurs sont libres de choisir les technologies qui leur semblent les plus adaptées, à condition que le service respecte le contrat d’API. Bien entendu, la plupart des organisations souhaitent éviter une anarchie totale et limiter les choix technologiques. Toutefois, cette liberté signifie que les développeurs ne sont plus contraints d’utiliser les technologies potentiellement obsolètes qui étaient en place au début d’un nouveau projet. Lorsqu’ils développent un nouveau service, ils peuvent opter pour des technologies actuelles. De plus, les services étant relativement petits, il devient envisageable de réécrire un ancien service à l’aide de technologies actuelles.
Troisièmement, le modèle d’architecture de microservices permet de déployer chaque microservice indépendamment. Les développeurs n’ont jamais besoin de coordonner le déploiement des modifications propres à leur service. Ces modifications peuvent être déployées dès qu’elles ont été testées. L’équipe chargée de l’interface utilisateur peut, par exemple, effectuer des tests A/B et apporter rapidement des améliorations successives à l’interface. Le modèle d’architecture de microservices rend possible le déploiement continu.
Enfin, le modèle d’architecture de microservices permet de faire évoluer chaque service indépendamment. Vous pouvez déployer uniquement le nombre d’instances de chaque service nécessaire pour répondre à ses contraintes de capacité et de disponibilité. De plus, vous pouvez utiliser le matériel le mieux adapté aux besoins en ressources d’un service. Par exemple, vous pouvez déployer un service de traitement d’images gourmand en ressources processeur sur des instances EC2 optimisées pour le calcul, et un service de base de données en mémoire sur des instances EC2 optimisées pour la mémoire.
Les inconvénients des microservices
Comme l’écrivait Fred Brooks il y a près de 30 ans, il n’existe pas de solution miracle. Comme toute autre technologie, l’architecture de microservices présente des inconvénients. L’un d’eux tient à son nom même. Le terme « microservice » met excessivement l’accent sur la taille des services. Certains développeurs préconisent d’ailleurs de créer des services extrêmement granulaires, comptant entre 10 et 100 lignes de code. Bien que les petits services soient préférables, il est important de garder à l’esprit qu’ils constituent un moyen d’atteindre un objectif, et non l’objectif principal. Le but des microservices est de décomposer suffisamment l’application afin de faciliter son développement et son déploiement agiles.
Un autre inconvénient majeur des microservices réside dans la complexité inhérente au fait qu’une application de microservices est un système distribué. Les développeurs doivent choisir et mettre en œuvre un mécanisme de communication interprocessus reposant soit sur une messagerie, soit sur des appels de procédure à distance (RPC). Ils doivent également écrire du code pour gérer les défaillances partielles, car le destinataire d’une requête peut être lent ou indisponible. Même si cela n’a rien de sorcier, c’est bien plus complexe que dans une application monolithique, où les modules s’appellent les uns les autres au moyen d’appels de méthodes ou de procédures propres au langage.
Un autre défi lié aux microservices réside dans l’architecture de base de données partitionnée. Les transactions métier qui mettent à jour plusieurs entités métier sont assez courantes. Ces types de transactions sont très simples à mettre en œuvre dans une application monolithique, car celle-ci ne comporte qu’une seule base de données. En revanche, dans une application basée sur des microservices, il faut mettre à jour plusieurs bases de données appartenant à différents services. Le recours aux transactions distribuées n’est généralement pas envisageable, et pas uniquement en raison du théorème CAP. En effet, de nombreuses bases de données NoSQL et plateformes de messagerie actuelles, pourtant hautement évolutives, ne les prennent tout simplement pas en charge. Il faut donc adopter une approche fondée sur la cohérence à terme, ce qui est plus complexe pour les développeurs.
Tester une application basée sur des microservices est également beaucoup plus complexe. Par exemple, avec un framework moderne tel que Spring Boot, il est très facile d’écrire une classe de test qui lance une application web monolithique et teste son API REST. En revanche, une classe de test similaire pour un service devrait lancer ce service ainsi que tous les services dont il dépend (ou, à tout le moins, configurer des bouchons pour ces services). Là encore, cela n’a rien de sorcier, mais il est important de ne pas sous-estimer la complexité de cette tâche.
Un autre défi majeur du modèle d’architecture de microservices consiste à mettre en œuvre des changements qui concernent plusieurs services. Imaginons, par exemple, que vous développiez une fonctionnalité nécessitant de modifier les services A, B et C, sachant que A dépend de B et que B dépend de C. Dans une application monolithique, il vous suffirait de modifier les modules correspondants, d’intégrer les changements et de déployer le tout en une seule fois. En revanche, avec un modèle d’architecture de microservices, vous devez planifier et coordonner soigneusement le déploiement des changements apportés à chacun des services. Par exemple, vous devriez d’abord mettre à jour le service C, puis le service B et enfin le service A. Heureusement, la plupart des changements ne concernent généralement qu’un seul service, et ceux qui touchent plusieurs services et nécessitent une coordination sont relativement rares.
Le déploiement d’une application basée sur des microservices est également beaucoup plus complexe. Une application monolithique est simplement déployée sur un ensemble de serveurs identiques derrière un répartiteur de charge traditionnel. Chaque instance de l’application est configurée avec les emplacements (hôtes et ports) des services d’infrastructure, tels que la base de données et un courtier de messages. À l’inverse, une application de microservices se compose généralement d’un grand nombre de services. Par exemple, Hailo compte 160 services différents et Netflix en compte plus de 600, selon Adrian Cockcroft [Note de l’éditeur – Hailo a été rachetée par MyTaxi.]. Chaque service possède plusieurs instances d’exécution. Cela représente beaucoup plus d’éléments mobiles à configurer, déployer, mettre à l’échelle et surveiller. En outre, vous devrez également mettre en œuvre un mécanisme de découverte de services (abordé dans un article ultérieur) permettant à un service de découvrir les emplacements (hôtes et ports) de tous les autres services avec lesquels il doit communiquer. Les approches opérationnelles traditionnelles, manuelles et fondées sur des tickets d’incident, ne peuvent pas s’adapter à un tel niveau de complexité. Par conséquent, pour réussir le déploiement d’une application de microservices, les développeurs doivent mieux maîtriser les méthodes de déploiement et disposer d’un niveau élevé d’automatisation.
Une approche de l’automatisation consiste à utiliser une PaaS prête à l’emploi telle que Cloud Foundry. Une PaaS permet aux développeurs de déployer et de gérer facilement leurs microservices. Elle leur évite d’avoir à se préoccuper de tâches telles que l’acquisition et la configuration des ressources informatiques. Parallèlement, les spécialistes des systèmes et des réseaux qui configurent la PaaS peuvent veiller au respect des bonnes pratiques et des politiques de l’entreprise. Une autre façon d’automatiser le déploiement des microservices consiste à développer ce qui revient essentiellement à créer sa propre PaaS. Un point de départ courant consiste à utiliser une solution d’orchestration de clusters, telle que Kubernetes, conjointement avec une technologie comme Docker. Plus loin dans cette série, nous verrons comment les approches de mise à disposition d’applications basée sur des logiciels telles que NGINX Plus, qui gère facilement la mise en cache, le contrôle des accès, la mesure de l’utilisation des API et la surveillance au niveau des microservices, peuvent contribuer à résoudre ce problème.
Résumé
La création d’applications complexes est difficile par nature. Une architecture monolithique n’est pertinente que pour des applications simples et légères. Son utilisation pour des applications complexes vous causera d’innombrables difficultés. Malgré ses inconvénients et les défis liés à sa mise en œuvre, le modèle d’architecture en microservices constitue un meilleur choix pour les applications complexes et évolutives.
Dans de prochains articles de blog, j’examinerai en détail différents aspects du modèle d’architecture en microservices et aborderai des sujets tels que la découverte de services, les options de déploiement des services et les stratégies permettant de remanier une application monolithique pour la décomposer en services.
Restez à l’écoute…
Rédaction – Cette série de sept articles est désormais terminée :
- Introduction aux microservices (cet article)
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ».
Le blogueur invité Chris Richardson est le fondateur du site original « CloudFoundry.com », l’une des premières plateformes Java en tant que service (PaaS) pour Amazon EC2. Il conseille désormais des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.