Vous est-il déjà arrivé de tester les performances d’un serveur en laboratoire, puis de le déployer pour gérer du trafic réel, pour finalement constater que ses performances étaient loin d’atteindre celles mesurées lors des tests ? L’utilisation du processeur est faible et de nombreuses ressources sont disponibles, mais les clients se plaignent de temps de réponse trop longs, et vous ne parvenez pas à mieux exploiter les capacités du serveur.
Ce que vous observez est l’un des effets de ce que l’on pourrait appeler la « lourde charge de traitement HTTP ». Dans cet article de blog, nous examinons le fonctionnement de HTTP et la manière dont les serveurs HTTP courants traitent les transactions HTTP. Nous nous penchons sur certains problèmes de performances susceptibles de survenir et voyons comment le modèle événementiel de NGINX en fait un proxy d’accélération très efficace pour ces serveurs HTTP. Avec NGINX, vous pouvez améliorer vos performances en conditions réelles afin de retrouver le niveau obtenu lors de vos tests de performance en local.
Pour obtenir des conseils sur le réglage de Linux et de NGINX afin d’améliorer la rapidité et l’évolutivité de vos applications, consultez l’article « Optimiser NGINX pour de meilleures performances » sur notre blog.
Introduction à HTTP et aux connexions persistantes
Les connexions persistantes HTTP sont une fonctionnalité essentielle pour améliorer les performances : elles réduisent la latence et accélèrent le chargement des pages web.
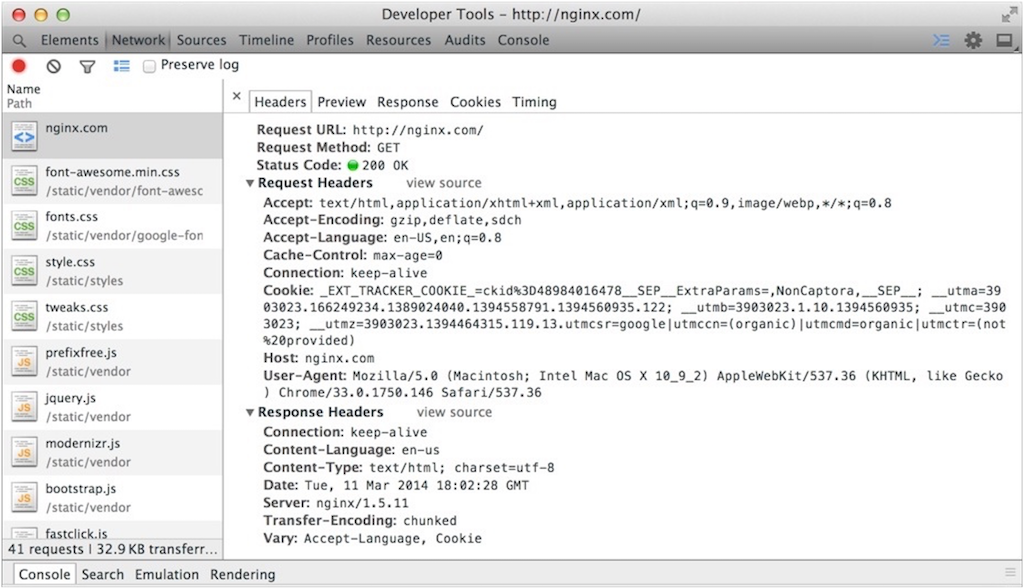
HTTP est un protocole simple, basé sur du texte. Si vous ne l’avez encore jamais fait, examinez les données produites par un outil de débogage HTTP, tel que celui intégré à votre navigateur web, et observez la structure standard des requêtes et des réponses :
Dans sa mise en œuvre la plus simple, un client HTTP établit une nouvelle connexion TCP avec le serveur de destination, envoie la requête et reçoit la réponse. Le serveur ferme ensuite la connexion TCP afin de libérer les ressources.
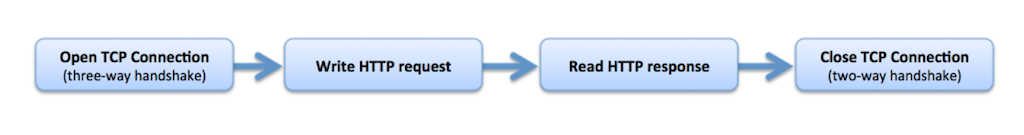
Ce mode de fonctionnement peut être très inefficace, en particulier pour les pages web complexes comportant un grand nombre d’éléments ou lorsque les liaisons réseau sont lentes. L’établissement d’une nouvelle connexion TCP nécessite une « poignée de main en trois temps », tandis que sa fermeture implique également une procédure en deux temps. Créer et fermer sans cesse des connexions TCP, une pour chaque message, revient à raccrocher puis à rappeler après chaque prise de parole au cours d’une conversation téléphonique.
HTTP utilise un mécanisme appelé « connexions persistantes » pour maintenir ouverte la connexion TCP entre le client et le serveur après la fin d’une transaction HTTP. Si le client doit effectuer une autre transaction HTTP, il peut utiliser la connexion persistante inactive au lieu de créer une nouvelle connexion TCP.
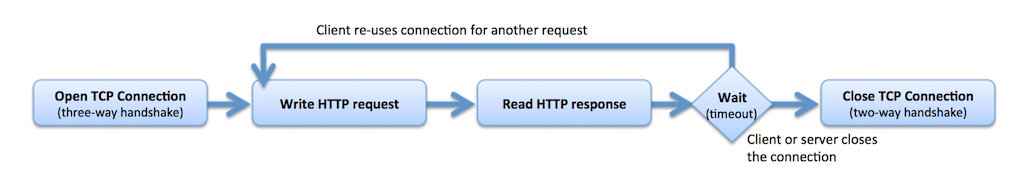
Les clients ouvrent généralement plusieurs connexions TCP simultanées à un serveur et effectuent des transactions persistantes sur chacune d’elles. Ces connexions restent ouvertes jusqu’à ce que le client ou le serveur décide qu’elles ne sont plus nécessaires, généralement à la suite de l’expiration d’un délai d’inactivité.
Les navigateurs web modernes ouvrent généralement 6 à 8 connexions persistantes et les maintiennent ouvertes pendant plusieurs minutes avant qu’elles n’expirent. Les serveurs web peuvent être configurés pour réduire leur délai d’expiration et les fermer plus tôt.
Quel est l’effet des connexions persistantes sur le serveur HTTP ?
Si de nombreux clients utilisent des connexions HTTP persistantes et que le serveur web présente une limite de connexions simultanées ou un problème de montée en charge, les performances chutent dès que cette limite est atteinte.
L’approche ci-dessus vise à offrir les meilleures performances possibles à chaque client. Malheureusement, dans un scénario comparable à la « tragédie des biens communs », si tous les clients procèdent ainsi, cela peut nuire aux performances de nombreux serveurs web et applications web courants.
Cela s’explique par le fait que de nombreux serveurs ont une limite fixe de connexions simultanées. Par exemple, dans les configurations courantes, le serveur HTTP Apache ne peut traiter qu’un nombre limité de connexions TCP simultanées : 150 avec le module multiprocessus (MPM) worker et 256 avec le MPM prefork. Chaque connexion HTTP persistante inactive occupe l’un de ces emplacements et, une fois qu’ils sont tous occupés, le serveur ne peut plus accepter de nouvelles connexions HTTP.
Il est généralement recommandé de désactiver les connexions persistantes sur le serveur web ou de limiter leur durée de vie à une période très courte. Elles constituent un vecteur très simple pour les attaques par déni de service SlowHTTPTest et Slowloris (pour une solution rapide, consultez Protection contre les attaques par déni de service Keep‑Dead sur serverfault.com).
En outre, ces serveurs web et applicatifs allouent généralement un thread ou un processus du système d’exploitation à chaque connexion. Une connexion TCP est un objet très léger pour le système d’exploitation, tandis qu’un thread ou un processus est très lourd. Les threads et les processus nécessitent de la mémoire, doivent être gérés activement par le système d’exploitation, et le « changement de contexte » entre les threads ou les processus consomme des ressources processeur. Attribuer à chaque connexion son propre thread ou processus est extrêmement inefficace.
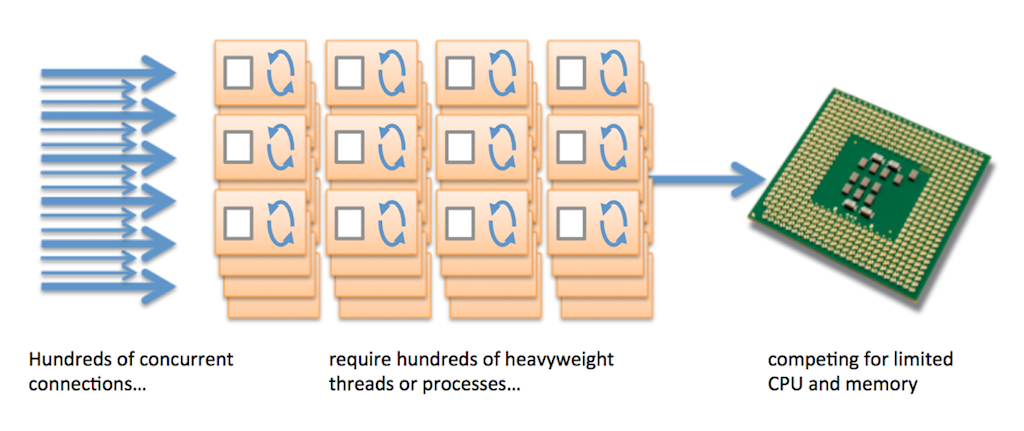
Le grand nombre de connexions clientes simultanées et l’affectation d’un thread ou d’un processus à chaque connexion engendrent le phénomène appelé « HTTP heavy lifting », qui nécessite des ressources disproportionnées pour traiter une transaction HTTP légère.
Qu’est-ce que cela signifie concrètement ?
Il suffit de peu de clients pour atteindre la limite de connexions simultanées de nombreux serveurs web et applicatifs modernes.
Si un client ouvre 8 connexions TCP et maintient chacune d’elles active pendant 15 secondes après sa dernière utilisation, il occupe 8 emplacements de connexions simultanées pendant 15 secondes. Si les clients arrivent sur votre site web au rythme d’un par seconde, 120 emplacements sont constamment occupés par des connexions persistantes inactives. Si ce rythme passe à 2 clients par seconde, 240 emplacements sont occupés. Une fois tous les emplacements occupés, les nouveaux clients ne peuvent plus se connecter tant que les connexions existantes n’ont pas expiré.
Cela peut entraîner des niveaux de service très inégaux. Les clients qui parviennent à établir une connexion persistante peuvent parcourir votre service à leur guise. Ceux qui tentent de se connecter lorsque tous les emplacements de connexions simultanées sont occupés ne peuvent pas accéder au service et doivent patienter dans une file d’attente.
Pourquoi ne constatez-vous pas ces effets lors des tests de performance ?
Ces problèmes ne se manifestent que sur des réseaux lents comptant de nombreux clients. Ils n’apparaissent pas lors de tests de performance effectués avec un seul client sur un réseau local rapide.
Il y a plusieurs raisons pour lesquelles ces effets peuvent ne pas apparaître dans un benchmark.
- Si vous n’activez pas les connexions persistantes pendant le test de performance, le client crée une nouvelle connexion TCP pour chaque transaction (et la connexion est fermée une fois la transaction terminée). Comme vous exécutez très probablement le test sur un réseau local rapide, celui-ci réussit et vous ne constatez pas les problèmes de performances liés à l’absence de connexions persistantes.
- Si vous activez les connexions persistantes, vous pouvez très probablement utiliser moins de connexions simultanées que la limite de votre serveur, et votre client de test sature chaque connexion (en la réutilisant de manière répétée), poussant ainsi votre serveur à sa capacité maximale. Toutefois, cela ne correspond pas au profil réel des connexions.
Notez que la plupart des outils d’analyse comparative ne rendent compte que des transactions réussies. Les connexions bloquées en raison de l’épuisement des ressources peuvent ne pas être signalées ou sembler ne représenter qu’une infime partie des connexions réussies. Cela masque la véritable nature du problème dans des conditions de trafic réelles.
Quelle est l’ampleur du problème ?
Tout serveur web ou serveur d’applications reposant sur des threads ou des processus est vulnérable aux limitations de concurrence.
Ce problème est inhérent à toute plateforme web ou applicative qui affecte un thread ou un processus à chaque connexion. Il n’est pas facile à détecter dans un environnement de test de performances optimisé, mais, dans des conditions réelles, il se traduit par de mauvaises performances et une utilisation excessive du processeur.
Vous pouvez prendre plusieurs mesures pour résoudre ce problème :
- Augmentez le nombre de threads ou de processus – Il s’agit d’une mesure à très court terme. Les threads et les processus sont des objets lourds du système d’exploitation, et leur multiplication entraîne une augmentation rapide de la charge de gestion.
- Désactiver ou limiter l’utilisation des connexions persistantes HTTP – Cela permet de repousser la limite de connexions simultanées, mais dégrade considérablement les performances pour chaque client.
- Utilisez un traitement spécialisé des connexions persistantes – Le serveur HTTP Apache (serveur web) dispose d’un MPM event relativement récent, qui transfère les connexions entre les threads de travail et un thread dédié aux événements lorsqu’elles passent de l’état « actif » à l’état « connexion persistante inactive », et inversement. Cette solution peut être envisagée si les autres modules que vous utilisez prennent en charge ce MPM ; notez toutefois que les connexions SSL/TLS sont toujours entièrement traitées dans des threads dédiés.
- Utilisez un modèle de traitement plus efficace – La mesure de loin la plus simple et la plus efficace consiste à placer un proxy HTTP performant devant vos serveurs web ou applicatifs. Un proxy piloté par les événements comme NGINX ne présente pas les limitations de concurrence décrites ci-dessus. Les connexions lentes et les connexions persistantes inactives ne lui posent aucun problème. En outre, il convertit efficacement les connexions lentes côté client, comportant plusieurs connexions persistantes inactives, en connexions rapides, locales et hautement efficaces, comparables à celles utilisées lors des tests de performance, afin de tirer le meilleur parti possible de vos serveurs web et applicatifs.
Utiliser NGINX comme proxy HTTP d’accélération
NGINX utilise une architecture différente qui ne souffre pas des problèmes de concurrence décrits ci-dessus. Il transforme les connexions lentes des clients en connexions optimisées, comparables à celles utilisées lors de tests de performance, afin de tirer le meilleur parti de vos serveurs.
NGINX utilise un modèle événementiel très efficace pour gérer les connexions.
Chaque processus NGINX peut gérer plusieurs connexions simultanément. Lorsqu’une nouvelle connexion est acceptée, la surcharge est très faible (elle se limite à un nouveau descripteur de fichier et à un nouvel événement à surveiller), contrairement au modèle à un processus ou à un thread par connexion décrit ci-dessus. NGINX dispose d’une boucle d’événements très efficace :
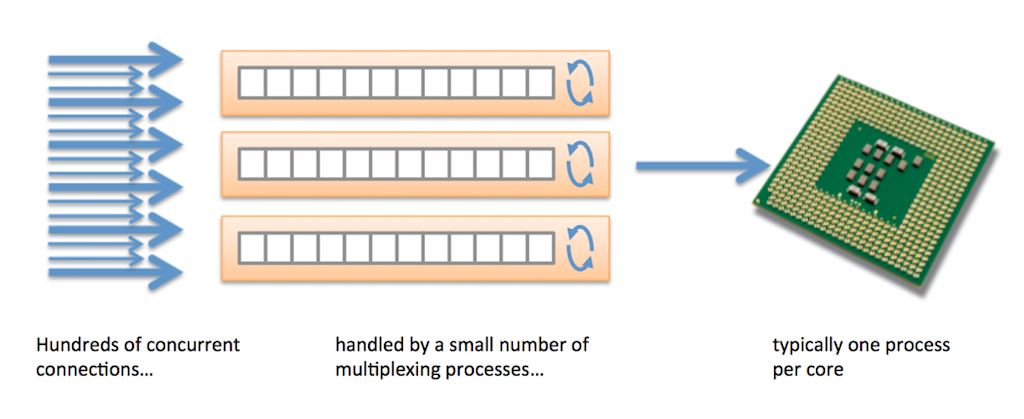
Cela permet à chaque processus NGINX de gérer facilement des dizaines, des milliers, voire des centaines de milliers de connexions simultanées.
NGINX transmet ensuite les requêtes au serveur en amont à l’aide d’un pool local de connexions persistantes. Vous évitez ainsi la surcharge liée à l’ouverture et à la fermeture des connexions TCP, tandis que les piles TCP s’adaptent rapidement à la taille de fenêtre et aux paramètres de nouvelle tentative optimaux. L’envoi des requêtes et la lecture des réponses sont bien plus rapides sur le réseau local optimisé :
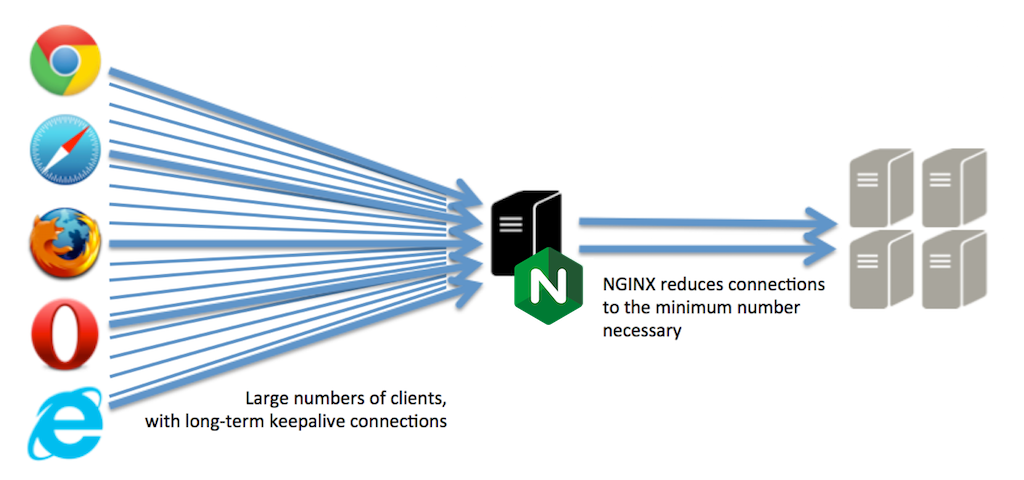
Au final, le serveur en amont communique avec un seul client local (NGINX) via un réseau rapide. Ce client exploite de manière optimale les connexions HTTP persistantes afin de réduire au minimum l’établissement de nouvelles connexions, sans pour autant les maintenir ouvertes inutilement. Le serveur retrouve ainsi un environnement optimal, comparable à celui d’un test de performances.
Lorsque NGINX fait office de proxy HTTP, vous constatez ce qui suit :
- Meilleure utilisation des ressources existantes. Vos serveurs web et applicatifs peuvent traiter davantage de transactions par seconde, car ils n’ont plus à prendre en charge les lourdes tâches liées au protocole HTTP.
- Réduction du taux d’erreur. Les expirations de délai HTTP sont beaucoup moins probables, car NGINX fait office d’ordonnanceur central pour tous les clients.
- De meilleures performances pour l’utilisateur final. Les serveurs fonctionnent plus efficacement et traitent les connexions plus rapidement.
Autres moyens par lesquels NGINX peut accélérer les services
Décharger votre infrastructure du traitement intensif des requêtes HTTP n’est que l’une des mesures grâce auxquelles NGINX peut transformer les performances de votre infrastructure applicative surchargée.
La fonctionnalité de mise en cache HTTP de NGINX peut mettre en cache les réponses des serveurs en amont, en suivant les règles standard de mise en cache afin de déterminer les éléments à mettre en cache et leur durée de conservation. Si plusieurs clients demandent la même ressource, NGINX peut répondre à partir de son cache et éviter de solliciter les serveurs en amont avec des requêtes en double.
NGINX peut également décharger le serveur en amont d’autres opérations. Vous pouvez lui confier les opérations de compression des données afin de réduire l’utilisation de la bande passante, centraliser le chiffrement et le déchiffrement SSL/TLS, effectuer l’authentification initiale des clients (par exemple, à l’aide de l’authentification HTTP de base, de sous-requêtes adressées à des serveurs d’authentification externes et de jetons Web JSON), et appliquer toutes sortes de règles pour limiter le débit du trafic lorsque cela est nécessaire.
Bien plus qu’un simple équilibreur de charge ou contrôleur de mise à disposition d’applications
Enfin, n’oubliez pas que, contrairement aux autres proxys d’accélération, équilibreurs de charge ou contrôleurs de mise à disposition d’applications (ADC), NGINX est également un serveur web complet. Vous pouvez utiliser NGINX pour servir du contenu statique, transférer le trafic vers des serveurs d’applications pour Java, PHP, Python, Ruby et d’autres langages, diffuser des contenus multimédias (audio et vidéo), l’intégrer à des systèmes d’authentification et de sécurité, et même répondre directement aux transactions à l’aide de règles intégrées à la configuration de NGINX.
Sans limitations de performances intégrées, NGINX et NGINX Plus exploitent pleinement les capacités du matériel sur lequel ils sont déployés, aujourd’hui comme à l’avenir.
Pour essayer NGINX Plus, commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.