Le marché de la gestion des API (APIM) est très concurrentiel. Le dernier Magic Quadrant de Gartner pour la gestion du cycle de vie complet des API classe 22 fournisseurs, dont 7 dans le quadrant des leaders. Pour être compétitif sur un marché existant, il est essentiel d’établir un positionnement fort afin de se différencier et de se démarquer de la concurrence. Alors, qu’est-ce qui distingue la solution de gestion des API de NGINX ?
Chez NGINX, notre objectif est de créer des logiciels légers et hautement performants. NGINX Open Source est devenu le serveur web de référence pour les sites les plus fréquentés au monde grâce à son architecture événementielle, qui offre une meilleure évolutivité que les serveurs web créant un processus ou un thread pour chaque connexion. NGINX Open Source est également la passerelle d’API la plus répandue du secteur, un composant d’infrastructure qui traite le trafic des API dans des solutions d’APIM telles que celles d’Apigee, Axway, IBM DataPower, Kong, Red Hat 3scale et Torry Harris.
Le module de gestion des API de NGINX Controller est une solution APIM hautes performances. Dans cet article, nous comparerons ses performances à celles de Kong, un concurrent réputé pour ses hautes performances. Kong repose sur NGINX et utilise Lua pour mettre en œuvre ses fonctionnalités d’API, tandis que le module de gestion des API s’appuie entièrement sur des fonctionnalités natives hautes performances, mises en œuvre sous forme de modules NGINX Plus. La solution de gestion des API de NGINX repose sur une architecture innovante qui dissocie le plan de données du plan de contrôle. Tous les appels d’API sont traités directement par NGINX Plus, qui fait office de passerelle API (plan de données), sans nécessiter aucune interaction avec le plan de contrôle. Il en résulte une médiation hautes performances du trafic API, aussi bien nord-sud qu’est-ouest.
Un aperçu des résultats : le module de gestion des API de NGINX Controller est deux fois plus performant que Kong.
Nous remercions tout particulièrement Intel d’avoir fourni le matériel et l’espace de laboratoire nécessaires à la réalisation de ces tests. Tous les détails concernant les tests et le matériel sont disponibles dans l’annexe.
Latence ajoutée à une requête unique
Dans ce test, nous avons comparé la latence supplémentaire introduite par le gestionnaire d’API pour une requête unique, avec des fichiers de 0 Ko et 1 Ko. Nous avons utilisé curl pour envoyer la requête HTTP unique (détails).
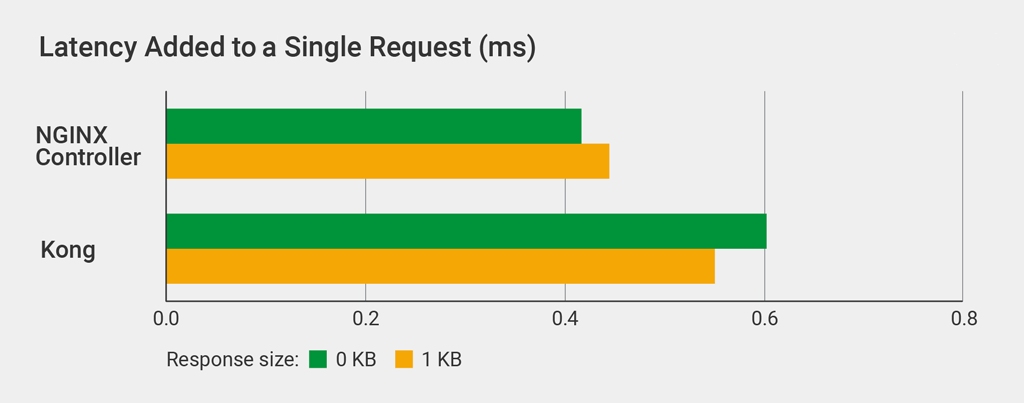
Kong augmente la latence par rapport au module de gestion des API : de 44 % pour un fichier de 0 Ko et de 24 % pour un fichier de 1 Ko.
Appels d’API par seconde
Une métrique standard de scalabilité HTTP est le nombre de requêtes par seconde (RPS). Dans le contexte d’APIM, la métrique équivalente est le nombre d’appels d’API par seconde. Nous avons utilisé wrk pour envoyer un flux continu de requêtes portant sur un fichier de 0 Ko ou de 1 Ko, avec 300 connexions pendant 3 minutes (détails).
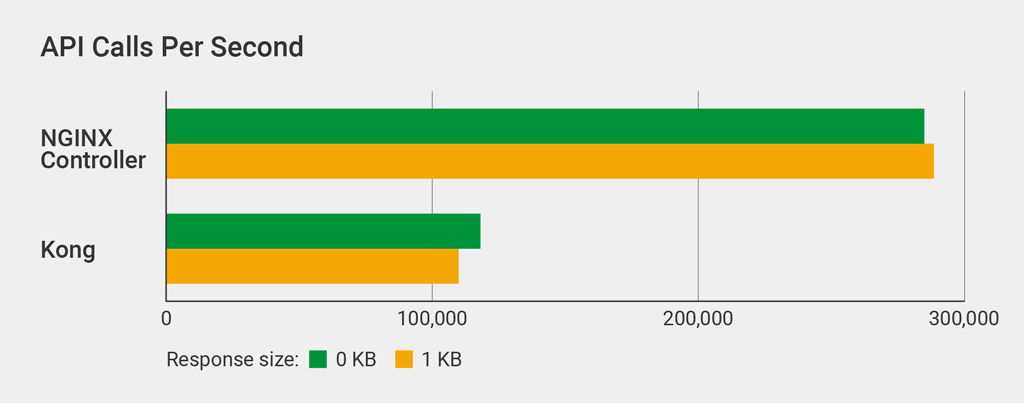
Le module de gestion des API a surpassé Kong, en traitant 2,6 fois plus d’appels d’API par seconde pour des réponses de 1 Ko.
Utilisation du processeur
Le module de gestion des API réduit la latence et traite davantage d’appels d’API par seconde que Kong, car il utilise le processeur plus efficacement. Nous avons mesuré l’utilisation du processeur en augmentant progressivement le nombre d’appels d’API par seconde. Nous avons utilisé un seul cœur, de sorte que le nombre absolu d’appels d’API par seconde est bien inférieur à celui du test précédent, pour lequel nous avions utilisé 22 cœurs (détails).
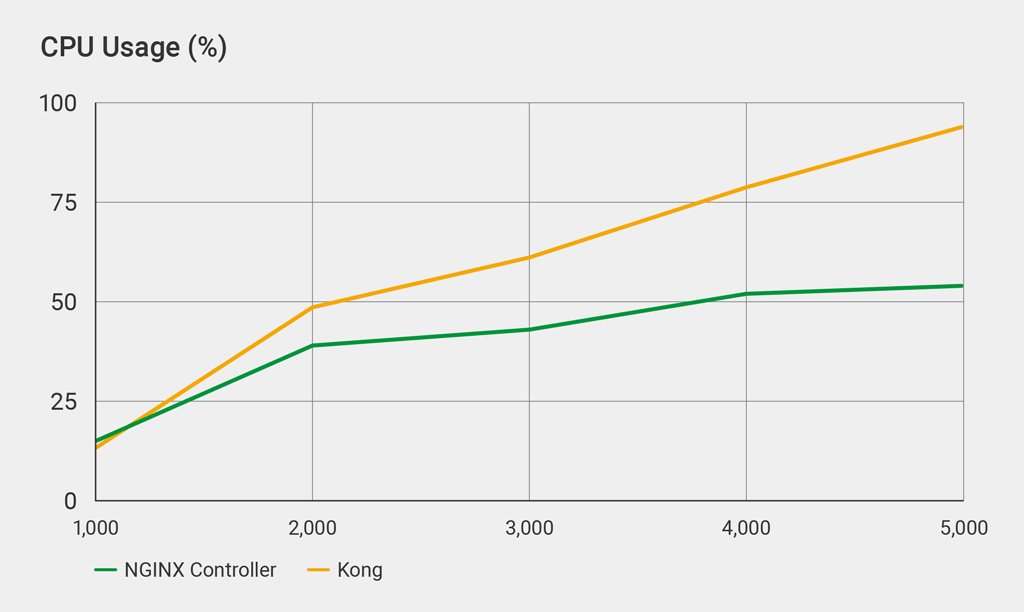
Kong atteint en pratique sa limite à 5 000 appels d’API par seconde : au-delà de ce volume, la latence augmente sensiblement, ce qui indique que le système est à pleine charge. À 5 000 appels par seconde, l’utilisation du processeur s’élève à 93 %, soit 73 % de plus que celle du module de gestion des API.
Appels d’API par seconde avec des JWT
Le dernier test mesure la capacité de chaque passerelle API à valider les jetons web JSON (JWT), la méthode privilégiée pour authentifier les requêtes API. Vos points de terminaison d’API les plus importants seront probablement authentifiés ; ce test se rapproche donc davantage d’une configuration réelle.
Nous avons utilisé le même JWT, signé avec HS256, pour les deux passerelles (détails).
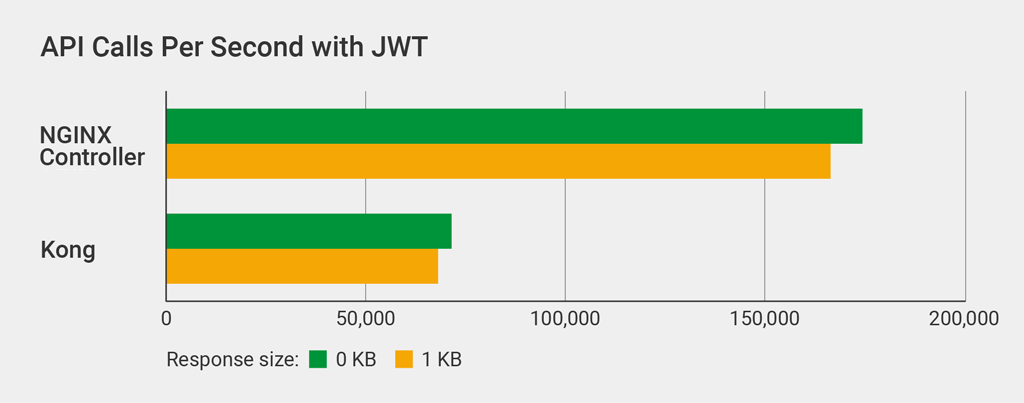
Le module de gestion des API traite plus de deux fois plus d’appels d’API authentifiés par JWT par seconde que Kong.
Fonctionnement de NGINX Controller
NGINX Controller est une solution de plan de contrôle qui gère le plan de données NGINX Plus. NGINX Controller vous permet de gérer l’intégralité du cycle de vie de NGINX Plus en tant qu’équilibreur de charge, passerelle d’API ou proxy dans un environnement de maillage de services. Grâce au module de gestion des API de NGINX Controller, vous pouvez définir, publier, sécuriser, surveiller et analyser des API.
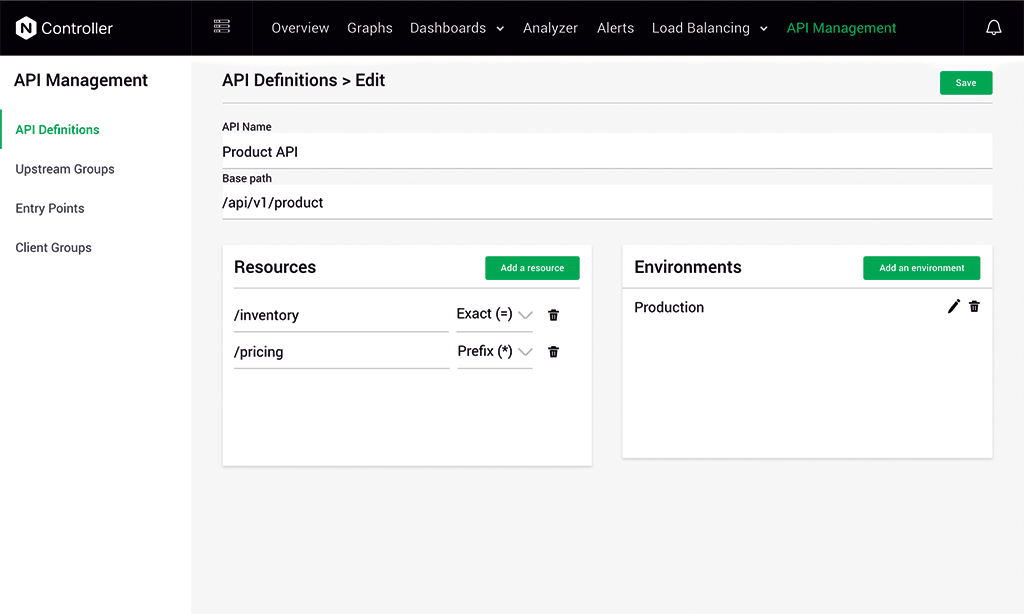
En arrière-plan, NGINX Controller génère une configuration NGINX Plus qui est publiée sur le plan de données NGINX Plus sous-jacent. Le chargeur de configuration principal dispose d’un mécanisme très efficace pour stocker les configurations en mémoire, ce qui permet au module de gestion des API d’offrir des performances élevées pour les API.
Conclusion
De nombreuses entreprises utilisent déjà NGINX Open Source comme passerelle d’API. Capital One a réussi à prendre en charge plus de 12 milliards d’appels d’API par jour avec NGINX Open Source. En fait, nombre de nos concurrents, dont Kong, utilisent NGINX Open Source comme moteur sous-jacent de leurs solutions APIM. Notre conception légère, qui repose sur une configuration NGINX native et hautement performante ainsi que sur des modules NGINX Plus, permet au module de gestion des API d’offrir une meilleure évolutivité que les solutions concurrentes dérivées de NGINX.
La latence est l’un des indicateurs les plus importants pour l’expérience utilisateur. Une latence élevée réduit la réactivité des applications et frustre les utilisateurs. Le module de gestion des API ajoute 20 à 30 % de latence en moins aux requêtes des utilisateurs par rapport à Kong. Il utilise également les ressources système plus efficacement, avec une consommation de processeur inférieure de 40 % à celle de Kong pour une même charge de travail.
Annexe
Topologie
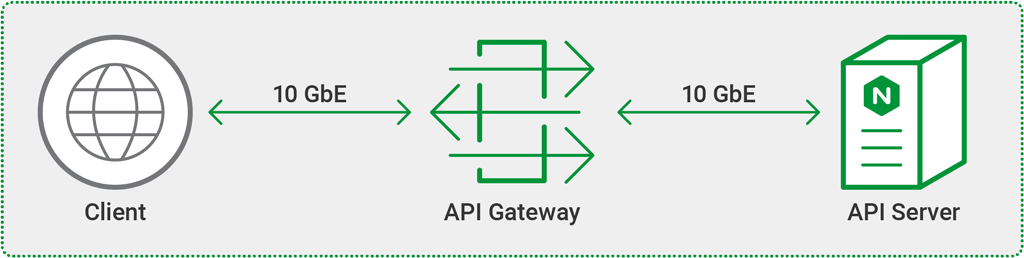
Tous les tests ont été réalisés à l’aide de trois machines distinctes reliées par des connexions 10 GbE au sein d’un réseau simple et plat de couche 2.
Matériel utilisé
Le matériel suivant a été utilisé pour les tests. Les trois machines étaient identiques. L’Hyper-Threading n’a pas été utilisé. Lors de tests précédents, nous n’avons pas constaté de différence notable de performances avec l’Hyper-Threading.
| Processeur | Réseau | Mémoire |
|---|---|---|
| Processeur Intel® Xeon(R) E5‑2699 v4 à 2,20 GHz, 22 cœurs | Contrôleur Ethernet Intel 10 Gigabits X540‑AT2 | 128 Go |
Logiciels utilisés
Les logiciels suivants ont été utilisés pour effectuer les tests :
- Module de gestion des API de NGINX Controller, version 2.
- Kong Open Source version 1.0.0. Nous n’avons pas testé Kong Enterprise, mais aucune de ses fonctionnalités supplémentaires n’est pertinente pour nos tests (par exemple, Kong Open Source et Kong Enterprise utilisent le même plug-in JWT).
curlversion 7.61.0.- Docker version 18.09.1. Pour faciliter la gestion, nous avons exécuté Kong et le module de gestion des API dans des conteneurs Docker. Nous avons constaté que Docker réduisait les performances d’environ 30 %, mais comme nous comparions des performances relatives, les avantages de Docker l’emportaient sur cette baisse de performances.
mpstatdans la version 12.0.1 du paquetsystat.wrkversion 4.1.0, installée conformément à ces instructions.
Configuration de NGINX
La configuration NGINX suivante a été utilisée pour les tests.
upstream my_upstream { keepalive 60; server API-server:80; keepalive_requests 3000000; keepalive_timeout 300;}server { listen 8000; access_log off; keepalive_requests 3000000; keepalive_timeout 300; tcp_nodelay on; location /test { set $apimgmt_environment 4; set $apimgmt_definition 3; set $upstream my_upstream; set $upstream_protocol http; rewrite ^ /_devel_4 last; } location = /_devel_4 { internal; set $apimgmt_definition_name my_api; set $apimgmt_environment_name devel; proxy_intercept_errors on; proxy_http_version 1.1; proxy_set_header Connection ""; proxy_pass $upstream_protocol://$upstream/0kb; # 0-KB file #proxy_pass $upstream_protocol://$upstream/1kb.bin; # 1-KB file }}Nous avons appliqué les paramètres suivants afin d’optimiser les performances. Comme indiqué dans la section suivante, nous avons appliqué des paramètres similaires dans la configuration de Kong.
keepalive_requestsetkeepalive_timeoutont été définis sur une valeur élevée afin de réduire au minimum la surcharge liée à l’établissement des connexions TCP.tcp_nodelaya été activé, améliorant légèrement les performances grâce à la désactivation de l’algorithme de Nagle.access_loga été désactivé. Son activation réduit les performances d’environ 10 %.- Nous avons utilisé les deux directives «
proxy_pass» pour demander un fichier de la taille appropriée.
Configuration de Kong
Nous avons ajouté les directives de configuration suivantes à « kong.conf.default », conformément aux paramètres de la configuration NGINX présentée dans la section précédente.
nginx_http_tcp_nodelay=onnginx_http_keepalive_requests=3000000nginx_http_keepalive_timeout=300proxy_access_log=offNous avons exécuté les appels d’API Kong suivants afin de créer une route vers le serveur d’API. La première commande crée un service nommé « test » et la seconde crée la route « /test » pointant vers le serveur.
$ curl -X POST http://localhost:8001/services/ --data 'name=test' --data 'url=http://API-server:80/0kb'$ curl -X POST http://localhost:8001/services/test/routes --data 'paths[]=/test'Les commandes suivantes affichent respectivement la configuration du service et celle de la route. Nous redirigeons la sortie vers l’outil « jq » afin de faciliter la lecture de la sortie JSON.
$ curl localhost:8001/services/ | jq '.'{ "next": null, "data": [ { "host": "172.20.40.32", "created_at": 1556770191, "connect_timeout": 60000, "id": "f4629d56-550b-4b37-aa59-66d931aa6f37", "protocol": "http", "name": "test", "read_timeout": 60000, "port": 80, "path": "/0kb", "updated_at": 1556770191, "retries": 5, "write_timeout": 60000 } ]}$ curl localhost:8001/services/test/routes | jq '.'{ "next": null, "data": [ { "created_at": 1556770191, "methods": null, "id": "a7b417af-ccd4-48f7-b787-ae19490194dc", "service": { "id": "f4629d56-550b-4b37-aa59-66d931aa6f37" }, "name": null, "hosts": null, "updated_at": 1556770191, "preserve_host": false, "regex_priority": 0, "paths": [ "/test" ], "sources": null, "destinations": null, "snis": null, "protocols": [ "http", "https" ], "strip_path": true } ]}Méthodologie de test
Latence ajoutée à une requête unique
Nous avons utilisé curl pour tester la latence d’une requête unique. Afin d’établir une valeur de référence, nous avons d’abord envoyé une requête au serveur d’API sans passer par une passerelle API. Nous avons ensuite envoyé la même requête en plaçant successivement chaque passerelle API devant le serveur d’API afin de mesurer la latence qu’elle introduisait.
$ curl -w "@curl-latency.txt" -o /dev/null -s http://target-serverLe contenu de « curl-latency.txt » :
time_namelookup: %{time_namelookup}n time_connect: %{time_connect}n time_appconnect: %{time_appconnect}n time_pretransfer: %{time_pretransfer}n time_redirect: %{time_redirect}n time_starttransfer: %{time_starttransfer}n ----------n time_total: %{time_total}nLe graphique de la section « Latence ajoutée à une requête unique » indique la valeur de time_total, en millisecondes. Voici un exemple de résultat :
$ curl -w "@curl-latency.txt" -o /dev/null -s http://192.0.2.1/api-endpoint time_namelookup: 0.000035 time_connect: 0.000364 time_appconnect: 0.000000 time_pretransfer: 0.000401 time_redirect: 0.000000 time_starttransfer: 0.001701 ---------- time_total: 0.001727Appels d’API par seconde
Nous avons testé le nombre d’appels d’API par seconde avec wrk, un outil d’analyse comparative évolutif que nous utilisons souvent. Nous avons essayé différentes combinaisons de paramètres, et celle-ci a permis d’optimiser les performances du module de gestion des API et de Kong :
$ wrk -t 22 -c 300 -d 180 http://target-serverLa commande crée 22 threads wrk (un par cœur) et répartit un total de 300 connexions entre ces threads. Le paramètre -d indique la durée du test, soit dans notre cas 180 secondes (3 minutes). Exemple de sortie :
$ wrk -t 22 -c 300 -d 180 http://192.0.2.1/api-endpointRunning 3m test @ http://192.0.2.1/api-endpoint 22 threads and 300 connections Thread Stats Avg Stdev Max +/- Stdev Latency 13.96ms 7.84ms 279.85ms 77.37% Req/Sec 0.96k 298.23 1.88k 68.55% 3769861 requests in 3.00m, 36.25GB readRequests/sec: 20934.34Transfer/sec: 206.16MBUtilisation du processeur
Nous avons mesuré l’utilisation du processeur avec mpstat (un outil Linux standard prévu à cet effet) tout en exécutant la commande wrk pour mesurer le nombre d’appels d’API par seconde. Exemple de sortie (réparti sur deux lignes pour plus de lisibilité) :
$ mpstatLinux 4.18.0-13-generic (nbdw38) 04/29/2019 _x86_64_ (88 CPU)03:34:50 PM CPU %usr %nice %sys %iowait %irq %soft %steal ...03:34:50 PM all 0.04 0.00 0.02 0.00 0.00 0.03 0.00 ... ... %guest %gnice %idle ... 0.00 0.00 99.91Appels d’API par seconde avec des JWT
Nous avons testé les performances des JWT avec la commande « wrk » pour mesurer le nombre d’appels d’API par seconde, en ajoutant le paramètre « -H » afin d’insérer le JWT dans l’en-tête HTTP « Authorization: Bearer ». Nous avons généré le JWT et les clés web JSON (JWK) en suivant les instructions de cet article de blog, puis stocké le JWT dans un fichier nommé test.jwt.
$ wrk -t 22 -c 300 -d 180 -H "Authorization: Bearer `cat test.jwt`" http://target-serverÀ propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.