Éditeur – Voici la deuxième partie d’une série consacrée à la mise en cache haute capacité et haute disponibilité :
- Caches partagés avec les clusters de cache NGINX Plus, partie 1
- Caches partagés avec les clusters de cache NGINX Plus, 2e partie (cet article)
Comment créer un cluster de cache à haute capacité et haute disponibilité à l’aide de NGINX ou NGINX Plus ? Cet article explique comment utiliser au moins deux serveurs de cache NGINX ou NGINX Plus pour créer un cluster de cache à haute disponibilité. (Sauf indication contraire, la méthode décrite ici s’applique aussi bien à NGINX Open Source qu’à NGINX Plus, mais, par souci de concision, nous mentionnerons uniquement NGINX Plus.)
Rappel – La solution de cache partitionné
La première partie de cette série décrivait un modèle permettant de créer de très grands clusters de cache partitionnés.
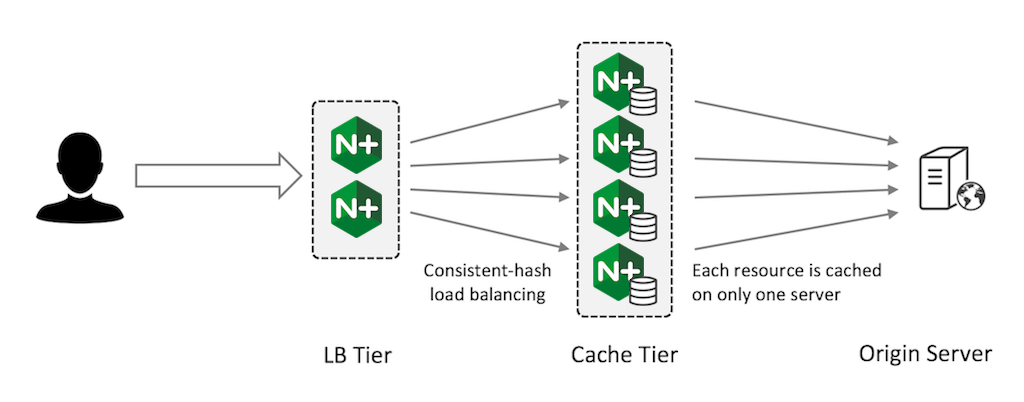
Ce modèle est efficace lorsque vous devez créer un cache de très grande capacité pouvant être étendu à volonté. Comme chaque ressource n’est mise en cache que sur un seul serveur, il n’offre pas une tolérance aux pannes totale. Toutefois, l’équilibrage de charge par hachage cohérent garantit qu’en cas de défaillance d’un serveur, seule la part du contenu mis en cache qui lui est attribuée est invalidée.
Création d’un cluster de cache à haute disponibilité
Si votre objectif principal est de réduire à tout prix le nombre de requêtes adressées à vos serveurs d’origine, la solution de partitionnement du cache n’est pas la plus adaptée. Une solution reposant sur une configuration minutieuse des instances NGINX Plus principales et secondaires peut en revanche répondre à vos besoins :
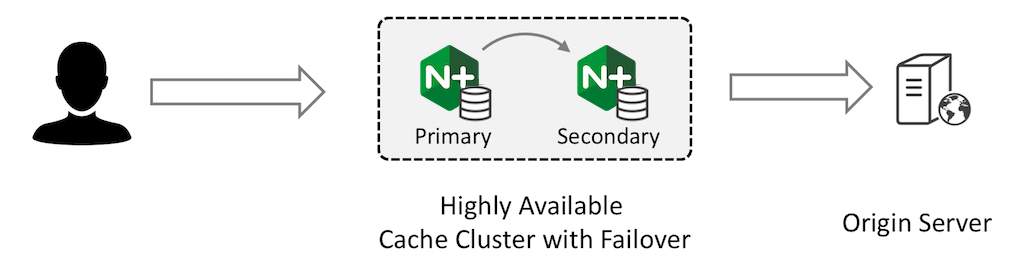
L’instance NGINX Plus principale reçoit tout le trafic et transmet les requêtes à l’instance secondaire. L’instance secondaire récupère le contenu auprès du serveur d’origine et le met en cache ; l’instance principale met également en cache la réponse de l’instance secondaire et la renvoie au client.
Les caches des deux appareils sont entièrement remplis et sont actualisés en fonction des délais d’expiration que vous avez configurés.
Configuration du serveur de cache principal
Configurez le serveur de cache principal afin qu’il transfère toutes les requêtes au serveur secondaire et mette les réponses en cache. Comme l’indique le paramètre « backup » de la directive « server » dans le groupe de serveurs en amont, le serveur principal transfère directement les requêtes au serveur d’origine en cas de défaillance du serveur secondaire :
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://secondary;
    }
}

upstream secondary {
    zone secondary 128k;          # for NGINX Plus extended status

    server 192.168.56.11;         # secondary
    server 192.168.56.12 backup;  # origin
}
Configuration du serveur de cache secondaire
Configurez le serveur de cache secondaire afin qu’il transmette les requêtes au serveur d’origine et mette les réponses en cache.
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://origin;
    }
}

upstream origin {
    zone origin 128k;            # for NGINX Plus extended status

    server 192.168.56.12;        # origin
}
Configuration de la haute disponibilité
Enfin, vous devez configurer la haute disponibilité (HA) afin que le serveur secondaire prenne en charge le trafic entrant en cas de défaillance du serveur principal. Lorsque ce dernier est de nouveau opérationnel, il reprend alors le trafic.
Dans cet exemple, nous utilisons la solution de haute disponibilité active-passive pour NGINX Plus. L’adresse IP virtuelle annoncée à l’extérieur est 192.168.56.20, et le serveur de cache principal fait office de nœud principal pour la haute disponibilité au sein du cluster. Si vous utilisez NGINX Open Source, vous pouvez installer et configurer manuellement keepalived ou une autre solution de haute disponibilité.
Scénarios de basculement
Rappelons que nous souhaitons créer un cluster de cache à haute disponibilité qui continue de fonctionner même en cas de défaillance d’un serveur de cache. Nous ne voulons pas que la charge du serveur d’origine augmente, que ce soit lorsqu’un serveur de cache tombe en panne ou lorsqu’il se rétablit et doit actualiser du contenu obsolète.
Supposons que le serveur principal tombe en panne et que la solution de haute disponibilité NGINX Plus transfère l’adresse IP externe vers le serveur secondaire.
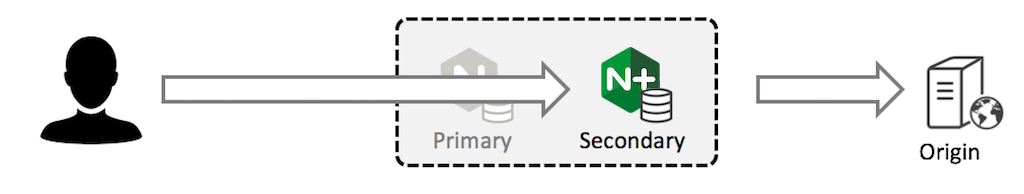
Le serveur secondaire dispose d’un cache complet et continue de fonctionner normalement. Le serveur d’origine ne subit aucune charge supplémentaire.
Lorsque le serveur de cache principal se rétablit et commence à recevoir du trafic client, son cache n’est plus à jour et de nombreuses entrées ont expiré. Le serveur principal actualise son cache local à partir du serveur de cache secondaire ; comme le cache du serveur secondaire est déjà à jour, le trafic vers le serveur d’origine n’augmente pas.
Supposons maintenant que le serveur secondaire tombe en panne. Le serveur principal le détecte (à l’aide d’un contrôle d’intégrité configuré dans le cadre de la solution de haute disponibilité) et redirige le trafic directement vers le serveur de secours (qui est le serveur d’origine).
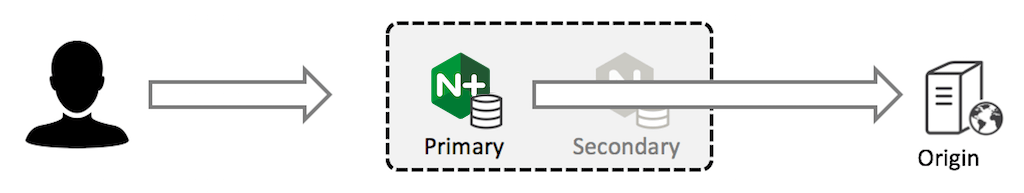
Le serveur principal dispose d’un cache complet et continue de fonctionner normalement. Là encore, aucune charge supplémentaire n’est imposée au serveur d’origine.
Lorsque le serveur secondaire est de nouveau opérationnel, son cache n’est plus à jour. Toutefois, il ne reçoit des requêtes du serveur principal que lorsque le cache de ce dernier expire, auquel cas la copie du serveur secondaire a également expiré. Même si le serveur secondaire doit alors demander le contenu au serveur d’origine, cela n’augmente pas la fréquence des requêtes adressées à celui-ci. Le serveur d’origine ne subit donc aucun effet négatif.
Tester le comportement de basculement
Pour tester notre solution de haute disponibilité, nous configurons le serveur d’origine pour qu’il journalise les requêtes et renvoie l’heure actuelle pour chaque requête. Cela signifie que la réponse du serveur d’origine change toutes les secondes :
access_log /var/log/nginx/access.log;
location / {
    return 200 "It's now $time_localn";
}
Les serveurs de cache principal et secondaire sont déjà configurés pour mettre en cache les réponses ayant le code d’état 200 pendant 15 secondes. Cela entraîne généralement une actualisation du cache toutes les 15 ou 16 secondes.
proxy_cache_valid 200 15s;Vérification du comportement du cache
Une fois par seconde, nous envoyons une requête HTTP à l’adresse IP virtuelle à haute disponibilité du cluster de cache. La réponse ne change pas tant que les caches des serveurs principal et secondaire n’ont pas expiré et que la réponse n’a pas été actualisée depuis le serveur d’origine. Cela se produit toutes les 15 ou 16 secondes.
$ while sleep 1 ; do curl http://192.168.56.20/ ; done
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:19 -0800
It's now 9/Feb/2017:06:35:19 -0800
^C
Nous pouvons également consulter les journaux du serveur d’origine pour vérifier qu’il ne reçoit une requête que toutes les 15 ou 16 secondes.
Vérification du basculement
Nous pouvons vérifier que le basculement fonctionne correctement en arrêtant le serveur principal ou le serveur secondaire, par exemple en arrêtant les processus nginx. Le test à charge constante continue de s’exécuter et la réponse est systématiquement mise en cache.
L’examen du journal d’accès du serveur d’origine confirme qu’il ne reçoit qu’une requête toutes les 15 à 16 secondes, quel que soit le serveur de cache qui tombe en panne ou se rétablit.
Fréquence de mise à jour du cache
Dans une situation stable, le contenu mis en cache est normalement actualisé toutes les 15 à 16 secondes. Le contenu expire au bout de 15 secondes, et un délai pouvant aller jusqu’à 1 seconde s’écoule avant la réception de la requête suivante, ce qui entraîne une actualisation du cache.
Il peut arriver que le cache semble se mettre à jour plus lentement (jusqu’à 30 secondes entre deux modifications du contenu). Cela se produit lorsque le contenu du serveur de cache principal expire et que celui-ci récupère auprès du serveur secondaire un contenu mis en cache qui est sur le point d’expirer. Si cela pose problème, vous pouvez configurer un délai d’expiration du cache plus court sur le serveur secondaire.
Résumé
La hiérarchisation des caches entre deux ou plusieurs serveurs de cache NGINX, comme nous l’avons décrit ici, constitue un moyen efficace de créer un cluster de cache à haute disponibilité qui réduit au minimum la charge sur les serveurs d’origine et les protège contre les pics de trafic lorsqu’un des serveurs de cache tombe en panne ou se rétablit.
La capacité totale du cache est limitée à celle d’un seul serveur de cache. La première partie de cette série décrit une autre architecture de cache partitionné, qui répartit le cache sur une grappe de serveurs de cache. Dans ce cas, la capacité totale correspond à la somme des capacités de tous les serveurs de cache, mais le contenu n’est pas répliqué pour protéger le serveur d’origine contre les pics de trafic en cas de défaillance d’un serveur de cache.
Testez la mise en cache haute disponibilité sur vos propres serveurs : commencez dès aujourd’hui votre essai gratuit de 30 jours ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.