Editor – Esta publicación forma parte de una serie de 10 entregas:
- Reduzca la complejidad con Kubernetes preparado para producción
- Cómo mejorar la resiliencia en Kubernetes con una gestión avanzada del tráfico
- Cómo mejorar la visibilidad en Kubernetes (este artículo)
- Seis formas de proteger Kubernetes mediante herramientas de gestión del tráfico
- Guía para elegir un controlador de Ingress, parte 1: identifique sus requisitos
- Guía para elegir un controlador de Ingress, parte 2: riesgos y preparación para el futuro
- Guía para elegir un controlador de Ingress, parte 3: código abierto frente a opción predeterminada frente a solución comercial
- Guía para elegir un controlador de Ingress, parte 4: opciones de controladores de Ingress de NGINX
- Cómo elegir una malla de servicios
- Pruebas de rendimiento de los controladores de Ingress de NGINX en un entorno dinámico de Kubernetes en la nube
También puede descargar la colección completa de artículos en forma de libro electrónico gratuito: De las pruebas a la producción con Kubernetes.
La adopción de microservicios acelera las experiencias digitales, pero las arquitecturas de microservicios también pueden hacer que esas experiencias sean más frágiles. Mientras sus desarrolladores trabajan a toda velocidad para lanzar nuevas aplicaciones, su arquitectura puede aumentar el riesgo de interrupciones, vulnerabilidades de seguridad y pérdida de tiempo debido a una resolución de problemas ineficiente o a la corrección de problemas que podrían haberse evitado. En este segundo artículo de nuestra serie sobre Kubernetes para entornos de producción, analizamos cómo los componentes que proporcionan visibilidad del tráfico pueden reducir la complejidad y mejorar la seguridad en sus entornos de microservicios.
Obtenga visibilidad para lograr una mejor comprensión
En primer lugar, veamos un par de definiciones:
- Visibilidad – Estado en el que se puede ver o ser visto
- Perspicacia – Una comprensión profunda de una persona o cosa
En una encuesta de StackRox de 2020, el 75 % de los usuarios de Kubernetes identificó la visibilidad como una funcionalidad «imprescindible». Coincidimos en que la visibilidad es clave en Kubernetes, ya que puede resultar especialmente difícil saber qué se ha implementado. Sin embargo, el 95 % de los participantes en el informe de F5 de 2021 Estado de la estrategia de aplicaciones (SOAS) afirmó que, aunque dispone de una gran cantidad de datos, carece de la información útil sobre el rendimiento, la seguridad y la disponibilidad de las aplicaciones que necesita para proteger y desarrollar su infraestructura y su negocio. Entonces, ¿por qué es importante contar con esta información y cómo se obtiene?
Con la información adecuada, puede:
- Refuerce la seguridad y el cumplimiento normativo detectando vulnerabilidades y posibles vectores de ataque
- Reduce las interrupciones y el tiempo de inactividad detectando los problemas antes que sus clientes
- Mejore la eficiencia de la resolución de problemas identificando la causa raíz de los fallos de la aplicación
- Confirma que el tráfico se dirige únicamente a donde quieres que vaya
- Sepa exactamente qué se está ejecutando en sus entornos de Kubernetes y si está correctamente configurado y protegido
- Determina si estás utilizando la cantidad adecuada de recursos en función del historial de latencia y rendimiento
- Predice las necesidades estacionales basándote en los patrones de tráfico anteriores
- Medir el rendimiento en términos de tiempo de respuesta para supervisar el cumplimiento de los acuerdos de nivel de servicio (SLA) y disponer de un sistema de alerta temprana antes de que los problemas afecten a la experiencia del usuario
Para obtener información útil, necesita dos tipos de datos de visibilidad: en tiempo real e históricos. Los datos en tiempo real le permiten diagnosticar el origen de un problema que se está produciendo en ese preciso momento, mientras que los datos históricos aportan perspectiva sobre qué es «normal» y qué constituye un valor atípico. En conjunto, estos dos tipos de fuentes de visibilidad pueden proporcionar información crucial sobre el rendimiento de las aplicaciones y de Kubernetes.
Al igual que con otras inversiones tecnológicas, también se necesita una estrategia para aprovechar sus beneficios. El informe SOAS también señala que no se logra obtener información valiosa debido a factores organizativos relacionados con la contratación y el desarrollo de los empleados, la estrategia y los procesos, y la falta de consenso sobre para qué deben utilizarse los datos, cuándo y por parte de quién. Entre las conclusiones se incluyen las siguientes:
- Competencias relacionadas – No es ningún secreto que hay escasez de profesionales tecnológicos cualificados, como confirma el 47 % de los encuestados, que afirma tener dificultades para encontrar el talento que necesita.
- Iniciativas para compartir datos – Solo el 12 % de los encuestados dispone de procesos y estrategias para comunicar los datos a los responsables de la toma de decisiones empresariales y concienciarlos sobre el impacto que tiene en el negocio una tecnología resiliente (o la falta de ella).
- El propósito de la visibilidad – La mayoría de los encuestados utiliza la telemetría de forma reactiva (es decir, para solucionar problemas), mientras que solo el 24 % utiliza de forma proactiva los datos y la información para detectar posibles degradaciones del rendimiento, y el 16 % para supervisar el cumplimiento de los SLA.
El resto de esta publicación se centra en los aspectos técnicos de la obtención de información. No te pierdas las próximas publicaciones sobre estrategia, procesos y otros temas.
Cómo puede ayudar NGINX
Sabemos que la mayoría de las implementaciones de Kubernetes ya utilizan una herramienta de monitorización y no necesitan otra más. Por eso, hemos instrumentado la API de NGINX Plus para facilitar la exportación de métricas y ofrecemos integraciones con herramientas populares como OpenTracing y Grafana y Prometheus, para que pueda obtener una visión completa del rendimiento dentro de sus clústeres. Obtendrá información específica sobre el rendimiento y la disponibilidad de las aplicaciones mediante trazas detalladas, lo que le permitirá comprender cómo se procesan las solicitudes en sus aplicaciones de microservicios.
- Visibilidad del tráfico de entrada y salida (norte-sur)
NGINX Ingress Controller proporciona visibilidad del tráfico que entra y sale de sus clústeres de Kubernetes. ¿Sabía que existen tres controladores Ingress populares basados en NGINX? No todos están preparados para entornos de producción, y una elección equivocada podría acabar complicando su estrategia de microservicios en lugar de mejorarla. Nuestra entrada de blog Un momento, ¿qué controlador NGINX Ingress para Kubernetes estoy utilizando? ofrece una comparativa de las opciones para que pueda tomar la decisión que mejor se adapte a sus necesidades. - Visibilidad del tráfico este-oeste
NGINX Service Mesh proporciona visibilidad del tráfico que fluye entre aplicaciones en contenedores.
Siga leyendo para descubrir cómo podemos ayudarle con dos problemas habituales:
Si quieres ver la tecnología en acción, no te pierdas esta demostración en directo y la sesión de preguntas y respuestas con expertos de NGINX y Grafana. Verás cómo obtener una monitorización en tiempo real de las principales métricas de equilibrio de carga y rendimiento, exportarlas a Prometheus y crear paneles de Grafana para visualizar el rendimiento acumulado.
Problema: mi aplicación va lenta (¡o no funciona!)
¿Sospechas que se está produciendo un ataque DDoS? ¿Los usuarios están informando de errores en tu sitio web? No puedes empezar a resolver el problema hasta que averigües exactamente dónde se encuentra.
- Monitorización en tiempo real con NGINX Ingress Controller
Con NGINX Plus, el panel de monitorización de la actividad en tiempo real, basado en la API de NGINX Plus, muestra cientos de métricas clave de carga y rendimiento. Obtenga información detallada hasta el nivel de un único pod para poder medir rápida y fácilmente los tiempos de respuesta de las aplicaciones y diagnosticar el origen de un problema. Si su entorno de Kubernetes crece, obtendrá automáticamente paneles para cada instancia adicional de NGINX Ingress Controller. Por ejemplo, dos columnas de la pestaña HTTP Upstreams le permiten conocer al instante el estado de las aplicaciones y la infraestructura: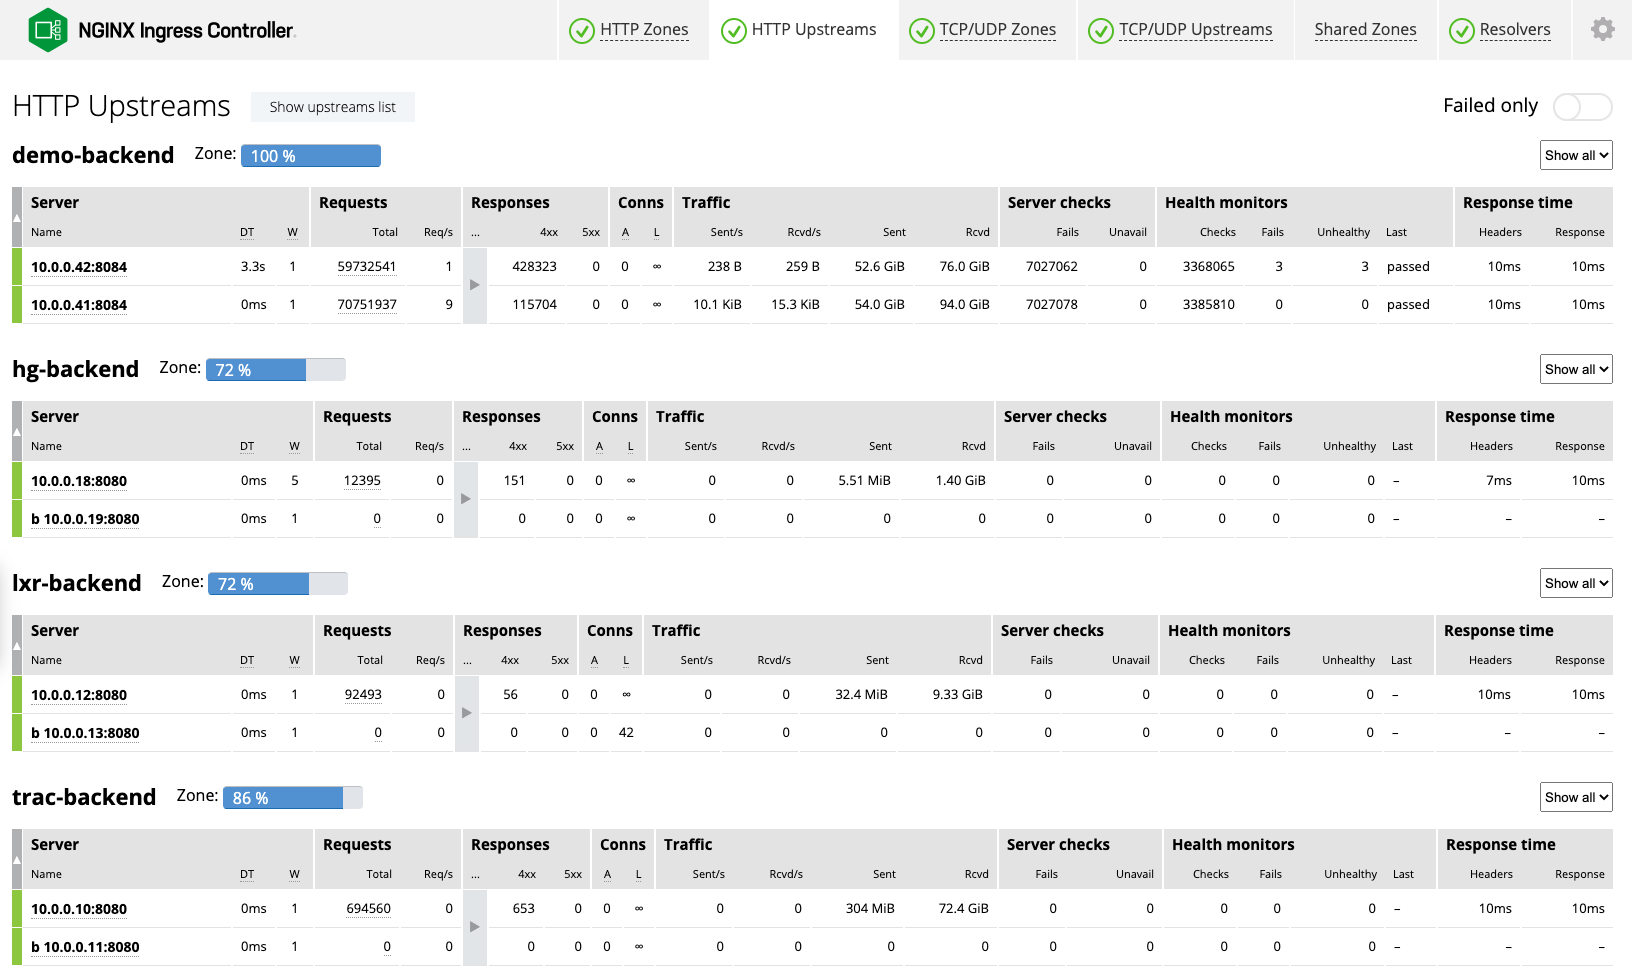
- Solicitudes – Si el número de solicitudes por segundo (solicitudes/s) cae por debajo de lo habitual para una aplicación determinada (por ejemplo, 5 solicitudes por segundo cuando lo normal son 40), es posible que el Ingress Controller o la aplicación estén mal configurados.
- Tiempo de respuesta – Si los tiempos de respuesta son de 10 milisegundos (ms) o menos, todo va de maravilla. Una latencia superior a 30–40 ms indica que hay problemas con las aplicaciones de origen.
- Estado básico de NGINX Ingress Controller
Con NGINX Open Source, NGINX Ingress Controller incluye una página de estado que proporciona ocho métricas básicas. - OpenTracing con NGINX Service Mesh
NGINX Service Mesh es compatible con OpenTracing mediante el módulo OpenTracing de NGINX. En el momento de redactar este documento, el módulo es compatible con Datadog, LightStep, Jaeger y Zipkin.
Problema: Mi clúster o plataforma se está quedando sin recursos
¿Tienes errores HTTP? 503 y 40x indican que hay un problema con tus recursos, mientras que los errores 502 indican que un cambio de configuración no ha funcionado. Utiliza los datos históricos para determinar qué recursos podrían estar agotándose.
- Registro con NGINX Ingress Controller
El primer paso para diagnosticar problemas de red es consultar los registros de NGINX Ingress Controller, en los que cada entrada está etiquetada con el servicio de Kubernetes correspondiente. Las entradas de error identifican el servicio asociado. Los registros incluyen información detallada sobre todo el tráfico que ha pasado por el Ingress Controller, como la marca de tiempo, la dirección IP de origen y el código de estado de la respuesta. También puede exportar los registros a agregadores populares como Datadog, Grafana y Splunk. - Métricas de Prometheus
Una de las funciones más populares de NGINX Ingress Controller es su lista, cada vez más amplia, de métricas de Prometheus, que incluyen métricas sobre el rendimiento de la red y el tráfico del controlador de Ingress. Con NGINX Plus, NGINX Ingress Controller exporta métricas sobre las conexiones, el almacenamiento en caché, el tráfico HTTP y TCP/UDP gestionado por grupos de procesos de trabajo de NGINX que comparten datos en una zona de memoria, el tráfico HTTP y TCP/UDP gestionado por grupos de servidores backend, entre otros. NGINX Service Mesh implementa un servidor Prometheus que utiliza la API de NGINX Plus para recopilar métricas de los sidecars de NGINX Service Mesh y los pods de NGINX Ingress Controller. Si prefiere utilizar una implementación de Prometheus existente, también proporcionamos configuraciones de recopilación para añadirlas a su archivo de configuración de Prometheus. - Paneles de Grafana
Proporcionamos paneles oficiales de Grafana para NGINX Ingress Controller y NGINX Service Mesh que permiten visualizar las métricas expuestas por Prometheus Exporter. Los usuarios valoran la granularidad de los datos, que incluyen detalles con una precisión de hasta milisegundos, comparativas superpuestas entre distintos días y picos de tráfico. Por ejemplo, el panel de NGINX Service Mesh puede indicar que los pods han alcanzado su capacidad mostrando el volumen de tráfico de un servicio o pod determinado y el número de pods activos que se están supervisando.
Preparación para producción con NGINX
El controlador de entrada NGINX listo para producción (basado en NGINX Plus) está disponible con una prueba gratuita de 30 días que incluye NGINX App Protect para proteger sus aplicaciones en contenedores. NGINX Service Mesh, que es gratuito para siempre, está disponible para su descarga en f5.com.
Sobre el autor

Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.