La disponibilidad es un asunto muy serio en una economía en la que las aplicaciones son moneda de cambio. Las aplicaciones que no responden se eliminan de inmediato y se critican en Internet con la rapidez y el sarcasmo de una reseña negativa en Yelp.
Desde los primeros tiempos de Internet, las organizaciones han procurado garantizar que las aplicaciones (los sitios web, antiguamente) estuvieran disponibles las 24 horas del día, los 7 días de la semana y los 365 días del año. Porque Internet nunca duerme, nunca se va de vacaciones y nunca se pone enfermo.
Para satisfacer esa necesidad (en realidad, un requisito), la escalabilidad surgió como uno de los primeros servicios de aplicaciones destinados a garantizar la disponibilidad. El servicio de aplicaciones más visible —y mejor comprendido— para satisfacer las necesidades de disponibilidad es el balanceo de carga.
Sin embargo, existen muchas formas de equilibrar la carga y diversos patrones de escalabilidad que se pueden implementar mediante esta tecnología básica. Hoy voy a destacar los cinco patrones de escalabilidad más utilizados para mantener las aplicaciones e Internet en funcionamiento y disponibles las 24 horas del día, los 7 días de la semana y los 365 días del año.
Equilibrado global de carga de servidores (GSLB)
GSLB tiene un nombre muy poco acertado. En realidad, nunca se trató del balanceo de carga de los servidores, sino de la disponibilidad del sitio. Hoy en día, este concepto se está ampliando para incluir también la disponibilidad de las aplicaciones.
GSLB es el mecanismo que permite garantizar que, si un centro de datos (en la nube o tradicional) no responde, se pueda recurrir a otro. GSLB puede aplicarse a nivel de dominio o de host. Por tanto, puede utilizarse para alternar example.com entre distintas ubicaciones, así como api.example.com.
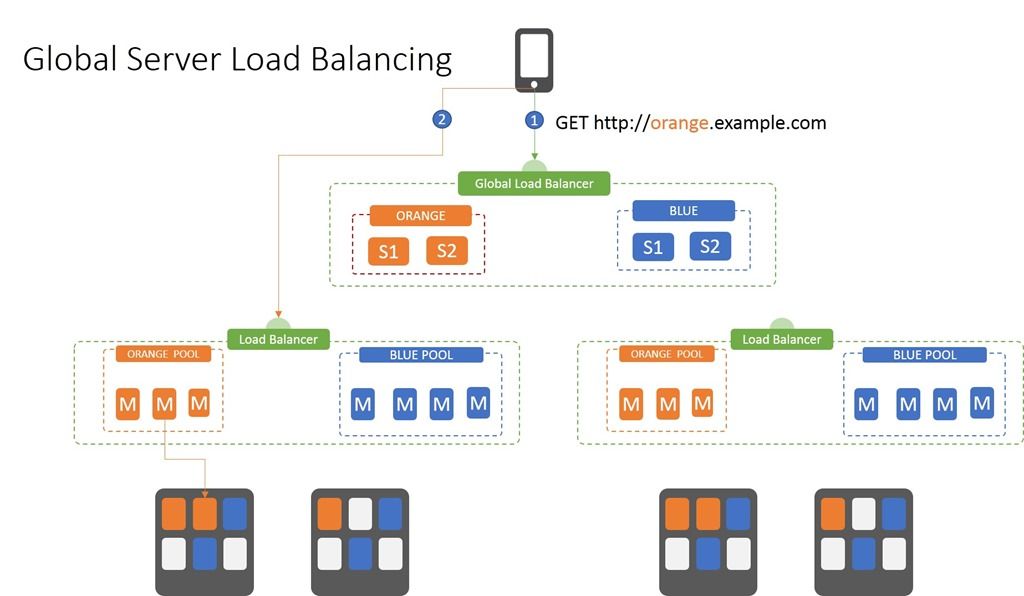
En su forma más básica, GSLB utiliza un sistema rudimentario de balanceo de carga basado en DNS. Esto significa que dispone de una lista de direcciones IP asociadas a un dominio o host y, si la primera no está disponible, las solicitudes se dirigen a la segunda de la lista, o a la tercera, la cuarta y así sucesivamente.
Este proceso consta de dos pasos:
- Solicita al balanceador de carga global la dirección IP adecuada. Este es el inconveniente que siempre se asocia al GSLB: si has realizado la consulta en los últimos 15 minutos, o durante el TTL actual de la dirección IP de cheese.com, recibirás la última respuesta obtenida. Por tanto, si ese sitio deja de estar disponible durante ese intervalo, no podrás conectarte.
- Realice la solicitud a la dirección IP del sitio devuelta por la consulta al GSLB. A menudo, esta resulta ser la de un balanceador de carga local que utiliza sus propios algoritmos y procesos de toma de decisiones para dirigir la solicitud al recurso adecuado.
Por lo general, la decisión tomada en el paso 1 no se basa en ningún criterio inteligente, sino únicamente en si un sitio determinado responde o no. Aun así, de este modo se pueden utilizar varias ubicaciones —en la nube, en un proveedor de alojamiento o en las propias instalaciones— para garantizar la disponibilidad. Al elegir estratégicamente ubicaciones en distintas zonas geográficas, se puede evitar el impacto de catástrofes naturales o cortes de Internet.
Pero eso se corresponde más bien con un escenario de DR (recuperación ante desastres) o BC (continuidad del negocio). Hay otros escenarios que aprovechan servicios de aplicaciones GSLB más inteligentes, como la geolocalización y el rendimiento de las aplicaciones. Así, si la aplicación del sitio A ofrece un rendimiento deficiente, quizá convenga enviar a los visitantes al sitio B hasta que se resuelva el problema. O tal vez se prefiera dirigir a los usuarios a la ubicación geográficamente más cercana para mejorar el rendimiento (porque la velocidad de la luz sigue siendo una limitación y la distancia influye en el rendimiento de las aplicaciones).
Independientemente de cómo se tome la decisión, el patrón básico sigue siendo el mismo: GLSB distribuye las solicitudes entre varios sitios físicamente separados devolviendo la dirección IP de uno de los sitios disponibles. Ya se trate de API o de aplicaciones, GSLB es un patrón de alto nivel para garantizar la disponibilidad.
Balanceo de carga tradicional (POLB)
Disponibilidad basada en conexiones
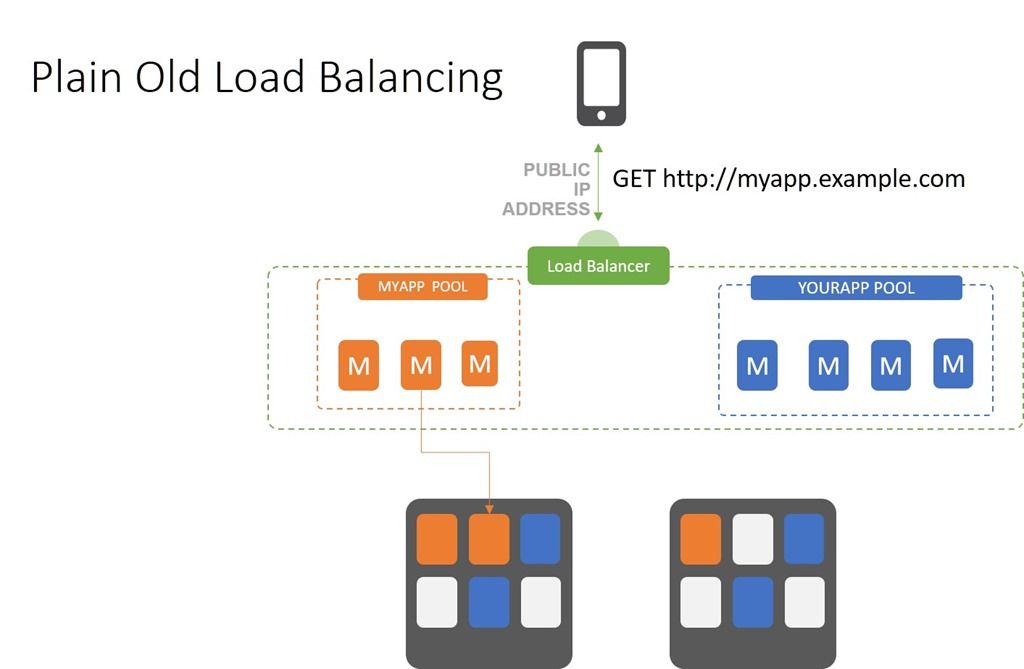
El balanceo de carga tradicional (POLB) es un término que me gusta utilizar para describir el balanceo de carga estándar basado en TCP. Con este patrón, la disponibilidad se consigue simplemente clonando aplicaciones y garantizando que se pueda establecer una conexión entre el cliente (usuario o dispositivo) y la aplicación.
El balanceador de carga (o proxy, si lo prefieres) recibe una solicitud de conexión, selecciona una instancia disponible de la aplicación y le reenvía la conexión. Esa es la última vez que el balanceador de carga interviene activamente. Es como ese «correo de presentación» con el que facilitas el contacto entre dos compañeros. Participas activamente en el intercambio inicial, pero después pasas a estar en copia y, por lo general, dejas de intervenir.
Utilizo el término POLB porque la elección de cómo dirigir las solicitudes no implica más que algoritmos. Por desgracia, pueden surgir muchos problemas en función del algoritmo utilizado para distribuirlas. Por ejemplo, el algoritmo round robin no tiene en cuenta la capacidad ni el rendimiento. Simplemente selecciona «la siguiente aplicación» y le envía la solicitud. Elegir «menos conexiones» puede afectar rápidamente al rendimiento al sobrecargar un recurso, mientras que otros podrían ser más rápidos. La elección de los algoritmos se convierte en un factor fundamental para mantener la disponibilidad.
POLB es el método predeterminado de balanceo de carga en entornos de contenedores y en muchos servicios de balanceo de carga nativos de la nube.
Persistencia
Sesiones persistentes y SSL
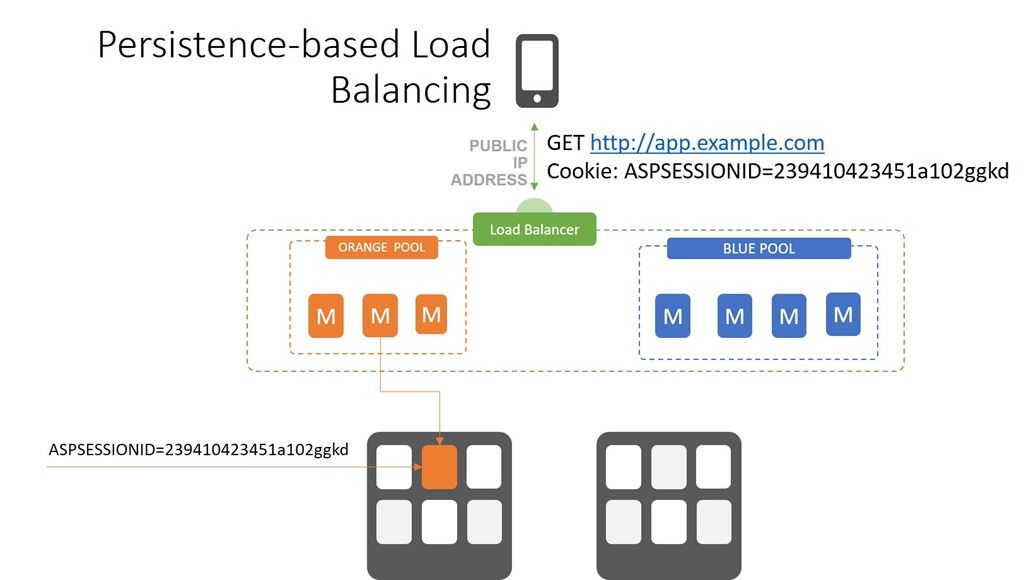
Una de las realidades de las aplicaciones de tres capas es que, por regla general, mantienen un estado. Esto significa que almacenan entre las solicitudes y las respuestas información esencial para el funcionamiento de la aplicación. El carrito de la compra, las credenciales, el estado, la última página visitada y el paso del proceso en el que se encuentra son datos que suelen almacenarse como parte de la «sesión». El problema es que muchas aplicaciones desarrolladas con frameworks de tres capas acabaron almacenando esa sesión en el servidor de aplicaciones o en el servidor web, en lugar de hacerlo en una base de datos. Esto implicaba que, una vez conectado a un servidor, tenía que seguir accediendo a ese mismo servidor para asegurarse de que toda su información estuviera disponible.
Los balanceadores de carga implementaban la persistencia de diversas formas, siendo la más popular la basada en cookies. Los identificadores de sesión se almacenaban en una cookie que el balanceador de carga utilizaba después para garantizar que las solicitudes llegaran al servidor correcto, omitiendo así, en la práctica, el proceso de selección algorítmica.
Cuando el uso de SSL/TLS se convirtió en un requisito fundamental para que los compradores se sintieran seguros, surgieron los mismos problemas. SSL/TLS permite establecer una sesión segura entre un cliente y un servidor de aplicaciones específico. Para garantizar que ambas partes de la comunicación pudieran descifrar y utilizar los datos intercambiados a través de esa conexión, el balanceador de carga debía poder dirigir las solicitudes del cliente al mismo servidor en el que se había iniciado la sesión. Mediante las mismas técnicas que permiten mantener la persistencia de sesión, los balanceadores de carga pudieron ofrecer persistencia basada en SSL/TLS.
Independientemente del tipo específico de persistencia utilizado, el patrón es el mismo. Si existe algún indicador de que ya se ha establecido una sesión, el equilibrador de carga respeta la conexión existente y garantiza que se mantenga durante toda la sesión del usuario. De lo contrario, el equilibrador de carga selecciona un recurso en función de su configuración y sus algoritmos, y establece la conexión.
Esto tiene consecuencias para la planificación de la capacidad a la hora de seleccionar un algoritmo de balanceo de carga. El algoritmo de menor número de conexiones es una buena opción para este escenario, ya que garantiza que ningún recurso se sobrecargue con sesiones activas mientras otros permanecen inactivos. Con otros algoritmos, existe la posibilidad de que un único recurso acabe manteniendo muchas sesiones de usuario al mismo tiempo, lo que afecta negativamente al rendimiento de todos los usuarios dirigidos a ese servidor.
Equilibrado de carga basado en el host
Servidores virtuales
El balanceo de carga basado en hosts es uno de los patrones de escalabilidad más comunes y con mayor compatibilidad. Podría parecer que no hace falta un balanceador de carga para implementarlo, ya que todos los servidores web pueden hacerse pasar por varios hosts al mismo tiempo. Pero sí es necesario. Aunque un servidor web o de aplicaciones puede alojar varios servidores virtuales, no necesariamente distribuye la carga entre ellos. Por tanto, sigue siendo necesario un balanceador de carga para poder escalar. La cuestión es si el balanceador de carga separará los hosts o si se dejará esa tarea al servidor web o de aplicaciones.
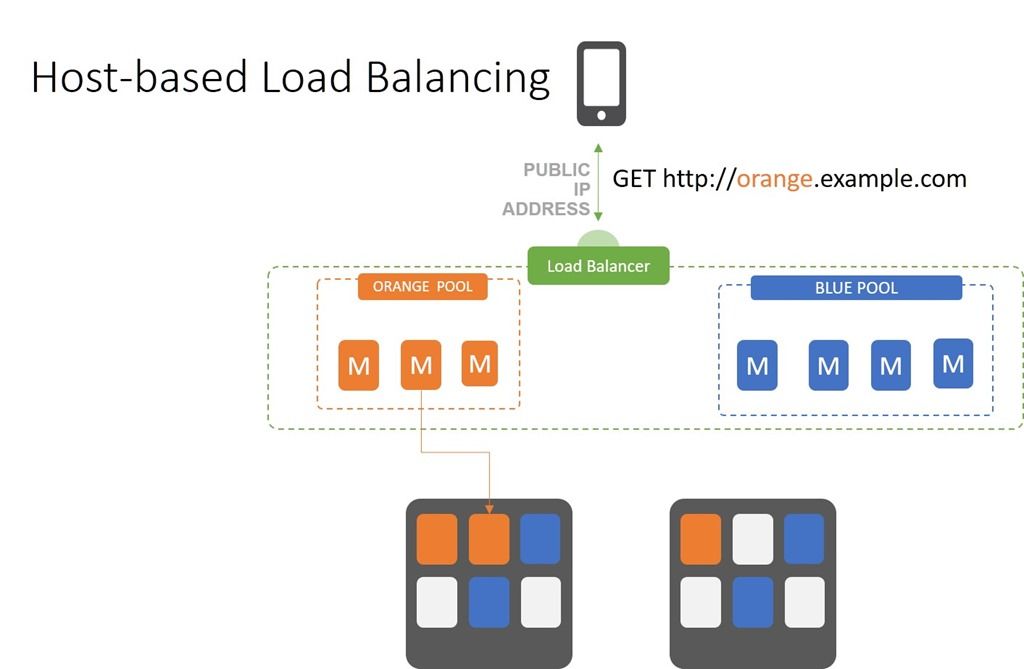
Tanto si se utilizan directivas del servidor web/de aplicaciones como un balanceador de carga externo, el flujo sigue siendo el mismo. Se realiza una solicitud y el destino (el balanceador de carga o el servidor web/de aplicaciones) la recibe. A continuación, el servidor de destino examina las cabeceras HTTP y obtiene el valor del host antes de dirigir la solicitud al servidor virtual correspondiente.
La ventaja de utilizar un equilibrador de carga para separar los hosts reside en su capacidad para aislar los dominios en función del host y escalarlos individualmente. Esto resulta más eficiente y puede reducir el número de servidores (tanto de hardware como de software) necesarios para escalar una aplicación. Además, facilita la planificación de la capacidad, ya que permite predecir mejor qué carga puede gestionar cada servidor host en un momento dado.
Esto se debe a que invocar la lógica de negocio no requiere la misma capacidad de procesamiento que solicitar una imagen. Combinar distintos hosts en el mismo dominio de escalabilidad genera una carga volátil y una capacidad impredecible. Si opta por utilizar un balanceador de carga para realizar un balanceo de carga convencional, el servidor web o de aplicaciones será el responsable de separar los hosts y dirigir las solicitudes al servidor virtual correspondiente. Este enfoque también presenta otros inconvenientes propios de una infraestructura compartida: los conflictos entre versiones, la aplicación de parches y las actualizaciones de las aplicaciones pueden generar fricciones entre los servidores virtuales.
La creciente adopción de contenedores y microservicios está impulsando el uso del balanceo de carga basado en hosts mediante controladores de entrada.
Enrutamiento y retorno
Balanceo de carga de capa 7 (HTTP)
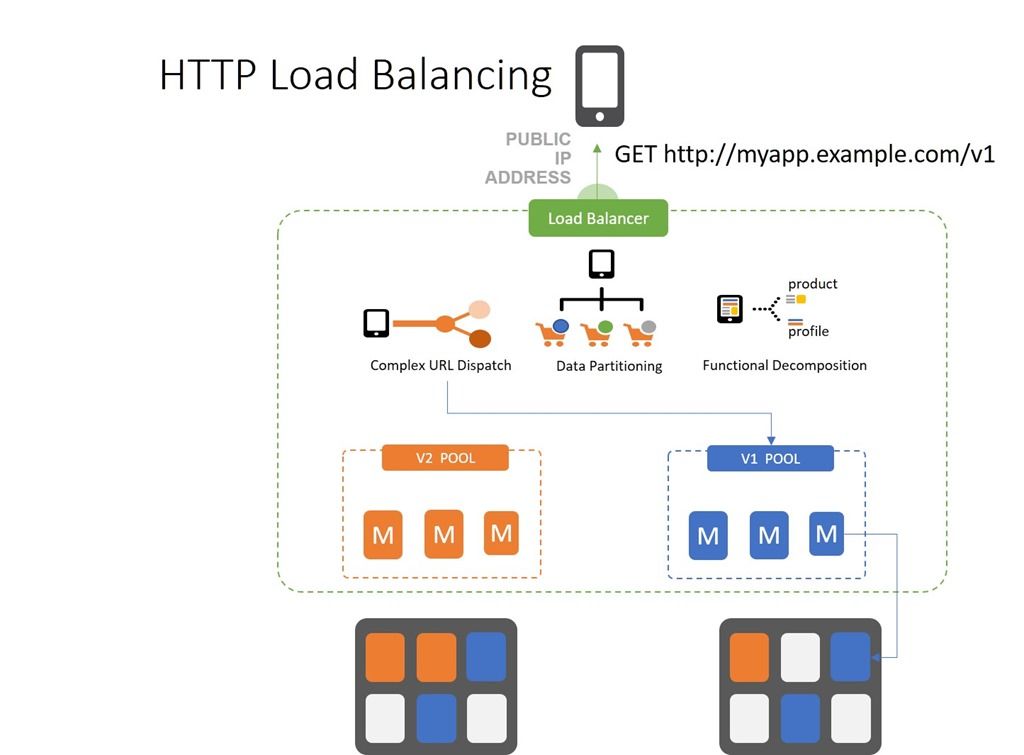
El balanceo de carga de capa 7 (HTTP) es mi favorito gracias a la versatilidad (¿agilidad?) que ofrece. Se pueden balancear las solicitudes en función de cualquier elemento HTTP, incluida la carga útil. La mayoría de la gente (con buen criterio, en mi opinión) limita sus reglas de balanceo de carga a la información disponible en la cabecera HTTP. Esto incluye, entre otros, el host, el método HTTP, el tipo de contenido, las cookies, las cabeceras personalizadas y el agente de usuario.
El balanceo de carga HTTP consiste primero en enrutar y después en equilibrar la carga. Un patrón típico de balanceo de carga HTTP sigue el esquema enrutar –> distribuir. Esto significa que primero se decide a qué servidor virtual debe dirigirse una solicitud y, a continuación, un algoritmo selecciona un recurso del grupo que da soporte a dicho servidor virtual.
El balanceo de carga HTTP permite implementar patrones como el versionado de API, en el que la versión de la API se incluye en el URI (o en una cabecera HTTP personalizada). El balanceador de carga puede distinguir las distintas versiones y garantizar que los clientes se dirijan al servicio de back-end correcto para su ejecución. Esto permite una migración gradual de los clientes cuando no es posible forzar la actualización.
Este tipo de patrón de escalabilidad también admite otros patrones, como la descomposición funcional y el particionamiento de datos. Es el patrón de escalabilidad más sólido y ágil de todos, y ofrece una amplia variedad de opciones a la hora de escalar aplicaciones y, cada vez más, microservicios.
En resumen, contamos con cinco patrones principales de escalabilidad, la mayoría de los cuales pueden combinarse —y, de hecho, suelen combinarse— para aprovechar los recursos de la forma más eficiente y obtener el máximo rendimiento posible. Es muy probable que, si aún no utiliza ninguno de ellos, acabe haciéndolo, por lo que comprender su estructura básica constituye una buena base para crear una arquitectura escalable, independientemente del tipo de aplicaciones que utilice o de dónde las tenga implementadas.
¡A escalar!
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.