Patrones de entrega de aplicaciones para escalar aplicaciones y API
Hoy en día, escalar aplicaciones y API no consiste en elegir el algoritmo de equilibrio de carga adecuado. En las más de dos décadas de evolución de la entrega de aplicaciones, lo único que se ha mantenido bastante constante son los algoritmos de equilibrio de carga. Su principal ventaja es mantener la disponibilidad. Su impacto en el rendimiento es, en el mejor de los casos, mínimo.
Esto no quiere decir que elegir un algoritmo sea irrelevante. Al fin y al cabo, el algoritmo de turno rotatorio rara vez es la mejor opción para una API o aplicación, pero es menos probable que la elección entre menos conexiones y respuesta más rápida influya tanto en el rendimiento general y la disponibilidad de un servicio digital como su arquitectura.
Lo que se ofrece aquí es una perspectiva arquitectónica sobre la entrega de aplicaciones, en respuesta al reconocimiento de esta como una de las seis capacidades clave necesarias para diseñar y operar servicios digitales.
¿Qué es un algoritmo de balanceo de carga?
Un algoritmo de balanceo de carga es un método programático para distribuir la carga entre un conjunto de recursos con el fin de garantizar la disponibilidad y mejorar el rendimiento.
Un algoritmo de balanceo de carga especifica cómo se eligen determinados recursos y qué variables se tienen en cuenta.
Round Robin es el algoritmo más sencillo y se limita a recorrer secuencialmente un conjunto conocido de recursos. Si hay tres recursos —A, B y C—, Round Robin dirige la primera solicitud a A, la segunda a B y la tercera a C. A continuación, el proceso de selección vuelve a empezar.
Menor número de conexiones es un algoritmo basado en el segundo axioma operativo, que establece que «a medida que aumenta la carga, disminuye el rendimiento». Por tanto, el algoritmo de menor número de conexiones elegirá el recurso con el menor número de conexiones (carga). Existen variantes de este algoritmo, entre las que destaca el de menor número de conexiones ponderado, que permite tener en cuenta las diferencias de capacidad entre los recursos.
El tiempo de respuesta más rápido se utiliza cuando el rendimiento es la máxima prioridad. El balanceador de carga determinará, de forma pasiva o activa, el tiempo de respuesta de cada recurso y elegirá el más rápido para cada solicitud. Este algoritmo no garantiza el tiempo de respuesta del usuario, ya que no influye en el último tramo ni en las condiciones de la red del usuario.
IP de origen es un algoritmo heredado del balanceo de carga de red que utiliza un valor hash simple de la IP de origen (cliente) para elegir un recurso. Este algoritmo siempre seleccionará el mismo recurso para una IP de origen determinada. Este algoritmo cayó en desuso porque está sujeto al problema del «megaproxy», por el que todos los usuarios procedentes de un único proxy o dirección IP son dirigidos al mismo recurso. Esto tiende a sobrecargar el recurso de destino, lo que provoca un rendimiento deficiente y, en última instancia, un fallo.
Los algoritmos de balanceo de carga son una parte importante de la arquitectura de entrega de aplicaciones, pero tienen un impacto menor en el rendimiento y la escalabilidad de una aplicación o servicio digital que el enfoque arquitectónico general.
¿Qué es la entrega de aplicaciones?
La entrega de aplicaciones es la disciplina que consiste en diseñar una arquitectura escalable y de alto rendimiento para aplicaciones, API y servicios digitales. Se basa en gran medida en el balanceo de carga como componente principal, pero incorpora funcionalidades modernas, como el enrutamiento de capa 7, y aprovecha patrones arquitectónicos comunes para optimizar el rendimiento y el uso eficiente de los recursos.
Utilizamos el término «entrega de aplicaciones» para distinguir deliberadamente entre el balanceo de carga, que es un detalle de implementación, y la arquitectura, que es un proceso de diseño.
¿Por qué escalamos?
El escalado es una respuesta técnica a un objetivo empresarial. En concreto, responde a la necesidad de mantener la disponibilidad y el rendimiento de las cargas de trabajo que componen un servicio digital para mejorar los índices de satisfacción del cliente, las tasas de conversión y la generación de ingresos. Esta última parte es especialmente importante, ya que nuestra investigación indica que la mayoría de las empresas (el 58 %) obtiene actualmente al menos la mitad de sus ingresos de los servicios digitales.
Consideremos también, por ejemplo, el uso de la nube pública para garantizar la continuidad del negocio (BC). La BC es uno de los principales usos de la nube pública y, en esencia, consiste en una implementación a escala global, es decir, en el balanceo de carga global. La conmutación por error es una funcionalidad esencial de la entrega de aplicaciones que, cuando se aplica a un sitio completo, permite redirigir rápidamente las solicitudes de una ubicación a otra. La disponibilidad continua de la presencia digital de una empresa es un resultado de negocio que se consigue mediante una respuesta técnica.
¿Cómo escalamos?
Responder a esta pregunta marca el inicio de nuestro recorrido técnico por la arquitectura de entrega de aplicaciones. Existen dos modelos de escalado: vertical (hacia arriba) y horizontal (hacia fuera).
El escalado vertical se basa en el principio de que añadir más potencia de procesamiento a un sistema aumentará su capacidad. Este método de escalado beneficia principalmente a las aplicaciones monolíticas y a los sistemas autónomos. Aparte de en la infraestructura, la mayoría de las organizaciones ya no recurren al escalado vertical porque requiere modificar el entorno físico: añadir CPU o RAM, o ampliar la capacidad de la red. Aunque la virtualización agiliza considerablemente el escalado vertical, especialmente en entornos de nube pública, la necesidad de migrar el software y los sistemas —incluso a una nueva máquina virtual— puede causar interrupciones.
El escalado horizontal es un enfoque arquitectónico que permite aumentar la capacidad de procesamiento incrementando el total de recursos disponibles. Esto se consigue distribuyendo la capacidad de procesamiento entre varias instancias de una aplicación, servicio o sistema. Actualmente, es el método de escalado más habitual, ya que se basa en duplicar los recursos en lugar de migrarlos. Además, el escalado horizontal ofrece una mayor variedad de opciones arquitectónicas que el escalado vertical, por lo que resulta más adecuado para todo tipo de aplicaciones y API.
Por tanto, no debería sorprender que los patrones modernos de entrega de aplicaciones se basen en el principio del escalado horizontal.
Patrones de entrega de aplicaciones
Elegir simplemente el escalado horizontal no pone fin al debate.
Una vez tomada la decisión (por lo general, es la opción predeterminada), deben tenerse en cuenta otros aspectos a la hora de decidir la arquitectura de la implementación. La forma más sencilla de abordar esta decisión es desde la perspectiva de el cubo de escalabilidad descrito en el libro The Art of Scalability.
En pocas palabras, el cubo de escalabilidad tiene tres ejes: x, y y z. Cada uno se corresponde con un patrón arquitectónico de equilibrio de carga. Cada uno de estos patrones es adecuado para alcanzar objetivos específicos de rendimiento y disponibilidad en función de los distintos tipos de aplicaciones y API.
Es probable que un servicio digital utilice una arquitectura que incorpore varios patrones para optimizar al mismo tiempo el rendimiento y el consumo de recursos. Este enfoque requiere un pensamiento sistémico, ya que debe tener en cuenta todos los componentes, cómo interactuarán y cómo fluirán las solicitudes del usuario a la aplicación y viceversa.
Escala del eje X
El patrón del eje X es el más básico. Se basa en la duplicación horizontal y la mayor parte del trabajo se lleva a cabo mediante un algoritmo de equilibrio de carga. Es el patrón más sencillo y da lugar a lo que denomino equilibrio de carga tradicional (POLB, por sus siglas en inglés).
Lo llamamos así por la simplicidad de la arquitectura, que no aprovecha las capacidades avanzadas de los balanceadores de carga modernos para interactuar con las solicitudes y respuestas en la capa de aplicación.
En este patrón, las aplicaciones se duplican y las solicitudes se reenvían a una instancia según la decisión del algoritmo de equilibrio de carga configurado.
Dado que este patrón suele utilizarse junto con TCP (capa 4), ofrece ventajas de rendimiento frente a otros patrones que dependen de la inspección de HTTP (capa 7). Principalmente, las conexiones pueden enlazarse entre sí en lugar de pasar por un proxy, lo que convierte de hecho al equilibrador de carga en un salto de red tras la conexión inicial. Esto se traduce en un mayor rendimiento general, pero impide que el equilibrador de carga inspeccione o actúe sobre las solicitudes y respuestas después de la conexión inicial. Dado que las arquitecturas de eje X destacan por garantizar la disponibilidad y pueden ofrecer un rendimiento muy elevado, suelen utilizarse para escalar servicios de infraestructura y seguridad, como cortafuegos y puertas de enlace de aplicaciones.
Diversas aplicaciones tradicionales (monolíticas, web de tres niveles y cliente-servidor) suelen escalarse mediante este patrón, ya que rara vez se descomponen en componentes más independientes que puedan aprovecharse en arquitecturas modernas de entrega de aplicaciones.
Escalado en el eje Y
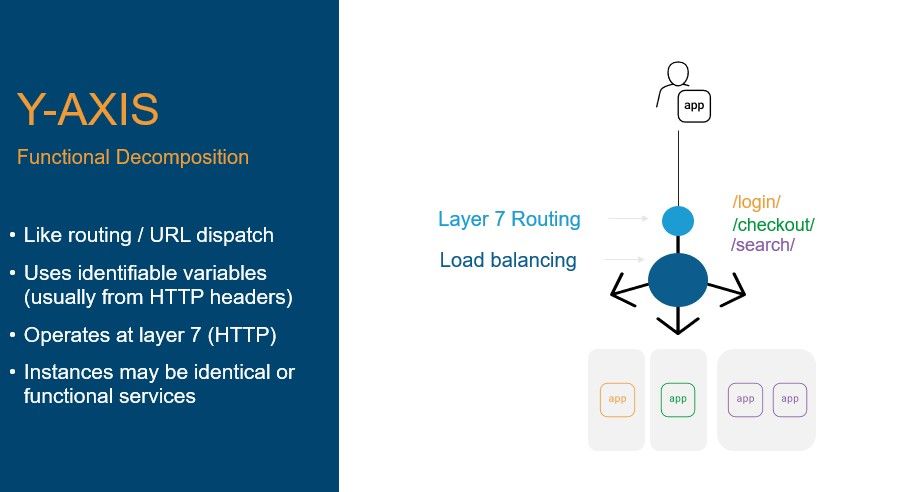
Este patrón se basa en la descomposición funcional y aprovecha las capacidades de la capa de aplicación (capa 7) de la entrega de aplicaciones para escalar en función de las funcionalidades, en lugar de sistemas completos. El patrón del eje Y es el primero en el que el enrutamiento de capa 7 se convierte en una herramienta clave del conjunto de recursos de la arquitectura de entrega de aplicaciones.
En general, los patrones basados en los ejes Y y Z aprovechan el enrutamiento de capa 7 para elegir un grupo de recursos y, a continuación, utilizan un algoritmo de equilibrio de carga para seleccionar un recurso específico. Esto difiere del patrón básico basado en el eje X, en el que no se utiliza el enrutamiento de capa 7.
Este patrón presupone que se opera en la capa 7, normalmente mediante HTTP, y utiliza alguna variable para distribuir el tráfico entre instancias específicas de una aplicación o servicio. Por ejemplo, si se encuentra el patrón /login en el URI, el equilibrador de carga elegirá una instancia, según el algoritmo de equilibrio de carga configurado, de un grupo de instancias de la aplicación que solo gestionan solicitudes de inicio de sesión. La variable puede ser cualquier elemento del encabezado o del contenido de la solicitud. Esto permite el enrutamiento basado en agentes, en API y en contenido (imágenes, scripts, etc.).
Las instancias de una aplicación pueden ser clones. Esto suele ocurrir cuando existe una disparidad en el uso de una aplicación que puede identificarse mediante una variable de la solicitud. Por ejemplo, las funciones de inicio de sesión y pago pueden distinguirse en una solicitud a partir del URI, de un valor del encabezado HTTP o de un valor de la carga útil de la solicitud. La aplicación de un patrón de eje Y permite que las aplicaciones tradicionales escalen en función de la función, lo que mejora la eficiencia en el uso de los recursos, ya que se pueden asignar más recursos a las funciones con un gran volumen de solicitudes, al tiempo que se mantiene el rendimiento esperado de las demás funciones.
El uso del patrón del eje Y para escalar funcionalmente las aplicaciones tradicionales surgió antes de la generalización de los microservicios, que hoy en día descomponen funcionalmente las aplicaciones. El patrón del eje Y sigue siendo aplicable a los microservicios y, de hecho, actualmente lo implementan los controladores de entrada. Los lectores más perspicaces observarán que este patrón también es aplicable a las API, dado que se basan en elementos de HTTP (capa 7), por lo que no sorprende que las puertas de enlace de API aprovechen este patrón fundamental.
Este patrón fue popularizado por eBay en los primeros tiempos de la Web 2.0. Su arquitectura de escalabilidad incluía entonces la segmentación de funciones en grupos de aplicaciones independientes. Un conjunto de servidores de aplicaciones se encargaba de las funciones de venta; otro, de las pujas; y otro, de las búsquedas. En total, organizaron aproximadamente 16.000 servidores de aplicaciones en 220 grupos diferentes. Esto les permitía escalar cada grupo de forma independiente, según las necesidades y el consumo de recursos de su función. Además, les permitía aislar y racionalizar las dependencias de recursos; por ejemplo, el grupo de ventas solo necesitaba comunicarse con un subconjunto relativamente pequeño de recursos de backend.
El patrón del eje Y también puede utilizarse para distribuir las solicitudes de distintos tipos de contenido, como las imágenes, entre un grupo de recursos y otros tipos de contenido entre otros grupos.
El uso del eje Y para distribuir la carga permite escalar individualmente los componentes de un servicio digital, lo que resulta mucho más eficiente en cuanto al uso de recursos que un patrón basado en el eje X. Además, permite optimizar la configuración en la capa de servicio o de aplicación para mejorar su rendimiento mediante el ajuste de variables específicas en el servidor web o de aplicaciones en función de un tipo de contenido determinado.
Escalado en el eje Z
El patrón del eje Z se popularizó por pura necesidad ante el crecimiento explosivo de las redes sociales y de Internet en general. En esencia, es un patrón de escalado en el eje Y al que se aplica una segmentación adicional, normalmente basada en una variable específica, como el nombre de usuario o el identificador de un dispositivo.
Este patrón permite diferenciar la arquitectura mediante una técnica derivada del particionamiento de datos.
“Un fragmento de base de datos, o simplemente fragmento, es una partición horizontal de los datos de una base de datos o un motor de búsqueda. Cada fragmento se aloja en una instancia independiente del servidor de base de datos para distribuir la carga. Algunos datos de una base de datos están presentes en todos los fragmentos, mientras que otros solo aparecen en uno de ellos.”
Wikipedia1
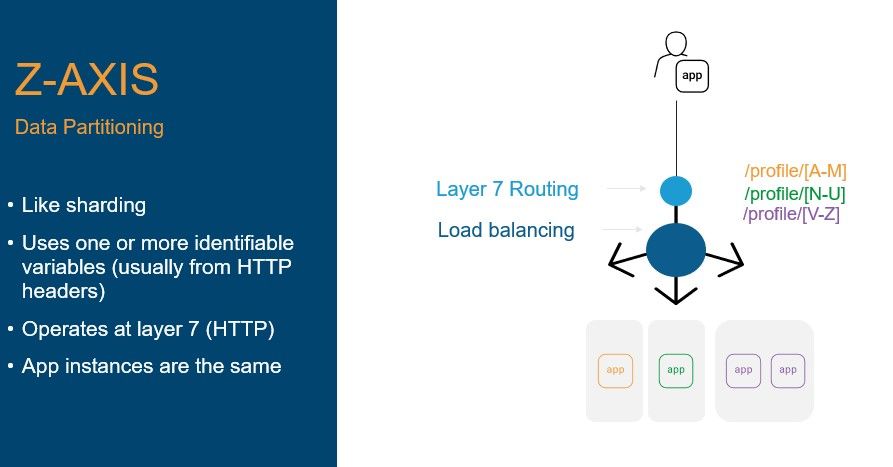
Este patrón aplica los principios utilizados en las bases de datos para distribuir las solicitudes en función de algún dato incluido en ellas. Puede ayudar a resolver cuellos de botella en la capa de datos, así como a garantizar el cumplimiento de las normas de soberanía de los datos. Utiliza una variable identificable —y normalmente única— para dirigir las solicitudes a un conjunto de recursos escalado horizontalmente. Este patrón suele utilizarse cuando se necesita un alto rendimiento, por ejemplo, para gestionar un volumen considerable de solicitudes de un servicio o una aplicación específicos.
El patrón del eje Z resulta especialmente útil para gestionar dispositivos perimetrales y del IoT, que pueden llegar a contarse por millones. Al utilizar los identificadores de los dispositivos como patrón base para fragmentar las solicitudes, se puede mejorar considerablemente la velocidad de transferencia de los datos. Esto puede resultar especialmente útil para los dispositivos que almacenan su configuración en una ubicación remota (en la nube o en un centro de datos), ya que estos datos son exclusivos de cada dispositivo y se pueden fragmentar de forma segura.
Este patrón suele mejorar el rendimiento, ya que el acceso a los datos con cargas elevadas puede degradarlo considerablemente. Por tanto, al distribuir el acceso a los datos entre más instancias, la carga disminuye y, con ella, mejora el rendimiento. Esto exige prestar especial atención a la integridad de los datos y puede provocar problemas de coherencia cuando se utiliza para fragmentar datos compartidos. Meta dio mayor relevancia a la fragmentación cuando desarrolló la fragmentación de servicios como parte de su arquitectura general. La especial atención que prestó al desarrollo de una arquitectura de entrega de aplicaciones escalable y de alto rendimiento constituye un excelente ejemplo de las importantes ventajas que puede aportar el reconocimiento de la entrega de aplicaciones como una capa formal dentro de una arquitectura más amplia.
En el caso de los servicios que acceden a fuentes de datos no primarias, un patrón de eje z puede mejorar el rendimiento sin afectar significativamente a la calidad de los datos en todo el sistema. Este enfoque evita tener que añadir código para vincular una instancia específica de una aplicación o API a una fuente de datos. En su lugar, se basa en la combinación de la configuración de los conectores de datos a nivel de instancia y el enrutamiento de la entrega de aplicaciones para garantizar que se utilice la fuente de datos adecuada.
El secreto para escalar está en la arquitectura de entrega de aplicaciones
Hoy en día, en un mundo en el que se prestan servicios digitales, no es habitual utilizar un único patrón de entrega de aplicaciones para diseñar un servicio digital fiable y de alto rendimiento. Esto se debe a la complejidad inherente de los servicios digitales y a la creciente diversidad de los «usuarios», que pueden ser dispositivos, personas o software.
Por tanto, un enfoque arquitectónico tiene en cuenta el uso más adecuado de los distintos patrones de entrega de aplicaciones en todo un servicio digital para ofrecer una experiencia óptima a los usuarios.
No existe una solución arquitectónica «correcta» o «incorrecta», ya que depende en gran medida de los servicios y las aplicaciones que componen un servicio digital, salvo que dicha solución no debe basarse únicamente en algoritmos de equilibrio de carga.
De hecho, cabe señalar que no se ha mencionado la selección de algoritmos, ya que elegir cómo se distribuye la carga dentro de un patrón de equilibrio de carga no es tan relevante como tomar la decisión arquitectónica adecuada para una aplicación o API específica.
Este es uno de los factores que impulsan la entrega de aplicaciones como disciplina. La forma en que se utilizan e implementan actualmente la entrega y la seguridad de aplicaciones va mucho más allá del simple escalado de un servidor web. Su implementación puede afectar al rendimiento y la disponibilidad y, en última instancia, determinar el éxito o el fracaso de los resultados empresariales. Por ello, es importante que las organizaciones consideren la entrega de aplicaciones una herramienta estratégica y arquitectónica dentro de su conjunto de recursos de diseño.
El balanceo de carga sigue siendo el principal requisito técnico para poder escalar. Comprender los patrones de entrega de aplicaciones y cómo aprovechan el balanceo de carga permitirá adoptar una mejor perspectiva a la hora de diseñar la arquitectura para garantizar la escalabilidad y el rendimiento de los servicios digitales, especialmente cuando es probable que estos servicios sean híbridos y combinen API con aplicaciones tanto modernas como tradicionales.
NOTA AL PIE