À l’ère actuelle de l’IA, les données sont le moteur indispensable à l’entraînement, à l’ajustement et à l’inférence de modèles complexes. Cependant, l’ingestion de volumes considérables de données stockées dans des environnements S3 présente souvent des difficultés majeures. Les entreprises doivent faire face à un afflux incessant de données réparties entre plusieurs emplacements et niveaux de performance, ce qui crée des goulets d’étranglement, réduit l’efficacité globale de l’entraînement et freine l’innovation. Sans une stratégie robuste d’ingestion des données, même les systèmes d’IA les plus sophistiqués risquent de subir des retards dus à une ingestion inefficace, ce qui nuit en définitive au délai d’obtention des informations exploitables et au positionnement concurrentiel.
Les défis spécifiques liés à la gestion des données d’IA ne tiennent pas uniquement au volume de données, mais aussi à la nécessité de garantir un accès fluide, une réplication à haut débit et un équilibrage de charge homogène dans des environnements d’infrastructure variés. Les approches existantes peuvent montrer leurs limites face à des déploiements multizones et multiclusters, ou lorsqu’il s’agit de concilier un stockage économique avec des exigences de hautes performances. Les équipes opérationnelles se voient alors contraintes de choisir entre économies et performances — un compromis intenable lorsque le transfert rapide et fiable des données est essentiel aux workflows d’IA.
Qu’est-ce que l’entraînement d’un modèle d’IA ?
L’entraînement des modèles d’IA consiste à apprendre aux algorithmes à reconnaître des schémas et à prendre des décisions en les exposant à des jeux de données rigoureusement sélectionnés. Il repose sur un processus d’amélioration itératif au cours duquel les modèles apprennent à partir des données, ajustent leurs paramètres internes et gagnent en précision prédictive. Cette approche rigoureuse transforme les données brutes en informations exploitables, ouvrant la voie à une prise de décision avancée et à des innovations transformatrices.
Renforcer votre pipeline d’entraînement de l’IA
F5 BIG-IP Local Traffic Manager (LTM) et F5 BIG-IP DNS relèvent ces défis en renforçant les pipelines d’entraînement de l’IA grâce à un équilibrage de charge avancé et à des fonctionnalités de réplication des données qui garantissent un accès rapide et résilient aux données stockées sur S3. En répliquant les jeux de données depuis des systèmes de stockage moins coûteux vers des configurations hautes performances de niveau 1, F5 permet aux entreprises d’optimiser leurs coûts tout en accélérant l’entraînement des modèles d’IA. Cette solution réduit le risque de goulets d’étranglement dans le traitement des données et garantit que chaque octet est acheminé avec la précision requise pour les entraînements itératifs et l’inférence, améliorant ainsi considérablement le débit opérationnel global.
Haute fiabilité, intégration transparente
Au cœur de l’offre de F5 se trouve un engagement en faveur d’une fiabilité à toute épreuve, grâce à une intégration transparente avec les principaux fournisseurs de solutions de stockage et les plateformes d’orchestration natives de Kubernetes. BIG-IP LTM et BIG-IP DNS s’appuient sur une mise en réseau accélérée par le matériel pour gérer efficacement les besoins en haut débit et mettre en œuvre des stratégies de réplication dynamique, en s’adaptant de manière transparente à l’évolution des exigences des infrastructures d’IA. Ces fonctionnalités reposent sur F5 rSeries et F5 VELOS, des équipements spécialement conçus pour offrir une évolutivité hautes performances. Ces fonctionnalités garantissent des performances constantes pour les déploiements multirégions et multizones, permettant ainsi aux pipelines d’IA complexes de fonctionner sans interruption. En harmonisant divers écosystèmes de stockage au sein d’un cadre orchestré unique, F5 crée une infrastructure aussi polyvalente que puissante.
La sécurité et l’évolutivité au premier plan
Au-delà des performances et de l’intégration, la sécurité et l’évolutivité font partie intégrante des solutions d’équilibrage de charge et de réplication S3. Des mécanismes de sécurité avancés protègent les données en transit et au repos, un aspect essentiel pour les organisations tenues de respecter des normes réglementaires strictes. Grâce à une prise en charge adaptée aux équipes NetOps, MLOps et DevOps, F5 BIG-IP Advanced Firewall Manager (AFM) offre non seulement des performances robustes, mais garantit également que les données utilisées pour l’entraînement et l’ajustement des modèles d’IA restent sécurisées et conformes. Cette approche globale répond aux complexités de la gestion des infrastructures d’IA en associant des fonctionnalités de sécurité de pointe à des solutions évolutives qui s’adaptent à la croissance des besoins de l’organisation.
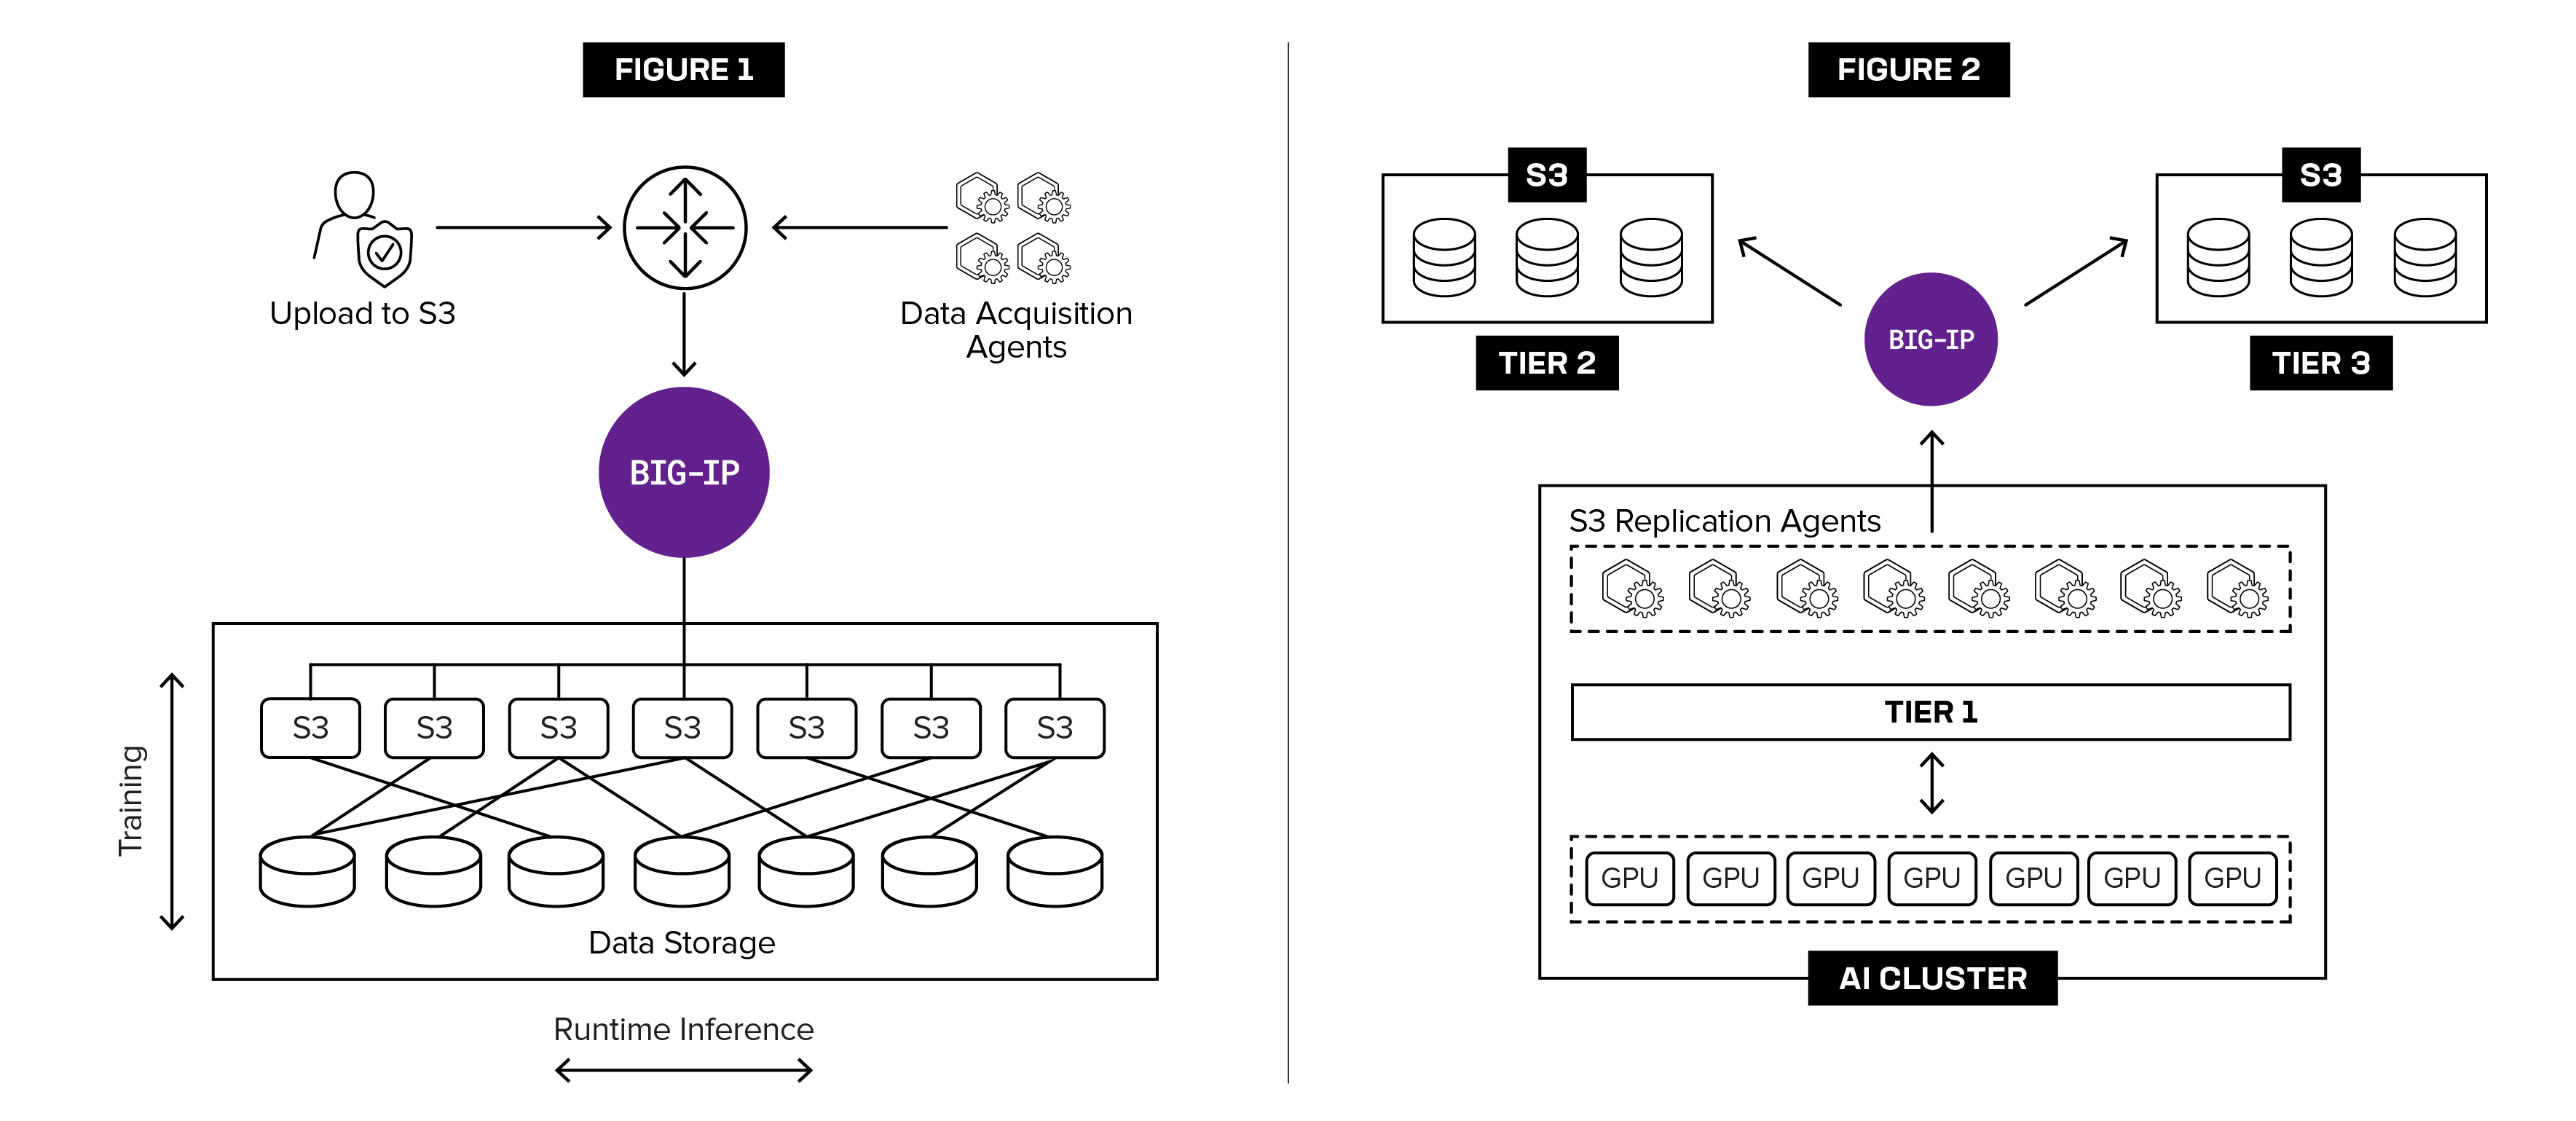
Figure 1 : Activez un équilibrage de charge sécurisé, résilient et hautement performant afin d’acheminer de manière optimale les données d’IA entre les systèmes, tout en garantissant un traitement rapide et une disponibilité continue pour l’ingestion des données d’IA dans les déploiements de stockage S3.
Figure 2 : La réplication depuis une infrastructure de niveau 1 hautes performances vers des référentiels de stockage de niveaux 2 et 3, plus économiques mais moins performants, est généralement orchestrée via le protocole S3 afin de préserver à la fois l’évolutivité et les performances.
Maximiser le retour sur investissement et se préparer aux charges de travail d’IA de demain
Grâce à l’équilibrage de charge avancé et à la réplication des données, l’intégration de S3 et de BIG-IP offre une solution complète aux défis urgents liés à la gestion des données d’IA. Les clients peuvent optimiser les vitesses d’accès aux données et appliquer facilement des pratiques de sécurité robustes dans des environnements intégrés et hétérogènes, afin de maximiser leur retour sur investissement tout en préparant leurs infrastructures d’IA pour l’avenir. Alors que l’infrastructure d’IA continue d’évoluer, F5 reste à l’avant-garde en veillant à ce que les pipelines de données demeurent agiles, fiables et sécurisés, prêts à alimenter la prochaine vague d’innovations en matière d’IA.
Pour découvrir comment F5 BIG-IP LTM, BIG-IP DNS, BIG-IP AFM et les systèmes matériels F5 peuvent répondre à vos besoins d’ingestion et de réplication de données S3 pour l’entraînement et l’ajustement de modèles d’IA, contactez-nous afin d’échanger avec votre équipe de compte F5, ou téléchargez notre présentation de la solution.
L’engagement de F5 en faveur de l’IA ne s’arrête pas là : découvrez comment F5 sécurise et déploie les applications d’IA partout.
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.