Tout comme des bilans de santé réguliers chez le médecin sont essentiels pour rester en bonne santé, des contrôles réguliers de l’état de vos applications sont indispensables pour garantir des performances fiables. Lorsqu’il assure les fonctions de proxy inverse et de répartition de charge du trafic, NGINX utilise des contrôles d’état passifs pour protéger les utilisateurs de vos applications contre les interruptions de service en redirigeant automatiquement le trafic vers d’autres serveurs lorsque certains ne répondent pas aux requêtes. NGINX Plus y ajoute des contrôles d’état actifs, qui envoient des sondes spécifiques capables de détecter les serveurs défaillants avant même qu’ils ne parviennent plus à traiter une requête. Quel type de contrôle d’état convient à vos applications ? Dans cet article, nous vous donnons les informations nécessaires pour faire ce choix.
Qu’est-ce qu’un contrôle d’état ?
Dans sa définition la plus simple, un contrôle d’intégrité est une méthode permettant de déterminer si un serveur est en mesure de traiter le trafic. NGINX utilise des contrôles d’intégrité pour surveiller les serveurs pour lesquels il assure les fonctions de proxy inverse ou d’équilibrage de charge, qu’il appelle des serveurs en amont.
Contrôles d’état passifs
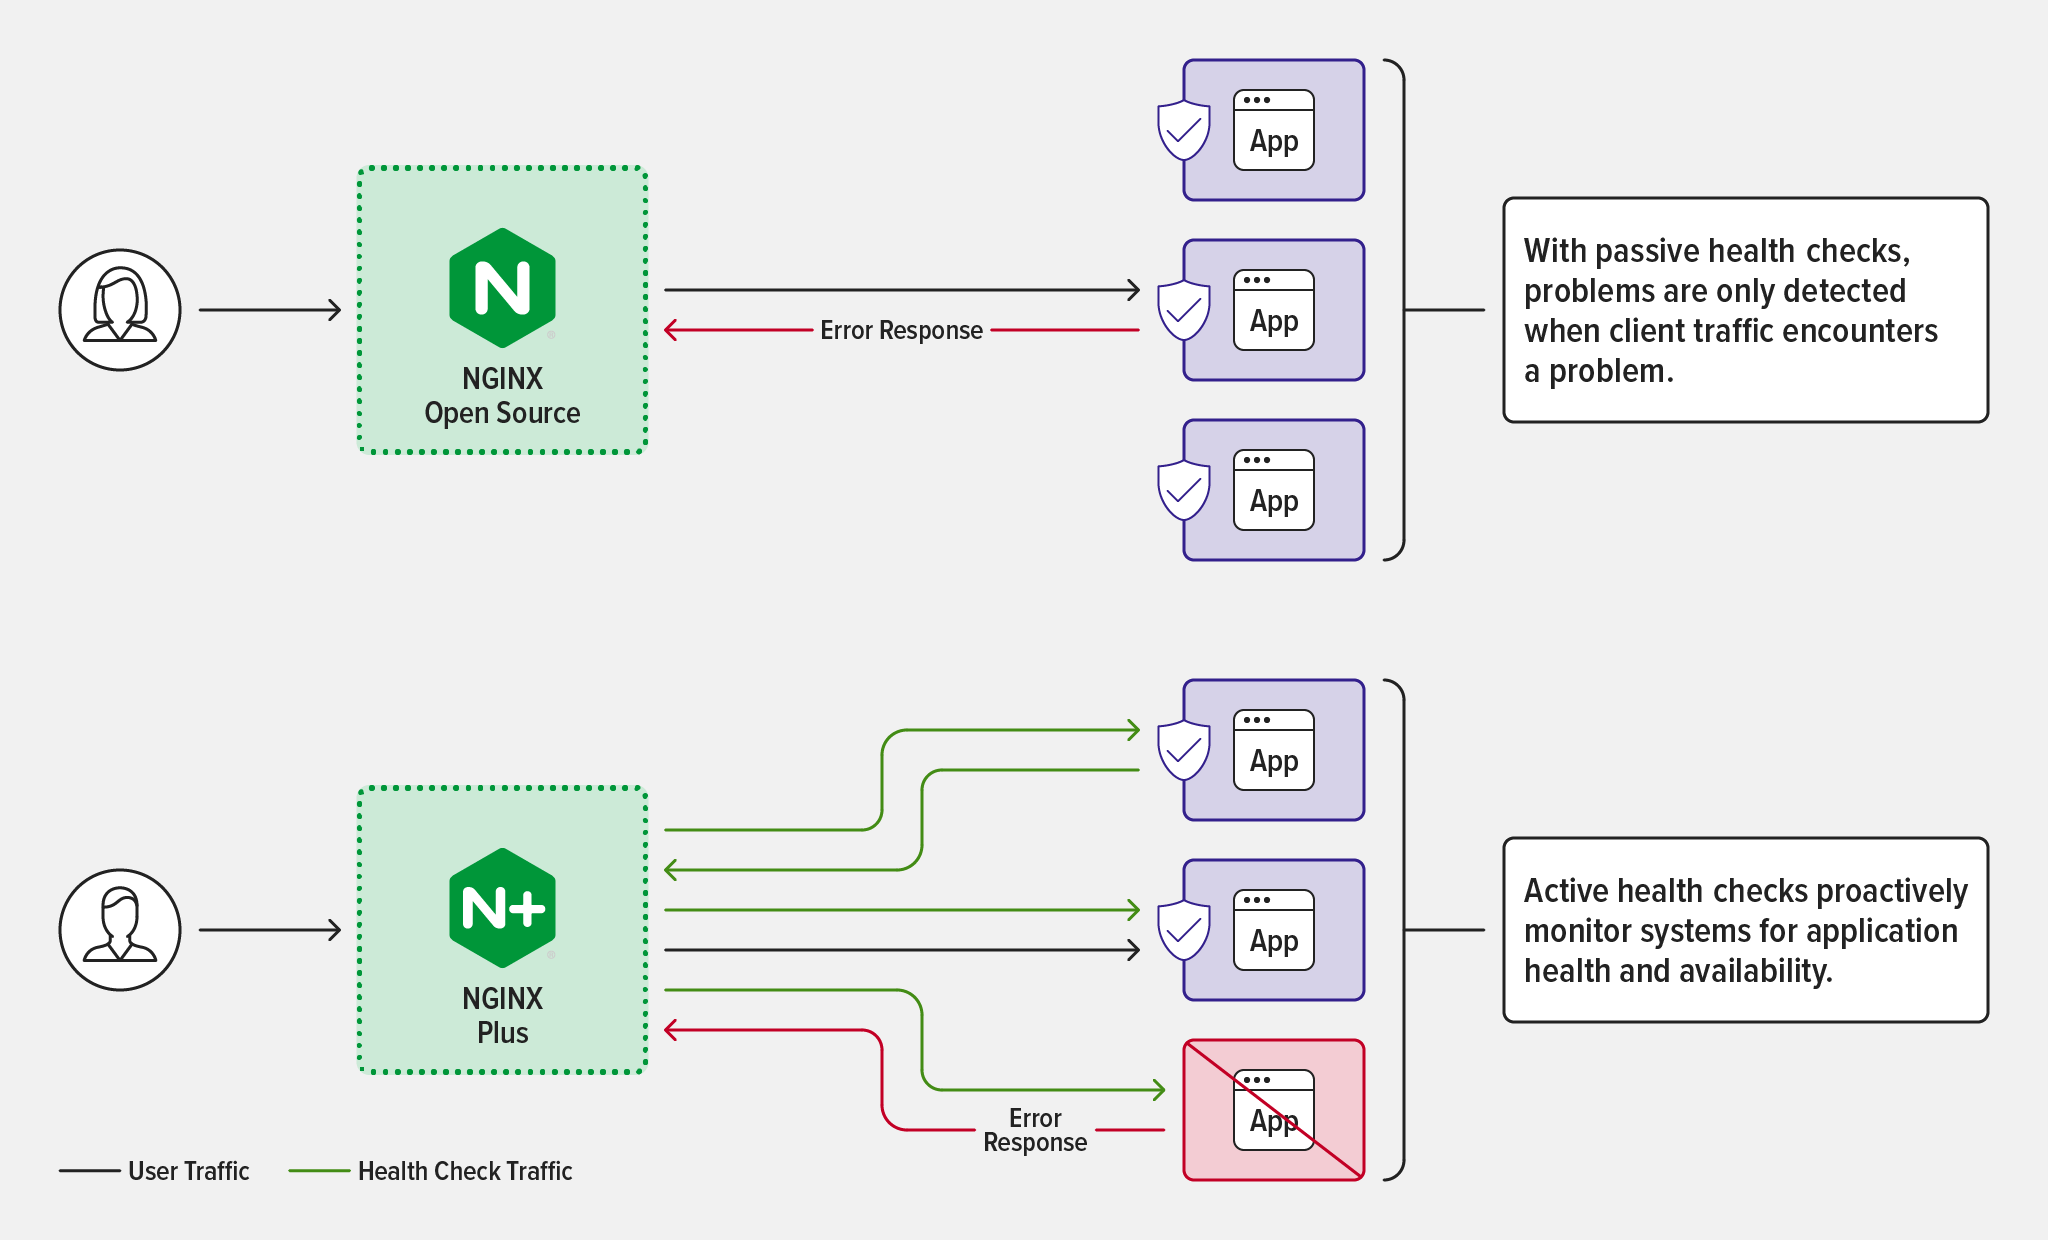
Les contrôles d’état passifs – disponibles dans NGINX Open Source et NGINX Plus – reposent sur l’observation du comportement du serveur lorsqu’il traite les connexions et le trafic. Ils permettent d’éviter aux utilisateurs de subir des interruptions dues à des dépassements de délai d’attente du serveur : lorsque NGINX détecte qu’un serveur est défaillant, il transmet immédiatement la requête à un autre serveur, cesse d’envoyer des requêtes au serveur défaillant et répartit les requêtes suivantes entre les serveurs encore opérationnels du groupe de serveurs en amont.
Notez que les contrôles d’état passifs ne sont efficaces que lorsque le groupe de serveurs en amont est configuré pour comporter plusieurs membres. Lorsqu’un seul serveur en amont est défini, il n’est jamais marqué comme indisponible et les utilisateurs subissent une interruption de service lorsqu’il est défaillant.
Fonctionnement des contrôles de santé passifs
Voici une présentation détaillée du fonctionnement des contrôles de santé passifs. Vous pouvez toutefois passer directement à la section Contrôles de santé actifs si cela ne vous intéresse pas.
Par défaut, NGINX considère qu’un serveur TCP/UDP (stream) est défaillant dès qu’une erreur ou un dépassement de délai survient lors de l’établissement d’une connexion avec celui-ci.
NGINX considère qu’un serveur HTTP est défaillant si une seule erreur ou expiration du délai d’attente se produit lors de l’établissement d’une connexion avec celui-ci, de la transmission d’une requête ou de la lecture de l’en-tête de réponse (l’absence totale de réponse est considérée comme une erreur de ce type). Vous pouvez utiliser la directive proxy_next_upstream pour personnaliser ces conditions pour le proxy HTTP, et il existe une directive équivalente pour les protocoles FastCGI, gRPC, memcached, SCGI, TCP/UDP et uwsgi.
Pour HTTP comme pour TCP/UDP, NGINX attend par défaut dix secondes avant de tenter à nouveau de se connecter à un serveur défaillant et de lui envoyer une requête. Vous pouvez utiliser le paramètre fail_timeout de la directive server[HTTP][Stream] pour modifier ce délai.
Vous pouvez utiliser le paramètre max_fails de la directive server pour augmenter le nombre d’erreurs ou de dépassements de délai nécessaires pour que NGINX considère le serveur comme défaillant ; dans ce cas, le paramètre fail_timeout définit la période au cours de laquelle ce nombre d’erreurs ou de dépassements de délai doit survenir, ainsi que le délai d’attente de NGINX avant de réessayer de contacter le serveur après l’avoir marqué comme défaillant.
Contrôles d’état actifs
Les contrôles d’état actifs, disponibles exclusivement dans NGINX Plus, sont des requêtes spécifiques envoyées régulièrement aux points de terminaison des applications pour vérifier qu’ils répondent correctement. Ils sont distincts des contrôles d’état passifs et viennent les compléter. Par exemple, NGINX Plus peut envoyer périodiquement une requête HTTP au serveur web de l’application pour s’assurer qu’il renvoie un code de réponse valide et le contenu attendu. Les contrôles d’état actifs permettent de surveiller en continu l’état de composants et de processus spécifiques de l’application. Ils constituent une mesure directe de la disponibilité de l’application, dont la pertinence dépend toutefois de la représentativité du contrôle d’état choisi par rapport à l’état global de l’application.
Vous pouvez personnaliser de nombreux aspects d’un contrôle d’intégrité actif ; consultez Cas d’utilisation des contrôles d’intégrité actifs.
Cas d’utilisation des contrôles d’intégrité passifs
Les contrôles d’état passifs sont indispensables. Il est recommandé à toutes les équipes de développement d’applications, DevOps, DevSecOps et d’exploitation des plateformes d’intégrer des contrôles d’état passifs à leur programme de surveillance de l’infrastructure de production. NGINX effectue par défaut des contrôles d’état passifs sur le trafic soumis à la répartition de charge, y compris dans les configurations HTTP, TCP et UDP.
Les avantages des contrôles d’état passifs sont notamment les suivants :
- Disponible dans NGINX Open Source
- Activé par défaut pour les serveurs inclus dans un bloc de configuration
upstream{}configuration block - Aucune charge supplémentaire sur les serveurs en amont
- Configurable selon le nombre minimal d’échecs sur une période donnée, comme décrit dans Fonctionnement des contrôles d’état passifs
- Configurable slow start (exclusive to NGINX Plus) – when a server returns to health, NGINX Plus gradually ramps up the amount of traffic forwarded to it, to give it time to “warm up”
Les avantages de NGINX Open Source sont son coût (nul, évidemment), ses possibilités de configuration et sa vaste bibliothèque de modules tiers. Le code source étant disponible, les développeurs peuvent modifier et étendre ses fonctionnalités pour répondre à leurs besoins spécifiques.
Pour de nombreuses applications (et leurs développeurs), les contrôles d’état passifs suffisent. Par exemple, les contrôles d’état actifs peuvent être superflus pour les microservices qui ne sont pas directement accessibles aux clients et qui exécutent des tâches de moindre envergure. De même, ils ne sont pas forcément nécessaires pour les applications dont la mise en cache peut réduire les risques de latence ou dont certaines tâches peuvent être prises en charge par des réseaux de diffusion de contenu (CDN). En résumé, les contrôles d’état passifs seuls sont particulièrement adaptés aux cas suivants :
- Surveillance du trafic HTTP
- Surveillance de l’infrastructure séparément des applications
- Surveillance des applications pour lesquelles la latence est acceptable
- Surveillance des applications internes pour lesquelles des performances élevées ne sont pas essentielles
Cas d’utilisation des contrôles d’intégrité actifs
Pour les applications stratégiques, les contrôles d’état actifs sont souvent indispensables, car les problèmes ont une incidence directe sur les clients et les processus clés. Il est essentiel de tester ces applications dans des conditions aussi proches que possible de leur utilisation par les clients ou les utilisateurs, ce qui nécessite des contrôles d’état actifs. Ces contrôles s’apparentent aux outils de surveillance des performances applicatives tels que New Relic et AppDynamics, qui effectuent des vérifications en dehors du trafic normal pour mesurer la latence et les réponses des applications. Pour les contrôles d’état actifs, NGINX Plus propose plusieurs fonctionnalités et capacités qui ne sont pas disponibles dans NGINX Open Source :
- Contrôles d’intégrité hors bande pour vérifier la disponibilité des applications
- Tester les points de terminaison configurés et rechercher des réponses spécifiques
- Tester des ports autres que ceux qui gèrent le trafic réel de l’application
- Maintenir les connexions HTTP ouvertes pour les contrôles d’état, afin d’éviter d’établir une nouvelle connexion à chaque contrôle
- Un meilleur contrôle des conditions d’échec et de réussite
- Tester, si nécessaire, les serveurs nouvellement ajoutés avant qu’ils ne reçoivent du trafic applicatif réel
Grâce aux contrôles d’état actifs, les développeurs peuvent configurer NGINX Plus pour détecter automatiquement lorsqu’un serveur backend est hors service ou rencontre des problèmes, puis acheminer le trafic vers des serveurs opérationnels jusqu’à la résolution du problème. Les possibilités de configuration plus étendues des contrôles d’état actifs permettent d’effectuer des vérifications plus poussées et de détecter d’éventuels problèmes applicatifs avant qu’ils n’affectent les utilisateurs réels de l’application. Cela permet de réduire les temps d’indisponibilité et d’éviter les interruptions d’accès à l’application pour les utilisateurs.
Comment configurer les contrôles d’état
Les contrôles d’état passifs sont activés par défaut, mais vous pouvez personnaliser leur fréquence ainsi que le nombre d’échecs à partir duquel un service est considéré comme défaillant, comme décrit dans Fonctionnement des contrôles d’état passifs. Pour obtenir des instructions de configuration complètes concernant les contrôles d’état passifs et actifs, consultez notre documentation :
- Vérifications de l’état de santé HTTP
- Contrôles d’intégrité TCP
- Vérifications de l’état de santé UDP
- Vérifications de l’état de santé gRPC
Conclusion : choisissez les contrôles d’état adaptés aux exigences de votre application
Les contrôles d’état sont essentiels pour garantir le bon fonctionnement et la réactivité de toute application en production. Ils constituent le meilleur moyen de détecter les problèmes et de repérer les sources de latence croissante avant qu’elles n’affectent les utilisateurs finaux. Pour de nombreuses applications, les contrôles d’état passifs suffisent.
Pour les applications plus critiques, qui nécessitent une visibilité directe sur le comportement de l’application du point de vue des utilisateurs, les contrôles d’état actifs sont plus adaptés. NGINX Open Source est gratuit et propose des contrôles d’état passifs configurables. NGINX Plus offre des fonctionnalités avancées de contrôle d’état actif ainsi qu’une assistance commerciale.
Vous souhaitez essayer les contrôles d’intégrité actifs avec NGINX Plus ? Commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.