Utilisation de variables pour la gestion des performances des applications
Les variables constituent un aspect important et parfois négligé de la configuration de NGINX. Avec environ 150 variables disponibles, vous pouvez optimiser chaque partie de votre configuration. Dans cet article de blog, nous expliquons comment utiliser les variables NGINX pour le traçage des applications et la gestion des performances applicatives (APM), en nous concentrant sur la détection des goulots d’étranglement qui nuisent aux performances de votre application. Cet article s’applique à la fois à NGINX Open Source et à NGINX Plus. Par souci de concision, nous utiliserons NGINX Plus dans la suite de cet article, sauf lorsqu’il existe une différence entre les deux versions.
L’environnement de mise à disposition des applications
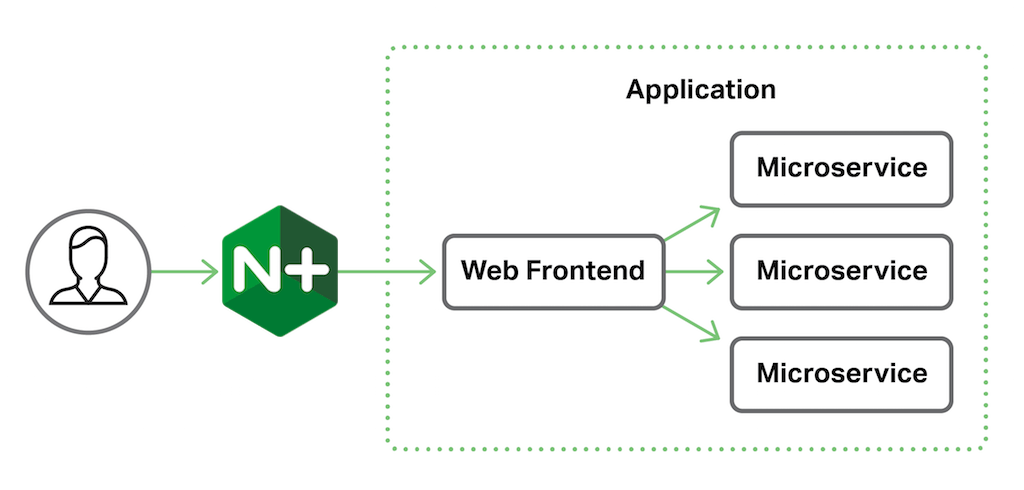
Dans notre exemple d’environnement de mise à disposition d’applications, NGINX Plus fait office de proxy inverse pour notre application. L’application elle-même se compose d’une interface web derrière laquelle se trouvent plusieurs microservices.
Traçage des requêtes de bout en bout
NGINX Plus R10 (et NGINX 1.11.0) introduit la variable « $request_id », une chaîne de 32 caractères hexadécimaux générée aléatoirement et automatiquement attribuée à chaque requête HTTP dès son arrivée (par exemple, 444535f9378a3dfa1b8604bc9e05a303). Ce mécanisme d’une simplicité trompeuse constitue un outil puissant de traçage et de dépannage. En configurant NGINX Plus et tous les services backend pour qu’ils transmettent la valeur « $request_id », vous pouvez suivre chaque requête de bout en bout. Cet exemple de configuration est destiné à notre serveur NGINX Plus frontend.
upstream app_server {    server 10.0.0.1:80;
}

server {
    listen 80;
    add_header X-Request-ID $request_id; # Return to client
    location / {
        proxy_pass http://app_server;
        proxy_set_header X-Request-ID $request_id; # Pass to app server
    }
}
Pour configurer NGINX Plus afin d’assurer le traçage des requêtes, nous commençons par définir l’emplacement réseau du serveur d’applications dans le bloc upstream. Par souci de simplicité, nous ne présentons ici qu’un seul server d’applications, mais nous en utiliserions normalement plusieurs afin d’assurer la haute disponibilité et la répartition de charge.
Le bloc server de l’application définit la manière dont NGINX Plus traite les requêtes HTTP entrantes. La directive listen indique à NGINX Plus d’écouter sur le port 80, le port par défaut pour le trafic HTTP. Toutefois, une configuration de production utilise normalement SSL/TLS pour protéger les données en transit.
La directive « add_header » renvoie la valeur $request_id au client sous la forme d’un en-tête personnalisé dans la réponse. Cela est utile pour les tests, mais aussi pour les applications clientes qui génèrent leurs propres journaux, telles que les applications mobiles, afin de pouvoir faire correspondre précisément une erreur côté client aux journaux du serveur.
Enfin, le bloc « location » s’applique à l’ensemble de l’espace de l’application (/) et la directive « proxy_pass » transmet simplement toutes les requêtes au serveur d’applications. La directive « proxy_set_header » modifie la requête transmise en ajoutant un en-tête HTTP qui est envoyé à l’application. Dans ce cas, nous créons un nouvel en-tête appelé « X-Request-ID » et lui attribuons la valeur de la variable « $request_id ». Notre application reçoit ainsi l’identifiant de requête généré par NGINX Plus.
Journalisation de « $request_id » de bout en bout
Notre objectif, avec le traçage des applications, est d’identifier les goulots d’étranglement des performances dans le cycle de traitement des requêtes, dans le cadre de la gestion des performances applicatives. Pour ce faire, nous journalisons les événements importants survenant pendant le traitement afin de pouvoir les analyser ultérieurement et détecter tout délai inattendu ou anormalement long.
Configuration de NGINX Plus
Nous commençons par configurer le serveur frontal NGINX Plus afin d’inclure $request_id dans un format de journalisation personnalisé, trace, utilisé pour le fichier access_trace.log.
log_format trace '$remote_addr - $remote_user [$time_local] "$request" '                 '$status $body_bytes_sent "$http_referer" "$http_user_agent" '
                 '"$http_x_forwarded_for" $request_id';

upstream app_server {
    server 10.0.0.1;
}

server {
    listen 80;
    add_header X-Request-ID $request_id; # Return to client
    location / {
        proxy_pass http://app_server;
        proxy_set_header X-Request-ID $request_id;        # Pass to app server
        access_log /var/log/nginx/access_trace.log trace; # Log $request_id
    }
}
Configuration de l’application backend
Transmettre l’ID de requête à votre application est une bonne chose, mais cela ne facilite pas réellement le traçage de l’application si celle-ci n’en fait rien. Dans cet exemple, nous avons une application Python gérée par uWSGI. Modifions le point d’entrée de l’application afin de récupérer l’ID de requête comme variable de journalisation.
from uwsgi import set_logvar
def main(environ, start_response):
    set_logvar('requestid', environ['X_REQUEST_ID'])
Nous pouvons ensuite modifier la configuration uWSGI afin d’inclure l’identifiant de requête dans le fichier journal standard.
log-format = %(addr) - %(user) [%(ltime)] "%(method) %(uri) %(proto)" %(status) %(size) "%(referer)" "%(uagent)" %(requestid)Grâce à cette configuration, nous produisons désormais des fichiers journaux qui peuvent être associés à une même requête sur de nombreux systèmes.
Entrée de journal de NGINX :
172.17.0.1 - - [02/Aug/2016:14:26:50 +0000] "GET / HTTP/1.1" 200 90 "-" "-" "-" 5f222ae5938482c32a822dbf15e19f0fEntrée de journal de l’application :
192.168.91.1 - - [02/Aug/2016:14:26:50 +0000] "GET / HTTP/1.0" 200 123 "-" "-" 5f222ae5938482c32a822dbf15e19f0fEn faisant correspondre les transactions aux champs d’identifiant de requête, des outils comme Splunk et Kibana nous permettent d’identifier les goulots d’étranglement qui affectent les performances de votre serveur d’applications. Par exemple, nous pouvons rechercher les requêtes dont le traitement a pris plus de deux secondes. Toutefois, la résolution temporelle par défaut d’une seconde des horodatages classiques est insuffisante pour la plupart des analyses en conditions réelles.
Mesure du temps haute précision
Afin de mesurer avec précision les requêtes de bout en bout, nous avons besoin d’horodatages précis à la milliseconde. En incluant la variable « $msec » dans les entrées de journal, nous obtenons une résolution à la milliseconde pour l’horodatage de chaque entrée. L’ajout d’horodatages à la milliseconde dans le journal de notre application nous permet de rechercher les requêtes dont le traitement a pris plus de 200 millisecondes, plutôt que 2 secondes.
Mais même ainsi, nous n’avons pas une vue d’ensemble complète, car NGINX Plus n’enregistre l’horodatage $msec qu’à la fin du traitement de chaque requête. Heureusement, plusieurs autres variables de mesure temporelle de NGINX Plus offrent une précision à la milliseconde et nous permettent de mieux comprendre le traitement lui-même :
$request_time– Durée totale de la requête, depuis la lecture par NGINX Plus du premier octet envoyé par le client jusqu’à l’envoi par NGINX Plus du dernier octet du corps de la réponse$upstream_connect_time– Temps nécessaire pour établir une connexion avec le serveur en amont$upstream_header_time– Temps écoulé entre l’établissement d’une connexion au serveur en amont et la réception du premier octet de l’en-tête de réponse$upstream_response_time– Temps écoulé entre l’établissement d’une connexion au serveur en amont et la réception du dernier octet du corps de la réponse
Pour plus d’informations sur ces variables de temporisation, consultez « Utilisation de la journalisation NGINX pour la surveillance des performances des applications ».
Étendons notre directive « log_format » afin d’inclure toutes ces variables de temporisation de haute précision dans notre format de journalisation « trace ».
log_format trace '$remote_addr - $remote_user [$time_local] "$request" $status '                 '$body_bytes_sent "$http_referer" "$http_user_agent" '
                 '"$http_x_forwarded_for" $request_id $msec $request_time '
                 '$upstream_connect_time $upstream_header_time $upstream_response_time';
À l’aide de notre outil d’analyse des journaux préféré, nous pouvons extraire les valeurs des variables et effectuer le calcul suivant afin de déterminer le temps qu’a mis NGINX Plus à traiter la requête avant de se connecter au serveur d’applications :
NGINX Plus processing time = $request_time - $upstream_connect_time - $upstream_response_timeNous pouvons également rechercher les valeurs les plus élevées de $upstream_response_time afin de déterminer si elles sont associées à des URI ou à des serveurs en amont particuliers. Nous pouvons ensuite les comparer plus en détail aux entrées du journal de l’application ayant le même ID de requête.
Conclusion
L’utilisation de la nouvelle variable « $request_id » et de tout ou partie des variables d’une précision de l’ordre de la milliseconde peut fournir de précieuses informations sur les goulots d’étranglement qui affectent les performances de votre application, améliorant ainsi la gestion de ses performances sans avoir à recourir à des agents et modules d’extension lourds.
Testez vous-même le traçage des applications avec NGINX Plus : commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.