Les recommandations connues sous le nom d’« application à douze facteurs » ont été publiées pour la première fois il y a plus de dix ans. Depuis, la quasi-totalité des pratiques qu’elles préconisent sont devenues la norme de fait pour développer et déployer des applications web. Bien qu’elles soient restées pertinentes malgré l’évolution de la manière dont les applications sont structurées et déployées, certaines nuances supplémentaires sont parfois nécessaires pour comprendre comment ces pratiques s’appliquent aux modèles d’architecture en microservices utilisés pour développer et déployer des applications.
Cet article de blog porte sur le facteur 3, « Stocker la configuration dans l’environnement », qui stipule :
- La configuration désigne tout ce qui varie d’un environnement de déploiement à l’autre (les déploiements étant appelés « deploys » dans la méthodologie des applications à douze facteurs).
- La configuration doit être strictement séparée du code de l’application : sinon, comment pourrait-elle varier d’un déploiement à l’autre ?
- Les données de configuration sont stockées dans des variables d’environnement.
Lorsque vous passez aux microservices, vous pouvez toujours respecter ces recommandations, mais pas nécessairement d’une manière qui corresponde exactement à une interprétation littérale de l’application à douze facteurs. Certaines recommandations, comme la mise à disposition des données de configuration sous forme de variables d’environnement, s’appliquent parfaitement. D’autres pratiques courantes propres aux microservices, tout en respectant les principes fondamentaux de l’application à douze facteurs, s’apparentent davantage à des extensions de celle-ci. Dans cet article, nous examinerons trois concepts clés de la gestion de la configuration des microservices sous l’angle du facteur 3 :
- Définir clairement la configuration de votre service
- Comment la configuration est fournie à un service
- Rendre un service disponible en tant que configuration
Terminologie et concepts clés des microservices
Avant d’aborder l’adaptation du facteur 3 aux microservices, il est utile de comprendre certains termes et concepts clés.
- Architecture d’application monolithique – Un modèle d’architecture traditionnel qui répartit les fonctions de l’application en modules, tout en regroupant tous ces modules dans une base de code unique.
- Architecture d’application en microservices – Un modèle architectural qui permet de créer une application vaste et complexe à partir de plusieurs petits composants, chacun exécutant un ensemble d’opérations bien délimité (comme l’authentification, l’envoi de notifications ou le traitement des paiements). Le terme « microservice » désigne également chacun de ces petits composants. Dans la pratique, certains « microservices » peuvent en réalité être assez volumineux.
- Service – Terme générique désignant une application ou un microservice au sein d’un système.
- Système – Dans le contexte de ce blog, l’ensemble des microservices et de l’infrastructure sous-jacente qui, ensemble, assurent toutes les fonctionnalités proposées par l’organisation.
- Artefact – Objet créé par un pipeline de test et de build. Il peut prendre de nombreuses formes, comme une image Docker contenant le code d’une application.
- Déploiement – Une « instance » en cours d’exécution d’un artefact, qui s’exécute dans un environnement tel que la préproduction, l’intégration ou la production.
Microservices ou monolithes
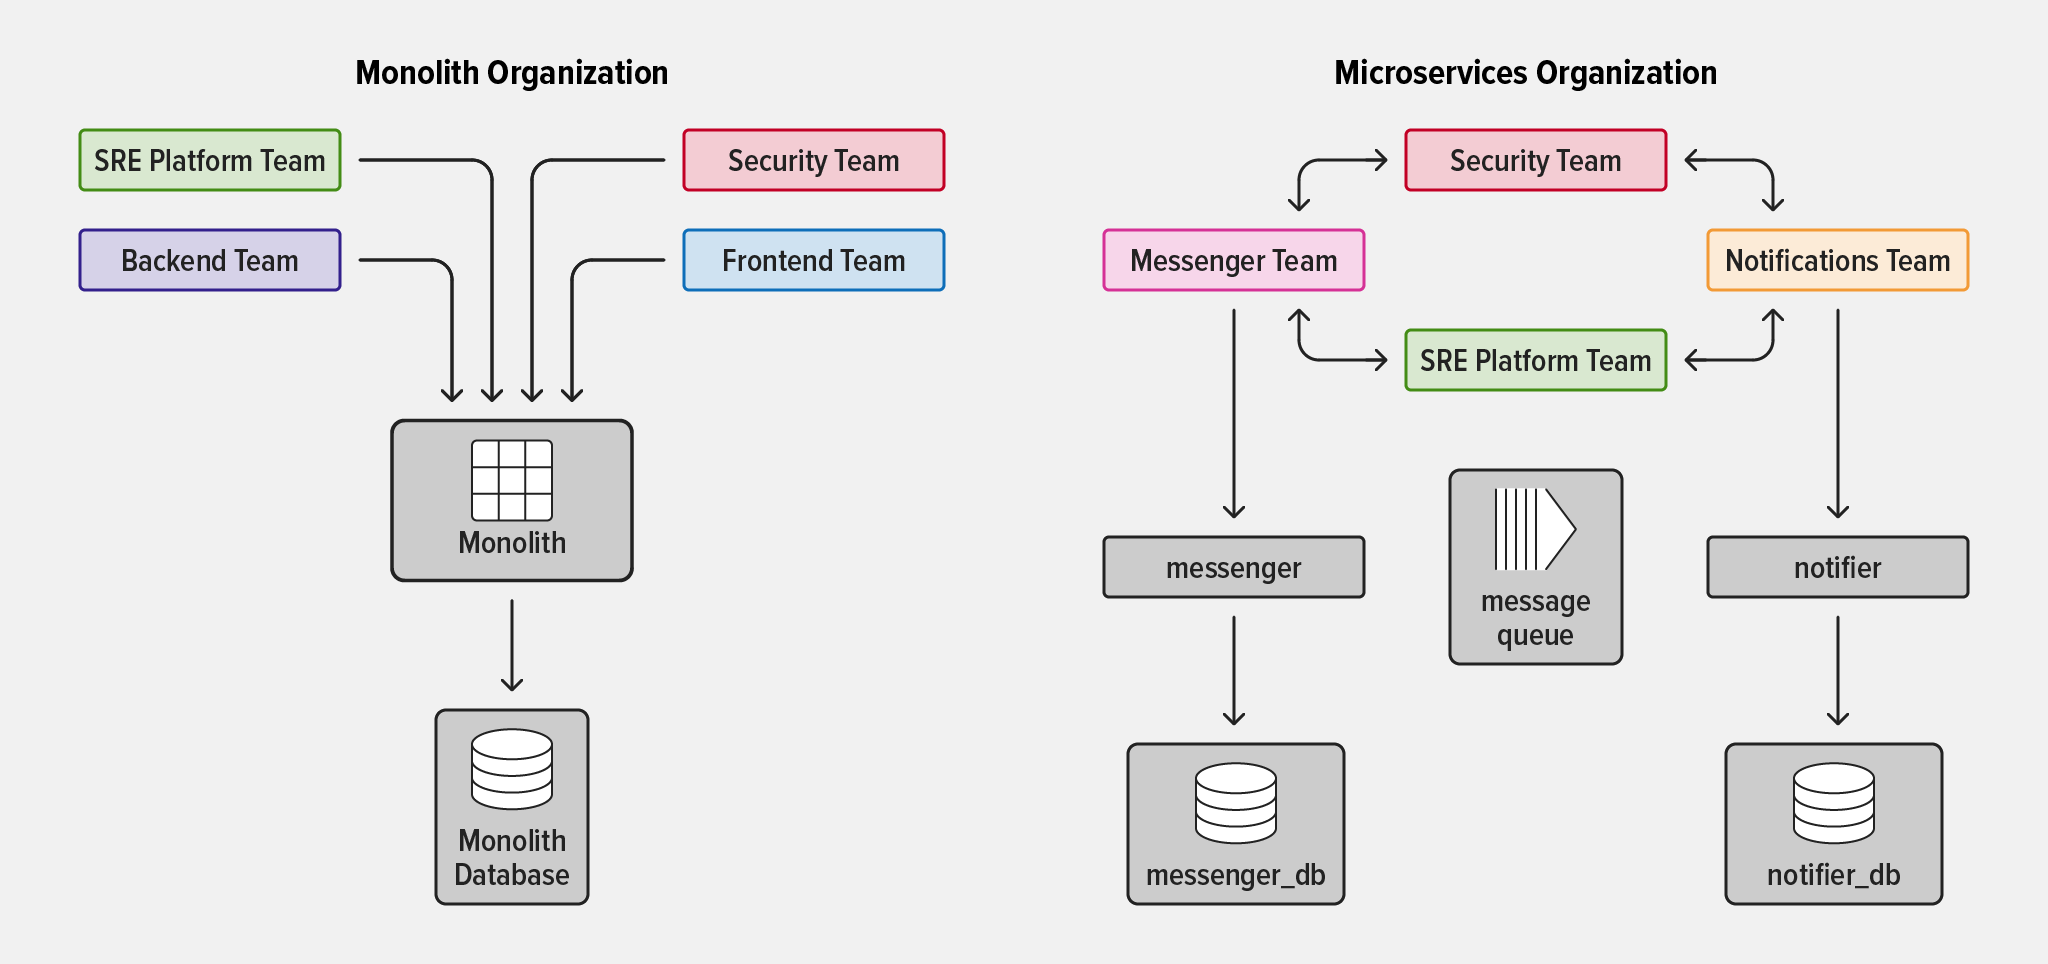
Avec une application monolithique, toutes les équipes de l’organisation travaillent sur la même application et l’infrastructure qui l’entoure. Bien que, sur le papier, les applications monolithiques paraissent généralement plus simples que les microservices, plusieurs raisons courantes poussent les organisations à adopter une architecture de microservices :
- Autonomie des équipes – Il peut être difficile de déterminer à qui appartiennent les fonctionnalités et les sous-systèmes d’une application monolithique. À mesure que les organisations se développent et gagnent en maturité, la responsabilité des fonctionnalités de l’application est souvent répartie entre un nombre croissant d’équipes. Cela crée des dépendances entre les équipes, car celle qui est responsable d’une fonctionnalité ne maîtrise pas tous les sous-systèmes associés au sein de l’application monolithique.
- Réduction du « rayon d’impact » – Lorsqu’une application de grande envergure est développée et déployée comme une seule unité, une erreur dans un sous-système peut dégrader le fonctionnement de l’ensemble de l’application.
- Mise à l’échelle indépendante des fonctionnalités – Même si un seul module d’une application monolithique est soumis à une forte charge, l’organisation doit déployer de nombreuses instances de l’application entière afin d’éviter une défaillance ou une dégradation du système.
Bien entendu, les microservices présentent leurs propres défis – notamment une complexité accrue, une observabilité moindre et la nécessité de nouveaux modèles de sécurité – mais de nombreuses organisations, en particulier celles de grande taille ou à croissance rapide, estiment que ces défis en valent la peine afin d’offrir à leurs équipes davantage d’autonomie et de flexibilité pour créer des bases fiables et stables pour les expériences qu’elles proposent à leurs clients.
Modifications requises pour les architectures de microservices
Lorsque vous refactorisez une application monolithique en microservices, vos services doivent :
- Accepter les modifications de configuration de manière prévisible
- Se faire connaître de l’ensemble du système de manière prévisible
- Être bien documenté
Dans une application monolithique, les petites incohérences dans les processus et le recours à des présupposés communs ne sont pas critiques. En revanche, avec de nombreux microservices distincts, ces incohérences et présupposés peuvent être source de grandes difficultés et de chaos. Bon nombre des changements à apporter avec les microservices sont des nécessités techniques, mais une proportion étonnamment importante concerne la manière dont les équipes travaillent en interne et interagissent entre elles.
Parmi les changements organisationnels notables liés à une architecture de microservices figurent :
- Au lieu de travailler ensemble sur la même base de code, les équipes deviennent totalement indépendantes, chacune étant entièrement responsable d’un ou de plusieurs services. Dans la mise en œuvre la plus courante des microservices, les équipes sont également réorganisées pour devenir « transversales », c’est-à-dire qu’elles réunissent des membres possédant toutes les compétences nécessaires pour atteindre leurs objectifs en dépendant le moins possible des autres équipes.
- Les équipes chargées de la plateforme (responsables de la santé globale du système) doivent désormais coordonner plusieurs services gérés par différentes équipes, au lieu de s’occuper d’une seule application.
- Les équipes chargées de l’outillage doivent rester en mesure de fournir des outils et des conseils aux différentes équipes responsables des services afin de les aider à atteindre rapidement leurs objectifs, tout en préservant la stabilité du système.
Définir clairement la configuration de votre service
L’un des aspects de l’architecture de microservices pour lesquels nous devons étendre le facteur 3 concerne la nécessité de définir clairement certaines informations essentielles sur un service, notamment sa configuration, et de limiter au minimum le contexte partagé avec les autres services. Le facteur 3 n’aborde pas directement ce point, mais celui-ci revêt une importance particulière lorsqu’un grand nombre de microservices distincts contribuent aux fonctionnalités de l’application.
En tant que propriétaire d’un service au sein d’une architecture de microservices, votre équipe est responsable de services qui jouent des rôles spécifiques dans l’ensemble du système. Les autres équipes dont les services interagissent avec les vôtres doivent pouvoir accéder au dépôt de votre service afin de consulter le code et la documentation, mais aussi d’y contribuer.
En outre, dans le domaine du développement logiciel, il est malheureusement fréquent que la composition des équipes change, non seulement parce que des développeurs rejoignent ou quittent l’entreprise, mais aussi en raison de réorganisations internes. De même, la responsabilité d’un service donné est souvent transférée d’une équipe à une autre.
Compte tenu de ces réalités, votre base de code et votre documentation doivent être extrêmement claires et cohérentes, ce qui passe par les mesures suivantes :
- Définir clairement l’objectif de chaque option de configuration
- Définir clairement le format attendu de la valeur de configuration
- Définir clairement la manière dont l’application attend que les valeurs de configuration soient fournies
- Consigner ces informations dans un nombre limité de fichiers
De nombreux frameworks applicatifs permettent de définir la configuration requise. Par exemple, le package NPM convict destiné aux applications Node.js utilise un « schéma » de configuration complet stocké dans un seul fichier. Celui-ci constitue la source de référence pour toute la configuration nécessaire à l’exécution d’une application Node.js.
Un schéma robuste et facile à trouver permet aux membres de votre équipe comme aux autres utilisateurs d’interagir en toute confiance avec votre service.
Comment la configuration est fournie à un service
Après avoir clairement défini les valeurs de configuration dont votre application a besoin, vous devez également tenir compte de la distinction importante entre les deux principales sources à partir desquelles une application de microservices déployée récupère sa configuration :
- Scripts de déploiement qui définissent explicitement les paramètres de configuration et accompagnent le code source de l’application
- Sources externes interrogées au moment du déploiement
Les scripts de déploiement constituent un modèle courant d’organisation du code dans les architectures de microservices. Comme ils sont apparus après la publication initiale de l’application à douze facteurs, ils en représentent nécessairement une extension.
Modèle : configuration du déploiement et de l’infrastructure aux côtés de l’application
Ces dernières années, il est devenu courant d’avoir un dossier nommé « infrastructure » (ou une variante de ce nom) dans le même dépôt que le code de votre application. Il contient généralement :
- Infrastructure en tant que code (Terraform en est un exemple courant) qui décrit l’infrastructure dont dépend le service, comme une base de données
- Configuration de votre système d’orchestration de conteneurs, comme les charts Helm et les manifestes Kubernetes
- Tout autre fichier lié au déploiement de l’application
À première vue, cela peut sembler contraire au principe du facteur 3, selon lequel la configuration doit être strictement séparée du code.
En fait, le fait de le placer à côté de votre application signifie qu’un dossier d’infrastructure respecte bien cette règle, tout en permettant de précieuses améliorations des processus, essentielles pour les équipes travaillant dans des environnements de microservices.
Les avantages de ce modèle sont notamment les suivants :
- L’équipe responsable du service est également responsable de son déploiement ainsi que du déploiement de l’infrastructure propre à ce service (comme les bases de données).
- L’équipe responsable peut s’assurer que les modifications apportées à chacun de ces éléments suivent son processus de développement (revue de code, intégration continue).
- L’équipe peut facilement modifier la manière dont son service et l’infrastructure sous-jacente sont déployés, sans dépendre d’équipes externes pour effectuer le travail à sa place.
Notez que les avantages offerts par ce modèle renforcent l’autonomie de chaque équipe, tout en garantissant une rigueur accrue dans le processus de déploiement et de configuration.
Quel type de configuration va où ?
En pratique, vous utilisez les scripts de déploiement stockés dans votre dossier d’infrastructure pour gérer à la fois la configuration définie explicitement dans les scripts eux-mêmes et la récupération de la configuration depuis des sources externes au moment du déploiement, en faisant en sorte que le script de déploiement d’un service :
- Définir directement certaines valeurs de configuration
- Définir les sources externes dans lesquelles le processus exécutant le script de déploiement peut rechercher les valeurs de configuration souhaitées
Les valeurs de configuration propres à un déploiement donné de votre service et entièrement sous le contrôle de votre équipe peuvent être spécifiées directement dans les fichiers du dossier d’infrastructure. Il peut s’agir, par exemple, de la durée maximale d’exécution autorisée pour une requête de base de données lancée par l’application. Cette valeur peut être modifiée en mettant à jour le fichier de déploiement, puis en redéployant l’application.
L’un des avantages de ce système est que les modifications apportées à ce type de configuration passent nécessairement par une revue de code et des tests automatisés, ce qui réduit le risque qu’une valeur mal configurée provoque une interruption de service. Les modifications de valeurs soumises à une revue de code, ainsi que les valeurs des clés de configuration à un instant donné, peuvent être retrouvées dans l’historique de vos outils de gestion du code source.
Les valeurs nécessaires au fonctionnement de l’application, mais qui ne sont pas sous le contrôle de votre équipe, doivent être fournies par l’environnement dans lequel l’application est déployée. Il peut s’agir, par exemple, du nom d’hôte et du port utilisés par le service pour se connecter à un autre microservice dont il dépend.
Comme ce service n’appartient pas à votre équipe, vous ne pouvez pas présumer de valeurs telles que le numéro de port. Ces valeurs peuvent changer à tout moment et doivent être enregistrées dans un référentiel de configuration centralisé lorsqu’elles sont modifiées, que ce soit manuellement ou par un processus automatisé. Elles peuvent ensuite être consultées par les applications qui en dépendent.
Nous pouvons résumer ces recommandations en deux bonnes pratiques de configuration des microservices.
À éviter dans la configuration des microservices : s’appuyer sur des valeurs codées en dur ou convenues d’un commun accord
Il peut sembler plus simple de coder en dur certaines valeurs dans vos scripts de déploiement, par exemple l’emplacement d’un service avec lequel le vôtre interagit. En pratique, coder en dur ce type de configuration est dangereux, en particulier dans les environnements modernes où l’emplacement des services change souvent. Et c’est particulièrement risqué si le second service ne vous appartient pas.
Vous pourriez penser que vous pouvez compter sur votre propre vigilance pour maintenir à jour l’emplacement d’un service dans vos scripts ou, pire encore, sur l’équipe responsable pour vous informer lorsque cet emplacement change. La vigilance se relâche souvent en période de stress, et faire reposer votre système sur la rigueur humaine l’expose à un risque de défaillance sans préavis.
Bonne pratique de configuration des microservices : laisser le service demander « Où se trouve ma base de données ? »
Que les informations d’emplacement soient codées en dur ou non, votre application ne doit pas dépendre de la présence d’une infrastructure critique à un emplacement donné. Au lieu de cela, un service nouvellement déployé doit pouvoir interroger une source commune au sein du système en lui posant des questions telles que « où se trouve ma base de données ? » et obtenir une réponse précise sur l’emplacement actuel de cette ressource externe. Le fait que chaque service s’enregistre auprès du système lors de son déploiement simplifie considérablement les choses.
Rendre un service disponible en tant que configuration
Tout comme le système doit pouvoir répondre aux questions « où se trouve ma base de données ? » et « où se trouve le “service X” dont je dépends ? », un service doit être exposé au système de manière à ce que les autres services puissent facilement le trouver et communiquer avec lui sans rien savoir de la façon dont il est déployé.
Une pratique de configuration essentielle dans les architectures de microservices est la découverte de services : l’enregistrement des informations relatives aux nouveaux services et leur mise à jour dynamique lorsque d’autres services y accèdent. Après avoir expliqué pourquoi la découverte de services est nécessaire pour les microservices, examinons un exemple de mise en œuvre avec NGINX Open Source et Consul.
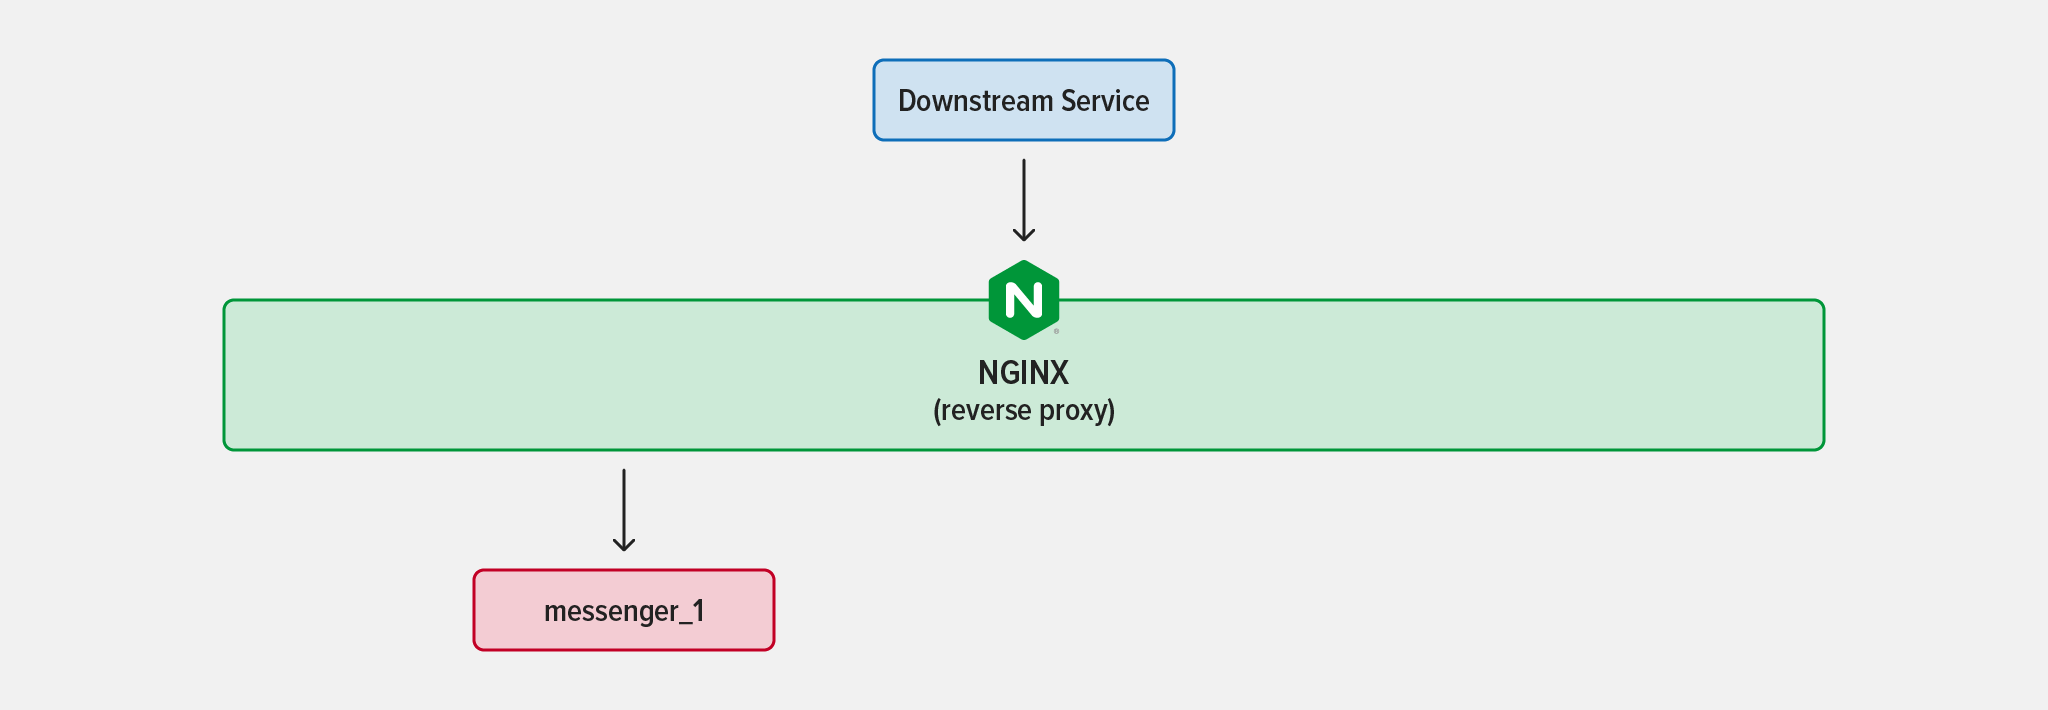
Il est courant d’exécuter simultanément plusieurs instances (déploiements) d’un service. Cela permet non seulement de gérer un trafic supplémentaire, mais aussi de mettre à jour un service sans interruption en lançant un nouveau déploiement. En faisant office de proxy inverse et d’équilibreur de charge, des outils comme NGINX traitent le trafic entrant et l’acheminent vers l’instance la plus appropriée. Ce modèle est intéressant, car les services qui dépendent du vôtre envoient leurs requêtes uniquement à NGINX et n’ont pas besoin de connaître les détails de vos déploiements.
Prenons un exemple : supposons que vous disposiez d’une seule instance d’un service appelé « messenger », exécutée derrière NGINX, qui fait office de proxy inverse.
Mais que se passe-t-il si votre application devient populaire ? C’est une bonne nouvelle, mais vous constatez alors qu’en raison de l’augmentation du trafic, l’instance messenger consomme beaucoup de ressources processeur et met plus de temps à traiter les requêtes, tandis que la base de données semble parfaitement fonctionner. Cela indique que vous pourriez résoudre le problème en déployant une autre instance du service messenger.
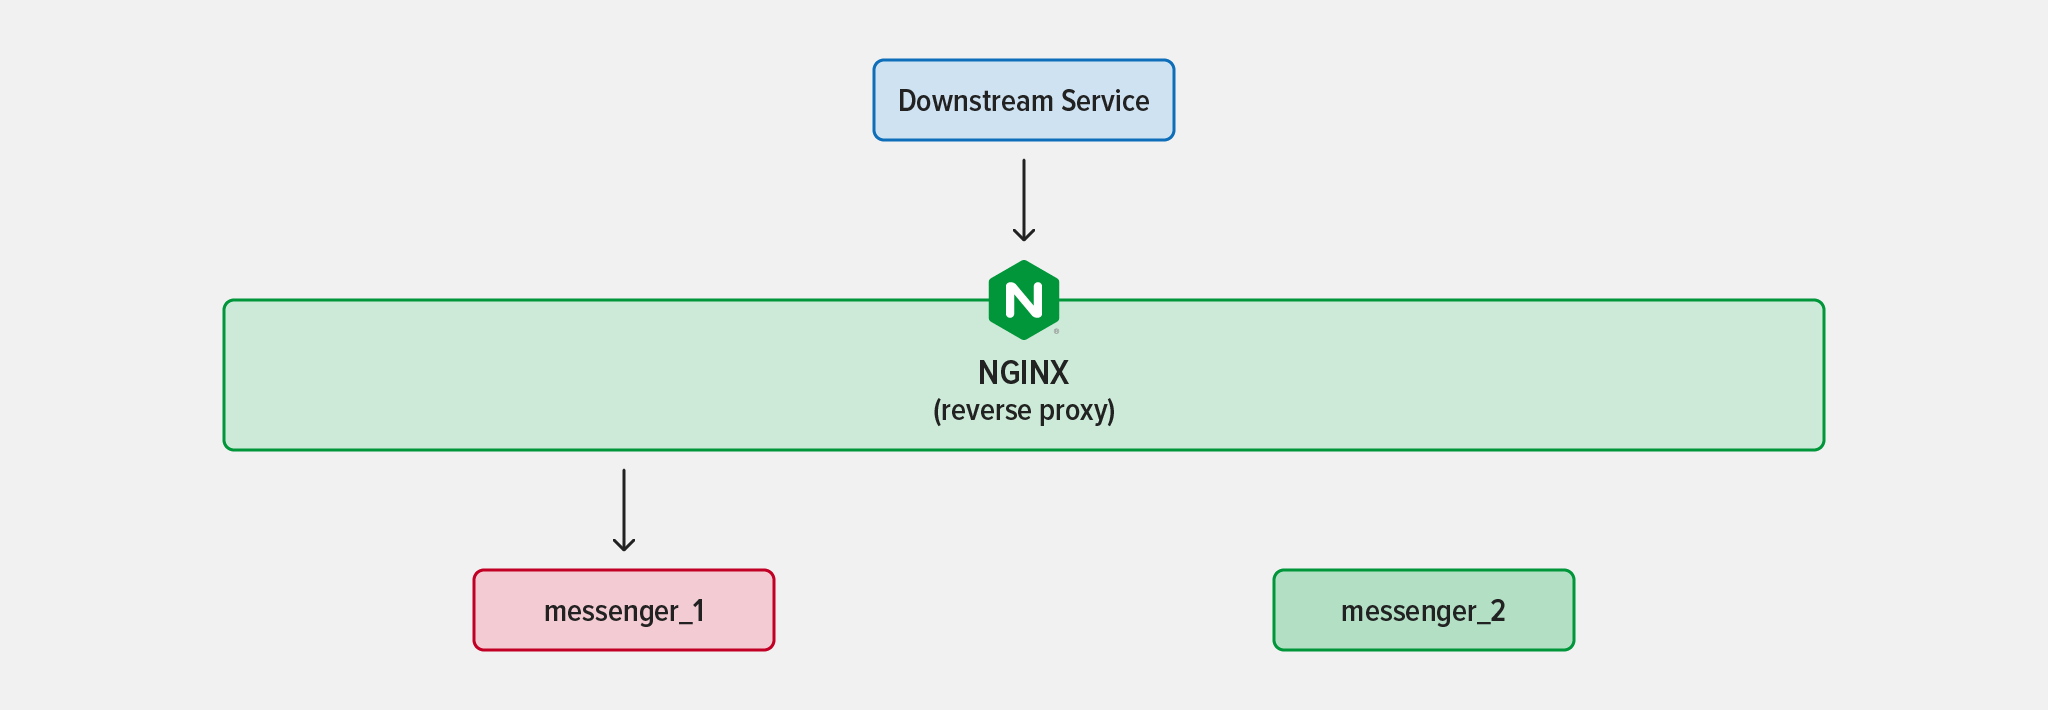
Lorsque vous déployez la deuxième instance du service messenger, comment NGINX sait-il qu’elle est opérationnelle et qu’il peut commencer à lui envoyer du trafic ? Ajouter manuellement de nouvelles instances à votre configuration NGINX est une solution, mais cela devient rapidement ingérable à mesure que davantage de services augmentent ou réduisent leur capacité.
Une solution courante consiste à suivre les services d’un système à l’aide d’un registre de services à haute disponibilité tel que Consul. Les nouvelles instances de service s’enregistrent auprès de Consul lors de leur déploiement. Consul surveille l’état des instances en effectuant régulièrement des contrôles d’intégrité. Lorsqu’une instance échoue à ces contrôles, elle est retirée de la liste des services disponibles.
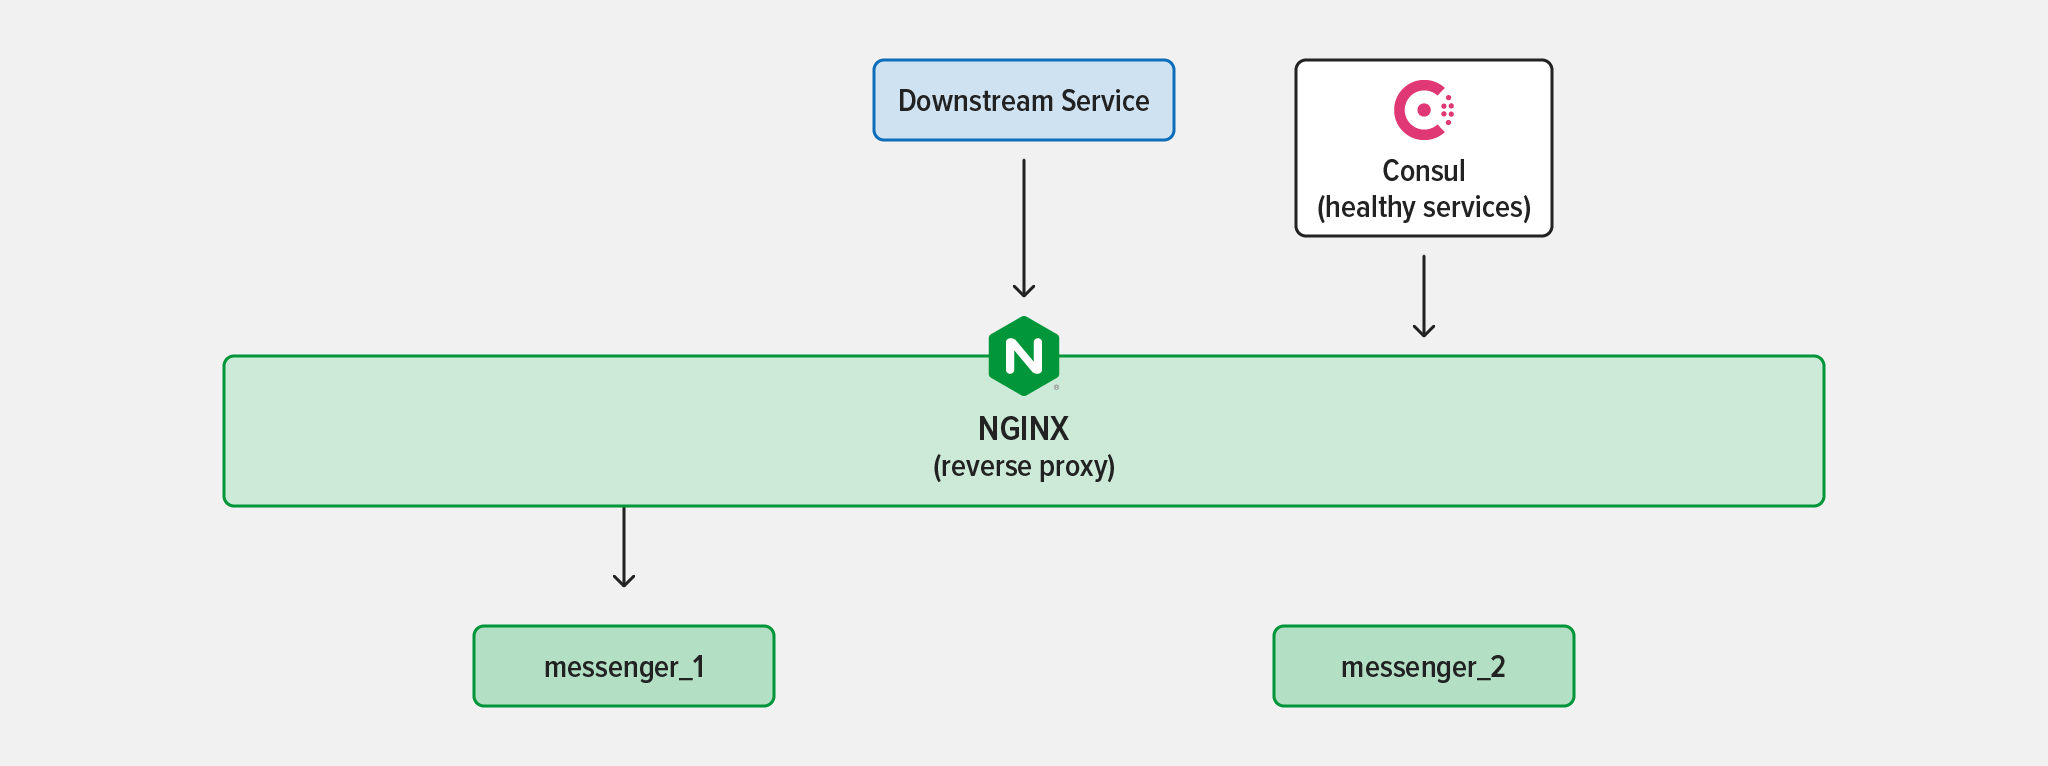
NGINX peut interroger un registre tel que Consul de différentes manières et adapter son routage en conséquence. Rappelons que lorsqu’il fait office de proxy inverse ou d’équilibreur de charge, NGINX achemine le trafic vers des serveurs « en amont ». Prenons cette configuration simple :
# Define an upstream group called "messenger_service"
upstream messenger_service {
    server 172.18.0.7:4000;
    server 172.18.0.8:4000;
}

server {
    listen 80;

    location /api {
        # Proxy HTTP traffic with paths starting with '/api' to the
        # 'upstream' block above. The default load-balancing algorithm,
        # Round-Robin, alternates requests between the two servers
        # in the block.
        proxy_pass http://messenger_service;
        proxy_set_header X-Forwarded-For $remote_addr;
    }
}
Par défaut, NGINX doit connaître l’adresse IP et le port exacts de chaque instance de messenger pour pouvoir y acheminer le trafic. Dans ce cas, il s’agit du port 4000 pour les adresses 172.18.0.7 et 172.18.0.8.
C’est là qu’interviennent Consul et Consul template. Consul template s’exécute dans le même conteneur que NGINX et communique avec le client Consul, qui tient à jour le registre des services.
Lorsque les informations du registre changent, Consul template génère une nouvelle version du fichier de configuration NGINX avec les adresses IP et les ports appropriés, l’enregistre dans le répertoire de configuration de NGINX et demande à NGINX de recharger sa configuration. Il n’y a aucune interruption de service lorsque NGINX recharge sa configuration, et la nouvelle instance commence à recevoir du trafic dès que le rechargement est terminé.
Avec un proxy inverse tel que NGINX dans ce type de situation, il suffit d’enregistrer auprès du système un point d’accès unique permettant aux autres services d’y accéder. Votre équipe peut ainsi gérer librement les différentes instances du service sans craindre que les autres services ne perdent l’accès au service dans son ensemble.
Passez à la pratique avec NGINX et Microservices March
Il est vrai que les microservices accroissent la complexité, tant sur le plan technique pour vos services que sur le plan organisationnel dans vos relations avec les autres équipes. Pour tirer parti des avantages d’une architecture de microservices, il est important de réexaminer d’un œil critique les pratiques conçues pour les monolithes afin de s’assurer qu’elles offrent toujours les mêmes bénéfices lorsqu’elles sont appliquées à un environnement très différent. Dans cet article, nous avons vu comment le facteur 3 de l’application à douze facteurs reste pertinent dans un contexte de microservices, tout en pouvant bénéficier de légers ajustements dans sa mise en œuvre concrète.
Pour en savoir plus sur l’application de la méthodologie des applications à douze facteurs aux architectures de microservices, consultez l’unité 1 de Microservices March 2023 (bientôt disponible sur le blog). Inscrivez-vous gratuitement pour accéder à un webinaire sur ce sujet et à un atelier pratique.

À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.