Nous avons beaucoup écrit sur la manière d’utiliser NGINX Plus et NGINX Open Source pour répartir la charge de vos sites web et applications afin de garantir une disponibilité et une fiabilité optimales. La répartition de charge est un outil essentiel pour améliorer les performances des applications, déployer des applications à grande échelle et déployer des conteneurs et des microservices.
Nous avons déjà expliqué comment déployer NGINX Plus dans un centre de données (éventuellement aux côtés de contrôleurs de mise à disposition d’applications traditionnels), dans des conteneurs et dans des environnements cloud, notamment Amazon Web Services (AWS), Google Cloud Platform et Microsoft Azure.
Dans cet article, nous nous concentrerons sur les techniques de répartition de charge (également appelées méthodes ou algorithmes de répartition de charge) de NGINX Plus et de NGINX, et vous donnerons quelques conseils pour choisir la méthode adaptée à chaque cas d’utilisation. NGINX propose quatre techniques de répartition de charge (Round Robin, Hash, IP Hash et Least Connections), et NGINX Plus en ajoute une cinquième (Least Time). Toutes les méthodes applicables au trafic HTTP sont également disponibles pour TCP (ainsi que pour UDP dans NGINX Plus à partir de la version 9), à l’exception d’IP Hash.
[NDLR – NGINX Plus R16 et NGINX Open Source 1.15.1 ont introduit l’algorithme « Random with Two Choices » comme méthode supplémentaire d’équilibrage de charge. Pour en savoir plus, consultez l’article NGINX et l’algorithme d’équilibrage de charge « Power of Two Choices » sur notre blog.]
Tour d’horizon des techniques de répartition de charge
Nous partons du principe que vous connaissez les bases de la configuration de l’équilibrage de charge, mais vous pouvez consulter ces ressources si vous souhaitez vous rafraîchir la mémoire :
- Les articles du Guide d’administration NGINX Plus offrent une vue d’ensemble complète.
- Équilibrage de charge haute performance renvoie à des présentations détaillées des fonctionnalités avancées de NGINX Plus qui permettent d’améliorer encore l’efficacité d’une méthode d’équilibrage de charge.
- Équilibrage de charge avec NGINX et NGINX Plus, Partie 1 et Partie 2 est un guide pas à pas qui transforme un simple proxy inverse en une solution complète d’équilibrage de charge grâce aux fonctionnalités avancées de NGINX Plus.
- La page de solutions « Équilibrage de charge » propose des liens vers d’autres ressources, notamment des livres numériques, des webinaires et des livres blancs.
Par souci de simplicité, nous nous concentrerons sur l’équilibrage de charge HTTP, que vous configurez dans le contexte http. L’équilibrage de charge TCP se configure quant à lui dans le contexte stream (tout comme l’équilibrage de charge UDP dans NGINX Plus à partir de la version 9). Bien que les équilibreurs de charge HTTP et TCP/UDP offrent les mêmes fonctionnalités, les directives et paramètres disponibles diffèrent quelque peu en raison des différences inhérentes aux protocoles ; pour en savoir plus, consultez la documentation des modules Upstream pour HTTP et TCP/UDP.
Vous activez l’équilibrage de charge à l’aide de deux blocs de configuration, que nous présenterons sous leur forme de base, sans paramètres facultatifs ni fonctionnalités supplémentaires :
- Le bloc
serverdéfinit un serveur virtuel qui écoute le trafic présentant les caractéristiques que vous définissez et le transmet à un groupe nommé de serveurs en amont. Dans nos exemples, le serveur virtuel écoute sur le port par défaut (80) le trafic HTTP destiné à www.example.com et le transmet au groupe de serveurs en amont nommé backend. Ce bloc est identique dans tous nos exemples.
server {    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}- (NGINX Plus et NGINX peuvent également répartir la charge entre des serveurs backend FastCGI, memcached, SCGI et uwsgi. Remplacez
proxy_passpar la directive appropriée :fastcgi_pass,memcached_pass,scgi_passouuwsgi_pass.) - Le bloc
upstreamdéfinit le nom d’un groupe de serveurs en amont et répertorie les serveurs qui en font partie, identifiés par leur nom d’hôte, leur adresse IP ou le chemin de leur socket de domaine UNIX. Dans nos exemples, le groupe de serveurs en amont nommé backend comprend trois serveurs : web1, web2 et web3. Le blocupstreampermet de spécifier la méthode de répartition de charge ; nous nous y intéresserons donc dans les sections suivantes. À titre d’exemple, voici le bloc correspondant à la méthode par défaut, le round-robin :
upstream backend {    server web1;
    server web2;
    server web3;
}
Tourniquet
Round Robin est la méthode d’équilibrage de charge par défaut de NGINX Plus et de NGINX. Le répartiteur de charge parcourt la liste des serveurs en amont dans l’ordre et attribue chaque nouvelle demande de connexion au serveur suivant, à tour de rôle.
Avec l’exemple de configuration suivant du groupe de serveurs en amont backend, l’équilibreur de charge envoie les trois premières demandes de connexion à web1, web2 et web3, dans cet ordre, la quatrième à web1, la cinquième à web2, et ainsi de suite.
upstream backend {    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Hachage
Avec la méthode Hash, l’équilibreur de charge calcule, pour chaque requête, un hachage basé sur la combinaison de texte et de variables NGINX que vous spécifiez, puis associe ce hachage à l’un des serveurs. Il envoie toutes les requêtes ayant ce hachage à ce serveur. Cette méthode assure ainsi une forme élémentaire de persistance de session.
Dans l’exemple suivant, la directive hash utilise le schéma (http ou https) et l’URI complète de la requête comme base pour le calcul du hachage :
upstream backend {    hash $scheme$request_uri;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Hachage IP
IP Hash (disponible uniquement pour HTTP) est une variante prédéfinie de la méthode Hash, dans laquelle le hachage est basé sur l’adresse IP du client. Vous la configurez à l’aide de la directive ip_hash.
upstream backend {    ip_hash;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Si le client possède une adresse IPv6, le hachage est calculé à partir de l’adresse complète. S’il possède une adresse IPv4, le hachage est calculé uniquement à partir des trois premiers octets de l’adresse. Ce mécanisme est conçu pour optimiser la répartition des clients de fournisseurs d’accès à Internet auxquels des adresses IP sont attribuées dynamiquement dans une plage de sous-réseau /24. En cas de redémarrage ou de reconnexion, l’adresse du client est souvent remplacée par une autre adresse de cette même plage /24, mais la connexion correspond toujours au même client. Il n’y a donc aucune raison de modifier son association au serveur.
Si, toutefois, la majorité du trafic vers votre site provient de clients appartenant au même réseau /24, la méthode IP Hash n’est pas adaptée, car elle associe tous les clients au même serveur. Dans ce cas (ou si vous souhaitez calculer le hachage sur les quatre octets pour une autre raison), utilisez plutôt la méthode Hash avec la variable $remote_addr.
hash $remote_addr;Moins de connexions
Avec la méthode du plus petit nombre de connexions, le répartiteur de charge compare le nombre de connexions actives qu’il maintient avec chaque serveur et envoie la requête au serveur qui en compte le moins. Cette méthode se configure à l’aide de la directive least_conn.
upstream backend {
    least_conn;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Temps de réponse le plus court
Avec la méthode Least Time (disponible uniquement dans NGINX Plus), l’équilibreur de charge combine mathématiquement deux indicateurs pour chaque serveur — le nombre actuel de connexions actives et le temps de réponse moyen pondéré des requêtes précédentes — et envoie la requête au serveur présentant la valeur la plus faible.
Le choix du paramètre de la directive least_time détermine lequel des deux temps de réponse est mesuré : le temps nécessaire à la réception de l’en-tête de réponse (header) ou le temps nécessaire à la réception de la réponse complète (last_byte).
upstream backend {    least_time (header | last_byte);

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Remarques :
- Pour l’équilibrage de charge TCP et UDP (dans le contexte
stream), vous pouvez choisir parmi trois types de temps de réponse à l’aide des paramètres suivants de la directiveleast_time:connect– Temps de connexion au serveur en amontfirst_byte– Temps nécessaire pour recevoir le premier octet des données de réponselast_byte– Temps nécessaire pour recevoir le dernier octet des données de réponse
- Pour le trafic HTTP comme pour le trafic TCP/UDP, dans NGINX Plus R12 et les versions ultérieures, ajoutez le paramètre
inflightpour inclure les connexions incomplètes dans chaque métrique ; ces connexions sont incluses par défaut dans les versions antérieures.
Choisir une technique de répartition de charge
Alors, comment savoir quelle technique de répartition de charge est la mieux adaptée à votre site web ou à votre application ?
Les profils de trafic varient tellement d’un site à l’autre – et même sur un même site selon l’heure de la journée – qu’il n’est pas pertinent de choisir une technique de répartition de charge en se fondant sur une seule caractéristique (par exemple, un trafic en rafales ou régulier, des connexions de courte ou de longue durée, etc.). Cela dit, nous allons examiner les avantages et les inconvénients de chaque méthode pour vous aider à restreindre les options à envisager.
Exécution de tests pour comparer les méthodes
Quelles que soient les méthodes de répartition de charge que vous envisagez, nous vous encourageons à les tester pour déterminer laquelle est la mieux adaptée à votre trafic. Par « mieux adaptée », on entend généralement celle qui permet de fournir des réponses aux clients le plus rapidement possible, mais vos critères peuvent être différents.
Les outils de gestion des performances applicatives sont très pratiques pour ce type de test : vous pouvez créer des écrans personnalisés avec des graphiques pour chacun des serveurs du groupe en amont, afin de les comparer en temps réel à mesure que les valeurs évoluent pendant le test. Plusieurs solutions APM proposent des plug-ins spécifiques pour NGINX Plus et NGINX, notamment AppDynamics, Datadog, Dynatrace et New Relic.
Les tests sont plus simples si tous les serveurs ont la même capacité. Dans le cas contraire, vous devez attribuer des poids aux serveurs afin que les machines disposant d’une capacité supérieure reçoivent davantage de requêtes. Consultez la section Définition des poids lorsque les serveurs ne sont pas identiques ci-dessous.
Voici quelques indicateurs à surveiller pendant les tests :
- Charge du processeur et de la mémoire – Examinez le pourcentage de la capacité totale utilisée, tant pour le processeur que pour la mémoire. Si la charge n’est pas répartie équitablement entre tous les serveurs, le trafic n’est pas distribué efficacement.
- Temps de réponse des serveurs – Si le temps de réponse est systématiquement plus élevé pour certains serveurs que pour d’autres, c’est que des requêtes plus « lourdes » (nécessitant davantage de calculs ou d’appels à une base de données ou à d’autres services) leur sont acheminées de manière déséquilibrée. Essayez d’ajuster les pondérations, car le déséquilibre peut être dû à des pondérations incorrectes plutôt qu’à un problème lié à la technique d’équilibrage de charge.
- Temps total de réponse au client – Là encore, des temps systématiquement plus élevés pour certains serveurs indiquent qu’ils reçoivent une part disproportionnée de requêtes longues à traiter. Vous pouvez, là aussi, essayer d’ajuster les pondérations pour voir si cela résout le problème.
- Erreurs et requêtes ayant échoué – Vous devez vous assurer que le nombre de requêtes ayant échoué et d’autres erreurs pendant les tests ne dépasse pas le niveau habituel de votre site. Sinon, vous fondez votre décision sur des situations d’erreur plutôt que sur un trafic réaliste. Pour certaines erreurs, le serveur peut envoyer sa réponse plus rapidement que lorsque la requête aboutit. Par exemple, pour le code de réponse HTTP
404(FileNotFound), le serveur renvoie probablement l’erreur beaucoup plus rapidement qu’il ne pourrait transmettre le fichier demandé si celui-ci existait. Avec les algorithmes de répartition de charge Least Connections et Least Time, cela peut amener le répartiteur de charge à privilégier un serveur qui, en réalité, ne fonctionne pas correctement.
Avantages, inconvénients et cas d’utilisation
Examinons maintenant les avantages et les inconvénients de chaque technique d’équilibrage de charge, ainsi que quelques cas d’utilisation auxquels elles sont particulièrement adaptées. Nous les présenterons par ordre croissant de pertinence pour la majorité des cas d’utilisation. Pour vous donner un aperçu : nous considérons que Least Connections (et, pour NGINX Plus, Least Time) constitue le meilleur choix pour le plus large éventail de cas d’utilisation.
Hachage et hachage IP
Les techniques de répartition de charge Hash et IP Hash établissent une association fixe entre un type donné de requête client (représenté par la valeur de hachage) et un serveur particulier. Vous connaissez peut-être ce mécanisme sous le nom de persistance de session : toutes les requêtes ayant une même valeur de hachage sont toujours dirigées vers le même serveur.
Le principal inconvénient de ces méthodes est qu’elles ne garantissent pas une répartition équitable du nombre de requêtes entre les serveurs, et encore moins un équilibrage uniforme de la charge. L’algorithme de hachage répartit uniformément l’ensemble des valeurs de hachage possibles dans des « compartiments », un pour chaque serveur du groupe de serveurs en amont, mais il est impossible de prévoir si les valeurs de hachage des requêtes réellement reçues seront réparties uniformément. Supposons, par exemple, que dix clients accèdent à un site et que l’algorithme IP Hash associe les valeurs de hachage de sept des adresses IP à web1, celle d’une adresse à web2 et celles de deux adresses à web3. Le serveur web1 reçoit alors plus de deux fois plus de requêtes que tous les autres serveurs réunis.
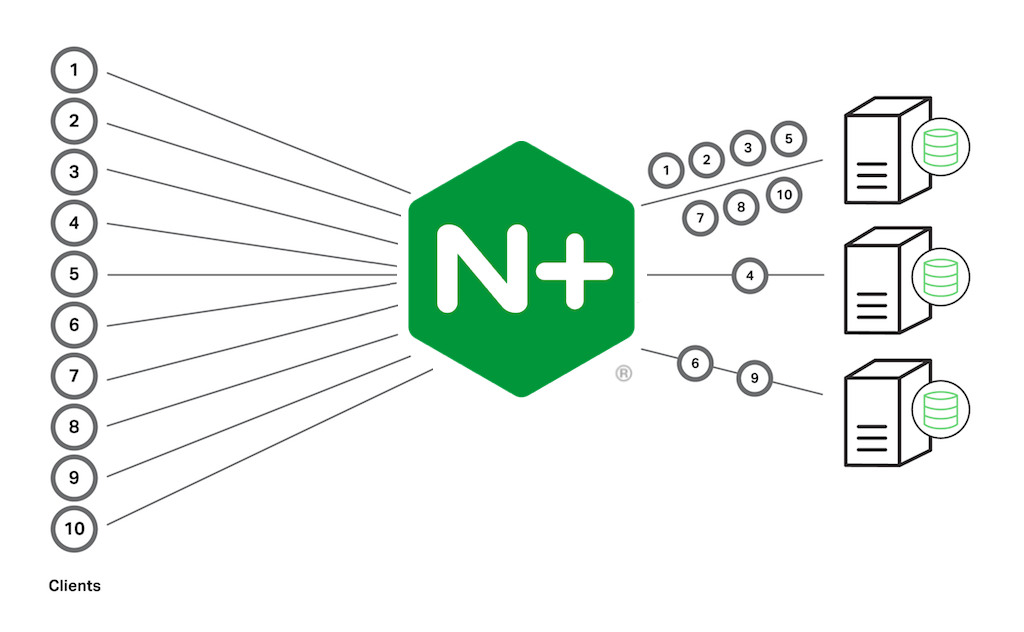
Il est donc judicieux d’utiliser Hash ou IP Hash lorsque les avantages du maintien des sessions l’emportent sur les effets potentiellement négatifs d’une charge déséquilibrée. Ce sont les seules formes de persistance de session disponibles dans NGINX. NGINX Plus propose trois autres mécanismes de persistance de session, plus sophistiqués, qui fonctionnent conjointement avec un véritable équilibrage de charge (vous les configurez à l’aide de la directive sticky). Vous pouvez toutefois choisir Hash ou IP Hash même avec NGINX Plus, car ces trois mécanismes ne fonctionnent pas dans les cas suivants :
- Le navigateur ou l’application cliente n’accepte pas les cookies, et l’application ne peut pas utiliser les mécanismes de persistance de session sans cookies. Utilisez la méthode IP Hash pour associer chaque client (plus précisément son adresse IP) à un serveur donné.
- Vous souhaitez envoyer systématiquement les requêtes pour une URL donnée au même serveur afin de tirer parti de la mise en cache sur le serveur lui-même. Utilisez la méthode Hash avec la variable
$request_uripour récupérer systématiquement le fichier sur le même serveur. Par exemple, supposons que vous sachiez que le traitement d’un fichier .php donné nécessite plusieurs appels à la base de données qui prennent du temps, mais que les données récupérées changent peu souvent et peuvent donc être mises en cache. Si vous dirigez toutes les requêtes concernant ce fichier vers le même serveur, seul le premier client subit un délai important dû aux appels à la base de données. Pour tous les clients suivants, les données sont rapidement récupérées depuis le cache. Autre avantage : un seul serveur doit mettre en cache cet ensemble de données. Comme vous évitez ainsi de mettre les mêmes données en cache sur chaque serveur, vous pouvez utiliser des caches plus petits.
Il existe quelques cas où la méthode IP Hash — ainsi que la méthode Hash lorsque l’adresse IP du client fait partie de la clé — ne fonctionne pas :
- Lorsque l’adresse IP du client peut changer au cours de la session, par exemple lorsqu’un client mobile passe d’un réseau Wi-Fi à un réseau cellulaire.
- Lorsque les requêtes d’un grand nombre de clients transitent par un proxy direct, car l’adresse IP du proxy est utilisée pour tous ces clients.
Les hachages sont déterministes (l’algorithme de hachage produit les mêmes résultats à chaque fois). Cela présente deux avantages : toutes les instances NGINX Plus ou NGINX d’un déploiement répartissent la charge des requêtes exactement de la même manière, et la correspondance entre les valeurs de hachage et les serveurs est conservée après les redémarrages du répartiteur de charge. (Elle est en réalité recalculée après le redémarrage, mais comme le résultat est toujours identique, elle est de fait conservée.)
En revanche, toute modification de l’ensemble des serveurs en amont impose généralement de recalculer au moins une partie des correspondances, ce qui rompt la persistance des sessions. Vous pouvez réduire quelque peu le nombre de correspondances à recalculer :
- Pour la méthode Hash, ajoutez le paramètre
consistentà la directivehash; NGINX Plus utilise l’algorithme de hachage ketama, ce qui réduit le nombre de remappages. - Pour la méthode IP Hash, avant de retirer temporairement un serveur du groupe upstream, ajoutez le paramètre
downà sa directiveserver, comme pour web2 dans l’exemple suivant. Les correspondances ne sont pas recalculées, car le serveur est supposé être bientôt remis en service.
upstream backend {    ip_hash;

    server web1;
    server web2 down;
    server web3;
}
Tourniquet
Comme indiqué précédemment, Round Robin est la méthode de répartition de charge par défaut dans NGINX Plus et NGINX. C’est donc assurément la méthode la plus simple à choisir : vous n’avez rien d’autre à configurer que le groupe de serveurs en amont lui-même.
Il est généralement admis que la méthode Round Robin fonctionne le mieux lorsque les caractéristiques des serveurs et des requêtes ne risquent pas d’entraîner une surcharge de certains serveurs par rapport aux autres. Voici quelques-unes des conditions à réunir :
- Tous les serveurs ont à peu près la même capacité. Cette exigence est moins importante si les différences entre les serveurs sont fidèlement reflétées par les pondérations qui leur sont attribuées.
- Tous les serveurs hébergent le même contenu.
- Les requêtes nécessitent des durées de traitement ou une puissance de calcul assez similaires. Si la charge de traitement varie fortement d’une requête à l’autre, un serveur peut se retrouver surchargé si le répartiteur de charge lui envoie par hasard de nombreuses requêtes lourdes dans un court laps de temps.
- Le volume de trafic n’est pas suffisamment élevé pour que les serveurs approchent souvent de leur pleine capacité. Si les serveurs sont déjà fortement sollicités, la répartition systématique des requêtes selon l’algorithme Round Robin risque davantage de faire basculer certains serveurs en surcharge, comme décrit au point précédent.
Le Round Robin est particulièrement adapté aux scénarios de test, car il garantit que les requêtes sont réparties entre tous les serveurs en nombre égal (ou selon la pondération appropriée). D’autres méthodes ne répartissent pas toujours le trafic de manière uniforme lorsque son volume est faible, ce qui peut fausser les résultats des tests.
La répartition uniforme peut également révéler si les caches fonctionnent correctement et à pleine capacité : comme Round Robin ne permet pas d’envoyer les requêtes concernant un fichier donné vers le même serveur, chaque serveur est susceptible de finir par diffuser et mettre en cache un large éventail de fichiers (dont, généralement, de nombreux fichiers également présents sur les autres serveurs), ce qui augmente les chances que le cache se remplisse.
Enfin, la répartition initiale uniforme aide à détecter les problèmes de persistance de session dans NGINX Plus (telle que configurée avec la directive sticky).
Moins de connexions et temps de réponse le plus court
Comme nous l’avons mentionné plus haut, la méthode du plus petit nombre de connexions (Least Connections) est la technique de répartition de charge la mieux adaptée au plus large éventail de cas d’usage, en particulier au trafic de production. Les retours d’expérience de nos clients le confirment. Ses performances sont stables et prévisibles.
La méthode du nombre minimal de connexions (Least Connections) répartit également efficacement la charge de travail entre les serveurs en fonction de leur capacité. Un serveur plus puissant traite les requêtes plus rapidement : à tout moment, il est donc susceptible d’avoir moins de connexions en cours de traitement (ou même en attente de traitement) qu’un serveur de moindre capacité. Cette méthode envoie chaque requête au serveur ayant le moins de connexions actives et tend ainsi à privilégier les serveurs puissants. (La définition de pondérations permet toutefois une répartition encore plus efficace des requêtes, comme décrit dans la section Définir des pondérations lorsque les serveurs ne sont pas identiques ci-dessous.)
Vous pouvez considérer Least Time (NGINX Plus uniquement) comme une version plus sensible de Least Connections. En intégrant le temps de réponse moyen, cette méthode tient compte de l’historique récent des performances du serveur (il s’agit en fait d’une moyenne mobile à pondération exponentielle : les temps de réponse anciens ont donc moins d’influence sur la moyenne que les temps de réponse récents).
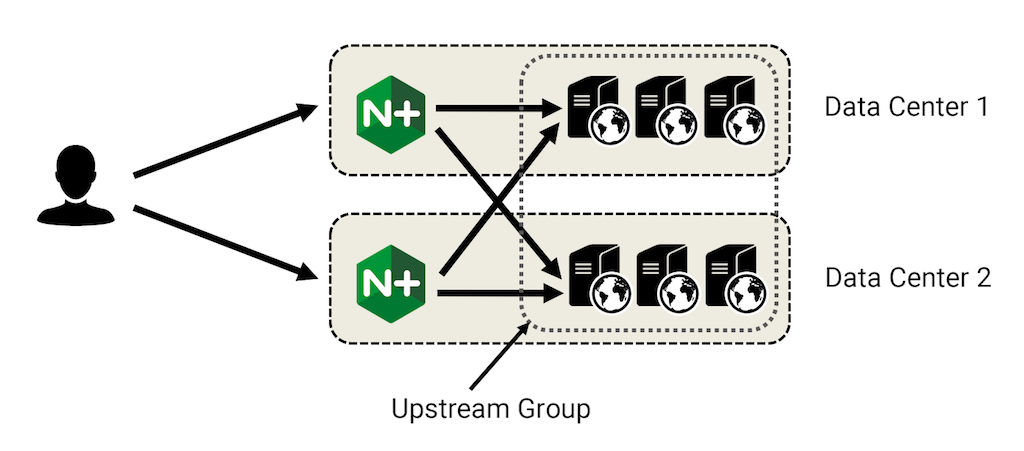
Least Time est particulièrement adapté lorsque les serveurs en amont présentent des temps de réponse moyens très différents. Si, par exemple, vous disposez de serveurs répartis dans plusieurs centres de données pour assurer la reprise après sinistre, Least Time a tendance à envoyer davantage de requêtes aux serveurs locaux, car ils répondent plus rapidement. Les environnements cloud constituent un autre cas d’utilisation, car les performances des serveurs y sont souvent très imprévisibles.
Définir les pondérations lorsque les serveurs ne sont pas identiques
Nous avons souligné à plusieurs reprises l’importance de définir des poids pour les serveurs lorsque ceux du groupe en amont ont des capacités différentes. C’est particulièrement important pour l’équilibrage de charge Round Robin, qui, sans cela, envoie le même nombre de requêtes à chaque serveur. Un serveur moins puissant risque alors de se retrouver surchargé, tandis qu’un serveur plus puissant reste en partie inutilisé.
Pour définir les poids, ajoutez le paramètre weight à une ou plusieurs directives server dans le bloc upstream. La valeur par défaut est 1.
Vous pouvez envisager l’effet de la pondération sur les différentes techniques de répartition de charge de la manière suivante. Gardez à l’esprit que ces descriptions sont correctes sur le plan conceptuel, mais que l’implémentation dans le code de NGINX Plus n’utilise pas nécessairement les opérations mathématiques indiquées. Voici le groupe de serveurs en amont utilisé dans nos exemples :
upstream backend {    server web1 weight=6;
    server web2 weight=3;
    server web3;
}- Round Robin – Chaque serveur reçoit un pourcentage des requêtes entrantes égal à son poids divisé par la somme des poids. Dans notre exemple, sur dix requêtes, web1 en reçoit six (60 %), web2 en reçoit trois (30 %) et web3 en reçoit une (10 %).
- Hash et IP Hash – Rappelons que, sans pondération, l’algorithme de hachage répartit uniformément l’ensemble des valeurs de hachage possibles dans des « compartiments », un pour chaque serveur du groupe en amont. Avec la pondération, il calcule la somme des poids, répartit l’ensemble des valeurs de hachage possibles entre autant de compartiments, puis associe à chaque serveur un nombre de compartiments égal à son poids. Dans notre exemple, il y a dix compartiments, chacun contenant 10 % des valeurs de hachage possibles. Six compartiments (60 % des valeurs de hachage possibles) sont associés à web1, trois compartiments (30 %) à web2 et un compartiment (10 %) à web3.
- Nombre minimal de connexions et Temps minimal – Comme nous l’avons mentionné précédemment, même sans pondération, ces algorithmes répartissent assez efficacement la charge de travail entre les serveurs en fonction de leur capacité. La définition de pondérations améliore encore leurs performances à cet égard. Rappelons que les algorithmes Nombre minimal de connexions et Temps minimal envoient chaque requête au serveur dont le « score » est le plus faible (respectivement le nombre de connexions ou une combinaison mathématique du nombre de connexions et du temps). Lorsque vous attribuez des pondérations, l’équilibreur de charge divise le score de chaque serveur par sa pondération, puis envoie, là encore, la requête au serveur dont la valeur est la plus faible. Voici un exemple pour l’algorithme Nombre minimal de connexions, avec les pondérations de notre exemple et le nombre de connexions actives indiqué : web1 a le score le plus faible, soit 100, et reçoit donc la requête, même si son nombre de connexions, qui s’élève à 600, représente 1,5 fois celui de web2 et plus de 4 fois celui de web3.
- web1 – 600 connexions actives ÷ 6 = 100
- web2 – 400 connexions actives ÷ 3 = 133
- web3 – 125 connexions actives ÷ 1 = 125
Résumé
Après avoir examiné les avantages et les inconvénients des techniques de répartition de charge disponibles dans NGINX Plus et NGINX, nous estimons que la méthode Least Connections (et, pour NGINX Plus, la méthode Least Time) est la plus adaptée au plus grand nombre de cas d’usage. Il est toutefois important de tester plusieurs méthodes dans votre environnement de déploiement, car la combinaison particulière des caractéristiques de votre trafic et de vos serveurs pourrait rendre une autre méthode plus adaptée à vos besoins.
Pour tester vous-même l’équilibrage de charge de NGINX Plus, commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
Nous aimerions connaître vos expériences en matière de répartition de charge dans différents cas d’utilisation. N’hésitez pas à les partager dans la section des commentaires ci-dessous.
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.