Dans notre précédente série d’articles de blog, « Déploiement de services applicatifs dans Kubernetes », nous avons abordé un modèle que nous observons chez de nombreux clients au cours de leur transformation numérique. La plupart de ces parcours commencent par le modèle traditionnel de création et de déploiement d’applications (généralement monolithiques), dans lequel la responsabilité de ces deux fonctions est répartie entre des équipes de développement et d’exploitation cloisonnées. À mesure que les entreprises adoptent un modèle plus moderne, elles créent des applications basées sur des microservices et les déploient à l’aide de pratiques DevOps qui estompent la séparation entre les silos traditionnels.
Alors que les équipes DevOps et les responsables d’applications prennent plus directement en main le déploiement, la gestion et la mise à disposition de leurs applications, il est souvent peu réaliste de décloisonner entièrement les équipes en une seule fois – et nous ne pensons d’ailleurs pas que cela soit nécessaire. Nous constatons plutôt qu’une répartition logique des responsabilités reste pertinente :
- Les équipes réseau et sécurité continuent de se concentrer sur la sécurité, les performances et la disponibilité globales de l’infrastructure de l’entreprise. Elles s’intéressent principalement aux services globaux, qui sont généralement déployés à la « porte d’entrée » de cette infrastructure. Ces équipes s’appuient sur F5 BIG-IP pour des cas d’utilisation tels que l’équilibrage global de la charge des serveurs (GSLB), la résolution DNS et l’équilibrage de charge, ainsi que la gestion avancée du trafic. BIG‑IQ et NGINX Controller [désormais F5 NGINX Management Suite] fournissent des métriques et des alertes sous une forme adaptée aux besoins des équipes NetOps. Ils offrent également aux équipes SecOps la visibilité et le contrôle de la sécurité dont elles ont besoin pour protéger les actifs de l’organisation et respecter les réglementations du secteur.
- Les équipes d’exploitation (DevOps avec une dominante Ops) créent et gèrent des applications individuelles en fonction des besoins des secteurs d’activité auxquels elles sont rattachées. Elles s’intéressent principalement aux services tels que l’automatisation et les pipelines CI/CD, qui leur permettent d’itérer plus rapidement sur les nouvelles fonctionnalités. Ces services sont généralement déployés au plus près de l’application, par exemple dans un environnement Kubernetes. Ces équipes s’appuient sur des produits NGINX tels que NGINX Plus, NGINX App Protect, NGINX Ingress Controller et NGINX Service Mesh pour assurer l’équilibrage de charge et la gestion du trafic des applications distribuées basées sur des microservices et hébergées dans plusieurs environnements, notamment des clusters Kubernetes. Les cas d’usage comprennent la terminaison TLS, le routage basé sur l’hôte, la réécriture d’URI, l’authentification JWT, la persistance des sessions, la limitation du débit, les contrôles d’intégrité, la sécurité (avec NGINX App Protect comme WAF intégré), et bien plus encore.
NetOps et DevOps dans les environnements Kubernetes
Les préoccupations différentes des équipes NetOps et DevOps se reflètent dans les rôles qu’elles jouent au sein des environnements Kubernetes et dans les outils qu’elles utilisent pour les remplir. Au risque de simplifier à l’excès, nous pouvons dire que les équipes NetOps s’occupent principalement de l’infrastructure et des fonctionnalités réseau situées à l’extérieur du cluster Kubernetes, tandis que les équipes DevOps se chargent de ces fonctionnalités à l’intérieur du cluster.
Pour acheminer le trafic vers les clusters Kubernetes, les équipes NetOps peuvent utiliser BIG‑IP comme équilibreur de charge externe prenant en charge les fonctionnalités et les différentes technologies de réseau overlay qu’elles connaissent déjà. Toutefois, BIG‑IP ne peut pas, à lui seul, suivre les modifications apportées à l’ensemble des pods au sein du cluster Kubernetes (par exemple, les changements concernant le nombre de pods ou leurs adresses IP). Pour contourner cette contrainte, F5 Container Ingress Services (CIS) est déployé en tant qu’opérateur au sein du cluster. CIS surveille les modifications apportées à l’ensemble des pods et adapte automatiquement en conséquence les adresses du pool d’équilibrage de charge du système BIG‑IP. Il détecte également la création de nouvelles ressources Ingress, Route et personnalisées, puis met à jour la configuration de BIG‑IP en conséquence.
Bien que vous puissiez utiliser BIG‑IP avec CIS pour répartir directement la charge du trafic vers les pods applicatifs, dans la pratique, NGINX Ingress Controller est la solution idéale pour détecter et suivre les changements dynamiques apportés aux pods et aux charges de travail applicatives qui représentent un grand nombre de services – par exemple, lors de la mise à l’échelle horizontale de vos pods applicatifs pour répondre aux variations de la demande.
Un autre avantage du déploiement de NGINX Ingress Controller est qu’il confie le contrôle de l’équilibrage de charge des applications aux équipes DevOps responsables de ces applications. Son plan de contrôle hautes performances et sa conception axée sur le DevOps le rendent particulièrement adapté aux cas d’usage DevOps évoluant rapidement, tels que les reconfigurations sur place et les mises à jour progressives, pour les services Kubernetes répartis dans plusieurs espaces de noms. NGINX Ingress Controller utilise l’API Kubernetes native pour détecter les pods à mesure qu’ils sont mis à l’échelle.
Comment BIG-IP et NGINX Ingress Controller fonctionnent ensemble
Comme vous le savez peut-être, BIG‑IP et NGINX Ingress Controller ont été conçus à l’origine par deux entreprises distinctes (respectivement F5 et NGINX). Depuis l’acquisition de NGINX par F5, nos clients nous ont indiqué qu’une meilleure interopérabilité entre les deux outils simplifierait la gestion de leur infrastructure. Pour répondre à cette demande, nous avons développé une nouvelle ressource Kubernetes appelée IngressLink.
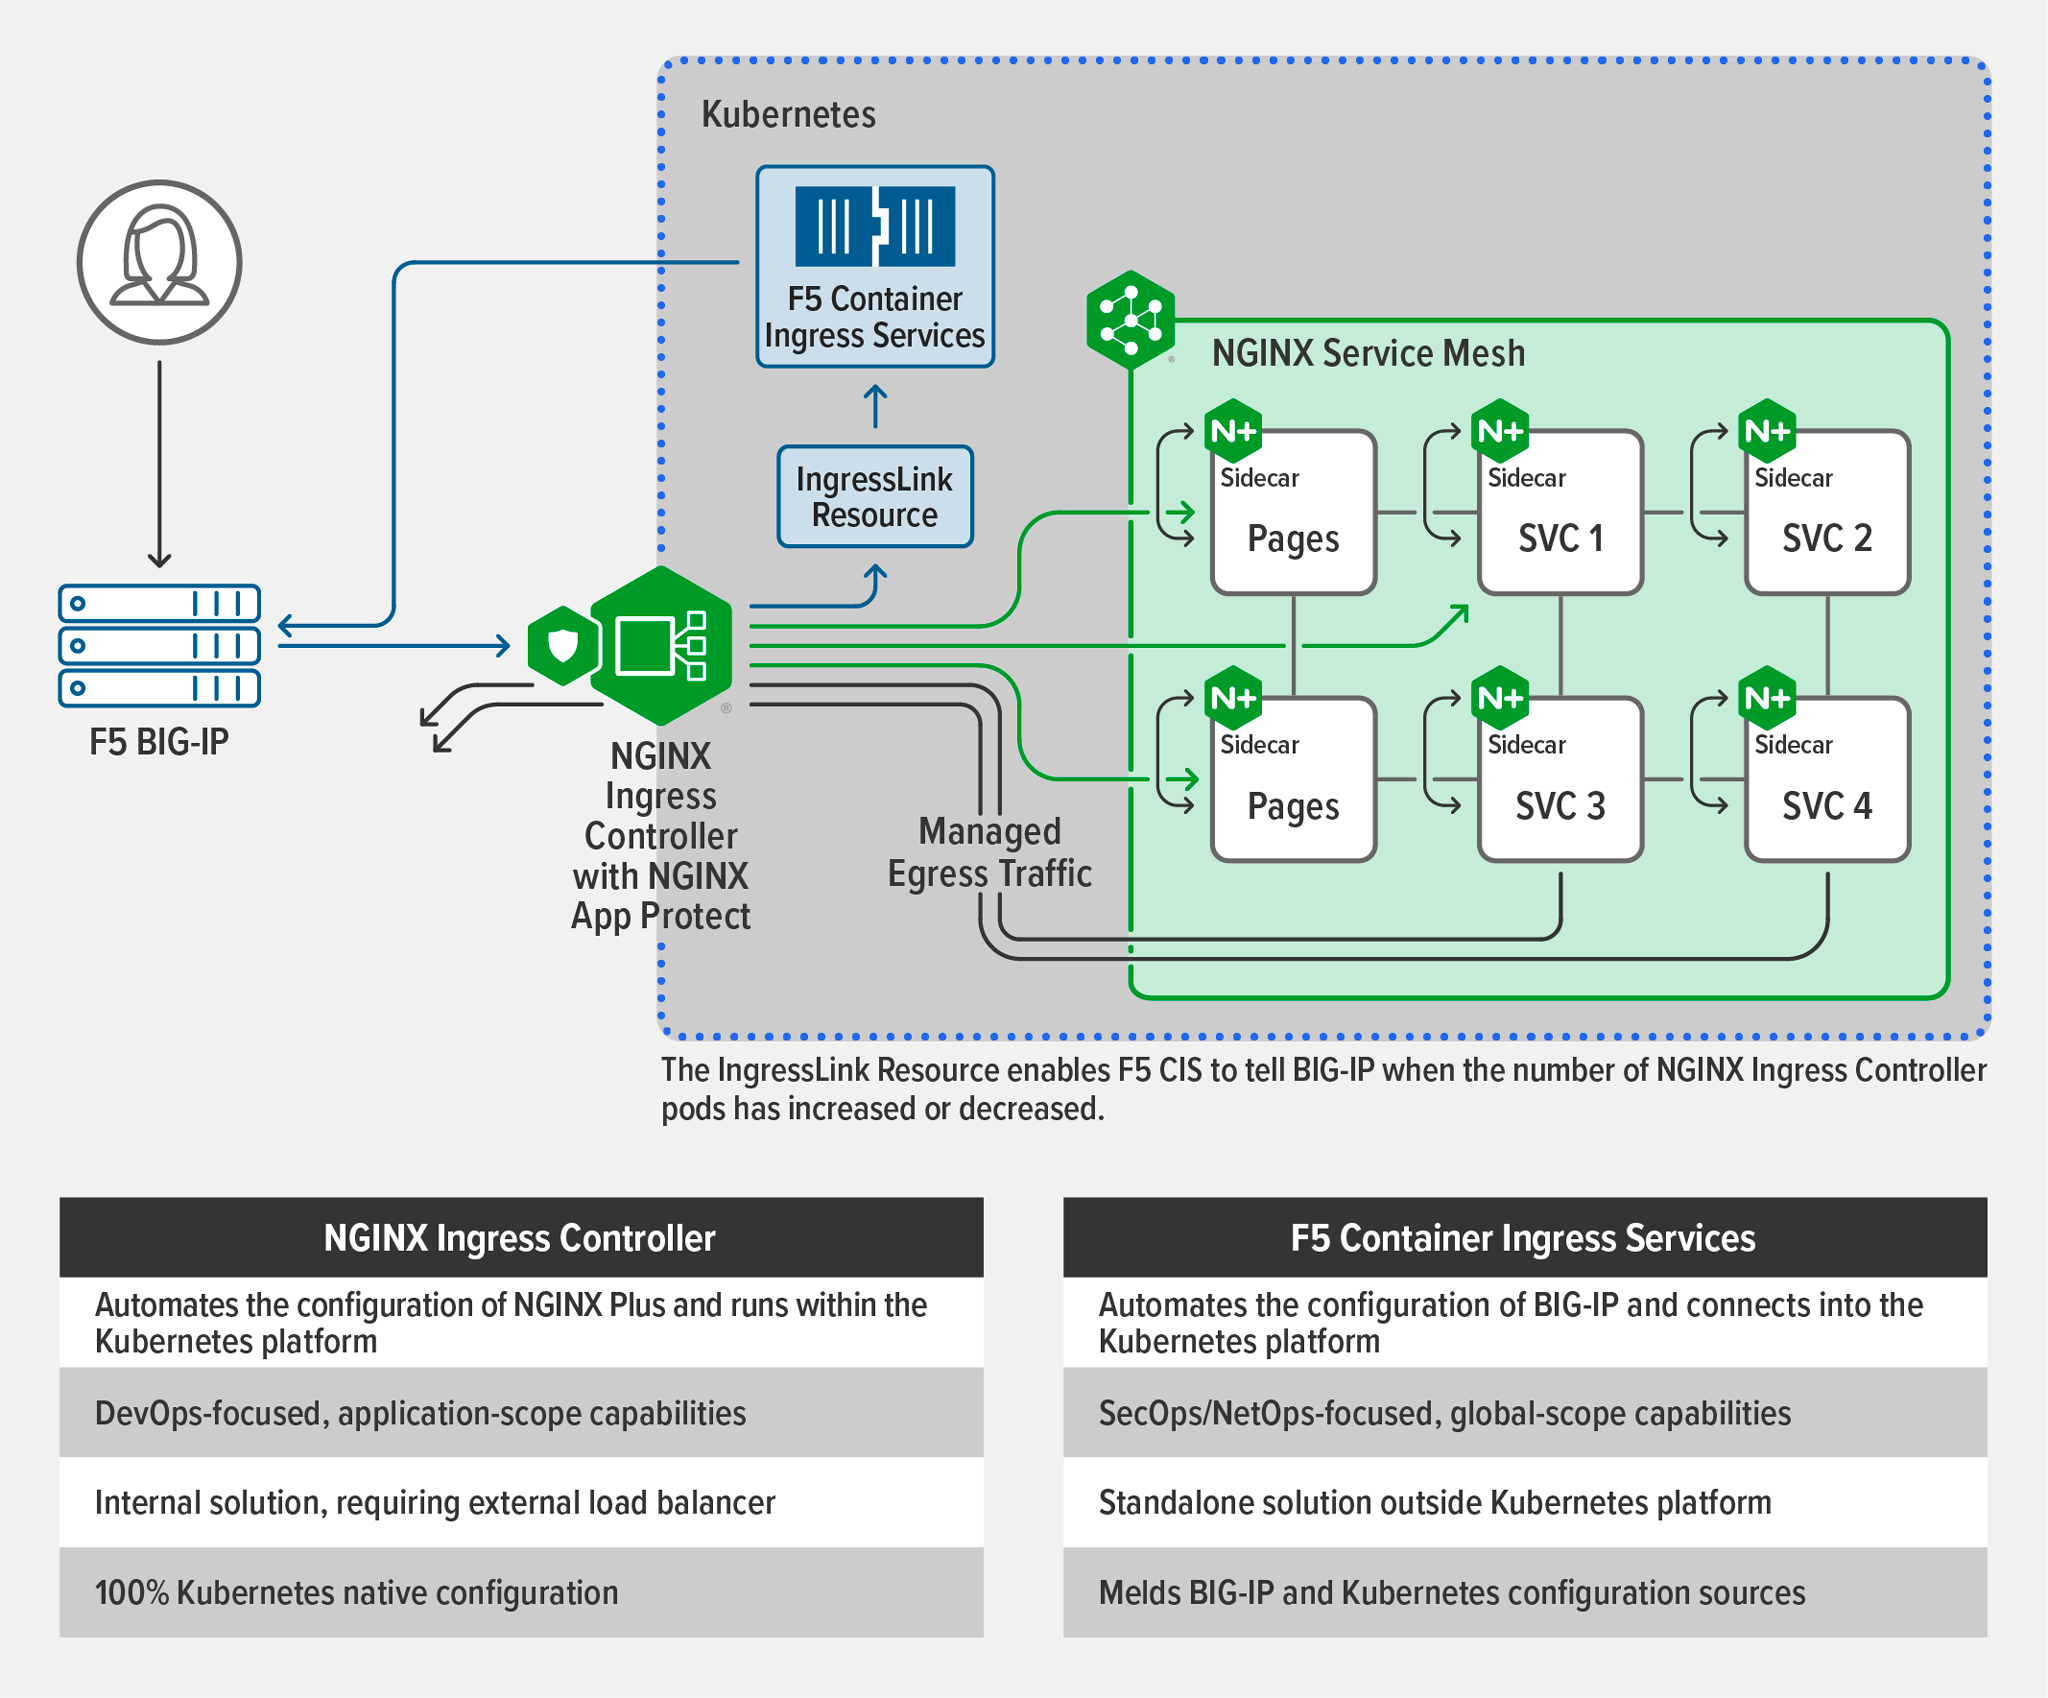
La ressource IngressLink est une amélioration simple qui utilise une CustomResourceDefinition (CRD) Kubernetes pour « relier » NGINX Ingress Controller et BIG‑IP. En termes simples, elle permet à CIS d’« informer » BIG‑IP chaque fois que l’ensemble des pods NGINX Ingress Controller change. Grâce à ces informations, BIG‑IP peut adapter rapidement ses stratégies d’équilibrage de charge correspondantes.
Avec BIG‑IP déployé pour assurer l’équilibrage de charge vers les clusters Kubernetes et NGINX Ingress Controller gérant le trafic entrant et sortant, le flux de trafic se présente comme suit :
- BIG‑IP dirige le trafic externe vers les instances du contrôleur d’entrée NGINX.
- NGINX Ingress Controller distribue le trafic vers les services appropriés au sein du cluster.
- Grâce à l’efficacité exceptionnelle de NGINX Ingress Controller, un ensemble stable d’instances peut gérer des modifications fréquentes et importantes de l’ensemble des pods applicatifs. Toutefois, lorsque votre NGINX Ingress Controller doit augmenter ou réduire sa capacité horizontalement (pour faire face aux hausses et aux baisses de trafic), CIS informe BIG‑IP de ces changements (via la ressource IngressLink), ce qui permet à BIG‑IP de s’y adapter rapidement.
Bien démarrer
Pour en savoir plus sur le fonctionnement de la ressource IngressLink, notamment grâce à un guide de déploiement, consultez F5 CloudDocs.
Pour commencer, demandez votre essai gratuit de 30 jours de NGINX Ingress Controller avec NGINX App Protect WAF et DoS. Si vous n’utilisez pas encore BIG‑IP, sélectionnez l’essai sur F5.com qui convient le mieux à votre équipe.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.