Cet article de blog explique comment configurer NGINX Open Source et NGINX Plus en tant que proxy transparent pour le trafic à destination des serveurs en amont. Il explique comment utiliser un proxy transparent pour usurper l’adresse IP source des paquets afin de mettre en œuvre la transparence IP, ainsi que la manière d’implémenter un mode d’équilibrage de charge appelé Direct Server Return pour le trafic UDP.
Les informations contenues dans cet article s’appliquent à la fois à NGINX Open Source et à NGINX Plus. Par souci de concision, nous parlerons uniquement de NGINX Plus.
Note de la rédaction – Voici le cinquième article d’une série consacrée à l’exploration approfondie des nouvelles fonctionnalités de NGINX Plus R10.
- Authentification des clients d’API avec JWT et NGINX Plus
- NGINX Plus R10 exploite la puissance d’IBM POWER
- Authentification des utilisateurs auprès d’applications existantes avec OpenID Connect et NGINX Plus
- Utiliser le module JavaScript de NGINX pour migrer progressivement les clients vers un nouveau serveur
- Transparence IP et retour direct au serveur avec NGINX et NGINX Plus en tant que proxy transparent (cet article)
N’oubliez pas non plus de regarder le webinaire à la demande, « Quelles sont les nouveautés de NGINX Plus R10 ? »
Résumé
NGINX Plus fonctionne comme un proxy inverse de couche 7. Cela permet à NGINX Plus d’appliquer diverses optimisations et améliorations aux requêtes réseau qu’il gère.
Par conséquent, les serveurs en amont (avec répartition de charge) constatent que tout le trafic provient d’une adresse IP du proxy NGINX Plus. Cela pose problème si le serveur en amont doit déterminer la véritable adresse IP d’origine (celle du client distant), par exemple à des fins d’authentification ou de journalisation.
Il existe des solutions de contournement efficaces pour le trafic HTTP et HTTPS, qui utilisent soit l’en-tête HTTP X-Forwarded-For, soit le protocole PROXY. Cet article décrit deux méthodes supplémentaires qui s’appliquent au trafic TCP et UDP :
- Transparence IP garantit que les serveurs en amont voient chaque connexion comme provenant du client distant qui l’a initiée. Elle s’applique aux protocoles basés sur TCP et UDP.
- Retour direct du serveur (DSR) permet en outre aux réponses des serveurs en amont d’être envoyées directement aux clients distants, sans passer par l’équilibreur de charge intermédiaire. Il s’applique aux protocoles basés sur UDP et peut être mis en œuvre en effectuant une traduction d’adresses réseau (NAT) sur le serveur d’origine ou sur un routeur intermédiaire.
Méthode 1 – Transparence IP Méthode 2a – DSR (NAT sur le routeur) Méthode 2b – DSR (NAT à l’origine)Protocoles pris en charge Protocoles TCP et UDP UDP uniquement UDP uniquementRoutage du trafic par les serveurs en amont Tout le trafic sortant est acheminé vers le proxy NGINX Plus, où il est terminé Tout le trafic sortant est acheminé via le serveur NGINX Plus intermédiaire Tout le trafic est acheminé normalementPerformances Standard : le trafic sortant est terminé sur le proxy NGINX Plus Meilleures : le trafic sortant est transféré par le serveur NGINX Plus intermédiaire Optimales : le trafic sortant est acheminé directement vers le client distant, sans passer par NGINX PlusContrôles d’intégrité Passifs par défaut ; contrôles actifs pris en charge Contrôles actifs requis ; contrôles passifs impossibles Contrôles actifs requis ; contrôles passifs impossiblesConfiguration requiseTCP et UDP sur le proxy NGINX Plus TCP : fonctionne par défaut
UDP : proxy_responses 1 TCP : non pris en charge
UDP : proxy_responses 0 TCP : non pris en charge
UDP : proxy_responses 0Comment et où les paquets sont-ils traités ? iptables termine les connexions sur le proxy NGINX Plus tc nat effectue les réécritures sur le serveur NGINX Plus intermédiaire tc nat effectue les réécritures sur les serveurs en amontConfiguration réseau sur le proxy NGINX Plus iptables pour capturer les paquets sortants Transfert IP et NAT sans état AucuneConfiguration réseau sur le serveur en amont Définir NGINX Plus comme route par défaut Définir NGINX Plus comme route par défaut NAT sans état
Le déploiement et le dépannage de la transparence IP et du DSR sont complexes. N’implémentez ces configurations que si le mode de fonctionnement standard du proxy inverse ne suffit pas pour votre application ou votre service.
Introduction : flux de paquets dans un proxy inverse standard de couche 7
Contrairement à un commutateur ou à un routeur qui se contente de transférer les paquets, NGINX Plus fonctionne comme un proxy inverse de couche 7. Dans ce mode de fonctionnement, NGINX Plus gère des connexions TCP distinctes côté client et côté serveur en amont (pour le trafic HTTP et TCP), ou des sessions UDP, afin de contrôler la communication entre le client distant et le serveur en amont sélectionné.
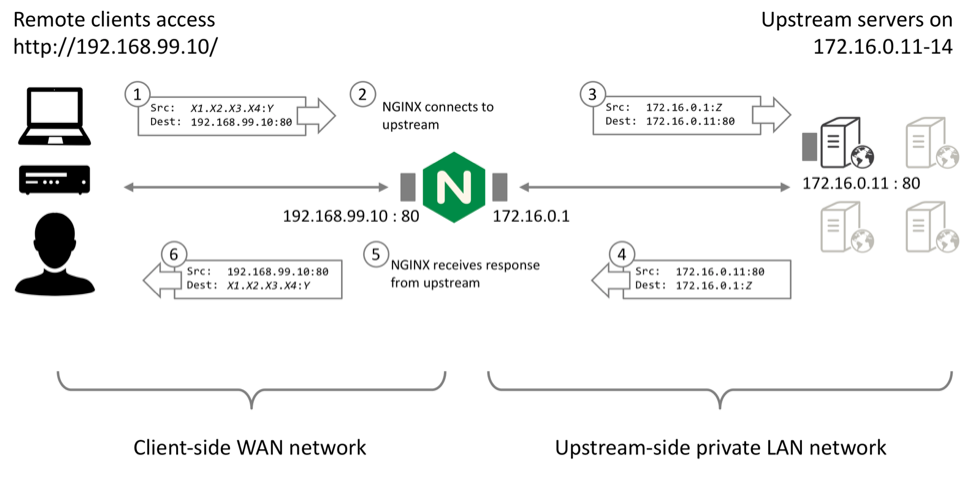
- Les clients distants établissent des connexions TCP ou envoient des datagrammes UDP directement au proxy inverse NGINX Plus, à l’adresse IP et au port publiés. NGINX Plus met fin à la connexion TCP ou à la session UDP et lit les données de la requête qu’elle contient.
- NGINX Plus établit ensuite une nouvelle connexion (ou réutilise une connexion inactive existante) au serveur en amont sélectionné (avec équilibrage de charge).
- Lorsque NGINX Plus transmet la requête au serveur en amont, la connexion provient de l’adresse IP interne de NGINX Plus.
- Lorsque le serveur en amont répond à la requête, il envoie les données à l’adresse IP interne de NGINX Plus.
- NGINX Plus reçoit les données de réponse sur la connexion côté serveur en amont. Il peut traiter ou modifier la réponse (par exemple, en appliquant une compression à une réponse HTTP).
- NGINX Plus écrit ensuite les données de réponse sur la connexion côté client.
L’une des conséquences de ce mode de fonctionnement standard du proxy inverse est que le serveur en amont constate que le trafic TCP et UDP provient du proxy NGINX Plus local.
Avantages et limites du mode proxy inverse de couche 7
Le mode de fonctionnement en proxy inverse de couche 7 offre des gains de performances et d’efficacité considérables pour le trafic HTTP et TCP (notamment grâce aux optimisations TCP, à la mise en mémoire tampon et à la réutilisation des connexions persistantes HTTP). Il présente toutefois une difficulté lorsque le serveur en amont doit déterminer l’adresse IP d’origine réelle de la connexion ou de la session, notamment à des fins d’authentification et de contrôle d’accès, de limitation du débit et de journalisation.
Pour certains protocoles, NGINX Plus peut utiliser l’en-tête HTTP X-Forwarded-For ou le protocole PROXY pour transmettre l’adresse IP d’origine aux serveurs en amont. Cet article décrit deux méthodes supplémentaires, rendues possibles par le paramètre transparent de la directive proxy_bind, introduit dans NGINX Plus Release 10 (R10)<.htmla>.
Méthode 1 : transparence IP
L’objectif de la transparence IP est de masquer la présence du proxy inverse afin que le serveur d’origine considère que les paquets IP proviennent de l’adresse IP du client. La transparence IP peut être utilisée avec les protocoles basés sur TCP et UDP.
Création d’un service de proxy inverse HTTP sur l’équilibreur de charge NGINX Plus
Pour illustrer la transparence IP, nous commençons par créer un cluster à charge répartie composé de quatre serveurs web qui renvoient quelques informations simples sur la connexion.
- Configurez un serveur virtuel HTTP simple qui répartit la charge du trafic entre un groupe de serveurs en amont :
# in the 'http' context
server {
    listen 80;

    location / {
        proxy_pass http://http_upstreams;
    }
}

upstream http_upstreams {
    server 172.16.0.11;
    server 172.16.0.12;
    server 172.16.0.13;
    server 172.16.0.14;
}- Pour vérifier que les serveurs en amont constatent que les connexions proviennent de l’équilibreur de charge NGINX Plus, configurez un serveur Web NGINX Plus sur chacun des quatre serveurs (de 172.16.0.11 à 172.16.01.14), avec un serveur virtuel simple qui renvoie des informations sur la connexion, par exemple :
# in the 'http' context
server {
    listen 80;

    location / {
        return 200 "Hello from $hostname. You connected from $remote_addr:$remote_port to $server_addr:$server_portn";
    }
}
Lorsque nous testons cette configuration, les serveurs en amont indiquent que les connexions proviennent de l’adresse IP locale de NGINX Plus (172.16.0.1) :
$ for i in {1..4}; do curl http://192.168.99.10 ; done
Hello from dev1. You connected from 172.16.0.1:42723 to 172.16.0.11:80
Hello from dev2. You connected from 172.16.0.1:39117 to 172.16.0.12:80
Hello from dev3. You connected from 172.16.0.1:54545 to 172.16.0.13:80
Hello from dev4. You connected from 172.16.0.1:57020 to 172.16.0.14:80
Configuration de NGINX Plus et de vos serveurs en amont pour la transparence IP
NGINX Plus R10 et versions ultérieures (ainsi que NGINX Open Source 1.11.0 et versions ultérieures) peuvent usurper l’adresse source du trafic en amont. Ajoutez le paramètre « transparent » à la directive « proxy_bind ». Le plus souvent, vous définissez comme adresse source celle du client distant :
proxy_bind $remote_addr transparent;Cette étape simple pose toutefois un défi de taille, car vous devez vous assurer que le trafic de réponse (sortant) à destination du client distant est correctement géré. Le trafic de réponse doit être acheminé vers NGINX Plus, qui doit mettre fin à la connexion TCP en amont. NGINX Plus envoie ensuite le trafic de réponse au client distant via la connexion TCP du client.
Vous devez apporter plusieurs modifications à la configuration, à la fois sur l’équilibreur de charge NGINX Plus et sur chaque serveur en amont :
- Sur l’équilibreur de charge NGINX Plus, configurez les processus de travail pour qu’ils s’exécutent en tant que
root, afin qu’ils puissent lier les sockets en amont à des adresses arbitraires. Dans le contexte principal (de niveau supérieur) du fichier /etc/nginx/nginx.conf, incluez la directiveuserpour définir l’identité des processus de travail NGINX Plus surroot:
# in the 'main' context
# 'user daemon' is the default; change to 'user root' with transparent proxy_bind
user root;- Sur l’équilibreur de charge NGINX Plus, assurez-vous que chaque connexion provient de l’adresse du client distant. Ajoutez la directive
proxy_bindavec le paramètretransparentà la configuration du serveur virtuel :
# in the 'http' context
server {
    listen 80;

    location / {
        proxy_bind $remote_addr transparent;
        proxy_pass http://http_upstreams;
    }
}- Sur l'équilibreur de charge NGINX Plus, configurez
iptablesafin de capturer les paquets de retour des serveurs en amont et de les transmettre à NGINX Plus. Dans cet exemple, nous exécutons les commandesiptablesetipruleafin de capturer tout le trafic TCP sur le port 80 provenant des serveurs représentés par la plage d'adresses IP 172.16.0.0/28 :
# ip rule add fwmark 1 lookup 100
# ip route add local 0.0.0.0/0 dev lo table 100
# iptables -t mangle -A PREROUTING -p tcp -s 172.16.0.0/28 --sport 80 -j MARK --set-xmark 0x1/0xffffffff- Exécutez la commande suivante pour afficher (
-L) la configuration actuelle de la table mangle d’iptables:
# iptables -t mangle -L
Chain PREROUTING (policy ACCEPT)
target     prot opt source               destination
MARK       tcp  --  172.16.0.0/28        anywhere             tcp spt:http MARK set 0x1

Chain INPUT (policy ACCEPT)
target     prot opt source               destination

Chain FORWARD (policy ACCEPT)
target     prot opt source               destination

Chain OUTPUT (policy ACCEPT)
target     prot opt source               destination

Chain POSTROUTING (policy ACCEPT)
target prot opt source destination- Sur les serveurs en amont, configurez le routage de sorte que tout le trafic de retour soit transféré vers NGINX Plus. Sur chaque serveur en amont, supprimez toute route par défaut préexistante et configurez comme route par défaut l’adresse IP de l’équilibreur de charge/proxy inverse NGINX Plus. Notez que cette adresse IP doit se trouver sur le même sous-réseau que l’une des interfaces du serveur en amont.
# route del default gw 10.0.2.2
# route add default gw 172.16.0.1- Vérifiez que la table de routage semble cohérente :
# route -n
Kernel IP routing table
Destination   Gateway     Genmask        Flags Metric Ref Use Iface
0.0.0.0       172.16.0.1  0.0.0.0        UG    0      0     0 eth2
10.0.2.0      0.0.0.0     255.255.255.0  U     0      0     0 eth0
172.16.0.0    0.0.0.0     255.255.255.0  U     0      0     0 eth2
192.168.56.0 0.0.0.0 255.255.255.0 U 0 0 0 eth1- Si vos serveurs en amont doivent pouvoir se connecter à des serveurs externes, vous devez également configurer la nouvelle passerelle NGINX Plus pour transférer le trafic et effectuer sa translation d’adresse (masquerading) – consultez la section Autoriser les serveurs en amont à accéder à des serveurs externes ci-dessous.
Test de la configuration de la transparence IP
Vous pouvez maintenant tester la configuration en envoyant des requêtes à NGINX Plus. Veillez à envoyer les requêtes depuis une adresse IP distante qui n’est pas directement routable depuis les serveurs en amont :
$ for i in {1..4}; do curl http://192.168.99.10 ; done
Hello from dev1. You connected from 192.168.99.1:60729 to 172.16.0.11:80
Hello from dev2. You connected from 192.168.99.1:43070 to 172.16.0.12:80
Hello from dev3. You connected from 192.168.99.1:45749 to 172.16.0.13:80
Hello from dev4. You connected from 192.168.99.1:46609 to 172.16.0.14:80
Notez que les connexions semblent désormais provenir de l’adresse IP du client distant (192.168.99.1), plutôt que d’une adresse locale de l’équilibreur de charge NGINX Plus.
Si la configuration ne fonctionne pas, consultez la section « Dépannage » ci-dessous.
Résumé : comment fonctionne la configuration de la transparence IP ?
- NGINX Plus reçoit une requête HTTP d’un client distant (192.168.99.1).
- NGINX Plus prend une décision de répartition de charge et sélectionne un serveur en amont (par exemple, 172.16.0.11) auquel se connecter. Avant d’établir la connexion, NGINX Plus lie son socket en amont à l’adresse du client distant.
- Le serveur en amont reçoit la connexion, qui semble provenir directement du client distant.
- Le serveur en amont répond en adressant les paquets à l’adresse du client distant et en les acheminant via NGINX Plus (le routeur par défaut).
- La règle
iptablesde l’équilibreur de charge NGINX Plus marque ces paquets et le routage les achemine localement. - NGINX Plus lit la réponse.
- NGINX Plus envoie ensuite la réponse au client distant.
En définitive, du point de vue des serveurs en amont, les connexions semblent provenir directement des clients distants.
Méthode 2 : retour direct du serveur
Le retour direct du serveur (DSR) est une extension du concept de transparence IP. Avec la transparence IP, le serveur en amont reçoit des paquets qui semblent provenir du client distant. Avec le DSR, le serveur en amont répond en outre directement au client distant ; les paquets de retour contournent entièrement l’équilibreur de charge.
Le DSR peut apporter un léger gain de performances en réduisant la charge sur l’équilibreur de charge, mais il présente plusieurs limitations :
- L’équilibreur de charge ne voit jamais les paquets de retour et ne peut donc pas déterminer si le serveur en amont répond ou s’il est en panne.
- L’équilibreur de charge ne peut pas inspecter une requête au-delà du premier paquet avant de sélectionner un serveur en amont. Sa capacité à prendre des décisions d’équilibrage de charge (routage basé sur le contenu) est donc très limitée.
- L’équilibreur de charge ne peut participer à aucune forme de négociation ni de traitement avec état, comme SSL/TLS.
- La plupart des autres fonctionnalités des contrôleurs de mise à disposition d’applications (ADC), telles que la mise en cache, le multiplexage HTTP et la journalisation, ne sont pas disponibles avec le DSR.
Le DSR présente un intérêt limité pour les protocoles TCP et, dans tous les cas, l’architecture de proxy inverse de NGINX Plus ne peut pas être appliquée au DSR/TCP.
Les protocoles UDP sont beaucoup plus simples et ne présentent aucune des caractéristiques de connexion propres à TCP. Vous pouvez configurer NGINX Plus pour prendre en charge le DSR avec des protocoles UDP tels que DNS, ce qui peut améliorer les performances. Plus précisément, grâce au DSR, NGINX Plus n’a pas besoin de maintenir les sockets UDP ouverts dans l’attente d’un paquet de réponse (ce qui améliore l’évolutivité), et les paquets de réponse peuvent contourner entièrement le traitement de couche 7 de NGINX Plus (ce qui réduit la latence).
En quoi une configuration DSR diffère-t-elle de la transparence IP ?
Il existe trois différences entre une configuration IP Transparency et une configuration DSR pour le trafic UDP :
- NGINX Plus doit usurper à la fois l’adresse IP du client distant et son port lors de l’envoi de datagrammes aux serveurs en amont (
proxy_bind: configuration du port). - NGINX Plus ne doit pas être configuré pour attendre des datagrammes de réponse provenant des serveurs en amont (directive «
proxy_responses0»). - Une étape supplémentaire est nécessaire pour réécrire l’adresse source des datagrammes de retour afin qu’elle corresponde à l’adresse publique de l’équilibreur de charge.
En outre, NGINX Plus doit être configuré pour effectuer des contrôles d’intégrité actifs sur les serveurs en amont. NGINX Plus ne peut pas s’appuyer sur ses contrôles passifs habituels pour vérifier l’état d’un serveur, car il n’observe pas les paquets de réponse envoyés par celui-ci.
Création d’un service de proxy inverse UDP standard
Pour illustrer le DSR, commencez par créer un cluster à charge répartie composé de quatre serveurs DNS qui renvoient des adresses IP différentes lors des recherches du nom « www.example.com ».
Configurez une configuration simple de proxy inverse qui répartit la charge entre les serveurs DNS:
# in the 'stream' context
server {
    listen 53 udp;

    proxy_responses 1;
    proxy_timeout 1s;
    proxy_pass dns_upstreams;
}

upstream dns_upstreams {
    server 172.16.0.11:53;
    server 172.16.0.12:53;
    server 172.16.0.13:53;
    server 172.16.0.14:53;
}
Les directives « proxy_responses » et « proxy_timeout » effectuent une vérification d’intégrité élémentaire. Si un serveur en amont n’envoie pas une réponse dans un délai d’une seconde, NGINX Plus considère que le serveur est défaillant et relance la requête DNS.
Configurez chaque serveur DNS pour qu’il réponde avec sa propre adresse IP aux requêtes concernant « www.example.com » :
$TTL   	604800
@           IN          SOA         ns1.example.com. admin.example.com. (
                              2           ; Serial
                         604800           ; Refresh
                          86400           ; Retry
                        2419200           ; Expire
                         604800 )         ; Negative Cache TTL

example.com.    IN      NS      ns1.example.com.

ns1             IN      A       172.16.0.11
www             IN      A       172.16.0.11
Les tests montrent clairement que NGINX Plus répartit la charge des requêtes entre les serveurs DNS :
$ for i in {1..4} ; do dig +short @192.168.99.10 www.example.com ; done
172.16.0.11
172.16.0.12
172.16.0.13
172.16.0.14
Configuration de NGINX Plus et de vos serveurs UDP en amont pour le DSR
NGINX Plus R10 et versions ultérieures (ainsi que NGINX Open Source 1.11.2 et versions ultérieures) peuvent usurper à la fois l’adresse source et le port du trafic en amont. Ajoutez le paramètre « transparent » à la directive « proxy_bind » :
proxy_bind $remote_addr:$remote_port transparent;Cela permet au serveur en amont de connaître l’adresse IP source complète afin de pouvoir générer des datagrammes de réponse envoyés directement au client distant.
Le serveur en amont génère des paquets de réponse (« sortants ») avec l’adresse IP de destination correcte, mais utilise son adresse IP locale comme adresse source. L’adresse source doit être remplacée par l’adresse IP et le port de l’équilibreur de charge NGINX Plus auquel le client s’est initialement connecté.
Deux méthodes sont possibles :
- NAT du routeur – Réécrivez les paquets sortants sur un routeur intermédiaire (tel que le proxy NGINX Plus)
- NAT d’origine – Réécrivez les paquets sortants lorsqu’ils quittent chaque serveur DNS en amont
Les deux méthodes utilisent la fonctionnalité NAT sans état que vous configurez à l’aide de la commande « tc ». Si les serveurs en amont sont directement connectés à Internet (c’est-à-dire que la topologie ne permet pas d’acheminer les paquets de retour via un routeur intermédiaire que vous contrôlez), vous devez sélectionner la méthode NAT d’origine.
Configuration de NGINX Plus pour le DSR
Les paquets de réponse ne sont pas transmis à NGINX Plus. Vous devez donc désactiver la vérification de l’état que vous avez configurée dans « Création d’un service de proxy inverse UDP standard » : modifiez la directive proxy_responses et désactivez la directive proxy_timeout. Désormais, NGINX Plus n’attend plus de réponses et ne considère pas le serveur en amont comme défaillant lorsqu’il n’en reçoit pas. La désactivation de cette vérification permet également à NGINX Plus de réutiliser immédiatement les ressources de socket.
Incluez également les deux variables « $remote_addr » et « $remote_port » dans le premier paramètre de la directive « proxy_bind », afin que NGINX Plus conserve à la fois l’adresse et le port sources d’origine dans les datagrammes envoyés aux serveurs en amont :
# in the 'stream' context
server {
    listen 53 udp;

    proxy_bind $remote_addr:$remote_port transparent;
    proxy_responses 0;
    #proxy_timeout 1s;
}
NAT du routeur – Réécriture des paquets sortants sur un routeur intermédiaire
Vous pouvez réécrire les paquets sortants sur un seul routeur intermédiaire. Par exemple, si les serveurs en amont se trouvent sur un réseau privé derrière l’équilibreur de charge NGINX Plus, vous pouvez utiliser celui-ci comme route par défaut et réécrire les paquets lors de leur transfert.
- Configurez chaque serveur en amont afin d’acheminer tout le trafic sortant via le serveur NGINX Plus :
# route add default gw nginx-ip-address- Configurez le serveur NGINX Plus pour transférer le trafic IP :
# sysctl -w net.ipv4.ip_forward=1- Configurez le serveur NGINX Plus pour effectuer une réécriture NAT sans état :
# tc qdisc add dev eth0 root handle 10: htb
# tc filter add dev eth0 parent 10: protocol ip prio 10 u32 match ip src 172.16.0.11 match ip sport 53 action nat egress 172.16.0.11 192.168.99.10
# tc filter add dev eth0 parent 10: protocol ip prio 10 u32 match ip src 172.16.0.12 match ip sport 53 action nat egress 172.16.0.12 192.168.99.10
# tc filter add dev eth0 parent 10: protocol ip prio 10 u32 match ip src 172.16.0.13 match ip sport 53 action nat egress 172.16.0.13 192.168.99.10
# tc filter add dev eth0 parent 10: protocol ip prio 10 u32 match ip src 172.16.0.14 match ip sport 53 action nat egress 172.16.0.14 192.168.99.10- Veillez à sélectionner l’interface de sortie appropriée ainsi que les adresses IP adéquates de chaque serveur en amont.
Pour plus d’informations sur la NAT sans état, consultez la page de manuel tc nat man page. Selon votre configuration, vous pourrez peut-être regrouper les commandes tc filter en une seule commande en utilisant des masques CIDR pour les paramètres src et egress old.
Pour afficher la configuration actuelle de tc filter, exécutez la commande suivante :
# tc filter show dev eth0NAT d’origine – Réécriture des paquets sortants sur chaque serveur en amont
Si vous pouvez configurer le réseau sur les serveurs en amont, notamment s’ils sont directement connectés à Internet, vous pouvez utiliser la configuration suivante. Elle doit être appliquée à chaque serveur en amont.
Configurez chaque serveur en amont pour effectuer une réécriture NAT sans état :
# tc qdisc add dev eth0 root handle 10: htb
# tc filter add dev eth0 parent 10: protocol ip prio 10 u32 match ip src 172.16.0.11 match ip sport 53 action nat egress 172.16.0.11 192.168.99.10
Veillez à sélectionner l’interface et les adresses IP appropriées sur chaque serveur en amont.
Test de la configuration DSR
Pour tester la configuration, envoyez des requêtes DNS à l’équilibreur de charge NGINX Plus et vérifiez qu’elles sont réparties entre les serveurs en amont.
Le DSR n’a aucun effet directement visible. Vous pouvez être certain qu’il fonctionne si vous avez utilisé la directive proxy_responses 0 pour configurer NGINX Plus afin qu’il n’attende pas de paquets de réponse, alors que vos clients DNS reçoivent bien des réponses réparties entre les serveurs. Vous pouvez également observer le flux de paquets à l’aide de tcpdump, comme décrit dans la section Dépannage ci-dessous.
Résumé : comment fonctionne la configuration DSR ?
- NGINX Plus reçoit un datagramme UDP provenant d’un client distant (192.168.99.1:port).
- NGINX Plus prend une décision d’équilibrage de charge et sélectionne un serveur en amont (par exemple, 172.16.0.11) auquel transmettre le contenu du datagramme. Avant de se connecter, NGINX Plus lie le côté local du socket en amont à l’adresse IP et au port du client distant.
- Le serveur en amont reçoit le datagramme envoyé par NGINX Plus, qui semble provenir directement de l’adresse IP et du port du client distant.
- Le serveur en amont répond en renvoyant des datagrammes au client distant. Il définit l’adresse IP et le port sources des datagrammes de réponse sur sa propre adresse IP locale et son propre port local.
- L’adresse IP source (et le port si nécessaire) est réécrite soit par le serveur en amont (configuration « NAT d’origine »), soit par un routeur intermédiaire (configuration « NAT de routeur »).
- Le client distant reçoit les datagrammes, adressés avec le quadruplet correct (adresses IP et ports source et de destination).
- NGINX Plus ne s’attend pas à recevoir de datagrammes de réponse et ferme immédiatement le socket en amont.
Au final, les paquets de réponse contournent le traitement de couche 7 dans NGINX Plus et sont directement transmis au client distant.
Dépannage
Si la transparence IP ou le DSR ne fonctionne pas comme prévu, suivez les suggestions ci-dessous pour rechercher les causes possibles :
Exécuter en tant que root
Vérifiez que les processus de travail NGINX Plus sont configurés pour s’exécuter en tant que root. Si ce n’est pas le cas, un message semblable au suivant s’affiche dans votre journal d’erreurs lorsque NGINX Plus tente de lier le socket à une adresse non locale :
setsockopt(IP_TRANSPARENT) failed (1: Operation not permitted) while connecting to upstream, client: 192.168.99.1, server: , request: "GET / HTTP/1.1", upstream: "http://172.16.0.11:80/", host: "192.168.99.10"Tester avec ping
Vérifiez que vous pouvez envoyer des requêtes ping aux clients et aux serveurs depuis le proxy NGINX Plus. Les serveurs en amont ne peuvent pas envoyer de requêtes ping aux adresses IP des clients distants, sauf si vous créez d’abord la configuration de routage nécessaire et configurez l’intermédiaire NGINX Plus pour transférer les paquets.
Aucune plage d’adresses IP ne doit se chevaucher
Assurez-vous que les sous-réseaux IP utilisés par les clients distants ne sont pas directement connectés aux serveurs en amont. Si tel est le cas, deux problèmes risquent de se produire :
- La protection de Linux contre le « filtrage du chemin inverse » peut rejeter silencieusement les paquets provenant de NGINX Plus, car l’adresse IP source est associée à un sous-réseau sur une autre interface.
- Les paquets de retour n’empruntent pas la route par défaut, mais sont envoyés directement au client distant connecté localement.
Utilisez tcpdump partout
Au fur et à mesure que vous élaborez la configuration et testez chaque étape intermédiaire, exécutez continuellement tcpdump sur chacun des serveurs afin de vérifier, à chaque étape, que les paquets sont envoyés aux bons points de terminaison et reçus par ceux-ci :
$ sudo tcpdump -i any -n tcp port 80Analysez tout comportement inhabituel à l’aide des vérifications répertoriées ci-dessous.
Vérifier les tables de routage
Vérifiez attentivement les tables de routage sur chaque serveur, en accordant une attention particulière aux serveurs en amont :
# route -n
Kernel IP routing table
Destination     Gateway         Genmask         Flags Metric Ref    Use Iface
0.0.0.0         172.16.0.1      0.0.0.0         UG    0      0        0 eth2
10.0.2.0        0.0.0.0         255.255.255.0   U     0      0        0 eth0
172.16.0.0      0.0.0.0         255.255.255.0   U     0      0        0 eth2
192.168.56.0    0.0.0.0         255.255.255.0   U     0      0        0 eth1
Existe-t-il des routes inattendues ? Pouvez-vous confirmer que tous les paquets du flux seront acheminés vers la bonne destination ? Rappelez-vous que, dans les configurations iptables et NAT du routeur, tous les paquets sortants doivent être acheminés via le proxy intermédiaire NGINX Plus.
Paquets manquants
Si des paquets sont perdus de manière inattendue (tcpdump indique qu’ils sont envoyés par une machine, mais qu’ils ne sont pas reçus par une autre), le filtrage du chemin inverse peut en être la cause silencieuse. Pour désactiver temporairement le filtrage du chemin inverse, exécutez la commande suivante :
# for f in /proc/sys/net/ipv4/conf/*/rp_filter; do echo 0 > $f ; donePermettre aux serveurs en amont d’accéder aux serveurs externes
Si vos serveurs en amont se trouvent sur un réseau privé et utilisent NGINX Plus (ou un autre serveur) comme passerelle par défaut, vous pouvez configurer cette passerelle afin de leur permettre d’accéder à des hôtes externes (sur Internet).
Vous devez activer le transfert IP afin que la passerelle puisse transférer les paquets provenant des serveurs en amont ; le transfert IP est généralement désactivé par défaut. Si les serveurs ne disposent pas d’adresses IP routables (ils utilisent des adresses privées telles que 172.16.0.0/24), vous devez également configurer le masquage IP sur les interfaces externes du serveur de passerelle :
# sysctl -w net.ipv4.ip_forward=1
# iptables -t nat -A POSTROUTING -o eth0 -j MASQUERADE
Vérifiez que vous pouvez envoyer une requête ping à un serveur externe depuis votre serveur en amont interne :
root@dev1:~# ping 8.8.8.8
PING 8.8.8.8 (8.8.8.8) 56(84) bytes of data.
64 bytes from 8.8.8.8: icmp_seq=1 ttl=61 time=6.72 ms
64 bytes from 8.8.8.8: icmp_seq=2 ttl=61 time=5.49 ms
^C
Pour afficher votre configuration actuelle de transfert, de routage et de iptables nat, exécutez les trois commandes suivantes :
# sysctl net.ipv4.ip_forward
# route -n
# iptables -t nat -L
Obtenir de l’aide auprès de NGINX
La configuration de la transparence IP ou du retour direct au serveur est complexe, et d’autres équipements réseau intermédiaires peuvent perturber le déploiement en supprimant ou en réécrivant les paquets. Si vous avez besoin d’aide, l’équipe Services professionnels de NGINX est à votre disposition.
Découvrez par vous-même la transparence IP et le DSR avec NGINX Plus : commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.