NodePort, LoadBalancer, contrôleur Ingress… rien que ça !
Lorsque nous discutons avec nos clients et la communauté de la mise en production de Kubernetes, l’une des questions les plus fréquentes est la suivante : ai-je besoin d’un contrôleur Ingress ? La réponse à cette question se résume rarement à un simple oui ou non. Il faut plutôt comprendre les différentes façons d’acheminer le trafic vers vos pods. Dans cet article, nous abordons les principes fondamentaux de la mise en réseau dans Kubernetes afin que vous puissiez décider en toute connaissance de cause si vous avez besoin d’un contrôleur Ingress et, le cas échéant, à quel moment.
Kubernetes prend en charge plusieurs approches et couches possibles pour acheminer le trafic externe vers un pod, mais elles ne se valent pas toutes. Le modèle par défaut est kube-proxy, qui n’est pas réellement un proxy et n’est pas conçu pour répartir la charge du trafic, contrôler les API ou surveiller le comportement des services.
Heureusement, il existe d’autres moyens de gérer le trafic externe, mais avant de poursuivre, faisons un rapide tour d’horizon des composants de Kubernetes :
- Les déploiements Kubernetes sont constitués de nœuds, qui sont des machines physiques ou virtuelles.
- Les nœuds se regroupent pour former un « cluster ».
- Chaque cluster gère des « pods », qui constituent la plus petite unité commune au niveau du réseau et de l’infrastructure dans Kubernetes. Un ou plusieurs pods forment ensemble un « service ».
- Chaque pod contient un ou plusieurs conteneurs (selon la taille de l’application).
Kubernetes surveille les pods qui composent un service et adapte leur nombre selon les besoins de l’application. Mais comment acheminer le trafic vers les pods ? C’est là qu’interviennent deux types d’objets Kubernetes : les services et les contrôleurs Ingress.
Qu’est-ce qu’un service Kubernetes ?
Selon la documentation de Kubernetes, un service est « un moyen abstrait d’exposer une application s’exécutant sur un ensemble de pods ». Un service connecte les pods au sein d’un cluster ou d’un réseau de conteneurs, de sorte que leur emplacement sur un nœud spécifique n’a pas d’importance. Cela permet d’acheminer le trafic externe vers des pods spécifiques même lorsque leur emplacement change, ou lorsqu’ils sont détruits puis redémarrés. Ainsi, un service fonctionne de manière très similaire à un proxy inverse rudimentaire.
Il existe plusieurs types de services et d’objets de service permettant d’acheminer le trafic externe vers Kubernetes. Ils sont souvent confondus, mais chacun remplit en réalité des fonctions très différentes. Il est donc utile de passer en revue leurs rôles, leurs usages et leurs inconvénients.
ClusterIP
ClusterIP est le service par défaut qui fournit, au sein de Kubernetes, un service auquel les autres services du cluster peuvent accéder. Il n’est pas accessible depuis l’extérieur du cluster. La seule façon d’exposer un service ClusterIP consiste à utiliser un outil tel que kube-proxy, mais cela n’est pertinent que dans de rares cas, notamment pour accéder à un service depuis votre ordinateur portable, déboguer un service ou consulter des données de surveillance et des métriques.
NodePort
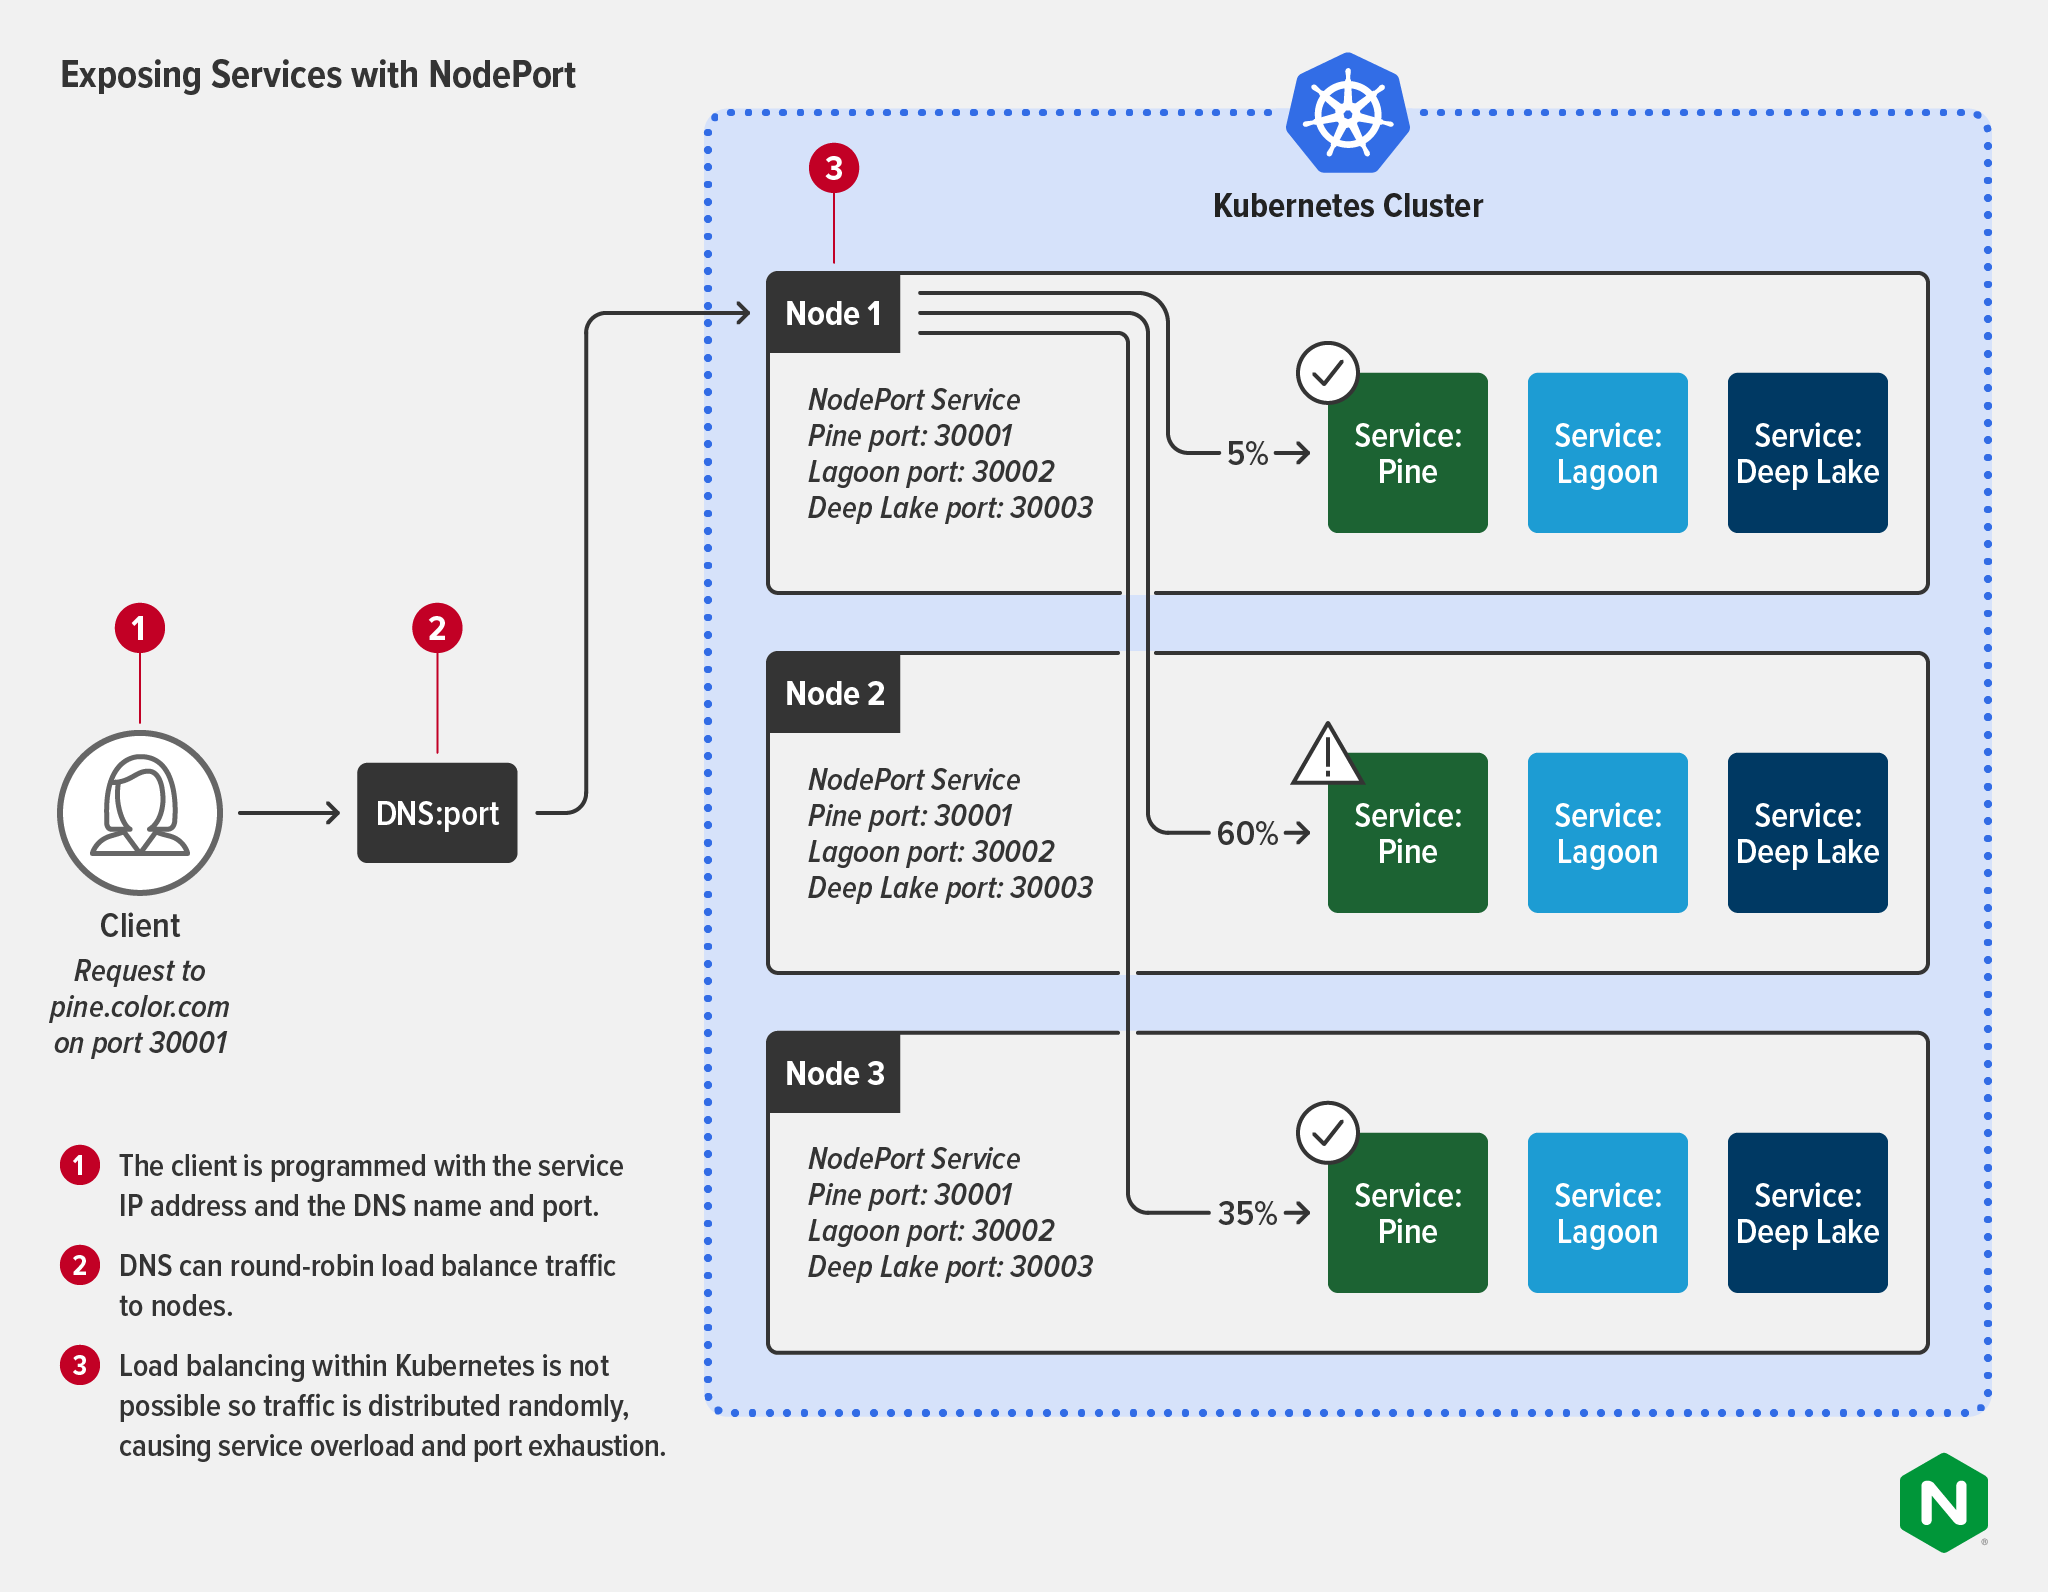
Un service NodePort ouvre un port spécifique sur chaque nœud du cluster et transfère tout trafic envoyé au nœud sur ce port vers l’application correspondante. Il s’agit d’un moyen très rudimentaire d’acheminer le trafic vers vos applications, qui présente de nombreuses limites dans les cas réels de gestion du trafic. Vous ne pouvez avoir qu’un seul service par NodePort et utiliser uniquement les ports compris entre 30000 et 32767. Même si 2768 ports peuvent sembler nombreux, les organisations qui exploitent Kubernetes à grande échelle les épuiseront rapidement. En outre, NodePort utilise des règles de routage de couche 4 ainsi que l’utilitaire Linux iptables, ce qui limite le routage de couche 7.
Outre les limitations de routage, l’utilisation de NodePort présente trois autres inconvénients majeurs :
- Les clients en aval doivent connaître l’adresse IP de chaque nœud pour pouvoir s’y connecter. Cela devient problématique si l’adresse IP du nœud ou l’hôte de la machine virtuelle change.
- NodePort ne peut pas acheminer le trafic vers plusieurs adresses IP.
- Comme le montre le schéma, NodePort n’assure pas l’équilibrage de charge au sein des clusters Kubernetes. Le trafic est donc réparti de manière aléatoire entre les services, ce qui peut entraîner une surcharge des services et un épuisement des ports.
LoadBalancer
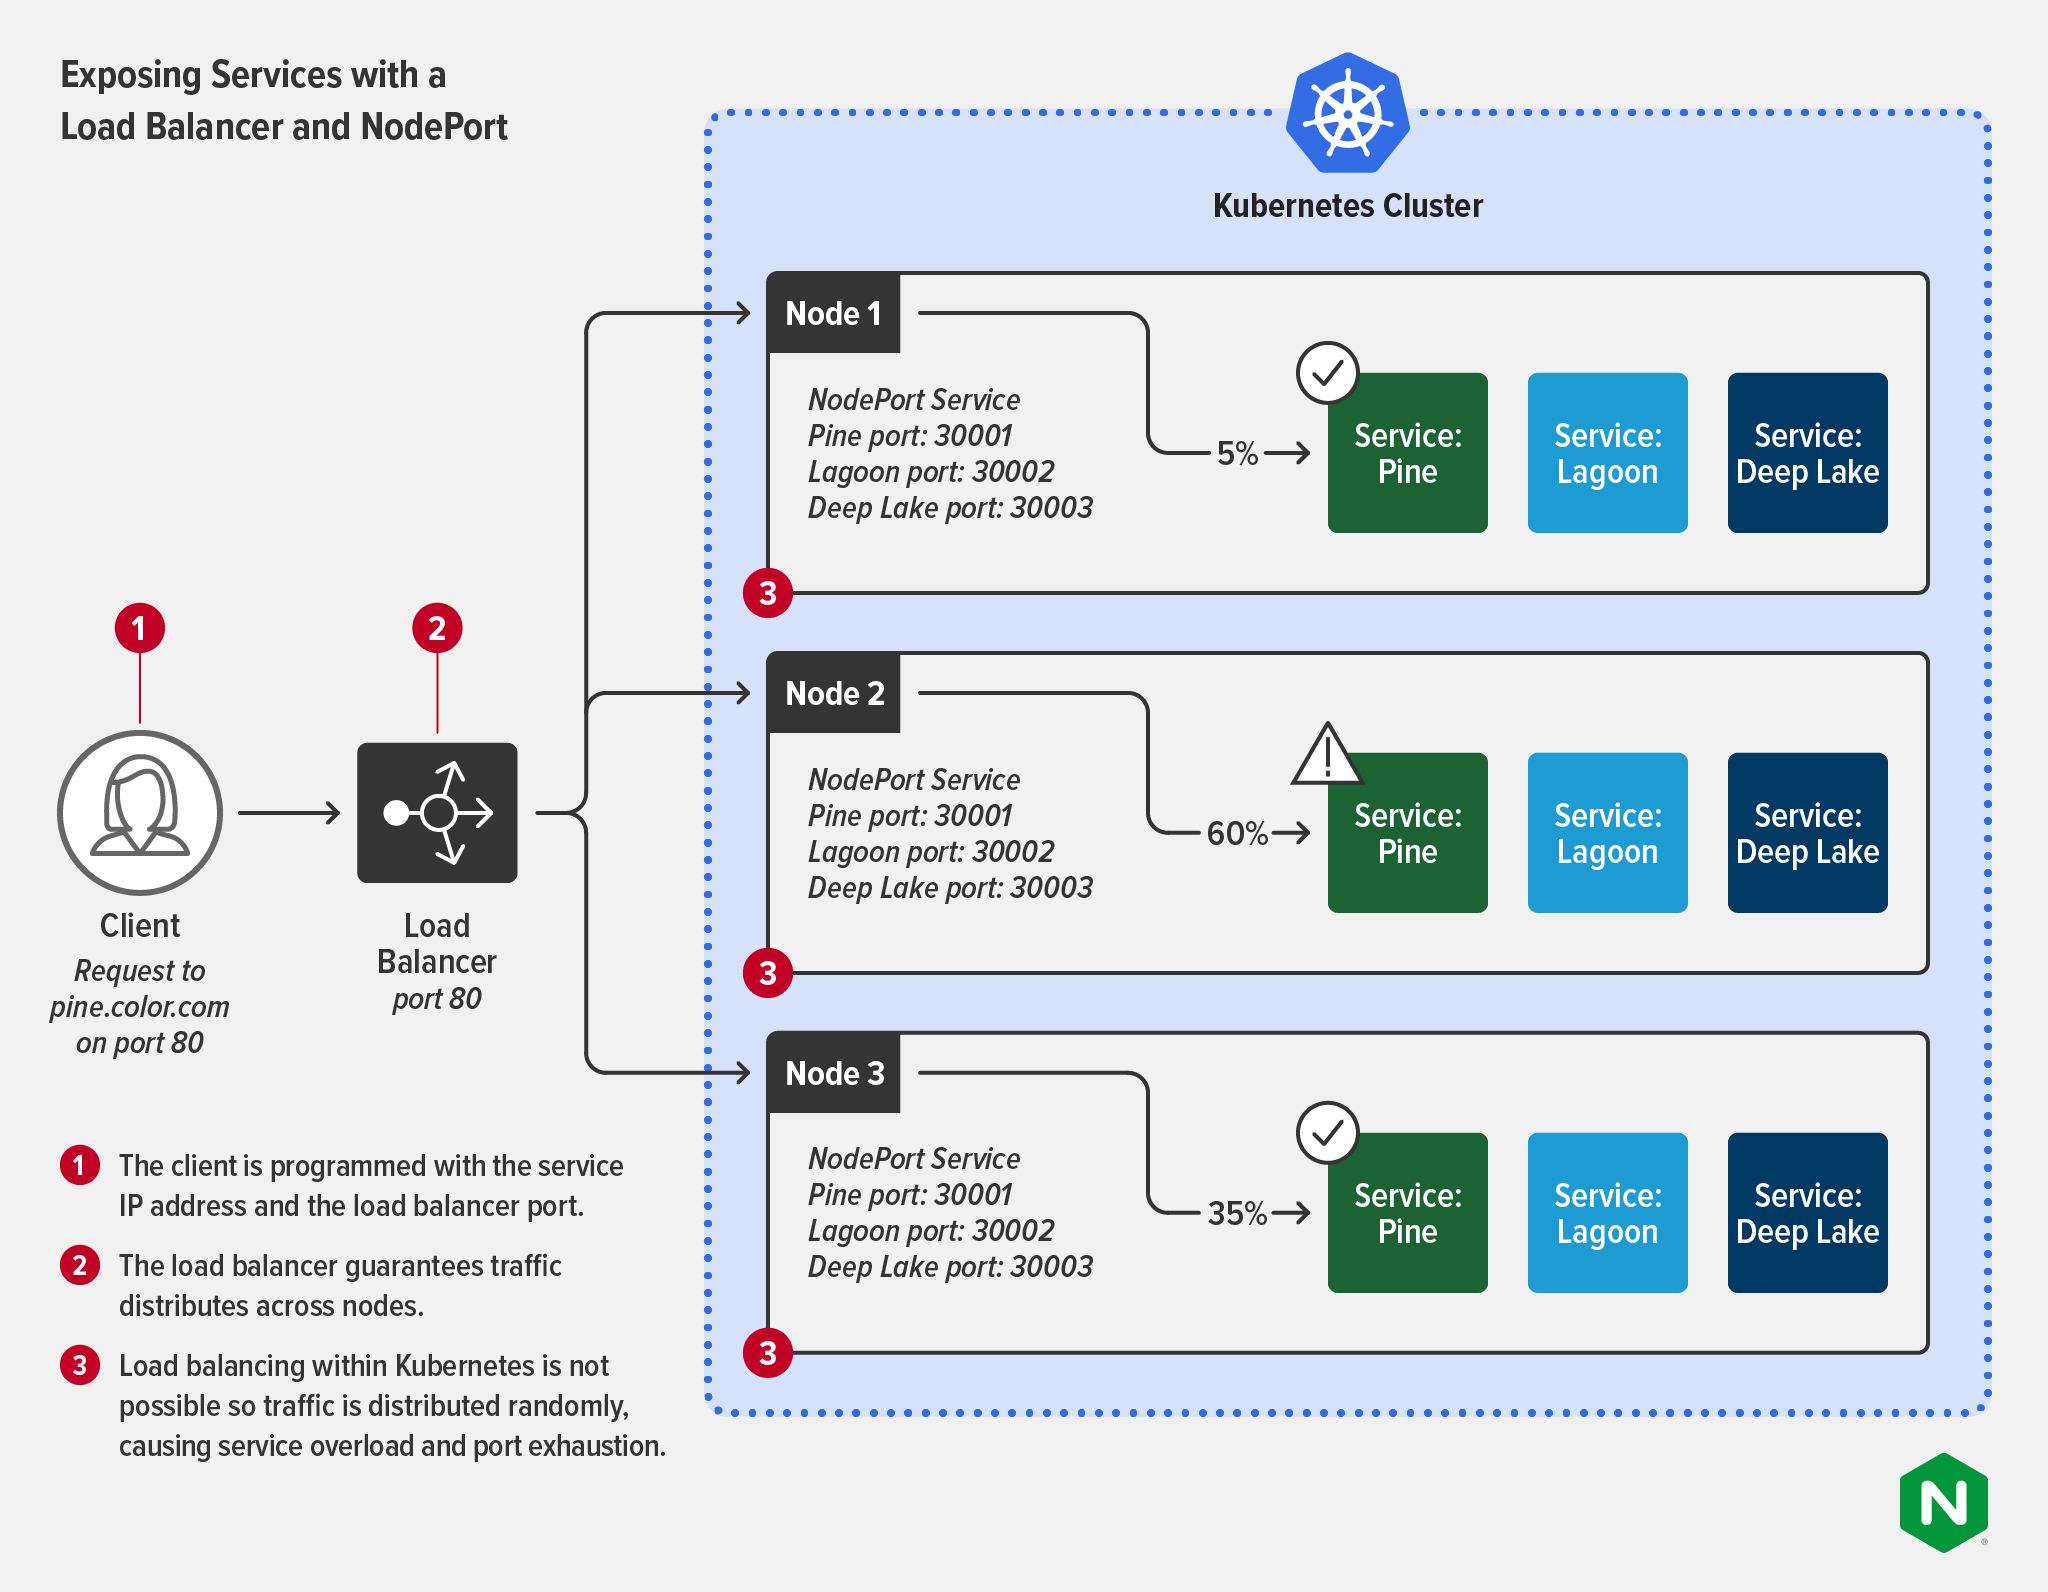
Un service LoadBalancer accepte le trafic externe, mais nécessite un équilibreur de charge externe servant d’interface pour ce trafic. Cela permet le routage de couche 7 (vers les adresses IP des pods), à condition que l’équilibreur de charge externe soit correctement réglé et reconfiguré pour acheminer le trafic vers les pods en cours d’exécution. LoadBalancer est l’un des moyens les plus courants d’exposer des services à l’extérieur. Il est le plus souvent utilisé sur une plateforme cloud et constitue un bon choix pour les déploiements statiques de petite taille.
Si vous utilisez un service Kubernetes géré, vous bénéficiez automatiquement de l’équilibreur de charge sélectionné par le fournisseur de cloud. Par exemple, sur Google Cloud Platform, vous pouvez déployer un équilibreur de charge réseau à l’aide du type de service LoadBalancer, tandis que l’équilibreur de charge applicatif (ALB) est utilisé par défaut dans AWS. Chaque service que vous exposez dispose de sa propre adresse IP publique, qui transfère l’ensemble du trafic sans aucun filtrage ni routage, ce qui signifie que vous pouvez envoyer presque n’importe quel type de trafic (HTTP, TCP/UDP, WebSocket, etc.). Si vous ne souhaitez pas utiliser les outils du fournisseur de cloud, par exemple parce que vous avez besoin de fonctionnalités plus avancées ou d’un outil indépendant de la plateforme, vous pouvez les remplacer par une solution telle que F5 BIG-IP (comme équilibreur de charge externe) et F5 Container Ingress Services (comme opérateur assurant le rôle de LoadBalancer). Pour en savoir plus sur ce modèle, consultez l’article Déploiement de BIG-IP et de NGINX Ingress Controller dans la même architecture sur notre blog.
L’utilisation de LoadBalancer pour exposer vos applications devient complexe dans les environnements dynamiques où les pods de vos applications doivent s’adapter à l’évolution de la demande. Comme chaque service possède sa propre adresse IP, une application populaire peut nécessiter la gestion de centaines, voire de milliers, d’adresses IP. Dans la plupart des cas, l’équilibreur de charge externe se connecte aux services via NodePort, comme illustré dans le schéma suivant. Bien que cela garantisse une répartition uniforme du trafic entre les nœuds, l’équilibrage de charge entre les services reste impossible, ce qui entraîne toujours une surcharge des services et un épuisement des ports.
Qu’est-ce qu’un contrôleur Ingress Kubernetes ?
Selon la documentation de Kubernetes, « les contrôleurs sont des boucles de contrôle qui surveillent l’état de votre cluster, puis effectuent ou demandent des modifications lorsque cela est nécessaire. Chaque contrôleur tente de rapprocher l’état actuel du cluster de l’état souhaité. » Les contrôleurs servent à gérer l’état dans Kubernetes pour de nombreuses tâches : attribuer correctement les ressources, définir le stockage persistant et gérer les tâches cron.
Dans le contexte du routage, un contrôleur Ingress permet de surmonter les limitations de NodePort et de LoadBalancer.
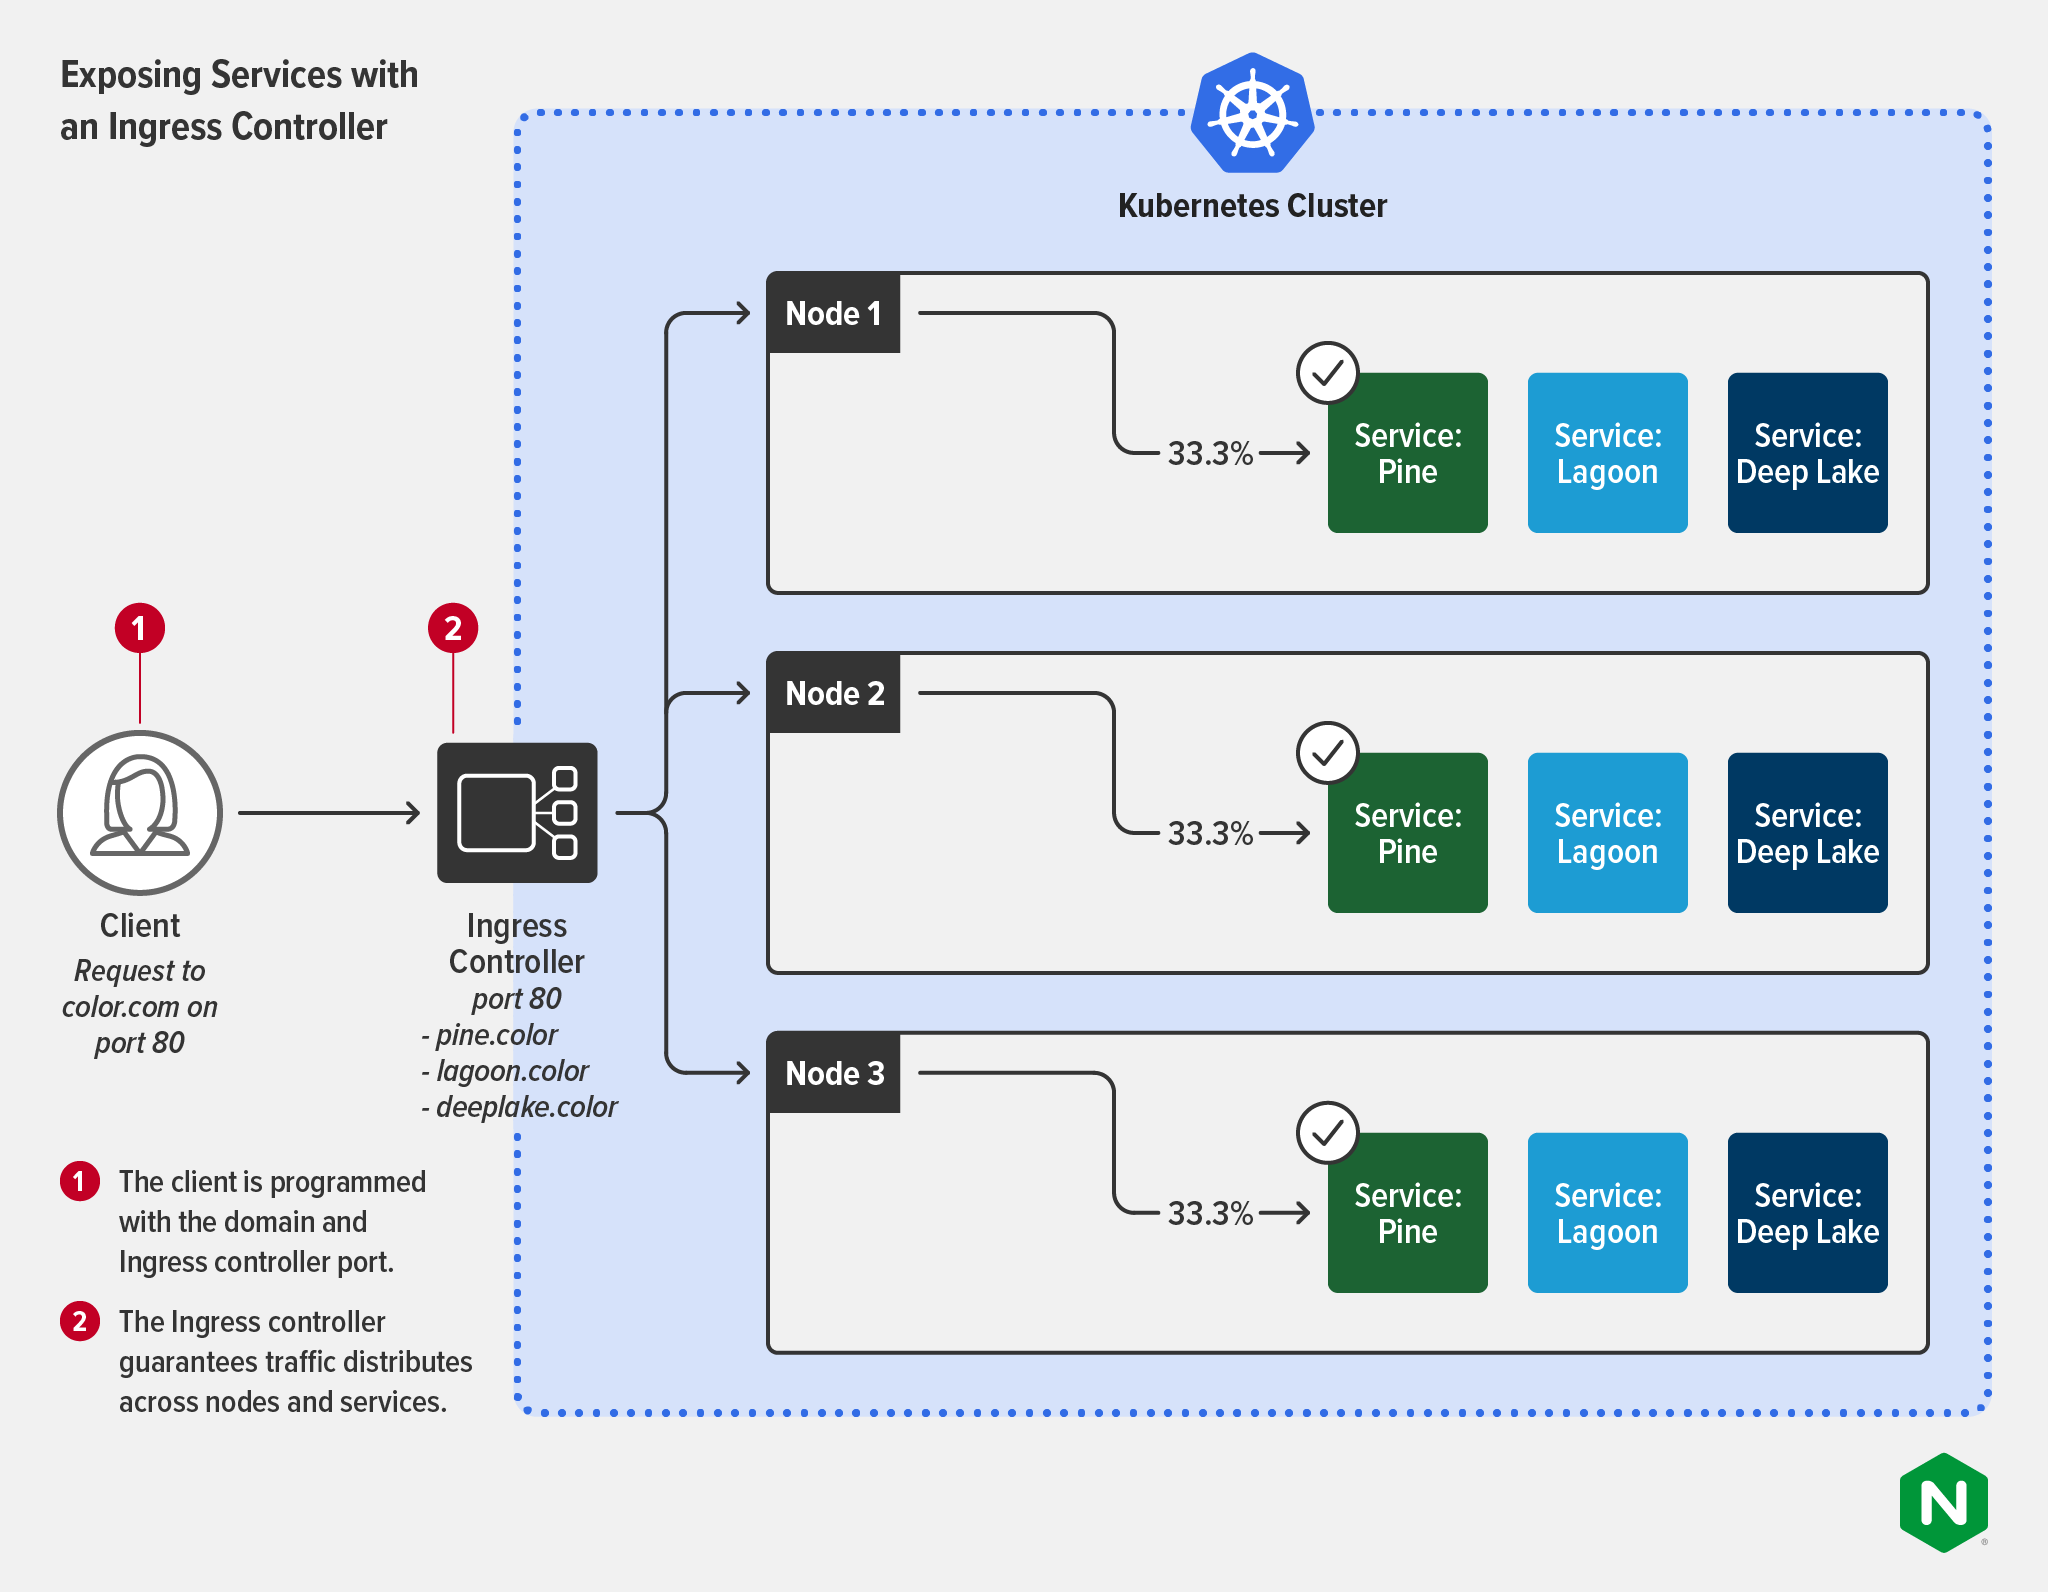
Un contrôleur Ingress permet de configurer et de gérer les interactions externes avec les pods associés à un service spécifique au moyen d’étiquettes. Les contrôleurs Ingress sont conçus pour faire du routage dynamique de couche 7 une fonctionnalité de premier plan. Ils offrent ainsi un contrôle et une gestion bien plus précis, tout en réduisant les tâches fastidieuses. Vous pouvez facilement utiliser un contrôleur Ingress non seulement pour contrôler le trafic entrant, mais aussi pour fournir des métriques de performances au niveau du service et l’intégrer à une politique de sécurité. Les contrôleurs Ingress proposent de nombreuses fonctionnalités propres aux équilibreurs de charge externes traditionnels, telles que la terminaison TLS, la gestion de plusieurs domaines et espaces de noms et, bien entendu, l’équilibrage du trafic. Ils peuvent équilibrer le trafic au niveau de chaque requête plutôt qu’au niveau de chaque service, ce qui offre une vue plus pertinente du trafic de couche 7 et permet de bien mieux faire respecter les SLA.
Et ce n’est pas tout ! Les contrôleurs Ingress peuvent également appliquer des règles de trafic sortant qui autorisent certains pods à communiquer uniquement avec des services externes spécifiques, ou garantir le chiffrement mutuel du trafic à l’aide de mTLS. L’utilisation obligatoire de mTLS est essentielle pour fournir des services réglementés dans des secteurs tels que la santé, la finance, les télécommunications et les administrations publiques. Elle constitue également un élément clé d’une stratégie de chiffrement de bout en bout (E2EE). La gestion du trafic sortant à l’aide du même outil simplifie aussi l’application de la logique métier aux services. Il est bien plus facile de définir des règles appropriées pour les ressources lorsque les flux entrants et sortants sont associés au sein d’un même plan de contrôle.
Le schéma suivant montre comment un contrôleur Ingress réduit la complexité pour le client, qui n’a plus besoin de connaître l’adresse IP ou le port d’un service. La répartition du trafic entre les services est garantie. Certains contrôleurs Ingress prennent en charge plusieurs algorithmes d’équilibrage de charge afin d’offrir davantage de flexibilité et de contrôle.
Déploiement d’un équilibreur de charge avec un contrôleur Ingress
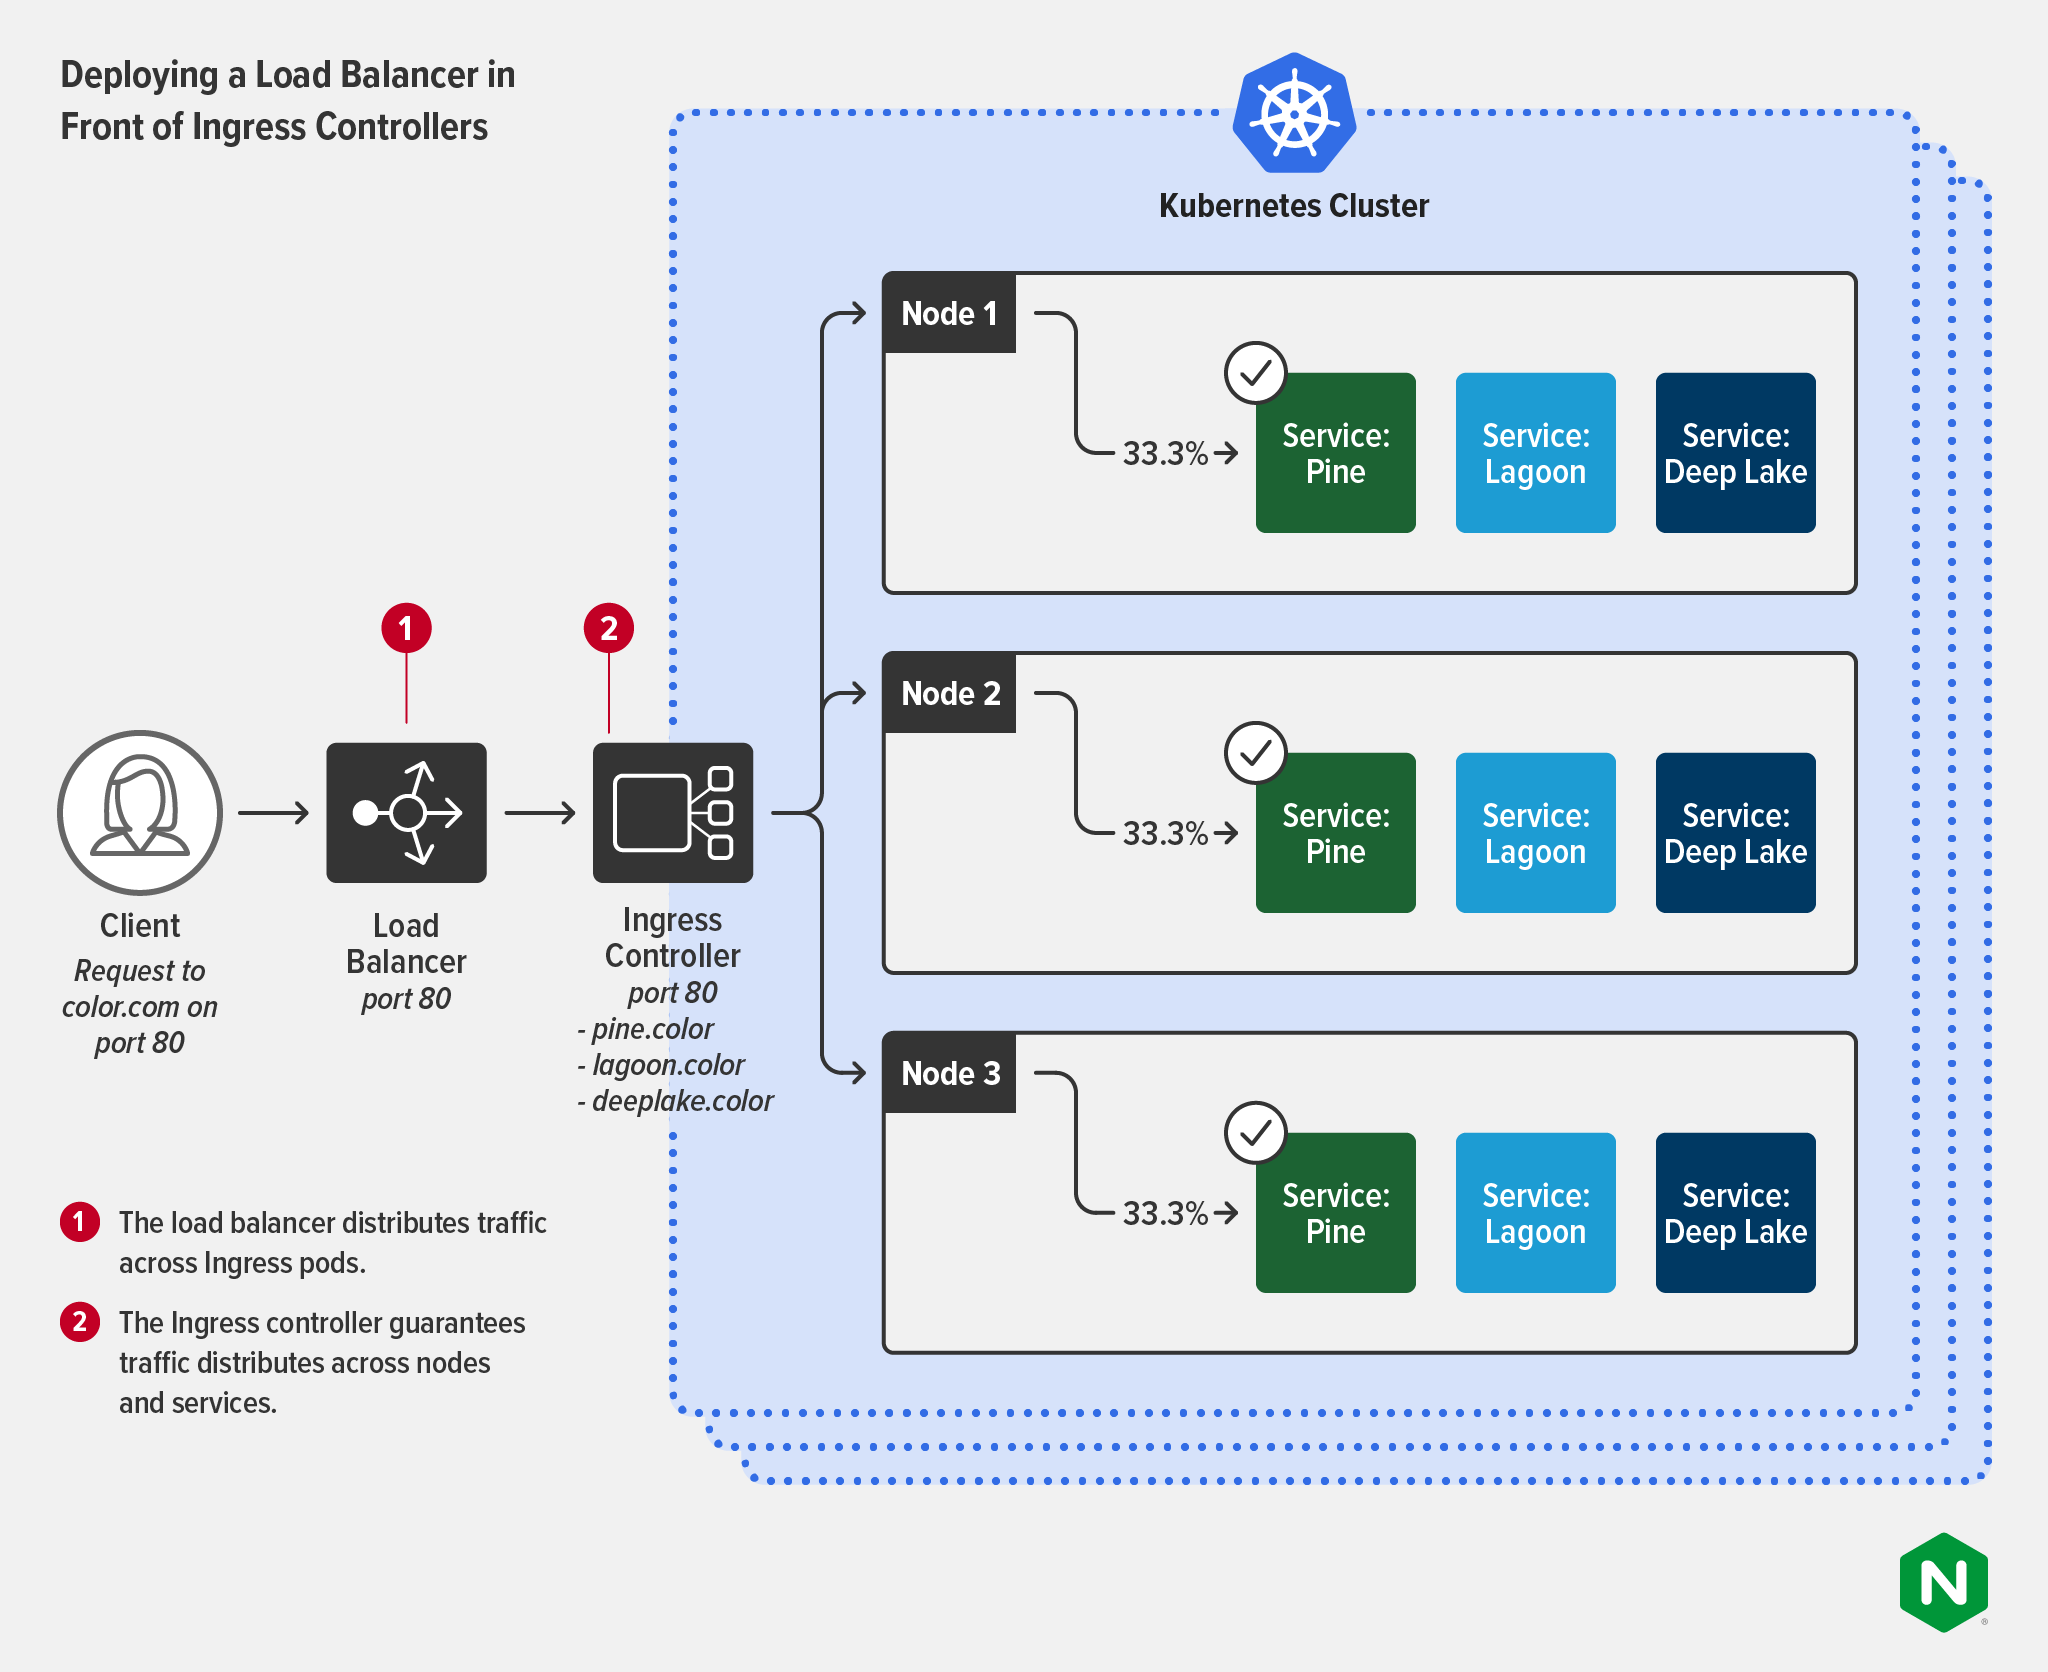
Comme nous l’expliquons dans « Déploiement de BIG-IP et de NGINX Ingress Controller au sein d’une même architecture », de nombreuses organisations ont des cas d’usage pour lesquels il est avantageux de déployer un équilibreur de charge externe avec un contrôleur Ingress (ou, dans la plupart des cas, plusieurs instances de contrôleur Ingress). Cette configuration est particulièrement courante lorsque les organisations doivent faire évoluer Kubernetes ou opérer dans des environnements soumis à des exigences de conformité strictes. Ces outils sont généralement gérés par des équipes différentes et utilisés à des fins distinctes :
- Équilibreur de charge (ou ADC) :
- Responsable : une équipe NetOps (ou éventuellement SecOps)
- Cas d’usage : en dehors de Kubernetes, comme seul point de terminaison exposé au public pour les services et applications destinés aux utilisateurs externes au cluster. Utilisé comme une appliance plus générique conçue pour renforcer la sécurité et assurer une gestion réseau de plus haut niveau.
- Contrôleur Ingress :
- Responsable : une équipe Platform Ops ou DevOps
- Cas d’usage : au sein de Kubernetes, pour l’équilibrage de charge granulaire du trafic nord-sud (HTTP2, HTTP/HTTPS, terminaison SSL/TLS, TCP/UDP, WebSocket, gRPC), les fonctions de passerelle API, ainsi que la centralisation de la sécurité et de la gestion des identités.
Ce schéma montre comment l’équilibreur de charge répartit le trafic entre plusieurs clusters, tandis que les clusters disposent de contrôleurs Ingress qui assurent une répartition uniforme entre les services.
Étapes suivantes
Si vous avez lu tout ceci et que vous vous posez encore des questions, consultez le webinaire de la Linux Foundation intitulé « Pourquoi avez-vous besoin d’un contrôleur Ingress et comment le choisir », dans lequel des experts de NGINX présentent les bases de la mise en réseau dans Kubernetes, explorent en détail les contrôleurs Ingress et dressent un état des lieux des solutions disponibles.
Pour en savoir plus sur l’utilisation d’un contrôleur Ingress et sur la manière de choisir celui qui répond le mieux à vos besoins, consultez Guide pour choisir un contrôleur Ingress, 1re partie : identifiez vos besoins sur notre blog.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.