NGINX Plus R9 permet désormais d’utiliser un proxy inverse et de répartir la charge du trafic UDP, ce qui constitue une amélioration majeure des capacités de répartition de charge de couche 4 de NGINX Plus.
Cet article de blog examine les défis liés à l’exploitation d’un serveur DNS dans une infrastructure applicative moderne afin de montrer comment NGINX Open Source et NGINX Plus peuvent répartir efficacement la charge du trafic UDP comme TCP. (Les contrôles d’intégrité [actifs] des applications sont réservés à NGINX Plus, mais les autres informations de cet article s’appliquent tout autant à NGINX Open Source ; par souci de concision, nous utiliserons NGINX Plus dans la suite de l’article).
[Note de la rédaction – Pour un aperçu de toutes les nouvelles fonctionnalités de NGINX Plus R9, consultez « Annonce de NGINX Plus R9 » sur notre blog.]
Pourquoi répartir la charge du trafic UDP ?
Contrairement à TCP, UDP ne garantit pas, par conception, la transmission de bout en bout des données. Cela revient à envoyer un message par pigeon voyageur : vous savez avec certitude que le message a été envoyé, mais vous ne pouvez pas être sûr qu’il est arrivé. Cette approche « sans connexion » présente plusieurs avantages, notamment une latence inférieure à celle de TCP, à la fois parce que les messages individuels plus petits d’UDP consomment moins de bande passante et parce qu’aucun processus d’établissement de liaison n’est nécessaire pour établir une connexion. UDP laisse au développeur de l’application le soin de détecter les expirations de délai et les autres problèmes liés au réseau. Mais qu’est-ce que cela implique pour le DNS ?
Comme plusieurs autres protocoles basés sur UDP, le DNS utilise un flux de données de type requête-réponse. Par exemple, un client DNS demande l’adresse IP correspondant à un nom d’hôte et reçoit une réponse. Si aucune réponse ne lui parvient dans le délai imparti, le client DNS envoie la même requête à un serveur DNS « de secours ». Toutefois, le fait de devoir attendre l’expiration de ce délai avant de réessayer peut transformer un processus habituellement extrêmement rapide (mesuré en millisecondes) en un processus très lent (mesuré en secondes).
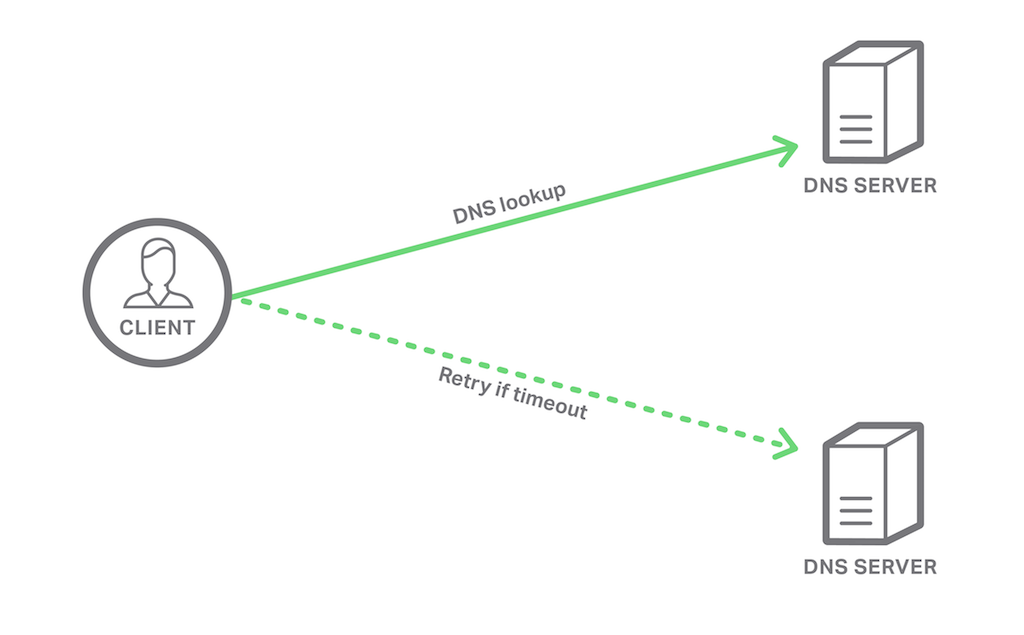
L’utilisation de NGINX Plus pour assurer le proxy et répartir la charge du trafic DNS réduit le nombre de situations dans lesquelles le client subit un dépassement de délai. Lorsque plusieurs serveurs DNS se trouvent derrière l’équilibreur de charge NGINX Plus, les clients ne subissent un dépassement de délai qu’en cas de partition réseau entre le client et NGINX Plus. Les problèmes affectant les serveurs DNS eux-mêmes sont transparents pour le client lorsque NGINX Plus utilise des contrôles d’intégrité des applications. En surveillant la disponibilité et le temps de réponse de chaque serveur, NGINX Plus évite d’envoyer les requêtes des clients à un serveur défaillant.
DNS n’est pas seulement un protocole UDP
Bien que la grande majorité du trafic DNS transite par UDP, certaines opérations DNS courantes utilisent TCP. DNS utilise UDP pour les petits messages (jusqu’à 512 octets), mais TCP pour les opérations qui nécessitent (ou sont susceptibles de nécessiter) des messages plus volumineux. Historiquement, TCP n’était utilisé avec DNS que pour les transferts de zone depuis un serveur de noms principal faisant autorité vers ses serveurs de noms secondaires. Cependant, avec l’essor des conteneurs et des infrastructures immuables, DNS est de plus en plus utilisé comme principal mécanisme de découverte de services, grâce à l’utilisation d’enregistrements SRV.
Les enregistrements DNS SRV records ont été initialement introduits pour permettre aux téléphones de voix sur IP (VoIP) utilisant SIP de détecter leurs serveurs, mais ils peuvent être utilisés pour tout type de service. Cependant, les enregistrements SRV contiennent beaucoup plus d’informations que la plupart des autres types d’enregistrements DNS. Par conséquent, seuls environ 10 enregistrements SRV tiennent dans une réponse UDP standard de 512 octets, contre environ 30 enregistrements A. Lorsqu’une réponse DNS dépasse la limite de 512 octets, les 512 premiers octets sont renvoyés, mais la réponse est signalée comme « tronquée ». Le client DNS peut alors soit traiter au mieux la réponse tronquée, soit réessayer la même requête en utilisant TCP.
Cela signifie que, lors de la répartition de charge entre des serveurs DNS au sein d’une infrastructure réseau moderne, NGINX Plus peut s’attendre à recevoir un mélange de trafic UDP et TCP.
Le DNS dans un environnement de microservices
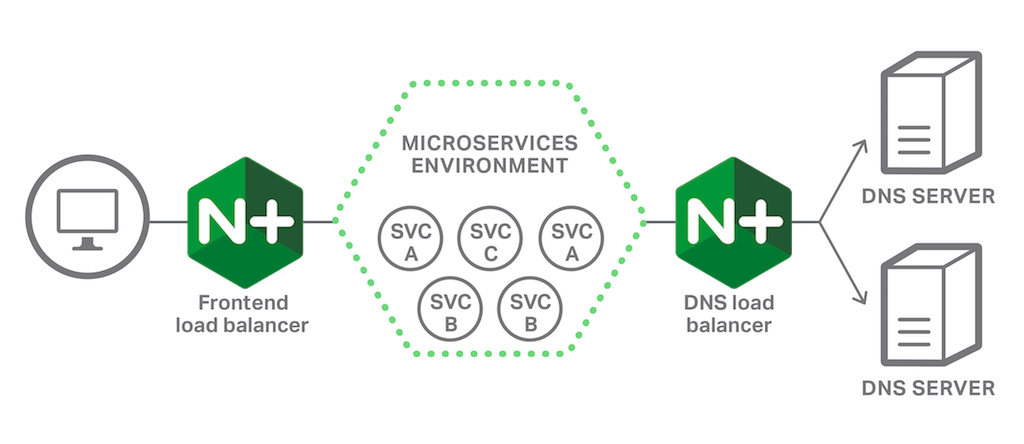
L’illustration suivante présente une vue simplifiée d’un environnement de microservices doté de deux répartiteurs de charge. Le répartiteur de charge frontal relaie les requêtes des clients publics de l’application, sélectionne la meilleure instance de microservice et assure de nombreuses autres fonctions que nous n’aborderons pas ici. Nous nous concentrerons sur le répartiteur de charge DNS, qui se situe entre l’environnement de microservices et les serveurs DNS fournissant aux microservices les informations nécessaires à la découverte de services.
Configuration de base de l’équilibrage de charge DNS
NGINX Plus implémente l’équilibrage de charge de couche 4 dans le module Stream, de sorte que l’équilibrage de charge UDP et TCP se configure dans le bloc stream, comme illustré dans l’extrait suivant.
Avertissement : Vous ne pouvez pas simplement ajouter cet extrait de configuration en tant que nouveau fichier dans le répertoire /etc/nginx/conf.d. Cela entraîne une erreur de validation (« la directive stream n’est pas autorisée ici »), car le fichier de configuration nginx.conf par défaut de NGINX Plus inclut le contenu des fichiers du répertoire conf.d dans le bloc http. La solution la plus simple consiste à inclure le bloc stream complet directement dans nginx.conf.
stream {    upstream dns_servers {
        server 192.168.136.130:53;
        server 192.168.136.131:53;
    }

    server {
        listen 53  udp;
        listen 53; #tcp
        proxy_pass dns_servers;
        error_log  /var/log/nginx/dns.log info;
    }
}
Nous définissons d’abord le groupe de serveurs DNS en amont. Les directives « server » indiquent le numéro du port sur lequel nos serveurs en amont sont à l’écoute, à savoir le port 53 (le port bien connu du DNS).
Le bloc server{} définit la manière dont NGINX Plus gère le trafic DNS entrant. Les deux directives listen indiquent à NGINX Plus d’écouter sur le port 53 le trafic UDP et TCP. TCP étant le protocole de couche 4 par défaut du module Stream, nous ne le spécifions pas explicitement en tant que paramètre, contrairement à UDP.
La directive « proxy_pass » indique à NGINX Plus comment traiter le trafic qu’il écoute. Ici, nous transmettons ce trafic au groupe de serveurs en amont « dns_servers ». NGINX Plus utilise automatiquement UDP lorsqu’il transmet les requêtes UDP des clients aux serveurs en amont (et TCP pour les requêtes TCP des clients). Il n’est donc pas nécessaire de spécifier explicitement le protocole de couche 4 dans le groupe de serveurs en amont.
Il n’existe pas de directive access_log dans le module Stream, car NGINX Plus n’inspecte pas la charge utile des segments TCP ou des datagrammes UDP (comme il le fait pour les paquets HTTP). Toutefois, nous pouvons utiliser le paramètre info de la directive error_log pour consigner le traitement des connexions et les événements de proxy.
[Note de l’éditeur – La journalisation des accès a été activée dans le module Stream après la publication de cet article, dans NGINX Open Source 1.11.4 et NGINX Plus R11.]
Optimisation pour la haute disponibilité
Pour améliorer la disponibilité de nos serveurs DNS, nous pouvons ajouter quelques directives supplémentaires et configurer des contrôles d’intégrité actifs (au niveau applicatif).
Configuration du nombre de réponses du proxy et de la durée du délai d’expiration
La première directive supplémentaire est proxy_responses, qui indique le nombre de réponses que NGINX Plus attend pour chaque requête UDP transmise par proxy. Dans notre cas, dès qu’il reçoit une réponse, NGINX Plus cesse immédiatement d’en attendre d’autres, ce qui libère la mémoire et le socket utilisés pour cette session.
La seconde directive supplémentaire, « proxy_timeout », détermine combien de temps NGINX Plus attend une réponse du serveur (ici, nous réduisons la valeur par défaut de 10 minutes à 1 seconde). Si NGINX Plus ne reçoit aucune réponse dans ce délai, il essaie le serveur suivant du groupe en amont et marque le serveur en amont qui ne répond pas comme indisponible pendant une période définie (10 secondes par défaut), afin qu’aucun autre client ne subisse de retard dû à l’expiration du délai d’attente pendant cette période.
server {    listen 53  udp;
    listen 53; #tcp
    proxy_pass      dns_servers;
    error_log       /var/log/nginx/dns.log info;
    proxy_responses 1;
    proxy_timeout 1s;
}
Nous pouvons également modifier la durée pendant laquelle un serveur est marqué comme indisponible en ajoutant l’option fail_timeout à la directive server dans le groupe de serveurs en amont. Avec le paramètre suivant, NGINX Plus marque les serveurs en amont défaillants comme indisponibles pendant 60 secondes :
upstream dns_servers {    server 192.168.136.130:53 fail_timeout=60s;
    server 192.168.136.131:53 fail_timeout=60s;
}
Cela nous permet de contrôler le délai subi par un client en cas de défaillance de l’un de nos serveurs DNS. Toutefois, si une requête TCP est envoyée à un serveur DNS défaillant, le mécanisme de détection d’erreurs intégré à TCP permet à NGINX Plus de le marquer automatiquement comme indisponible, afin que les requêtes TCP ou UDP suivantes ne lui soient pas envoyées.
Configuration des contrôles d’intégrité actifs
La fonctionnalité de vérification active de l’état de NGINX Plus constitue un outil supplémentaire extrêmement précieux pour assurer la haute disponibilité de tout service avec répartition de charge, notamment DNS. Au lieu d’attendre l’échec d’une véritable requête TCP provenant d’un client DNS avant de déclarer le serveur DNS indisponible, NGINX Plus tente périodiquement d’établir une connexion TCP sur le port 53 afin de vérifier que le serveur DNS est à la fois disponible et opérationnel, grâce à l’ajout de la directive health_check avec son paramètre port=53 dans le bloc server{}. (Par défaut, NGINX Plus envoie les vérifications d’état au port spécifié par la directive listen, soit le port 53 dans notre cas. Nous utilisons donc ici ce paramètre pour définir explicitement la valeur par défaut, mais nous pourrions spécifier un autre port si nous modifiions également nos serveurs DNS afin qu’ils répondent au trafic reçu sur celui-ci.)
Avec UDP, nous pouvons aller encore plus loin et configurer une vérification active de l’état qui effectue une véritable requête DNS pour un enregistrement connu. Par exemple, nous pourrions ajouter l’enregistrement CNAME suivant au fichier de zone du sous-domaine également utilisé pour la découverte de services dans l’environnement de microservices.
healthcheck IN CNAME healthy.svcs.example.com.Compte tenu de la légèreté du protocole UDP, nous pouvons surveiller le trafic réseau et extraire facilement la chaîne d’octets correspondant à une requête DNS. Nous créons ensuite un bloc de configuration match en utilisant cette chaîne comme paramètre de la directive send. La directive expect indique la réponse que le serveur doit renvoyer pour être considéré comme opérationnel.
match dns_lookup {
    send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...;
    expect ~* "healthy.svcs.example.com.";
}
L’avantage de cette vérification approfondie de l’état de santé au niveau applicatif est que, même si votre serveur de noms est opérationnel, effectuer une véritable recherche DNS pour votre domaine de production permet de détecter des problèmes de configuration et des données corrompues qui pourraient autrement entraîner des problèmes en aval.
L’équipe d’assistance NGINX Plus peut vous aider à préparer des contrôles d’intégrité UDP pour les recherches DNS et d’autres protocoles.
L’extrait suivant met en évidence les directives supplémentaires requises pour les contrôles d’intégrité actifs.
stream {    upstream dns_servers {
        zone dns_mem 64k;
        server 192.168.136.130:53 fail_timeout=60s;
        server 192.168.136.131:53 fail_timeout=60s;
    }

    match dns_lookup { send x00x01x00x00x00x01x00x00x00x00x00x00x06x68x65x61 ...; expect ~* "healthy.svcs.example.com."; }

    server {
        listen 53  udp;
        listen 53; #tcp
        health_check match=dns_lookup interval=20 fails=2 passes=2 udp;
        health_check interval=20 fails=1 passes=2 port=53; #tcp
        proxy_pass      dns_servers;
        error_log       /var/log/nginx/dns.log debug;
        proxy_responses 1;
        proxy_timeout   1s;

    }
}
La directive « zone » définit une zone de mémoire partagée appelée dns_mem, qui met les résultats des contrôles d’intégrité (ainsi que d’autres informations d’état) à la disposition de tous les processus de travail NGINX Plus.
La directive « match » est présentée juste au-dessus.
La directive « health_check » comporte plusieurs paramètres que vous pouvez ajuster en fonction de votre environnement. Ici, nous définissons des contrôles d’intégrité distincts pour UDP et TCP. En raison des différences entre UDP et TCP, nous exigeons deux échecs consécutifs du contrôle d’intégrité UDP avant de déclarer le serveur DNS défaillant, contre un seul échec pour TCP. Pour les deux protocoles, nous exigeons deux réponses positives avant de déclarer à nouveau un serveur opérationnel, afin d’éviter d’envoyer des requêtes à un serveur instable dont l’état oscille constamment.
L’un des avantages de définir un seul groupe en amont de serveurs DNS pour le trafic UDP et TCP est que l’échec d’un contrôle d’intégrité pour l’un ou l’autre protocole marque le serveur comme défaillant et le retire du pool avec répartition de charge.
Optimisation pour la montée en charge
Bien que le déploiement de seulement deux serveurs backend puisse constituer une solution de haute disponibilité efficace, les fonctionnalités de répartition de charge de NGINX Plus vous permettent d’ajouter des serveurs backend horizontalement, de manière transparente pour le client.
L’exemple d’environnement de microservices décrit ci-dessus ne nécessitera probablement pas de mise à l’échelle des serveurs DNS backend. En revanche, un FAI qui fournit des services DNS à l’ensemble de ses abonnés est soumis à une charge constante et à de possibles pics très importants, ce qui nécessite un grand nombre de serveurs DNS ainsi qu’un proxy frontend pour répartir la charge du trafic entre eux.
Tous les algorithmes d’équilibrage de charge de NGINX et NGINX Plus sont disponibles pour TCP et UDP, ainsi que pour HTTP :
- Round Robin (par défaut)
- Hachage générique et sa variante cohérente (algorithme ketama)
- Hachage IP
- Moins de connexions
- Temps minimal (NGINX Plus uniquement)
(Vous pouvez également configurer des pondérations pour tous les algorithmes afin d’améliorer encore leur efficacité. Pour en savoir plus, consultez la section consacrée aux pondérations dans l’article « Choisir une technique d’équilibrage de charge NGINX Plus » sur notre blog.)
Alors que les requêtes HTTP peuvent varier considérablement en termes de charge et de traitement imposés aux serveurs backend, les requêtes DNS génèrent généralement toutes la même charge. Pour cette raison, il est peu probable que les algorithmes Least Connections et Least Time offrent un avantage par rapport à Round Robin. En particulier, Least Connections comptabilise toutes les requêtes UDP pour lesquelles NGINX Plus attend encore une réponse du serveur en amont. Tant que les valeurs de proxy_responses et de proxy_timeout n’ont pas été atteintes, NGINX Plus continue de comptabiliser les connexions des serveurs en amont qui ont peut-être déjà terminé leur travail.
Lorsque vous avez un grand nombre de clients et un protocole qui implique de nombreux « échanges » — plusieurs messages échangés entre le client et le serveur, comme dans le flux défi-réponse RADIUS —, l’utilisation d’un hachage de l’adresse IP source permet à ces échanges de s’effectuer avec un seul serveur backend. En d’autres termes, cela établit une persistance de session, ce qui signifie que NGINX Plus dirige toutes les requêtes d’un client donné vers le même serveur. L’exemple suivant configure l’algorithme d’équilibrage de charge par hachage pour une paire de serveurs d’authentification RADIUS, en utilisant comme clé l’adresse IP source (du client), capturée par la variable $remote_addr.
upstream radius_servers {    hash $remote_addr; # Source-IP hash
    server 192.168.136.201:1812;
    server 192.168.136.202:1812;
}
Plus d’informations
Pour en savoir plus sur l’équilibrage de charge UDP et TCP, consultez les ressources suivantes :
- Équilibrage de charge TCP et UDP dans le guide d’administration de NGINX Plus
- Module Stream de NGINX et contexte de configuration
upstreamconfiguration context - Guide de déploiement pour la répartition de charge des serveurs Microsoft® Exchange™, qui doivent gérer à la fois le trafic TCP et le trafic HTTP
- Haute disponibilité de MySQL avec NGINX Plus et Galera Cluster<.htmla> (cas d’utilisation de l’équilibrage de charge TCP)
Pour en savoir plus sur les autres fonctionnalités remarquables de NGINX Plus R9, consultez l’article « Présentation de NGINX Plus R9 » sur notre blog et regardez notre webinaire à la demande « Nouveautés de NGINX Plus R9 ».
Pour essayer NGINX Plus, commencez dès aujourd’hui votre essai gratuit de 30 jours ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.