Note de l’auteur – Cet article de blog est le sixième d’une série :
- Présentation de l’architecture de référence pour les microservices de NGINX
- MRA, 2e partie : le modèle de proxy
- MRA, partie 3 : le modèle de maillage de routeurs
- MRA, partie 4 : le modèle Fabric
- MRA, partie 5 : adapter l’application Twelve-Factor aux microservices
- MRA, partie 6 : mise en œuvre du modèle de disjoncteur avec NGINX Plus (cet article)
Les six articles de blog, ainsi qu’un article consacré aux frontends web pour les applications de microservices<.htmla>, ont été réunis dans un ebook gratuit.
Consultez également ces autres ressources NGINX sur les microservices :
- Une série très utile et populaire de Chris Richardson sur la conception d’applications basées sur des microservices
- Les articles de Chris Richardson réunis dans un ebook gratuit, avec des conseils supplémentaires sur la mise en œuvre de microservices avec NGINX et NGINX Plus
- Autres articles de blog sur les microservices
- Webinaires sur les microservices
La conception d’applications fondées sur des microservices a profondément transformé le fonctionnement des applications. Dans une architecture de microservices, une « application » est désormais un ensemble de services qui dépendent les uns des autres pour exécuter des tâches et fournir des fonctionnalités. Dans les applications complexes, le graphe des services peut être très profond et comporter de multiples interdépendances entre les différents services.
Par exemple, un service utilisateur peut être indispensable à de nombreux autres services qui dépendent des données qu’il fournit. Dans ce cas, une défaillance du service utilisateur peut entraîner une cascade de défaillances dans l’ensemble de l’application.
Le modèle Circuit Breaker – terme popularisé par Martin Fowler – gagne en popularité auprès des architectes de microservices en tant que modèle de conception d’applications permettant d’éviter les défaillances en cascade des services. Le principe du modèle Circuit Breaker consiste à surveiller les services de votre application et le trafic qui circule entre eux afin de prévenir les défaillances et, lorsqu’elles surviennent, d’en limiter l’impact sur vos applications.
Pour les microservices, le modèle Circuit Breaker est particulièrement utile, car il assure une résilience ascendante. Correctement mis en œuvre, il peut contribuer à éviter les défaillances en cascade en garantissant la continuité du service, même lorsque certains services sont indisponibles. Le modèle Circuit Breaker a notamment été adopté de façon emblématique par Netflix comme composant essentiel de sa philosophie de conception d’applications.
Ne cherchez pas à éviter l’échec, acceptez-le
L’un des principes fondamentaux de la conception d’applications modernes est que des défaillances se produiront. L’empilement de couches sur lequel reposent les applications modernes – des machines virtuelles hébergées dans le cloud aux conteneurs, en passant par les bibliothèques applicatives et les réseaux dynamiques – implique que toute application comporte une multitude d’éléments mobiles. Vous devez partir du principe qu’un ou plusieurs composants de votre application finiront par connaître une défaillance, d’une manière ou d’une autre. Anticiper les défaillances et intégrer des mécanismes permettant d’en atténuer les effets contribue grandement à renforcer la résilience de votre application.
L’un des objectifs les plus importants du modèle de disjoncteur consiste à tenter d’éviter les défaillances en amont. Pour certains types d’erreurs, comme un manque de mémoire, il est possible de détecter qu’une défaillance est imminente et de prendre des mesures pour l’empêcher. En général, le service signale qu’il est défaillant, puis le disjoncteur lui donne la possibilité de se rétablir en limitant le nombre de requêtes ou en les redirigeant intégralement. Une fois le service rétabli, il est également judicieux que le disjoncteur augmente progressivement le nombre de requêtes qui lui sont adressées afin de ne pas le surcharger immédiatement, au risque qu’il redevienne défaillant.
Dans l’architecture de référence NGINX pour les microservices, nous disposons d’un service appelé le redimensionneur. Lorsqu’une photo de grande taille est chargée dans le système, le redimensionneur la décompresse, corrige son orientation, la réduit, puis la réduit à nouveau, avant d’enregistrer l’image originale corrigée et les deux images redimensionnées dans un stockage d’objets. En raison de la nature de ces opérations, le redimensionneur est le composant de l’application qui sollicite le plus le processeur et la mémoire.
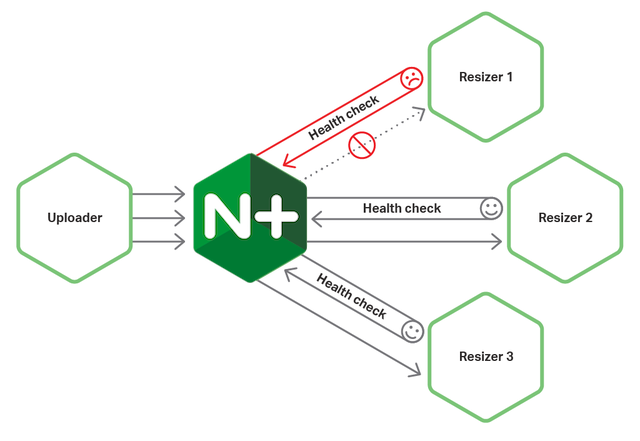
Lorsque de nombreuses images sont redimensionnées simultanément, le service de redimensionnement peut manquer de mémoire et, dans certains cas, tomber complètement en panne. Pour éviter ce type de problème, nous avons placé un disjoncteur entre les instances du service de redimensionnement et le service uploader qui leur transmet les images. Le service uploader interroge régulièrement les instances du service de redimensionnement pour connaître leur état de santé. Cette requête amène le service de redimensionnement à vérifier, entre autres contrôles d’intégrité, s’il a utilisé plus de 80 % de la mémoire disponible, puis à communiquer son état de santé au service uploader.
Si une instance du redimensionneur indique qu’elle est défaillante, le service de chargement achemine les requêtes vers d’autres instances – comme illustré à la figure 1 – tout en continuant à vérifier si l’instance concernée s’est rétablie. Lorsque celle-ci indique qu’elle est de nouveau opérationnelle, elle est réintégrée au pool avec équilibrage de charge, et le service de chargement augmente progressivement le trafic qui lui est envoyé jusqu’à atteindre sa pleine capacité. Cette conception empêche les instances du redimensionneur de tomber complètement en panne, évite que des tâches soient lancées sans être menées à terme, limite les attentes excessives pour les utilisateurs dont les processus auraient autrement échoué et aide le système à traiter le plus efficacement possible le flux de requêtes qui lui est envoyé.
Le modèle de disjoncteur améliore la cohérence
L’un des avantages de la mise en œuvre du disjoncteur au niveau de NGINX est qu’elle crée une couche universelle, cohérente et extrêmement flexible pour gérer les disjoncteurs dans l’ensemble de votre application de microservices. Grâce à cette universalité et à cette cohérence, vous n’avez pas à gérer les subtilités et les incohérences propres aux bibliothèques de disjoncteurs de chaque langage, ni à adapter votre architecture en conséquence.
Vous bénéficiez de nombreux avantages en retirant l’essentiel des fonctionnalités du disjoncteur du code de chaque service pour les implémenter plutôt dans NGINX Plus :
- Le disjoncteur d’un service écrit, par exemple, en Java est le même que celui d’un service écrit en PHP – et le disjoncteur lui-même peut être écrit dans un autre langage, selon les besoins
- Vous évitez d’avoir à réimplémenter la fonctionnalité de disjoncteur pour les différents langages et bibliothèques de support utilisés par chacun de vos services
- Chaque service qui n’a pas besoin d’intégrer le code du disjoncteur est ainsi simplifié ; il s’exécute plus rapidement et est plus facile à écrire, à déboguer, à exécuter et à maintenir
- Le code de support de chaque service est simplifié ; l’ensemble des bibliothèques et des systèmes utilisés peut ainsi refléter uniquement les fonctionnalités principales du service
- Le code du disjoncteur est simplifié : puisqu’il n’existe qu’à un seul endroit, il peut être réduit à l’essentiel, sans avoir à s’adapter aux contextes locaux.
- Le code du disjoncteur peut tirer parti des fonctionnalités de NGINX Plus, telles que la mise en cache, ce qui le rend bien plus puissant
- Vous pouvez affiner votre code de disjoncteur au niveau de NGINX Plus, puis le réutiliser dans d’autres applications et sur différentes plateformes de déploiement, par exemple sur site, sur diverses plateformes cloud et dans des environnements hybrides.
Il est toutefois important de noter que les disjoncteurs ne peuvent pas être mis en œuvre uniquement dans NGINX Plus. Un véritable disjoncteur exige que le service fournisse un contrôle d’intégrité actif et introspectif à un URI désigné (généralement /health). Le contrôle d’intégrité doit être adapté aux besoins de ce service spécifique.
Lors de l’élaboration du contrôle d’intégrité, vous devez comprendre le profil de défaillance du service et les types de conditions susceptibles de provoquer une panne, telles qu’un échec de connexion à la base de données, une mémoire insuffisante, un manque d’espace disque ou une surcharge du processeur. Ces conditions sont évaluées au cours du processus de contrôle d’intégrité, qui fournit ensuite un état binaire indiquant si le service est sain ou non.
Le modèle de disjoncteur offre de la flexibilité
Lorsque vous implémentez le modèle de disjoncteur au niveau de NGINX, comme décrit ici, il revient à NGINX Plus de gérer la situation lorsqu’une instance de service signale qu’elle est défaillante. Plusieurs options sont possibles.
La première option consiste à rediriger les requêtes vers d’autres instances saines et à continuer d’interroger l’instance défaillante pour vérifier si elle se rétablit. La deuxième option consiste à fournir des réponses mises en cache aux clients qui sollicitent le service, afin de maintenir la stabilité même si celui-ci est indisponible. Cette solution convient particulièrement aux services principalement axés sur la lecture, tels qu’un service de contenu.
Une autre possibilité consiste à proposer des sources de données alternatives. Par exemple, l’un de nos clients dispose d’un serveur publicitaire personnalisé qui utilise les données de profil pour diffuser des publicités ciblées à ses utilisateurs. Si ce serveur est indisponible, la requête de l’utilisateur est redirigée vers un serveur de secours qui fournit un ensemble de publicités génériques adaptées à tous. Cette approche fondée sur des sources de données alternatives peut s’avérer très efficace.
Enfin, si vous comprenez très précisément le profil de défaillance d’un service, vous pouvez atténuer les risques de panne en ajoutant une limitation du débit au disjoncteur. Les requêtes ne sont transmises au service qu’au rythme qu’il est capable de gérer. Cela crée une marge au sein du disjoncteur, qui peut ainsi absorber les pics de trafic.
La limitation du débit peut être particulièrement efficace dans un scénario d’équilibrage de charge centralisé tel que le modèle de maillage de routeurs, où le trafic des applications transite par un nombre limité d’équilibreurs de charge, qui peuvent ainsi avoir une bonne visibilité sur l’utilisation globale du trafic à l’échelle du site.
Mise en œuvre du modèle de disjoncteur dans NGINX Plus
Comme nous l’avons expliqué précédemment, le modèle de disjoncteur peut prévenir une défaillance avant qu’elle ne survienne en réduisant le trafic vers un service défaillant ou en redirigeant les requêtes vers un autre service. Cela nécessite une vérification active de l’état de santé, reliée à un dispositif de surveillance interne sur chaque service. Malheureusement, une vérification passive de l’état de santé ne suffit pas, car elle ne détecte la défaillance qu’une fois celle-ci survenue ; il est alors déjà trop tard pour prendre des mesures préventives. C’est pourquoi NGINX Open Source ne peut pas mettre en œuvre le modèle de disjoncteur : il ne prend en charge que les vérifications passives de l’état de santé.
NGINX Plus dispose toutefois d’un système robuste de contrôles d’intégrité actifs, offrant de nombreuses options pour détecter les problèmes d’intégrité et y répondre. L’examen de la mise en œuvre de certains types de services dans l’architecture de référence pour les microservices fournit de bons exemples des options et des cas d’usage permettant de mettre en œuvre le disjoncteur.
Commençons par le service de chargement qui se connecte au service de redimensionnement. Le service de chargement place les images dans un magasin d’objets, puis demande au service de redimensionnement d’ouvrir une image, de la corriger et de la redimensionner. Cette opération est très gourmande en ressources de calcul et en mémoire. Le service de chargement doit surveiller l’état du service de redimensionnement et éviter de le surcharger, car celui-ci peut littéralement provoquer l’arrêt de l’hôte sur lequel il s’exécute.
La première chose à faire est de créer un bloc location spécifiquement destiné à la vérification de l’état du service de redimensionnement. Ce bloc correspond à un emplacement internal, ce qui signifie qu’il n’est pas accessible au moyen d’une requête envoyée à l’URL standard du serveur (http://example.com/health-check-resizer). Il sert plutôt d’emplacement réservé aux informations de vérification de l’état. La directive health_check envoie une requête de vérification de l’état à l’URI /health toutes les trois secondes et utilise les tests définis dans le bloc match nommé conditions pour vérifier l’état de l’instance de service. Une instance de service est marquée comme défaillante dès qu’elle échoue à une seule vérification. Les directives proxy_* envoient la requête de vérification de l’état au groupe en amont resizer, en utilisant TLS 1.2 sur HTTP 1.1, avec les en-têtes HTTP indiqués définis sur null.
location /health-check-resizer {    internal;
    health_check uri=/health match=conditions fails=1 interval=3s;


    proxy_pass                        https://resizer;
    proxy_ssl_session_reuse           on;
    proxy_ssl_protocols               TLSv1.2;
    proxy_http_version                1.1;
    proxy_set_header Connection       "";
    proxy_set_header Accept-Encoding  "";
}
L’étape suivante consiste à créer le bloc conditions match afin de spécifier les réponses correspondant à un état sain ou défaillant. La première vérification porte sur le code d’état de la réponse : s’il est compris entre 200 et 399, le test passe à l’instruction d’évaluation suivante. La deuxième vérification consiste à s’assurer que le Content-Type est application/json. Enfin, la troisième vérification consiste à comparer, à l’aide d’une expression régulière, la valeur des métriques deadlocks, Disk et Memory. Si elles indiquent toutes un état sain, le service est considéré comme sain.
match conditions {    status 200-399;
    header Content-Type ~ "application/json";
    body ~ '{
        "deadlocks":{"healthy":true},
        "Disk":{"healthy":true},
        "Memory":{"healthy":true}
    }';
}
Le système de disjoncteur et de contrôle d’intégrité de NGINX Plus dispose également d’une fonctionnalité de démarrage progressif. Le paramètre slow_start de la directive server pour le service de redimensionnement dans le bloc upstream indique à NGINX Plus de modérer le flux de trafic lorsqu’une instance du service de redimensionnement redevient opérationnelle après avoir été défaillante. Au lieu de submerger immédiatement le service avec autant de requêtes que les services opérationnels, le trafic envoyé au service en cours de rétablissement augmente progressivement jusqu’à atteindre le débit normal sur la période indiquée par le paramètre slow_start – dans ce cas, 30 secondes. Le démarrage progressif augmente les chances que le service retrouve toutes ses capacités, tout en réduisant l’impact si cela ne se produit pas.
upstream resizer {    server        resizer slow_start=30s;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
La limitation des requêtes permet de gérer et de réguler le flux de requêtes adressées au service. Si vous connaissez suffisamment bien le profil de défaillance de l’application pour déterminer le nombre de requêtes qu’elle peut traiter à un instant donné, la mise en œuvre d’une limitation des requêtes peut s’avérer très bénéfique. Toutefois, cette fonctionnalité n’est efficace que si NGINX Plus connaît précisément le nombre total de connexions transmises au service. Il est donc particulièrement utile de mettre en œuvre le disjoncteur de limitation des requêtes sur une instance NGINX Plus exécutée dans un conteneur avec le service lui-même, comme dans le modèle Fabric, ou sur un équilibreur de charge centralisé chargé de gérer l’ensemble du trafic d’un cluster.
L’extrait de code de configuration suivant définit une limite du débit des requêtes à appliquer aux instances du service de redimensionnement dans leurs conteneurs. La directive limit_req_zone fixe la limite à 100 requêtes par seconde. La variable $server_addr est utilisée comme clé, ce qui signifie que toutes les requêtes adressées au conteneur du service de redimensionnement sont comptabilisées dans cette limite. La zone est nommée moderateReqs et la durée de conservation du nombre de requêtes est de 1 minute. La directive limit_req permet à NGINX Plus de mettre en mémoire tampon des pics allant jusqu’à 150 requêtes. Lorsque ce nombre est dépassé, les clients reçoivent le code d’erreur 503 comme spécifié par la directive limit_req_status, indiquant que le service est indisponible.
http {    # Moderated delivery
    limit_req_zone $server_addr zone=moderateReqs:1m rate=100r/s;
    # ...
    server {
        # ...
        limit_req zone=moderateReqs burst=150;
        limit_req_status 503;
        # ...
    }
}
Un autre avantage majeur de l’exécution du disjoncteur au sein de NGINX Plus est la possibilité d’intégrer la mise en cache et de centraliser les données mises en cache afin qu’elles puissent être utilisées dans l’ensemble du système. Cela est particulièrement utile pour les services principalement axés sur la lecture, tels que les serveurs de contenu, lorsque les données lues depuis le backend ne changent pas fréquemment.
proxy_cache_path /app/cache levels=1:2 keys_zone=oauth_cache:10m max_size=10m inactive=15s use_temp_path=off;
upstream user-manager {
    server        user-manager;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}

server {
    listen 443 ssl;
    location /v1/users {
        proxy_pass http://user-manager;
        proxy_cache            oauth_cache;
        proxy_cache_valid      200  30s;
        proxy_cache_use_stale  error timeout invalid_header updating
                               http_500 http_502 http_503 http_504;
    }
}
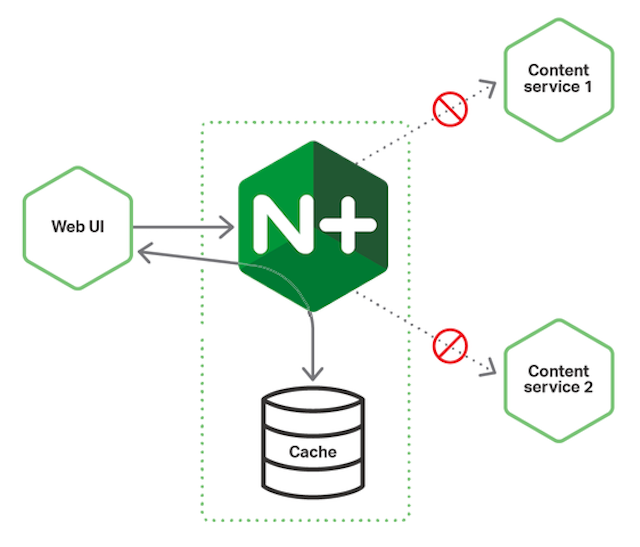
Comme le montre la figure 2, la mise en cache des données permet d’éviter que de nombreuses requêtes de données client n’atteignent les instances du microservice, libérant ainsi de la capacité pour les requêtes qui n’ont encore jamais été reçues.
Cependant, pour un service dont les données peuvent changer, par exemple un service de gestion des utilisateurs, le cache doit être géré avec discernement. Dans le cas contraire, un utilisateur pourrait modifier son profil, mais continuer à voir les anciennes données dans certains contextes parce qu’elles sont mises en cache. Un délai d’expiration raisonnable et l’acceptation du principe de haute disponibilité avec cohérence à terme permettent de résoudre ce dilemme.
L’une des fonctionnalités intéressantes du cache NGINX est qu’il peut continuer à fournir les données mises en cache même si le service est totalement indisponible – dans l’extrait ci-dessus, si le service renvoie l’un des quatre codes d’erreur les plus courants de la série 500.
La mise en cache n’est pas la seule solution pour répondre aux clients lorsqu’un serveur est indisponible. Comme nous l’avons indiqué dans « Le modèle de disjoncteur offre davantage de flexibilité », l’un de nos clients avait besoin d’une solution résiliente en cas d’indisponibilité de son serveur de publicités personnalisées, et les réponses mises en cache ne convenaient pas. Il souhaitait plutôt qu’un serveur de publicités génériques diffuse des annonces non personnalisées jusqu’à ce que le serveur personnalisé soit de nouveau opérationnel. Cela se fait facilement à l’aide du paramètre backup de la directive server. L’extrait suivant indique que lorsque tous les serveurs définis pour le domaine personal-ad-server sont indisponibles, les serveurs définis pour le domaine generic-ad-server sont utilisés à la place.
upstream personal-ad-server {    server        personal-ad-server;
    server        generic-ad-server backup;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
Enfin, il est possible de demander à NGINX d’évaluer les codes de réponse d’un service et de les traiter individuellement. Dans l’extrait suivant, si un service renvoie une erreur 503, NGINX Plus transmet la requête à un autre service. Par exemple, si le service de redimensionnement dispose de cette fonctionnalité et que l’instance locale est surchargée ou cesse de fonctionner, les requêtes sont alors envoyées à une autre instance de ce service.
location / {    error_page 503 = @fallback;
}

location @fallback {
    proxy_pass http://alternative-backend;
}
Conclusion
Le modèle de disjoncteur est un outil puissant qui permet d’assurer la résilience et le contrôle de votre application de microservices. NGINX Plus offre de nombreuses fonctionnalités et options pour mettre en œuvre le disjoncteur dans votre environnement. Pour réussir la mise en œuvre de ce modèle, il est essentiel de comprendre le profil de défaillance du service que vous protégez, puis de choisir les options qui permettent au mieux de prévenir les défaillances, dans la mesure du possible, et d’en atténuer les effets lorsqu’elles surviennent.
Pour essayer NGINX Plus, commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.