Modèles de mise à disposition d’applications pour faire évoluer les applications et les API
Aujourd’hui, la mise à l’échelle des applications et des API ne consiste pas à choisir le bon algorithme d’équilibrage de charge. En plus de vingt ans d’évolution de la fourniture d’applications, les algorithmes d’équilibrage de charge sont l’un des rares éléments à être restés relativement constants. Leur principal avantage est de garantir la disponibilité. Leur incidence sur les performances est, au mieux, minime.
Cela ne signifie pas pour autant que le choix d’un algorithme soit sans importance. Après tout, l’algorithme round robin est rarement le meilleur choix pour une API ou une application, mais le choix entre les algorithmes du plus petit nombre de connexions et du temps de réponse le plus rapide est moins susceptible d’avoir une incidence sur les performances globales et la disponibilité d’un service numérique que son architecture.
Il s’agit ici d’aborder la fourniture d’applications sous l’angle de l’architecture, celle-ci ayant été élevée au rang des six capacités clés nécessaires à la conception et à l’exploitation de services numériques.
Qu’est-ce qu’un algorithme d’équilibrage de charge ?
Un algorithme d’équilibrage de charge est une méthode programmatique qui consiste à répartir la charge entre un ensemble de ressources afin de garantir leur disponibilité et d’améliorer les performances.
Un algorithme d’équilibrage de charge définit la manière dont les ressources spécifiques sont sélectionnées et les variables prises en compte.
Round Robin est l’algorithme le plus simple : il parcourt séquentiellement un ensemble connu de ressources. S’il existe trois ressources – A, B et C –, l’algorithme Round Robin achemine la première requête vers A, la deuxième vers B et la troisième vers C. Le processus de sélection recommence ensuite.
Le moins de connexions est un algorithme fondé sur le deuxième axiome opérationnel, selon lequel « lorsque la charge augmente, les performances diminuent ». Ainsi, l’algorithme du moins de connexions choisit la ressource ayant le moins de connexions (charge). Il existe plusieurs variantes de cet algorithme, notamment celle du moins de connexions pondéré, qui permet de tenir compte des différences de capacité entre les ressources.
Le temps de réponse le plus rapide est utilisé lorsque les performances sont une priorité absolue. Le répartiteur de charge détermine, de manière passive ou active, le temps de réponse de chaque ressource et choisit la plus rapide pour chaque requête. Cet algorithme ne garantit pas le temps de réponse utilisateur puisqu’il n’a aucune incidence sur le dernier kilomètre ni sur les conditions du réseau de l’utilisateur.
Adresse IP source est un algorithme hérité de la répartition de charge réseau qui utilise une simple valeur de hachage de l’adresse IP source (client) pour choisir une ressource. Cet algorithme sélectionne toujours la même ressource pour une adresse IP source donnée. Il est tombé en désuétude en raison du problème dit du « méga-proxy », où tous les utilisateurs provenant d’un même proxy ou d’une même adresse IP sont dirigés vers la même ressource. Cela tend à surcharger la ressource cible, entraînant de mauvaises performances et, à terme, une défaillance.
Les algorithmes d’équilibrage de charge constituent un élément important de l’architecture de mise à disposition des applications, mais ils ont moins d’incidence sur les performances et la capacité de montée en charge d’une application ou d’un service numérique que l’approche architecturale globale.
Qu’est-ce que la mise à disposition d’applications ?
La mise à disposition d’applications est une discipline qui consiste à concevoir une architecture évolutive et hautement performante pour les applications, les API et les services numériques. Elle repose en grande partie sur l’équilibrage de charge, qui en constitue un composant essentiel, tout en intégrant des fonctionnalités modernes telles que le routage de couche 7 et en s’appuyant sur des modèles d’architecture courants afin d’optimiser les performances et l’utilisation efficace des ressources.
Nous utilisons le terme « livraison d’applications » afin d’établir délibérément une distinction entre l’équilibrage de charge, qui relève de la mise en œuvre, et l’architecture, qui relève d’un processus de conception.
Pourquoi mettons-nous à l’échelle ?
La mise à l’échelle est une réponse technique à un objectif commercial. Elle répond notamment à la nécessité de maintenir la disponibilité et les performances des charges de travail qui composent un service numérique afin d’améliorer les scores de satisfaction client, les taux de conversion et la génération de revenus. Ce dernier point est particulièrement important, car nos recherches indiquent que la majorité (58 %) des entreprises tirent aujourd’hui au moins la moitié de leurs revenus des services numériques.
Prenons également, par exemple, l’utilisation du cloud public pour assurer la continuité d’activité (CA). La CA est l’un des principaux cas d’usage du cloud public et repose fondamentalement sur une mise à l’échelle mondiale, c’est-à-dire sur la répartition globale de charge. Le basculement est une fonctionnalité essentielle de la fourniture d’applications qui, lorsqu’elle est appliquée à l’ensemble d’un site, permet de rediriger rapidement les requêtes d’un emplacement vers un autre. La disponibilité continue de la présence numérique d’une entreprise constitue un objectif métier rendu possible par une réponse technique.
Comment passer à l’échelle ?
Répondre à cette question marque le début de notre exploration technique de l’architecture de déploiement des applications. Il existe deux modèles de mise à l’échelle : verticale (vers le haut) et horizontale (vers l’extérieur).
La mise à l’échelle verticale repose sur le principe selon lequel l’ajout de puissance de traitement à un système permet d’en augmenter la capacité. Cette méthode de mise à l’échelle profite principalement aux applications monolithiques et aux systèmes autonomes. En dehors de l’infrastructure, la plupart des organisations ne s’appuient plus sur la mise à l’échelle verticale, car elle nécessite de modifier l’environnement physique, par exemple en ajoutant des processeurs ou de la mémoire vive, ou en augmentant la capacité du réseau. Bien que la mise à l’échelle verticale soit considérablement accélérée par la virtualisation, en particulier dans les environnements de cloud public, la nécessité de migrer les logiciels et les systèmes, même vers une nouvelle machine virtuelle, peut entraîner des perturbations.
La mise à l’échelle horizontale est une approche architecturale qui consiste à augmenter la puissance de traitement en accroissant le volume total de ressources disponibles. Pour ce faire, la puissance de traitement est répartie entre plusieurs instances d’une application, d’un service ou d’un système. Il s’agit aujourd’hui de la méthode de mise à l’échelle la plus courante, car elle repose sur la duplication des ressources plutôt que sur leur migration. En outre, la mise à l’échelle horizontale offre un plus grand choix d’options architecturales que la mise à l’échelle verticale, ce qui la rend mieux adaptée à l’ensemble des applications et des API.
Il n’est donc pas surprenant que les modèles modernes de déploiement d’applications reposent sur le principe de la mise à l’échelle horizontale.
Modèles de déploiement des applications
Le simple fait de choisir la mise à l’échelle horizontale ne suffit pas à clore le débat.
Une fois cette décision prise (il s’agit généralement du choix par défaut), d’autres considérations doivent guider la décision architecturale relative à la mise en œuvre. La manière la plus simple d’aborder cette décision consiste à l’envisager sous l’angle du « cube de scalabilité », tel qu’il est décrit dans le livre « The Art of Scalability ».
Pour faire simple, le cube de mise à l’échelle comporte trois axes : x, y et z. Chacun correspond à un modèle architectural d’équilibrage de charge. Chacun de ces modèles permet d’atteindre des objectifs précis en matière de performances et de disponibilité, selon les différents types d’applications et d’API.
Un service numérique utilisera probablement une architecture intégrant plusieurs modèles afin d’optimiser simultanément les performances et la consommation des ressources. Cette approche nécessite une pensée systémique, car elle doit prendre en compte tous les composants, leurs interactions et la manière dont les requêtes circuleront de l’utilisateur vers l’application, puis en sens inverse.
Échelle de l’axe X
Le modèle de l’axe X est le plus élémentaire. Il repose sur la duplication horizontale, et l’essentiel du travail est effectué par un algorithme d’équilibrage de charge. C’est le modèle le plus simple, qui aboutit à ce que j’appelle le « Plain Old Load Balancing » (POLB), autrement dit un simple équilibrage de charge.
Nous l’appelons ainsi en raison de la simplicité de son architecture, qui n’exploite aucune des fonctionnalités avancées des répartiteurs de charge modernes permettant d’interagir avec les requêtes et les réponses au niveau de la couche applicative.
Dans ce modèle, les applications sont dupliquées et les requêtes sont transmises à une instance en fonction de la décision prise par l’algorithme d’équilibrage de charge configuré.
Comme ce modèle est souvent utilisé conjointement avec TCP (couche 4), il offre de meilleures performances que d’autres modèles reposant sur l’inspection du protocole HTTP (couche 7). En particulier, les connexions peuvent être raccordées entre elles plutôt que relayées par un proxy, ce qui transforme de fait l’équilibreur de charge en simple saut réseau après l’établissement de la connexion initiale. Cela améliore les performances globales, mais empêche l’équilibreur de charge d’inspecter les requêtes et les réponses ou d’agir sur celles-ci après la connexion initiale. Les architectures selon l’axe X étant particulièrement efficaces pour garantir la disponibilité et pouvant offrir des performances élevées, elles sont souvent utilisées pour faire évoluer des services d’infrastructure et de sécurité tels que les pare-feu et les passerelles applicatives.
Divers types d’applications traditionnelles (monolithiques, web à trois niveaux et client-serveur) sont généralement mis à l’échelle selon ce modèle, car il est rare que ces applications soient décomposées en composants plus distincts pouvant être exploités dans des architectures modernes de mise à disposition d’applications.
Mise à l’échelle sur l’axe Y
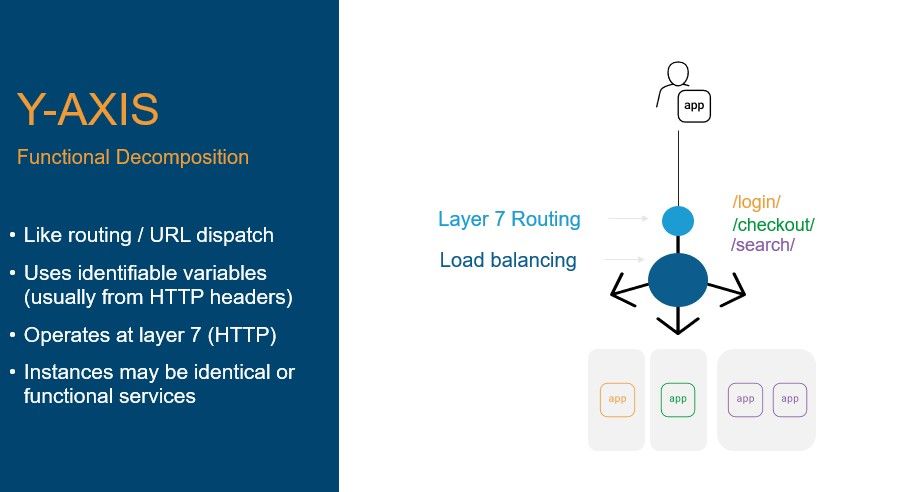
Ce modèle repose sur la décomposition fonctionnelle et exploite les capacités de la couche applicative (couche 7) de la distribution d’applications afin d’adapter la capacité en fonction des fonctionnalités plutôt que des systèmes entiers. Le modèle de l’axe Y est le premier dans lequel le routage de couche 7 devient un outil essentiel de l’architecture de distribution d’applications.
En général, les modèles basés sur les axes y et z tirent parti du routage de couche 7 pour choisir un pool, puis un algorithme d’équilibrage de charge est utilisé pour sélectionner une ressource spécifique. Cette approche diffère du modèle de base fondé sur l’axe x, qui n’utilise pas le routage de couche 7.
Ce modèle suppose un fonctionnement au niveau de la couche 7, généralement en HTTP, et utilise une variable pour distribuer le trafic vers des instances spécifiques d’une application ou d’un service. Par exemple, si le motif /login est détecté dans l’URI, l’équilibreur de charge choisit, selon l’algorithme d’équilibrage de charge configuré, une instance parmi un groupe d’instances d’application qui traitent uniquement les requêtes de connexion. La variable peut correspondre à n’importe quel élément de l’en-tête ou du contenu de la requête. Cela permet un routage basé sur l’agent, sur l’API ou sur le contenu (images, scripts, etc.).
Les instances d’application peuvent être des clones. C’est souvent le cas lorsque l’utilisation d’une application présente des disparités qui peuvent être identifiées par une variable dans la requête. Par exemple, les fonctions de connexion et de paiement peuvent être distinguées dans une requête en fonction de l’URI, d’une valeur dans l’en-tête HTTP ou d’une valeur dans la charge utile de la requête. L’application d’un modèle selon l’axe Y permet aux applications traditionnelles d’évoluer en fonction de la fonction, ce qui améliore l’efficacité de l’utilisation des ressources, car davantage de ressources peuvent être allouées au traitement des fonctions à fort volume tout en maintenant les performances attendues des autres fonctions.
L’utilisation du modèle de l’axe Y pour mettre à l’échelle les applications traditionnelles en fonction de leurs fonctionnalités est antérieure à la généralisation des microservices, qui permettent aujourd’hui de décomposer les applications par fonction. Le modèle de l’axe Y reste applicable aux microservices et est d’ailleurs aujourd’hui mis en œuvre par des contrôleurs d’entrée. Les lecteurs avertis remarqueront que ce modèle s’applique également aux API, puisqu’elles reposent sur des mécanismes HTTP (couche 7). Il n’est donc pas surprenant que les passerelles d’API exploitent ce modèle fondamental.
Ce modèle a été popularisé par eBay aux débuts du Web 2.0. Son architecture de mise à l’échelle reposait alors sur la répartition des fonctions dans des pools d’applications distincts. Les fonctionnalités de vente étaient prises en charge par un ensemble de serveurs d’applications, les enchères par un autre et la recherche par un autre encore. Au total, environ 16 000 serveurs d’applications étaient répartis dans 220 pools différents. Cela permettait de faire évoluer chaque pool indépendamment des autres, en fonction des besoins et de la consommation de ressources de sa fonction. Cette organisation permettait également d’isoler et de rationaliser les dépendances aux ressources : par exemple, le pool dédié à la vente n’avait besoin de communiquer qu’avec un sous-ensemble relativement restreint de ressources backend.
Le modèle de l’axe Y peut également être utilisé pour répartir différents types de requêtes de contenu, par exemple en affectant les images à un pool de ressources et les autres types de contenu à d’autres pools.
L’utilisation de l’axe Y pour répartir la charge permet aux composants d’un service numérique d’évoluer indépendamment, ce qui est bien plus efficace en matière d’utilisation des ressources qu’un modèle fondé sur l’axe X. Elle permet d’optimiser la configuration au niveau du service ou de l’application afin d’en améliorer les performances, en ajustant certaines variables du serveur web ou applicatif en fonction d’un type de contenu donné.
Mise à l’échelle selon l’axe Z
Le modèle de mise à l’échelle selon l’axe Z s’est imposé par pure nécessité face à la croissance fulgurante des réseaux sociaux et d’Internet en général. Il s’agit fondamentalement d’un modèle de mise à l’échelle selon l’axe Y auquel s’ajoute une segmentation supplémentaire, généralement fondée sur une variable spécifique telle qu’un nom d’utilisateur ou un identifiant d’appareil.
Ce modèle permet de différencier les architectures grâce à une technique dérivée du partitionnement des données.
“Un fragment de base de données, ou simplement fragment, est une partition horizontale des données d’une base de données ou d’un moteur de recherche. Chaque fragment est hébergé sur une instance distincte de serveur de base de données afin de répartir la charge. Certaines données d’une base restent présentes dans tous les fragments, tandis que d’autres n’apparaissent que dans un seul fragment.”
Wikipédia1
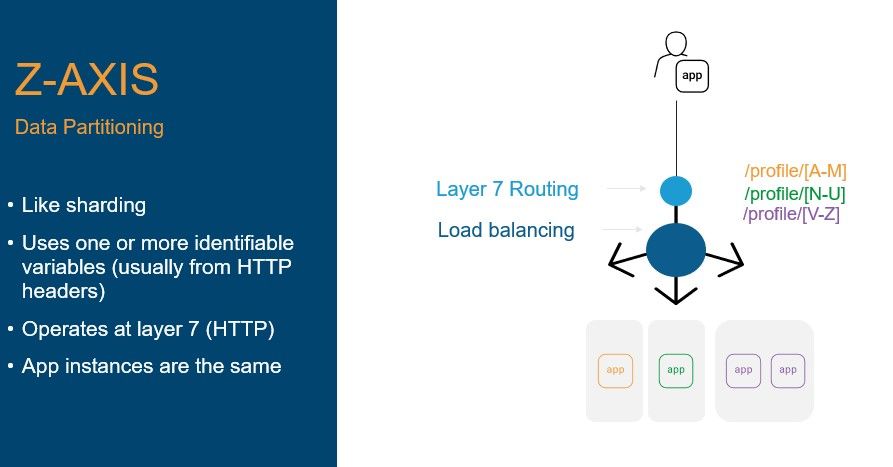
Ce modèle applique les principes utilisés dans les bases de données afin de répartir les requêtes en fonction d’une donnée qu’elles contiennent. Il peut contribuer à résoudre les goulets d’étranglement au niveau de la couche de données, tout en garantissant le respect des règles de souveraineté des données. Il utilise une variable identifiable — et généralement unique — pour acheminer les requêtes vers un pool de ressources mis à l’échelle horizontalement. Ce modèle est généralement utilisé lorsqu’un débit élevé est nécessaire, par exemple pour traiter un volume important de requêtes destinées à un service ou à une application spécifique.
Le modèle d’axe Z est particulièrement utile pour gérer les appareils en périphérie et les objets connectés, qui peuvent se compter par millions. L’utilisation des identifiants des appareils comme critère de base pour répartir les requêtes permet d’accélérer considérablement le transfert des données. Cela peut être particulièrement utile pour les appareils qui stockent leur configuration dans un emplacement distant (cloud ou centre de données), car ces données sont propres à chaque appareil et peuvent être réparties en toute sécurité.
Ce modèle tend à améliorer les performances, car l’accès aux données en cas de forte charge peut considérablement les dégrader. Ainsi, en répartissant l’accès aux données entre davantage d’instances, la charge diminue et les performances s’améliorent. Cette approche exige une attention particulière à l’intégrité des données et peut entraîner des problèmes de cohérence lorsqu’elle est utilisée pour partitionner des données partagées. Meta a mis en lumière la question du partitionnement lorsqu’elle a développé le partitionnement des services dans le cadre de son architecture globale. L’attention particulière qu’elle a accordée au développement d’une architecture de diffusion d’applications hautement performante et évolutive illustre parfaitement les avantages considérables que peut apporter la reconnaissance de la diffusion d’applications comme une couche à part entière au sein d’une architecture plus vaste.
Pour les services qui accèdent à des sources de données non principales, un modèle selon l’axe Z peut améliorer le débit sans affecter sensiblement la qualité des données dans l’ensemble du système. Cette approche évite d’avoir à ajouter du code pour associer une instance spécifique d’une application ou d’une API à une source de données. Elle s’appuie plutôt sur la combinaison de la configuration des connecteurs de données au niveau de l’instance et du routage de la distribution des applications afin de garantir l’utilisation de la source de données appropriée.
Le secret de la mise à l’échelle réside dans l’architecture de déploiement des applications
Aujourd’hui, dans un monde où les services numériques sont omniprésents, il est rare de s’appuyer sur un seul modèle de déploiement d’applications pour concevoir un service numérique performant et fiable. Cela s’explique par la complexité intrinsèque des services numériques et par la diversité croissante des « utilisateurs », qui peuvent être des appareils, des êtres humains ou des logiciels.
Ainsi, une approche architecturale consiste à déterminer la meilleure façon d’utiliser les modèles de déploiement d’applications au sein d’un service numérique afin d’offrir une expérience optimale aux utilisateurs.
Il n’existe pas de solution architecturale « correcte » ou « incorrecte », car celle-ci dépend fortement des services et des applications qui composent un service numérique. Toutefois, une telle solution ne doit pas reposer uniquement sur des algorithmes d’équilibrage de charge.
En effet, il convient de noter qu’il n’a nullement été question du choix de l’algorithme, car la manière dont la charge est répartie dans le cadre d’un modèle d’équilibrage de charge importe moins que le choix de l’architecture adaptée à une application ou une API donnée.
C’est l’un des facteurs qui font de la mise à disposition des applications une discipline à part entière. Aujourd’hui, l’utilisation et la mise en œuvre de la mise à disposition et de la sécurité des applications vont bien au-delà de la simple mise à l’échelle d’un serveur web. Leur mise en œuvre peut avoir une incidence sur les performances et la disponibilité et, en définitive, contribuer à la réussite ou à l’échec de l’entreprise. Il est donc important que les organisations considèrent la mise à disposition des applications comme un outil stratégique et architectural dans leur boîte à outils de conception.
L’équilibrage de charge reste la principale exigence technique pour assurer la montée en charge. Comprendre les modèles de mise à disposition des applications et la manière dont ils exploitent l’équilibrage de charge permet de mieux concevoir l’architecture des services numériques en vue d’optimiser leur montée en charge et leurs performances, en particulier lorsque ces services sont susceptibles d’être hybrides et de combiner des API ainsi que des applications modernes et traditionnelles.
NOTE DE BAS DE PAGE