Accélérez vos pipelines de données d’IA, fiabilisez-les et sécurisez-les avec F5 BIG-IP
Les pipelines de données d’IA reposent sur un accès rapide et fiable à d’immenses jeux de données. L’entraînement et l’ajustement fin, tout comme la prise en charge des charges de travail RAG, nécessitent des pipelines hautes performances pour transférer les données entre les workflows des plateformes de création de modèles d’IA et les déploiements de stockage. F5 BIG-IP optimise la distribution des données S3 grâce à un équilibrage de charge intelligent et à une inspection approfondie du trafic, garantissant ainsi l’évolutivité, les performances et la protection des charges de travail d’IA.
Les charges de travail d’IA en entreprise sont confrontées à des goulots d’étranglement liés aux données
Les modèles d’IA consomment d’énormes volumes de données lors des processus d’entraînement, d’ajustement fin et de génération augmentée par récupération (RAG). Ces jeux de données sont souvent répartis entre des systèmes de stockage objet multicloud et sur site. Sans gestion intelligente du trafic sur le chemin des données, les entreprises sont confrontées à une latence imprévisible, à un débit irrégulier et à des goulets d’étranglement qui laissent les GPU inactifs et augmentent les coûts d’infrastructure.
Les approches traditionnelles de mise en réseau du stockage aggravent ces difficultés. Les applications se connectent souvent directement aux systèmes de stockage objet, ce qui lie étroitement les charges de travail à l’API ou à la région d’un seul fournisseur. Cette rigidité complique le rééquilibrage des pipelines lorsqu’un cluster ralentit, lorsque les données doivent être transférées d’un fournisseur à un autre ou lorsque des exigences réglementaires imposent leur rapatriement. Chaque changement entraîne un risque d’interruption de service, d’incohérence des données et de réécriture coûteuse des applications.
La sécurité complique encore la situation. Les données d’entraînement sensibles et les précieux résultats produits par les modèles transitent par des réseaux partagés, parfois non fiables. Sans inspection centralisée ni application des politiques, les organisations ne peuvent pas empêcher de manière fiable l’empoisonnement des jeux de données, les accès non autorisés ou l’exfiltration. Ces lacunes exposent les initiatives d’IA à des retards opérationnels, à des manquements aux exigences de conformité et à des risques pour leur réputation.
Relevez les défis liés à la distribution des données d’IA grâce à la plateforme F5® de distribution et de sécurité des applications (ADSP)
La F5 ADSP, qui intègre F5 BIG-IP, fournit un point de contrôle programmable et hautes performances pour la distribution de données compatible avec S3. F5 BIG-IP permet un couplage faible en dissociant les applications des systèmes de stockage back-end spécifiques, ce qui permet aux charges de travail de fonctionner de manière transparente dans les clouds et les environnements sur site, sans modification. F5 BIG-IP surveille en permanence l’état du stockage et utilise un DNS intelligent ainsi que la répartition de charge pour acheminer le trafic vers les points de terminaison les plus performants, afin que les pipelines restent résilients et offrent des performances prévisibles en cas de charges élevées ou de pics de trafic.
Les performances à grande échelle constituent un principe fondamental de la conception. Le logiciel F5 BIG-IP exécuté sur du matériel F5 spécialement conçu peut traiter plusieurs térabits de données par seconde et les acheminer entre les clusters de stockage sans surcharger les différents nœuds. La gestion programmable du trafic permet aux architectes de façonner, de hiérarchiser et de répliquer les flux, afin d’éviter les congestions tout en optimisant l’utilisation des GPU. Ainsi, les tâches d’entraînement et les opérations d’ajustement fin s’exécutent efficacement, tandis que les requêtes RAG reçoivent les données avec la rapidité et la régularité nécessaires à une exécution efficace.
Le schéma suivant illustre comment F5 BIG-IP prend en charge trois composantes essentielles de tous les workflows d’ingestion de données d’IA (entraînement des modèles, ajustement fin et RAG). Chacune de ces composantes répond à des enjeux fondamentaux, tels que l’agrégation de données réparties géographiquement, la résilience des points de terminaison et l’optimisation de la distribution des données depuis les systèmes de stockage. Grâce à des fonctionnalités telles que le routage DNS intelligent, la gestion programmable du trafic et l’application de politiques de sécurité avancées, F5 garantit l’évolutivité, la fiabilité et la sécurité des pipelines d’IA. Cette architecture maintient des performances élevées tout en assurant une protection contre l’empoisonnement des données et les accès non autorisés sur l’ensemble du cycle de vie des mouvements de données.
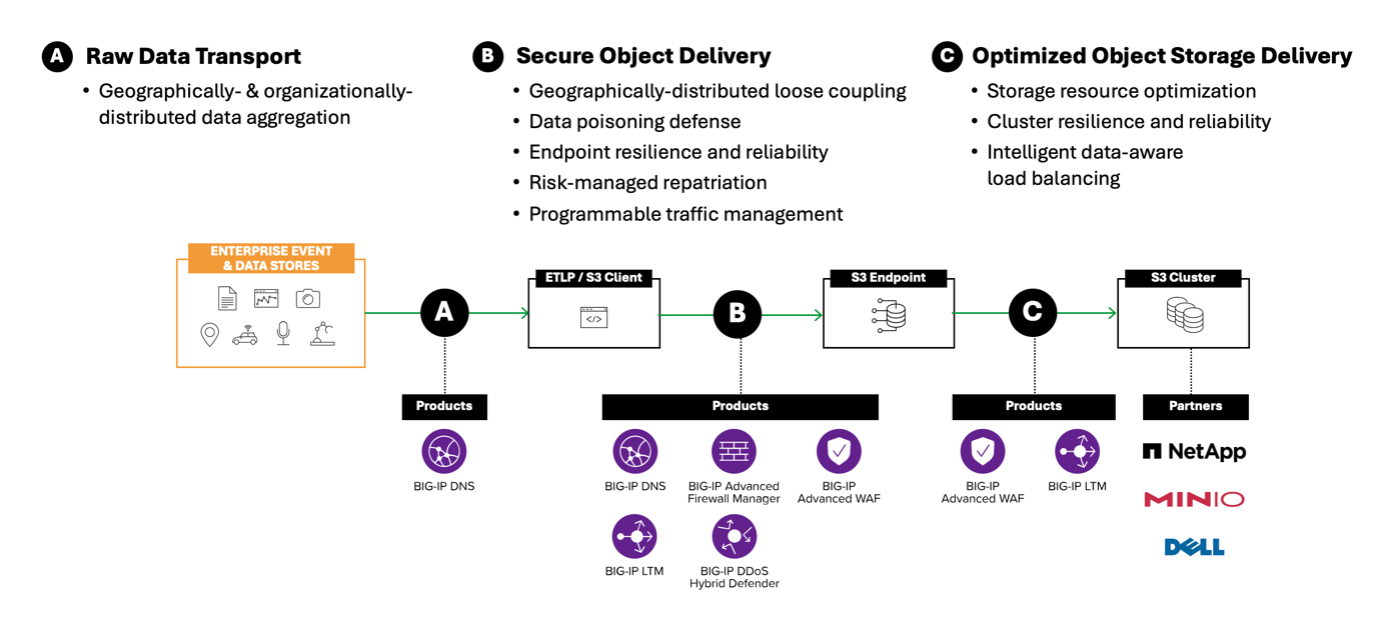
Avec F5, la sécurité est intégrée dès la conception, et non ajoutée après coup. F5 BIG-IP applique une inspection centralisée à tous les points d’entrée et de sortie des données, bloquant les jeux de données empoisonnés ou malformés avant qu’ils ne contaminent les pipelines. Des fonctionnalités telles que la terminaison TLS, l’atténuation des attaques DDoS et la protection des API de couche 7 vont au-delà des contrôles proposés par les fournisseurs de stockage, offrant aux organisations la gouvernance et la traçabilité nécessaires pour se conformer aux référentiels ou aux exigences propres à leur secteur.
Il est essentiel de gérer les flux de données des applications d’IA et d’éviter la congestion du réseau à grande échelle, en particulier au sein des réseaux cœur et entre plusieurs sites. Avec une capacité pouvant atteindre 6 Tbit/s dans un seul châssis, F5 peut répondre aux exigences des charges de travail d’IA modernes, qui impliquent des volumes de trafic de données toujours plus importants et complexes. F5® VELOS® assure un équilibrage de charge sécurisé, résilient et hautement performant, qui achemine de manière optimale les données d’IA entre les systèmes, garantissant ainsi un traitement rapide et une disponibilité continue. Les données parviennent ainsi rapidement et en toute sécurité à leur destination, ce qui contribue à améliorer les performances globales des applications d’IA.
Des pipelines de données d’IA optimisés génèrent un réel impact sur l’activité
En déployant F5 BIG-IP dans le chemin de données de l’IA, les organisations éliminent la fragilité des pipelines et réduisent le gaspillage des ressources de calcul. Les GPU restent pleinement utilisés, les délais d’exécution des tâches diminuent et les équipes d’IA ont l’assurance que les charges de travail évolueront de manière prévisible à mesure que les volumes de données augmenteront. En évitant les goulots d’étranglement inutiles, les entreprises accélèrent la mise au point des modèles et améliorent le retour sur investissement de leur infrastructure.
Le couplage faible entre les applications et le stockage permet aux entreprises d’adopter de nouvelles solutions de stockage objet, de s’étendre à de nouvelles régions ou de rapatrier des charges de travail depuis des clouds publics sans réécriture coûteuse ni interruption de service. Cette agilité se traduit directement par des économies, une plus grande flexibilité dans le choix des fournisseurs et une meilleure résilience, autant d’atouts essentiels à mesure que l’adoption de l’IA s’accélère et que les stratégies de stockage évoluent.
Enfin, la centralisation de l’application des politiques garantit que l’intégrité des données et la conformité ne sont jamais reléguées au second plan. F5 BIG-IP offre aux architectes la visibilité, l’observabilité et les capacités d’application des politiques dont ils ont besoin pour garantir à la direction que les données sensibles restent protégées de bout en bout. Il en résulte une infrastructure d’IA non seulement plus rapide et plus fiable, mais aussi sécurisée, conforme et prête à être déployée à l’échelle de l’entreprise.
PRINCIPAUX AVANTAGES
Éliminez les goulots d’étranglement du pipeline
Assurez une utilisation optimale des GPU grâce à une distribution de données constante et hautement performante, afin de réduire les périodes d’inactivité des ressources de calcul et les retards dans l’exécution des tâches.
Gagnez en agilité dans tous les environnements de stockage
Dissociez les applications de systèmes de stockage spécifiques afin de permettre leur migration fluide entre différents clouds, régions ou environnements sur site, sans réécritures coûteuses.
Renforcez la sécurité des données et la conformité
Protégez les jeux de données sensibles grâce à une application centralisée des politiques afin d’empêcher l’empoisonnement des données et les accès non autorisés, tout en garantissant la conformité réglementaire.
CARACTÉRISTIQUES PRINCIPALES
Renforcez la résilience du site et activez l’équilibrage de charge
Surveillez en continu l’état du stockage et acheminez le trafic vers les points de terminaison ou les sites optimaux afin de garantir la résilience du service et un débit prévisible.
Déployez une gestion intelligente du trafic
Façonnez, hiérarchisez et répliquez les flux à grande échelle afin d’optimiser l’utilisation des GPU et d’éviter les congestions pour les charges de travail d’entraînement et d’ajustement fin de l’IA, ainsi que de mise à disposition de la RAG.
Garantissez une application intégrée des politiques de sécurité
Effectuez la terminaison TLS, l’atténuation des attaques par déni de service distribué (DDoS) et la protection des API de couche 7 directement dans le chemin de données afin de sécuriser les pipelines à plusieurs niveaux.