
À medida que os recursos de IA e aprendizado de máquina são cada vez mais considerados essenciais para impulsionar a inovação e a eficiência em empresas de todos os portes, as organizações precisam determinar a melhor forma de oferecer aos desenvolvedores de aplicações acesso a esses recursos. Em muitos casos, será usado um serviço de inferência de IA, ou seja, “um serviço que aciona modelos de IA para produzir uma saída com base em uma determinada entrada” (como prever uma classificação ou gerar texto), geralmente em resposta a uma chamada de API feita pelo código de outra aplicação.
Esses serviços de inferência podem ser desenvolvidos e utilizados de diversas maneiras (até mesmo dentro de uma única organização). Eles podem ser desenvolvidos inteiramente de forma interna ou consumidos como SaaS, aproveitar projetos de código aberto e usar modelos abertos ou comerciais. Podem fazer parte de uma “Plataforma de Machine Learning” completa, que ofereça suporte a iniciativas mais amplas de ciência de dados e criação de modelos, ou simplesmente disponibilizar um endpoint de API para executar os modelos. Podem ser executados em um data center privado, em uma nuvem pública, em uma instalação de colocation ou em uma combinação desses ambientes. É provável que organizações maiores recorram a mais de uma opção de inferência de IA (especialmente quando apresentam níveis mais baixos de maturidade organizacional nessa área). Embora não exista uma abordagem única que funcione para todos, alguns padrões comuns estão surgindo.
Visão geral dos padrões
Analisaremos três padrões gerais de consumo de inferência de IA, bem como seus diversos pontos fortes e fracos:
- Inferência de IA como SaaS – Os aplicativos se conectam a um provedor externo especializado em serviços de inferência de IA.
- Inferência de IA gerenciada na nuvem – Os aplicativos se conectam a serviços de inferência de IA totalmente gerenciados e executados na nuvem pública.
- Inferência de IA autogerenciada – Os aplicativos utilizam inferência de IA gerenciada pela própria organização, seja como parte de um serviço centralizado ou diretamente no nível do aplicativo.
Principais pontos de decisão
Ao avaliar os prós e contras dos padrões operacionais a seguir, é importante considerar alguns fatores-chave:
Considerações operacionais
Escalabilidade – Quem é responsável por dimensionar uma determinada opção e com que eficiência ela pode ser ampliada ou reduzida à medida que as necessidades de capacidade mudam ao longo do tempo? Há limites de escalabilidade ou de capacidade?Custo – À primeira vista, os serviços totalmente gerenciados podem parecer mais caros, mas, ao considerar o custo total de propriedade (incluindo hardware especializado e pessoal), a decisão pode não ser tão óbvia. Como os custos operacionais variam à medida que a capacidade aumenta ou diminui? Há custos mínimos?Manutenção / Suporte – Quem é responsável pela manutenção do serviço de inferência? Sua organização precisará contratar funcionários ou consultores especializados nessa área, ou faria mais sentido optar por um serviço gerenciado?
Considerações sobre o desenvolvimento
Facilidade de integração das cargas de trabalho – Com que rapidez o serviço de IA pode ser integrado às cargas de trabalho que o utilizam? A oferta do serviço é compatível com o padrão de uso esperado (por exemplo, inferência offline/em lote) e com os ambientes operacionais?Agilidade – Com que rapidez a aplicação como um todo pode ser adaptada às mudanças nos requisitos de negócios? Quais aspectos da arquitetura estão mais consolidados e seriam difíceis de alterar?
Considerações sobre desempenho
Desempenho – A localização física do serviço (em relação aos consumidores do serviço) e a latência da inferência são relevantes para seus casos de uso?Disponibilidade de hardware – Há algum requisito especial de hardware para o serviço? Em caso afirmativo, você tem capacidade para atender à demanda esperada (aplicável tanto a ambientes locais quanto em nuvem)?
Considerações sobre os dados
Vazamento de dados – Existe a preocupação de que dados confidenciais possam ser enviados ao serviço de inferência ou estar presentes no resultado da inferência? Em caso afirmativo, é possível inspecionar o tráfego e aplicar medidas de proteção?Governança de dados – Para onde os dados da aplicação são enviados geograficamente (e como)? O controle direto permanece na organização ou é transferido a terceiros? Existem regulamentações ou políticas de conformidade específicas que determinem como os dados devem ser tratados?
Padrão SaaS
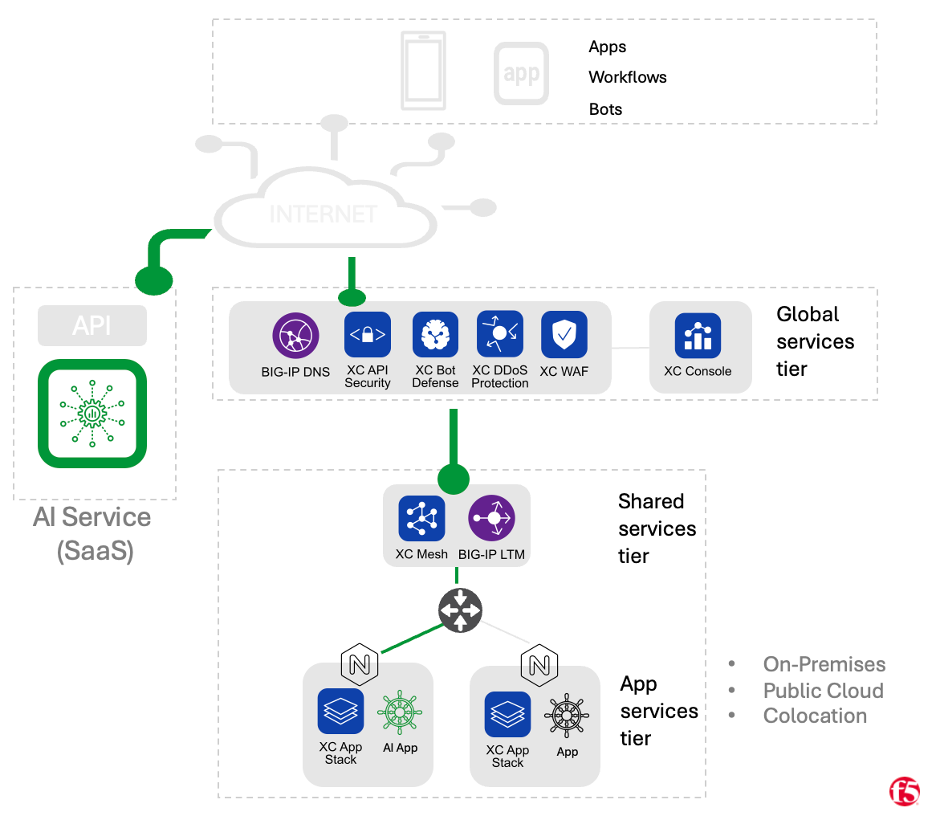
As organizações podem optar por utilizar os serviços de um provedor de SaaS dedicado, especializado em hospedar modelos de IA para inferência (como OpenAI ou Cohere). Nesse caso, as cargas de trabalho executadas na infraestrutura da organização (seja em um data center privado, em uma instalação de colocation ou na nuvem pública) utilizam APIs disponibilizadas pelo provedor de SaaS. Com esse padrão, a responsabilidade pela operação da infraestrutura necessária para hospedar os modelos recai inteiramente sobre o provedor de SaaS, e o tempo necessário para colocar tudo em funcionamento pode ser muito curto. No entanto, esses benefícios vêm à custa do controle, pois esse padrão é o menos “flexível” entre os que abordaremos. Da mesma forma, o controle sobre dados confidenciais costuma ser menor nesse modelo, no qual a internet pública geralmente é usada para se conectar ao serviço, e é menos provável que o fornecedor externo de SaaS consiga atender a requisitos rigorosos de conformidade regulatória.
Ideal para
- Tempo de lançamento no mercado: prototipagem rápida e lançamentos de MVP.
- Organizações sem conhecimento especializado ou experiência significativa em inferência de IA internamente.
- Aplicações sem necessidades significativas ou rigorosas de segurança e governança de dados.
Pontos fortes
- Curto prazo de lançamento no mercado: um modelo operacional simples pode resultar em tempos de integração reduzidos.
- Provedores de serviços especializados estão bem preparados para lidar com os desafios de escalabilidade da inferência.
- Não exige investimento em hardware especializado nem em pessoal qualificado.
Desafios
- Preocupações com latência e conectividade em comparação com serviços executados no mesmo ambiente que as cargas de trabalho dos aplicativos.
- As questões de privacidade, governança e segurança de dados dependem de um provedor externo de SaaS (ou podem ser incompatíveis com ele).
- Em maior escala, os custos operacionais podem ser mais altos do que nos modelos de hospedagem própria.
- Pode não haver suporte para hospedagem de modelos personalizados e serviços de personalização de modelos.
Padrão gerenciado na nuvem
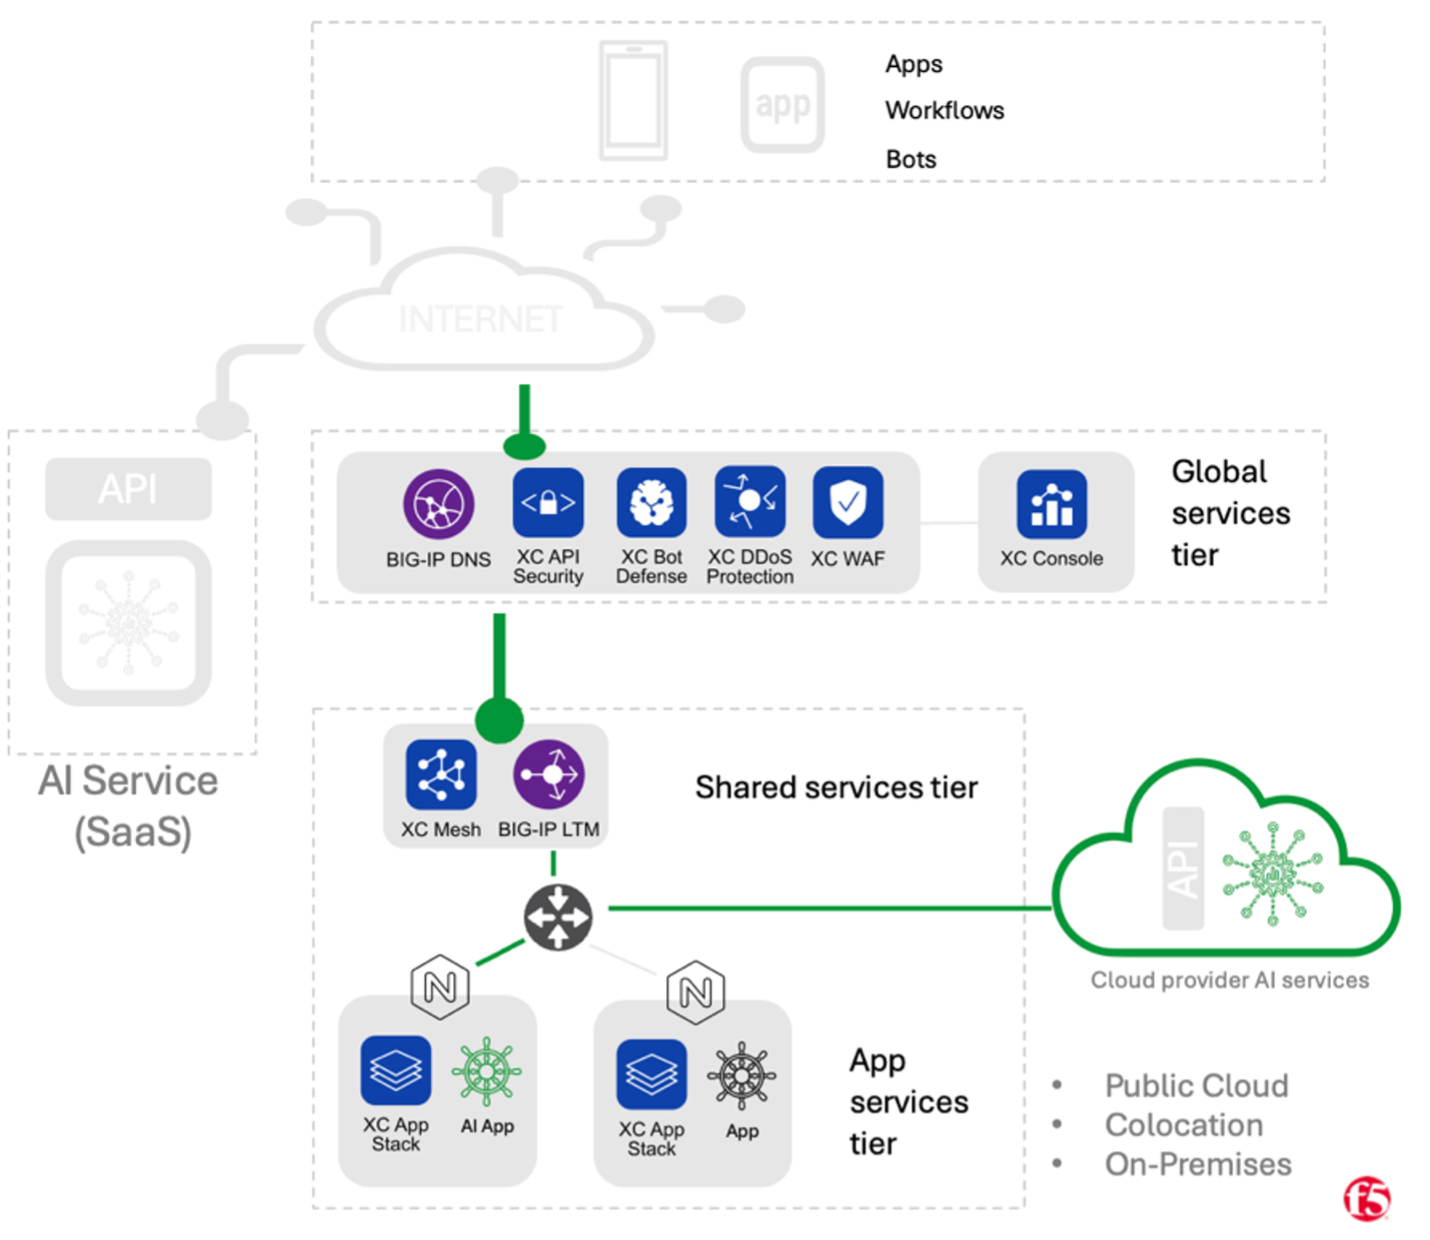
Nesse padrão, as organizações utilizam serviços gerenciados fornecidos por provedores de nuvem pública (por exemplo, Azure OpenAI, Google Vertex e AWS Bedrock). Assim como no primeiro padrão, a responsabilidade operacional pela implantação, pelo dimensionamento e pela manutenção dos modelos de IA recai sobre o provedor de nuvem, e não sobre a organização que consome o serviço. A principal diferença entre esse padrão e o padrão de SaaS mencionado acima é que, nesse caso, os endpoints da API de inferência geralmente podem ser acessados por meio de redes privadas, e as cargas de trabalho dos consumidores de IA podem ser alocadas junto ao serviço de modelo de IA (por exemplo, na mesma zona ou região). Como resultado, os dados normalmente não trafegam pela internet pública, a latência tende a ser menor e os mecanismos de conexão a esses serviços são semelhantes aos usados para outros serviços gerenciados de provedores de nuvem (ou seja, contas de serviço, políticas de acesso e ACLs de rede). As organizações que utilizam redes multinuvem podem obter alguns desses mesmos benefícios mesmo quando as cargas de trabalho e os serviços de inferência de IA estão hospedados em nuvens diferentes.
Ideal para
- Organizações que já investem em nuvem pública.
- Aplicações executadas em outros serviços gerenciados em nuvem ou conectadas a eles.
Pontos fortes
- Muitas organizações já estão familiarizadas com a conexão de suas cargas de trabalho a outros serviços gerenciados de provedores de nuvem (por exemplo, bancos de dados, armazenamentos de objetos etc.).
- A responsabilidade operacional e de infraestrutura pela execução e pelo dimensionamento dos modelos recai principalmente sobre o provedor de nuvem.
- As preocupações com a latência e algumas questões de privacidade de dados podem ser mais fáceis de resolver.
Desafios
- Aplicações em ambientes multicloud/nuvem híbrida exigem esforço adicional para serem conectadas e protegidas.
- A falta de uniformidade entre os serviços gerenciados em nuvem e as APIs pode levar à dependência de um fornecedor.
- Organizações sem uma presença significativa na nuvem pública podem enfrentar dificuldades.
- Em operações de maior escala, os custos operacionais podem ser mais altos do que nos modelos de hospedagem própria.
- Talvez não haja suporte para hospedagem de modelos personalizados e serviços de personalização de modelos.
Padrão autogerenciado
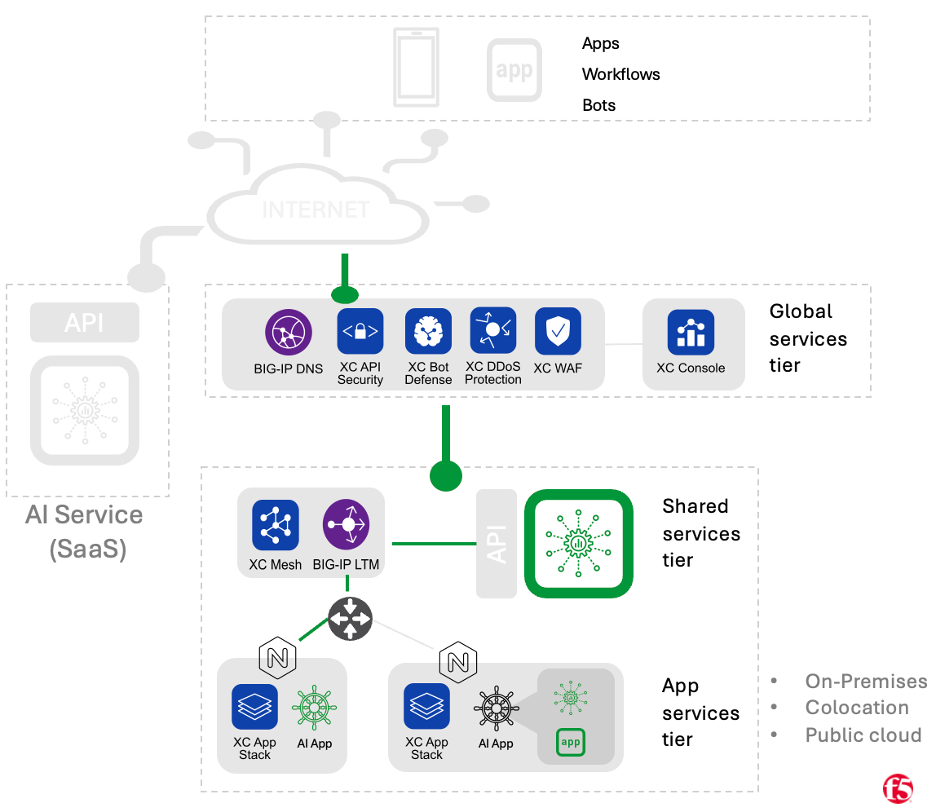
Para o modelo autogerenciado, primeiro discutiremos o caso em que a inferência de modelos de IA é executada como um “serviço compartilhado” centralizado e, em seguida, analisaremos o caso em que não há um serviço centralizado e as questões operacionais ficam a cargo de cada equipe de aplicação.
Serviço compartilhado autogerenciado
Na variante de “Serviço Compartilhado” do padrão Autogerenciado, uma organização pode ter uma ou mais equipes dedicadas responsáveis pela manutenção da infraestrutura de inferência, dos modelos executados nela, das APIs usadas para se conectar a ela e de todos os aspectos operacionais do ciclo de vida do serviço de inferência. Assim como nos outros padrões, as cargas de trabalho das aplicações de IA consumiriam os serviços de inferência por meio de chamadas de API. A infraestrutura de disponibilização de modelos pode ser executada em data centers privados, na nuvem pública ou em uma instalação de colocation. As equipes responsáveis pela operação do serviço de inferência podem utilizar plataformas de aprendizado de máquina auto-hospedadas (como Anyscale Ray ou MLFlow). Como alternativa, podem recorrer a ferramentas mais específicas para disponibilização de inferência, como o servidor Text Generation Inference da Hugging Face, ou a softwares desenvolvidos internamente. Com a inferência autogerenciada, as organizações ficam limitadas ao uso de modelos que elas próprias treinaram ou que estejam disponíveis para execução local (portanto, modelos proprietários de um serviço baseado em SaaS podem não ser uma opção).
Mais adequado para
- Organizações maduras com ampla experiência em gerenciamento de infraestrutura.
- Organizações com alta demanda de inferência que justifique o custo total de propriedade (TCO) de um serviço autogerenciado.
- Aplicações com os requisitos mais rigorosos de privacidade de dados e conformidade.
Pontos fortes
- As organizações têm controle total sobre todos os aspectos do serviço de inferência.
- Os desafios de privacidade de dados geralmente são mais fáceis de resolver com modelos auto-hospedados.
- Em grande escala, o custo pode ser mais vantajoso do que o de serviços de inferência gerenciados na nuvem ou baseados em SaaS.
Desafios
- As organizações têm controle total sobre todos os aspectos do serviço de inferência (provavelmente serão necessários grandes investimentos em infraestrutura e pessoal, além de manutenção e desenvolvimento contínuos e atenção a questões de escalabilidade).
- Normalmente, não é uma opção economicamente viável para organizações com necessidades mínimas de inferência e poucas preocupações com a privacidade dos dados.
- Sem acesso a modelos fechados/proprietários que possam estar disponíveis como SaaS ou serviços gerenciados em nuvem.
Autogerenciado, não um serviço compartilhado
Organizações que não contam com uma equipe central responsável por operar serviços de inferência de IA para uso por aplicações representam a outra variante do padrão autogerenciado. Nessa versão, as equipes de cada aplicação podem executar seus modelos na mesma infraestrutura que lhes foi alocada para a carga de trabalho da aplicação. Elas podem optar por acessar esses modelos via API ou utilizá-los diretamente de forma “offline”. Com esse padrão, os desenvolvedores podem obter, em menor escala, alguns dos mesmos benefícios do modelo autogerenciado de “serviço compartilhado”.
Mais adequado para
- Aplicações que exigem processamento em lote e inferência offline.
- Organizações com consumo muito baixo de inferência, mas com requisitos rigorosos de privacidade de dados e conformidade.
Pontos fortes
- Maior flexibilidade para desenvolvedores de aplicações, permitindo uma ampla variedade de possibilidades de integração com cargas de trabalho.
- Pode atingir metas de privacidade de dados e latência em pequena escala.
- Pode ser mais econômico do que os outros modelos discutidos em alguns casos (como no caso de uma única equipe com altas demandas de consumo).
Desafios
- A responsabilidade operacional pelo ciclo de vida do modelo é atribuída às equipes de cada aplicação.
- Não aproveita as economias de escala à medida que aumenta o consumo de inferência de IA por uma organização (falta de consistência, utilização ineficiente de recursos etc.)
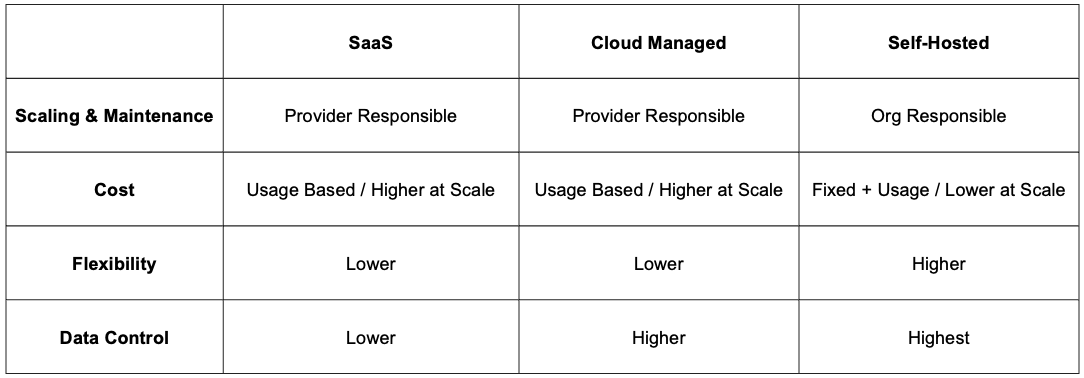
Resumo das vantagens e desvantagens dos padrões
Protegendo aplicativos de IA e serviços de inferência de modelos
Em sua essência, as aplicações de IA são muito semelhantes a qualquer outra aplicação moderna. Elas são desenvolvidas com uma combinação de componentes voltados ao usuário e de backend, muitas vezes dependem de armazenamentos de dados externos, fazem uso intensivo de chamadas de API etc. Essas aplicações herdam os mesmos desafios de segurança comuns a todas as aplicações modernas e precisam das mesmas proteções, aplicadas da mesma forma (por exemplo, AuthNZ, proteções contra DDoS, WAF, práticas de desenvolvimento seguro etc.). No entanto, as aplicações de IA, especialmente aquelas que utilizam IA generativa, também estão sujeitas a uma série de questões específicas que podem não se aplicar a outras aplicações (por exemplo, consulte OWASP Top 10 para LLMs). A natureza geralmente imprevisível desses modelos pode gerar novos problemas, especialmente em casos de uso nos quais os modelos recebem um grau significativo de autonomia.
Felizmente, devido à forte dependência de interações orientadas por API com a inferência de modelos de IA nos padrões discutidos acima, muitas organizações já estão bem posicionadas para implementar essas novas medidas de segurança. Por exemplo, um gateway de API que ofereça funcionalidades tradicionais de limitação de taxa, autenticação, autorização e gerenciamento de tráfego pode ser ampliado para oferecer suporte a limites de taxa baseados em tokens, ajudando no controle de custos (seja no tráfego de saída, no nível da aplicação, para um serviço gerenciado por um provedor/SaaS, seja no tráfego de entrada, com autorização RBAC como proteção à frente de um serviço de inferência autogerenciado). Da mesma forma, a infraestrutura que atualmente executa serviços tradicionais de Web Application Firewall (WAF), como a verificação de injeção de SQL ou XSS, pode ser um local adequado para adicionar proteções contra injeção de prompts e ataques semelhantes. A maioria das práticas modernas de observabilidade é diretamente aplicável a casos de uso específicos de inferência de IA orientada por API, e as equipes devem conseguir aproveitar bem as ferramentas e práticas já existentes nessa área.
Conclusão
Embora o entusiasmo em torno de aplicações baseadas em IA e serviços de inferência seja certamente recente, os princípios fundamentais envolvidos em sua implantação e proteção existem há muito tempo. As organizações precisarão avaliar as vantagens e desvantagens ao determinar a melhor forma de aproveitar os recursos de IA, assim como fazem ao adotar qualquer outra tecnologia, considerando seus casos de uso específicos, os recursos disponíveis e os objetivos de longo prazo. Da mesma forma, embora os casos de uso de IA — especialmente de IA generativa — apresentem alguns novos desafios de segurança, as necessidades que compartilham com outras aplicações modernas e a forte dependência da interação com modelos por meio de APIs oferecem uma excelente oportunidade para utilizar e ampliar padrões, práticas e ferramentas existentes. Seja em uma solução auto-hospedada ou em um serviço gerenciado, garantir que os desenvolvedores tenham acesso a uma solução segura, escalável e de alto desempenho, que atenda aos requisitos específicos da sua empresa, é fundamental para maximizar o valor e o impacto dos seus investimentos em IA.
Sobre o autor
Publicações relacionadas no blog

O estado da maturidade digital empresarial: a transformação digital ainda não terminou
Explore como a IA impacta as empresas, as aplicações da IA generativa, as estratégias para modernizar as operações de TI e os benefícios da maturidade digital com a F5.
Como a IA generativa acelera a transformação digital
Veja como a IA generativa impulsiona a transformação digital nas empresas, acelerando tendências como a integração de APIs, os desafios dos modelos operacionais de TI híbrida e a adoção de AIOps.
Seis capacidades técnicas para acelerar a transformação digital
As arquiteturas empresariais atuais carecem dos fatores necessários de agilidade, escalabilidade, segurança e observabilidade, essenciais para impulsionar a mudança tecnológica. No entanto, estas seis capacidades fundamentais ajudarão as empresas a gerenciar riscos e desafios ao longo de sua transformação digital.
Inverter a API é a transformação digital de que as empresas precisam para participar e competir em uma economia de APIs
As organizações detêm um valor latente — na forma de APIs internas — que precisam explorar para competir em uma economia de APIs. Embora os desafios técnicos e de segurança possam desestimular algumas delas, as empresas precisam reconhecer que inverter suas APIs permitirá liberar o valor da organização como plataforma.
A modernização da TI começa pela infraestrutura
O hardware e o software evoluíram rapidamente desde os primórdios da internet, mas, para aproveitar ao máximo os benefícios resultantes dessa evolução, as organizações precisam avaliar e modernizar sua infraestrutura e a entrega de aplicativos. Acelere os esforços de modernização com a nova F5 rSeries.