
Este é o primeiro de uma série de artigos que abordam diversos aspectos do que foi necessário para desenvolver e operar nosso serviço SaaS :
- Plano de controle para uma PaaS Kubernetes distribuída
- Malha de serviços global para aplicações distribuídas
- Segurança de plataforma para infraestrutura, aplicativos e dados distribuídos
- Segurança de aplicações e redes de clusters distribuídos
- Observabilidade em uma plataforma distribuída globalmente
- Operações e SRE de uma plataforma distribuída globalmente
- Framework de serviços em Golang para microsserviços distribuídos
Como descrevemos em nosso blog anterior, nossos clientes estão desenvolvendo conjuntos complexos e diversificados de soluções empresariais — como manufatura inteligente, análise forense de vídeo para segurança pública, negociação algorítmica e redes 5G de telecomunicações — e, por isso, precisamos oferecer uma experiência sempre disponível, conectada e confiável para essas aplicações e seus usuários finais.
Como esses aplicativos podem ser executados em vários clusters distribuídos entre provedores de nuvem ou locais de edge dos clientes, nossa equipe de plataforma precisou criar um plano de controle distribuído e um serviço de PaaS para implantar, proteger e operar vários clusters Kubernetes multilocatários. Esse plano de controle distribuído proporcionou muitos benefícios operacionais, de escalabilidade e de desempenho, que abordaremos em nossa apresentação (link do vídeo) — por exemplo, como gerenciar milhares de clusters K8s de edge com GitOps — e também em uma publicação separada no blog nas próximas semanas.
TL;DR (Resumo)
- Não conseguimos encontrar no mercado uma solução fácil de usar que resolvesse o problema de implantar, proteger e operar vários clusters de aplicações distribuídos entre provedores de nuvem, nuvens privadas ou diversos locais de edge computing.
- Não conseguimos encontrar uma distribuição robusta do Kubernetes ou uma PaaS (por exemplo, OpenShift, Cloud Foundry etc.) que oferecesse um conjunto abrangente de serviços operacionais e de segurança necessários para clusters distribuídos — como identidade baseada em PKI, RBAC e gerenciamento de acesso de usuários, gerenciamento de segredos e chaves entre provedores de nuvem, malha de serviços multicluster, observabilidade e logs de auditoria ou segurança de aplicações e redes.
- Anthos (Google), Azure Arc (Microsoft) e Rancher são plataformas de gerenciamento de múltiplos clusters que reúnem diversos serviços diferentes; nossa análise concluiu que essas soluções não teriam atendido aos requisitos operacionais, de escalabilidade, segurança e multilocação que tínhamos para serviços de aplicações e infraestrutura em vários clusters.
- Tivemos que criar nosso próprio plano de controle distribuído para nossa PaaS gerenciada, desenvolvida sobre o Kubernetes. Começamos com o Kubernetes padrão e, em seguida, fizemos alterações significativas para fornecer os serviços de plataforma necessários às nossas equipes de DevOps e SRE. Além disso, tivemos que criar um plano de controle para gerenciar um grande número de clusters distribuídos e oferecer multilocação em uma infraestrutura heterogênea (na borda, em nossa rede e em vários provedores de nuvem).
Kubernetes para gerenciamento de aplicações: por quê e como
Escolhemos o Kubernetes (K8s) como o núcleo da nossa plataforma de gerenciamento de aplicações distribuídas, pois ele oferece um amplo conjunto de funcionalidades sem impor regras em excesso — o que nos dá flexibilidade para inovar em aspectos que consideramos importantes para nossos clientes. Usamos essa base para começar a desenvolver nosso serviço e, com a crescente popularidade do K8s, também ficou mais fácil encontrar desenvolvedores e operadores familiarizados com ele.
Dito isso, implantar e gerenciar um grande número de clusters Kubernetes prontos para produção em um ambiente híbrido (várias nuvens, pontos de presença de rede e locais de edge computing) não é uma tarefa fácil, pois não há soluções prontas para uso no Kubernetes que possam:
- Harmonizar recursos de infraestrutura heterogêneos com agrupamento, escalabilidade e provisionamento sem intervenção automatizados; isso era especialmente problemático na borda e em nossos PoPs de rede
- Forneça conectividade confiável e de alto desempenho entre locais distintos — especialmente ao transitar entre provedores de nuvem e a partir de locais de borda
- Resolva o problema de segurança dos dados em trânsito, dos dados em repouso, dos segredos, das chaves e da rede… tudo respaldado por uma identidade de PKI uniforme que funciona na borda, na rede e na nuvem
- Ofereça multitenancy de verdade — com isolamento entre tenants e garantias de segurança — e a capacidade de executar cargas de trabalho de produção e desenvolvimento para atender às necessidades internas e dos clientes nos mesmos clusters
- Forneça observabilidade e operações em clusters distribuídos, integradas a políticas e objetivos centralizados, sem a necessidade de criar uma infraestrutura complexa de coleta de logs e métricas
Após várias provas de conceito com diversos provedores de nuvem e plataformas de código aberto, como GKE, AKS, EKS e RKE, além de OpenShift e Cloud Foundry, percebemos que nenhuma delas atendia a todos os cinco requisitos acima. Por isso, decidimos criar nossa própria PaaS, partindo do Kubernetes “puro” e incorporando diversos recursos de identidade, rede, segurança, multilocação, logs, métricas etc. Embora usemos o Kubernetes para atender às nossas necessidades internas, tivemos que tomar algumas decisões difíceis, como não disponibilizar esses clusters do Kubernetes diretamente aos nossos usuários internos e/ou clientes para que executassem suas cargas de trabalho (falaremos mais sobre isso adiante, pois a multilocação era um objetivo fundamental para nós).
Além dos vários novos recursos que precisávamos adicionar, também era necessário executar nossas cargas de trabalho e serviços junto às cargas de trabalho dos clientes em diversos locais na borda, em nossa rede e em nuvens públicas e privadas. Isso significava que precisávamos desenvolver recursos adicionais para gerenciar vários clusters em diferentes ambientes… todos conectados por meio de nossa rede global e de nossos gateways de aplicações distribuídos, a fim de oferecer conectividade de confiança zero e no nível das aplicações entre esses clusters.
A parte difícil: multilocação e múltiplos clusters no Kubernetes
Criar e operar aplicações executadas em um único cluster Kubernetes não é uma tarefa trivial, mesmo quando se utiliza um cluster gerenciado por um provedor de nuvem. Por isso, é comum que as equipes de DevOps e SRE busquem minimizar sua sobrecarga operacional e evitem lidar com as complexidades de vários clusters. É bastante comum ver equipes criarem um grande cluster Kubernetes e colocarem nele todos os tipos de recursos. Embora isso pareça ótimo, pois permite simplificar as operações e executar o cluster com a máxima eficiência computacional e de custos, essa não é a melhor ideia por vários motivos. Em primeiro lugar, as necessidades das cargas de trabalho de produção são muito diferentes das de desenvolvimento e testes e das de homologação — cargas de trabalho de desenvolvimento instáveis podem causar problemas para cargas de trabalho de produção mais estáveis.
Além das necessidades de diferentes cargas de trabalho, as limitações de segurança e isolamento do K8s são outro fator que impulsiona a adoção de múltiplos clusters. Uma abordagem comum para solucionar questões de segurança e isolamento de recursos no K8s é criar clusters independentes para cada locatário usando um modelo multilocatário. Embora isso possa ser viável na nuvem, não é possível executar vários clusters na borda. Os locais de borda têm recursos limitados de computação e armazenamento, além de largura de banda de rede restrita para enviar logs e métricas de cada cluster adicional à nuvem central.
Para lidar com o problema de vários clusters Kubernetes, avaliamos o Rancher para o gerenciamento centralizado dos nossos clusters Kubernetes (quando começamos, o Anthos e o Azure Arc ainda não existiam), bem como o KubeFed. As duas abordagens disponíveis na época eram (e a situação continua a mesma hoje):
- O gerenciamento de vários clusters (por exemplo, com o Rancher) a partir de um console central teria nos permitido implantar vários clusters em qualquer local e realizar operações de gerenciamento do ciclo de vida, como atualizações, reversões etc. Alguns desses sistemas também permitiam gerenciar um cluster individual por meio da automação da configuração e da implantação de aplicações
- Outra abordagem é implantar um plano de controle de federação de clusters Kubernetes (KubeFed), que pode fazer com que vários clusters físicos pareçam um único cluster. Esse projeto estava apenas começando quando o avaliamos e, ainda hoje, encontra-se apenas em estágio alfa.
Após o recente anúncio do GCP Anthos e do Azure Arc, reavaliamos nossa decisão original de criar um plano de controle distribuído e concluímos que nem mesmo essas duas novas soluções teriam sido capazes de resolver dois problemas críticos relacionados a clusters distribuídos. Os dois principais recursos de que precisávamos para nossa plataforma eram:
- Gerenciar vários clusters como uma frota para viabilizar a execução de operações em todos os clusters ou em um grupo lógico deles — operações como configuração, implantação, métricas etc. Isso é fundamental, pois queremos reduzir a sobrecarga operacional das nossas equipes de SRE, facilitar a depuração para nossas equipes de DevOps e melhorar a escalabilidade do nosso sistema
- Capacidade de particionar um único cluster físico do Kubernetes para oferecer multilocação sem precisar provisionar outros clusters físicos — isso é especialmente importante em ambientes com recursos limitados, nos quais não queremos adicionar novos clusters físicos apenas para viabilizar a multilocação
Para resolver esses dois problemas, tivemos que desenvolver uma nova técnica — o plano de controle distribuído — para reduzir a sobrecarga operacional de “múltiplos” clusters e oferecer o equivalente a “múltiplos clusters” para multilocação em ambientes com recursos limitados.
Plano de controle distribuído: como implementamos o Kubernetes multicluster
Nossa equipe de plataforma decidiu criar um plano de controle distribuído para Kubernetes que disponibiliza APIs do Kubernetes para uso da nossa equipe. No entanto, essas APIs são provenientes de clusters “virtuais” que existem apenas em nosso plano de controle — um servidor de API K8s virtual (vK8s) para um cluster K8s virtual (conforme mostrado na Figura 1). Esse plano de controle mapeia a intenção do usuário para vários clusters físicos do Kubernetes executados em nossa infraestrutura de edge, nos POPs da nossa rede e em ambientes de nuvem pública. Esses clusters físicos só podem ser acessados pelo nosso plano de controle distribuído, e não por tenants/usuários individuais.
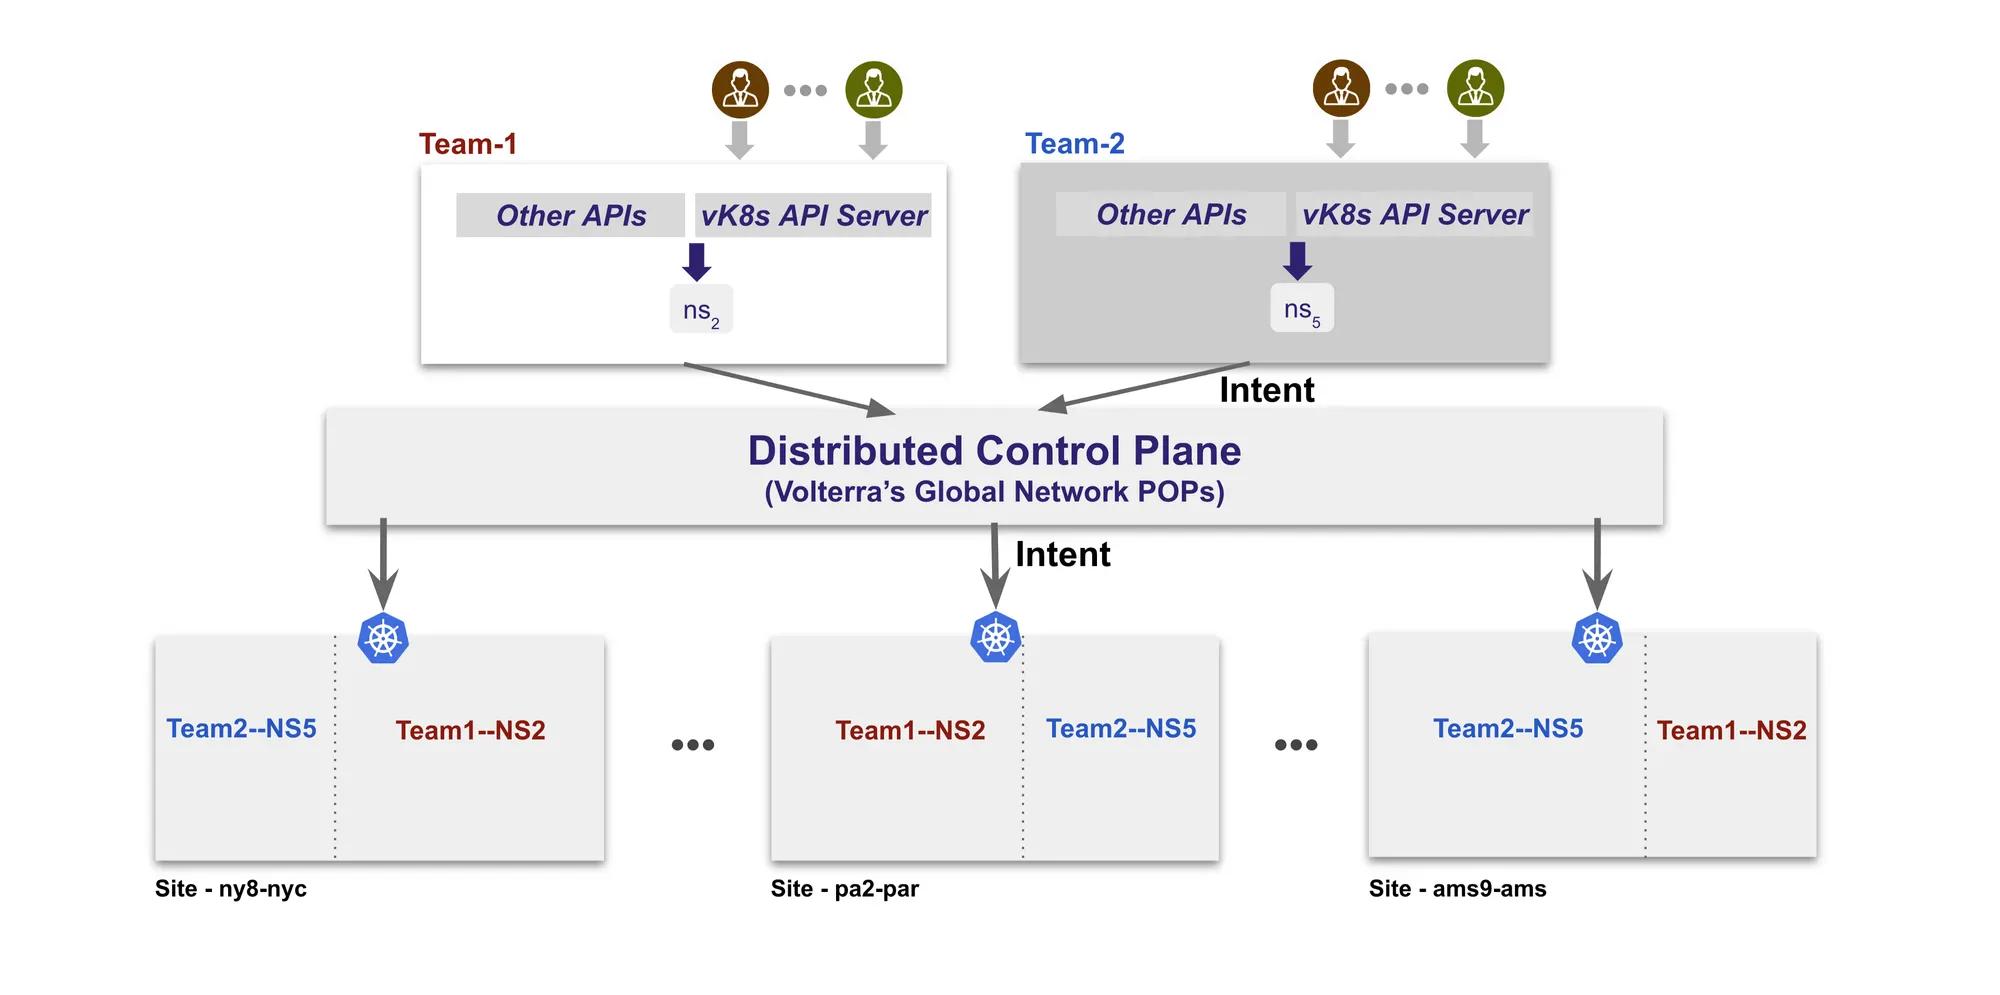
Esse plano de controle fornece a cada locatário um ou mais clusters de aplicações “virtuais”, nos quais é possível implantar suas aplicações. Com base na configuração, o plano de controle as replica e gerencia em vários clusters físicos do Kubernetes. Além das operações de configuração e implantação, as operações de monitoramento também acompanham esse cluster “virtual”, sem a necessidade de criar ferramentas para coletar e analisar dados de vários clusters físicos.
Vamos considerar como exemplo um aplicativo de interface do usuário chamado productpage, que o usuário pretende executar de forma distribuída em três locais — pa2-par, ny8-nyc e ams9-ams —, com duas réplicas em cada um deles. Quando o usuário cria um objeto vK8s e o associa a um cluster virtual, um servidor de API vK8s é provisionado imediatamente e pode ser usado com o kubectl padrão.
Na etapa seguinte, o usuário baixa o kubeconfig desse cluster virtual e cria um arquivo YAML padrão para descrever uma implantação do K8s para o productpage.
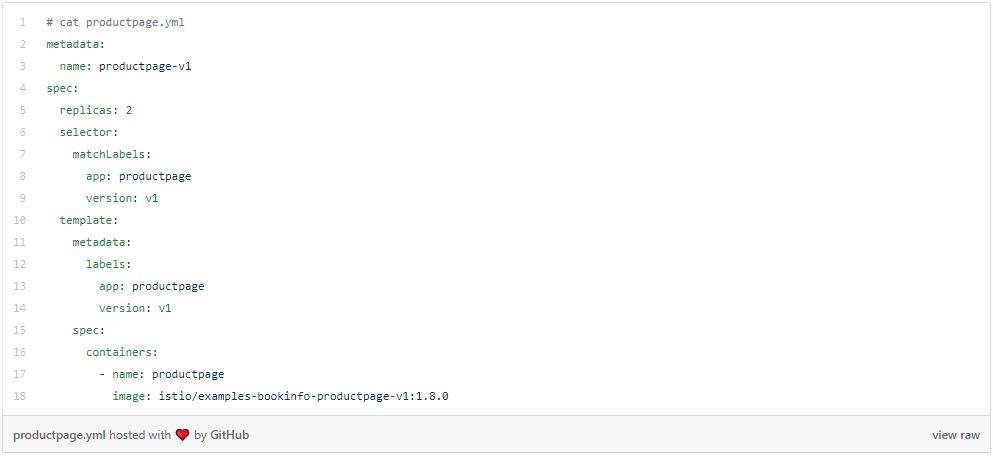
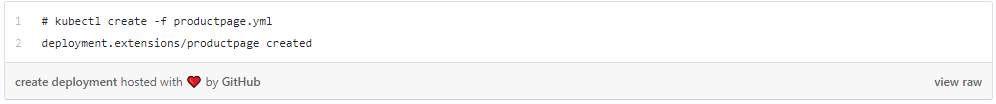
Após criar a especificação de implantação, o usuário pode prosseguir com a criação de uma implantação neste cluster virtual:
Agora, se o usuário verificar sua implantação, verá que 6 réplicas foram iniciadas, com 2 em cada local (pa2-par, ny8-nyc e ams9-ams).
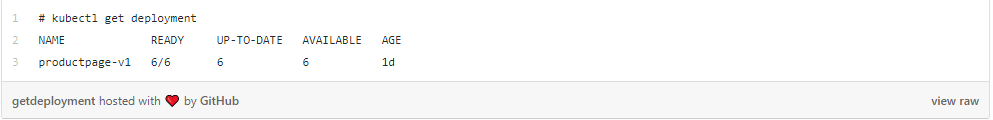
A saída a seguir mostra dois pods em execução em cada local, com o mapeamento para um nó físico específico
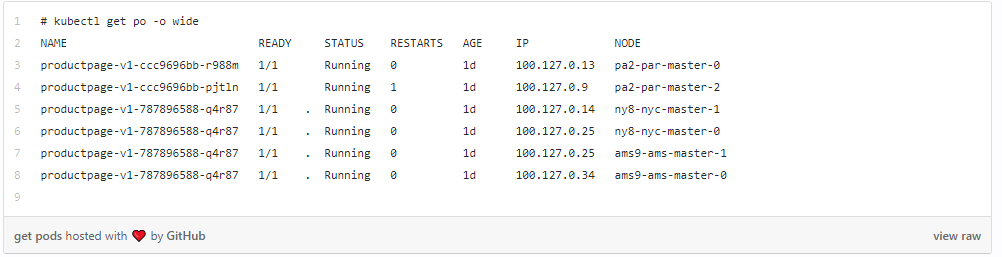
Este exemplo simples demonstra como é fácil obter, em poucos minutos, a replicação de qualquer aplicativo em vários clusters, sem a sobrecarga de instalação e gerenciamento. Além de mapear a intenção, o plano de controle distribuído também oferece observabilidade para o cluster virtual como um todo, e não para cada cluster individualmente.
Controle distribuído e gerenciamento centralizado para multilocação
Como você pode ver na Figura 2, nosso plano de gerenciamento centralizado está sendo executado em dois provedores de nuvem pública (uma região em cada um) — um na AWS e outro no Azure (para redundância). Esse plano de gerenciamento permite que nossa equipe de SRE crie tenants com isolamento rígido entre eles — por exemplo, uma equipe de desenvolvimento que trabalha em nosso serviço VoltMesh pode ser um tenant, enquanto uma equipe de soluções para clientes que trabalha em POCs de clientes pode ser outro tenant, com seu próprio conjunto de usuários.
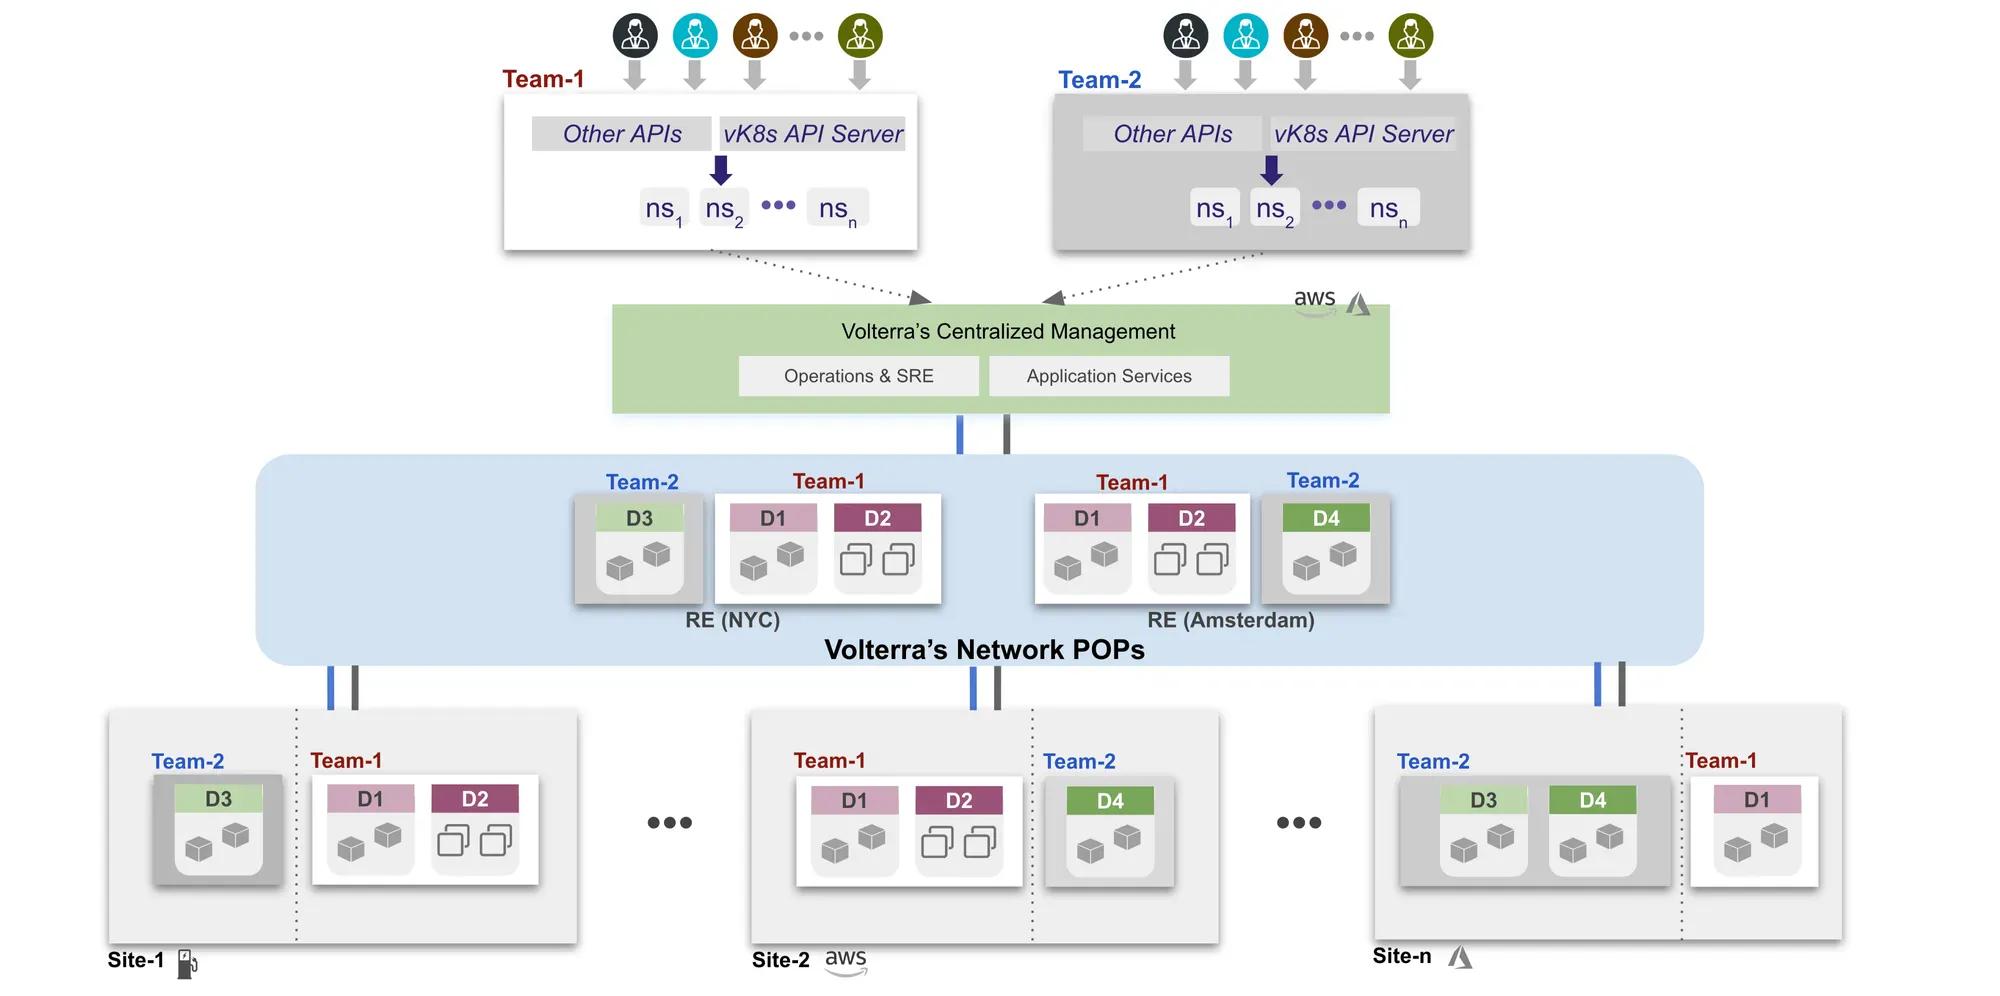
Cada um desses tenants pode criar vários namespaces e atribuir um grupo de usuários para colaborar nesses namespaces. Esses namespaces não são namespaces do Kubernetes — eles constituem um limite de isolamento em nossa plataforma, com regras de RBAC e políticas de IAM para os usuários.
Quando um usuário em um namespace deseja criar um cluster de aplicações, ele cria um objeto vK8s que, por sua vez, cria um servidor de API vK8s em nosso plano de gerenciamento. Usando esse objeto vK8s, o usuário pode criar deployments, stateful sets, PVCs etc., e o plano de controle garantirá que essas operações sejam realizadas em um ou mais clusters físicos, com base nos sites associados ao objeto vK8s.
Como cada tenant e usuário utiliza operações padrão do K8s sem nenhuma modificação, o sistema é compatível com diversas ferramentas populares entre os operadores, como Spinnaker, Helm, Jenkins etc.
Benefícios obtidos com um plano de controle distribuído
A grande vantagem de um plano de controle distribuído é que ele eliminou a sobrecarga operacional das nossas equipes de SRE e DevOps. Agora, elas podem realizar operações (configuração, implantação, monitoramento, políticas etc.) em um cluster virtual, e o plano de controle fará automaticamente o mapeamento para vários clusters físicos. Além de simplificar a operação de vários clusters, o plano de controle também resolveu o problema de segurança e isolamento em ambientes multilocatários.
Esse plano de controle distribuído também aumentou a produtividade dos desenvolvedores que desejam adicionar novos recursos à nossa plataforma — eles não precisam criar uma nova automação sempre que adicionam recursos que afetam a configuração ou as operações em vários clusters. Eles usam o modelo de configuração baseado em intenção, e o plano de controle sabe o que precisa ser feito. Além disso, eles podem continuar interagindo com esse objeto distribuído e composto por vários clusters — o kubernetes virtual — usando o kubectl, sem precisar recorrer a mais uma CLI.
Depois de executar isso em nossos ambientes de desenvolvimento e teste, homologação e produção por mais de um ano, percebemos que esse plano de controle distribuído globalmente (em execução nos POPs da nossa rede) também oferece vantagens significativas em termos de escalabilidade, desempenho e confiabilidade — algo que não havíamos imaginado por completo no início. Abordaremos essa descoberta em nossa próxima apresentação na KubeCon e em uma publicação separada no blog nas próximas semanas.
Continua…
Esta série de posts abordará vários aspectos do que foi necessário para desenvolver e operar nosso serviço SaaS distribuído globalmente, com diversos clusters de aplicações na nuvem pública, em nossos PoPs de rede privada e em locais de edge computing. O próximo tema é Malha de serviços global para aplicações distribuídas…
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...