As interrupções de serviço são caras. Se, em última análise, elas são resultado de um ataque ou de uma falha de software ou hardware não é tão relevante. Os custos por minuto de indisponibilidade estão aumentando devido à crescente dependência de APIs e aplicações web na economia digital moderna.
Para algumas empresas, esses custos são assombrosos. Estima-se que os 40 minutos de indisponibilidade da Amazon em 2013tenham custado US$ 2,64 milhões. Isso equivale a US$ 1.100 por segundo para quem não quiser fazer as contas. Se você acha isso assustador, considere o Google, cujos 5 minutos de indisponibilidade no mesmo ano custaram US$ 109 mil por minuto (ou US$ 1.816,67 por segundo) — um total exorbitante de US$ 545 mil. Por 5 minutos. Tecnicamente, se essa tivesse sido a única indisponibilidade, seria a tão almejada disponibilidade de “cinco noves” que a equipe de TI deve alcançar.
Com que frequência ocorrem interrupções? Com frequência demais, aparentemente. Se você nunca viu este mapa, dê uma olhada no mapa de interrupções em tempo real da Pingdom. Ele é criado com dados coletados de mais de 700 mil usuários da plataforma em todo o mundo. Esse mapa, fascinante de uma forma um tanto mórbida, exibe as interrupções ocorridas na última hora ao redor do planeta. Os clarões que representam as interrupções são um toque interessante e deixam bem evidente o impacto que elas causam nos usuários.
Ou seja, um impacto indesejado.
A economia digital agrava esse problema. No início deste ano, uma indisponibilidade do S3 da Amazon derrubou uma série de aplicativos e sites de clientes. Mas, antes que você atribua esse problema aos provedores de nuvem pública, uma rápida consulta ao site builtwith.com logo desfará essa impressão. A porcentagem de sites que utilizam CDNs e APIs talvez seja alarmantemente alta quando se considera a dependência gerada em relação ao tempo de atividade de terceiros. É difícil encontrar um site que não dependa de pelo menos uma API ou serviço externo, o que aumenta a possibilidade de indisponibilidade, pois, se esse serviço externo ficar fora do ar, seu site também ficará.
Basicamente, a TI adotou os “cinco noves” porque é impossível alcançar 100% de disponibilidade. Hoje, com os custos por segundo disparando devido à migração da economia para o ambiente digital, o segredo é minimizar o tempo de inatividade. Em outras palavras, definir metas que exijam um baixo tempo médio de resolução (MTTR) é tão importante — talvez até mais — quanto tentar eliminar o tempo de inatividade.
Uma das principais métricas das “organizações de alto desempenho” no Relatório sobre o Estado do DevOps de 2016 da Puppet Labs é o MTTR, definido como o tempo necessário para restaurar o serviço quando ocorre um incidente (por exemplo, uma interrupção não planejada ou degradação do serviço). As organizações de melhor desempenho (com base na avaliação do relatório) levam menos de uma hora, enquanto as organizações de médio e baixo desempenho levam “menos de um dia”. “Em outras palavras”, observa o relatório, “as organizações de alto desempenho apresentaram um MTTR 24 vezes mais rápido do que as de baixo desempenho”.
Observe que a questão não era “se” ocorreria um incidente de serviço, mas “quando” ele ocorreria. Parte-se do pressuposto de que um incidente acontecerá e, portanto, o segredo é minimizar o tempo de resolução. Uma pesquisa realizada pela IHS em 2016 revelou que, “em média, os participantes da pesquisa enfrentam 5 eventos de indisponibilidade por mês, totalizando 27 horas de indisponibilidade mensais”, o que custa US$ 1 à organização média de médio porte e até US$ 60 milhões às organizações maiores.
Se presumirmos que a Lei de Murphy ainda prevalece sobre as leis de Moore e Conway, a solução é tentar minimizar o MTTR para reduzir o tempo (e os custos) associados à inevitável indisponibilidade.
Isso significa que a visibilidade é fundamental, o que exige monitoramento. Muito, muito monitoramento. Mas não apenas do site, do aplicativo web ou da API — precisamos monitorar toda a stack. Desde a rede, passando pelos serviços do aplicativo, até a própria aplicação. Isso é algo que nem todos fazem e, quando fazem, parecem fazê-lo de forma inconsistente.
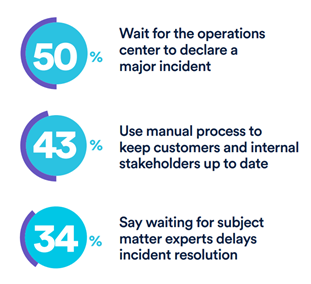
Considere a pesquisa de 2017 xMatters|Atlassian sobre maturidade em DevOpsna qual 50% dos entrevistados declararam que “esperam a equipe de operações declarar um incidente grave” antes de responder. É alarmante que 1/3 das empresas “fique sabendo das interrupções de serviço por meio de seus clientes”.
Em uma economia digital, cada segundo conta. Não apenas porque custa dinheiro, mas também porque afeta negativamente as receitas futuras, além disso. A redução do valor da marca e da confiança dos clientes resulta em menos compras, menos usuários e, por fim, na estagnação do crescimento. Não é esse o caminho que as organizações devem seguir.
O monitoramento é o primeiro passo para detectar problemas que causam indisponibilidade. Mas o monitoramento por si só não ajuda a reduzir o MTTR. A comunicação, sim. Alertar as partes interessadas assim que possível e fornecer a elas as informações necessárias para solucionar o problema contribui para uma resolução mais rápida. Isso significa que o compartilhamento — um dos quatro pilares fundamentais do DevOps — é essencial para melhorar o MTTR. Mesmo que sua empresa ainda não tenha adotado outros aspectos do DevOps, vale a pena considerar o compartilhamento como uma iniciativa de alta prioridade. Seja por meio do ChatOps ou por e-mail, aplicativo móvel ou uma página wiki atualizada dinamicamente, é fundamental que as informações obtidas por meio do monitoramento sejam amplamente compartilhadas em toda a organização.
Uma falha em um switch ou servidor pode parecer inofensiva, mas, se não for corrigida, pode acabar derrubando metade dos serviços dos quais um aplicativo crítico depende. No estudo State of the Network de 2017, realizado pela Viavi, 65% dos administradores de redes e sistemas apontam que “determinar se o problema é causado pela rede, pelo sistema ou pelos aplicativos” é seu principal desafio ao solucionar problemas em aplicativos. Maior visibilidade e monitoramento de toda a infraestrutura são uma forma de enfrentar esse desafio, garantindo que os responsáveis por identificar a causa raiz tenham à disposição o máximo possível de informações sobre o status e a integridade de todos os componentes no caminho dos dados.
A visibilidade é fundamental para o futuro da TI. Sem ela, não podemos alcançar o nível de automação necessário para corrigir interrupções antes que elas ocorram. Sem visibilidade, não podemos reduzir o MTTR de forma significativa. Sem ela, realmente não podemos manter o crescimento dos negócios em um ritmo sustentável.
A visibilidade, assim como a segurança, deve ser uma prioridade na estratégia que impulsiona a TI. Afinal, interrupções acontecem, e é a visibilidade que permite às organizações se recuperarem com rapidez e eficiência, minimizando ao máximo os danos à marca e aos resultados financeiros.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...