
Este é o segundo artigo de uma série que aborda diversos aspectos do que foi necessário para desenvolvermos e operarmos nosso serviço SaaS :
- Plano de controle para PaaS Kubernetes distribuída
- Malha de serviços global para aplicações distribuídas
- Segurança de plataforma para infraestrutura, aplicativos e dados distribuídos
- Segurança de aplicações e redes de clusters distribuídos
- Observabilidade em uma plataforma distribuída globalmente
- Operações e SRE de uma plataforma distribuída globalmente
- Framework de serviços em Golang para microsserviços distribuídos
Em um artigo anterior do blog, apresentamos um pouco do contexto sobre as necessidades que nos levaram a criar uma nova plataforma. Com essa plataforma, permitimos que nossos clientes desenvolvam um conjunto complexo e diversificado de aplicações — como manufatura inteligente, análise forense de vídeo para segurança pública, negociação algorítmica e redes 5G de telecomunicações.
O primeiro artigo desta série abordou um plano de controle distribuído para disponibilizar vários clusters de aplicações baseados em Kubernetes e multilocatários na nuvem pública, em nossos PoPs de rede privada e em locais de borda.
Este blog abordará os desafios de conectar e proteger esses clusters de aplicações distribuídos sob três perspectivas: de aplicação para aplicação, de usuário/máquina para aplicação e de aplicação para a internet pública. Apresentaremos um datapath L3-L7+ totalmente novo e integrado, um plano de controle distribuído globalmente e nossa rede global de alto desempenho. Esses três elementos se combinam para oferecer um conjunto abrangente de serviços de rede e segurança na borda, em qualquer VPC de nuvem ou nos PoPs da nossa rede global. Após mais de um ano em produção com mais de 35 clientes, começamos a ampliar a implantação e consideramos que este é um bom momento para compartilhar nossa jornada.
TL;DR (Resumo)
- Fornecer conectividade de alto desempenho, confiável e segura para clusters de aplicações distribuídas exigiu que construíssemos uma nova rede global. Embora existam muitos provedores de serviços para conectar consumidores a aplicações e proteger essas conexões (Akamai, Cloudflare etc.), bem como para conectar funcionários a aplicações e proteger essas conexões (por exemplo, Zscaler, Netskope etc.), não há um provedor de serviços que atenda à necessidade de conectividade e segurança entre aplicações.
- Além de uma rede global para conectar aplicações distribuídas, esses clusters de aplicações exigem serviços de rede, confiabilidade e segurança — roteamento de APIs, balanceamento de carga, segurança e roteamento de rede — com um modelo operacional e de configuração consistente. Esses serviços precisam ser executados em várias localidades de provedores de nuvem, em localidades de borda com recursos limitados e/ou em nossa rede global.
- Para fornecer esses serviços de rede e segurança, decidimos criar um novo caminho de dados de rede L3-L7+ totalmente integrado, com configuração, políticas e observabilidade consistentes, independentemente de onde fosse executado — em nossa rede, em diversas nuvens públicas ou em locais de borda. Como muitos desses caminhos de dados podem ser implantados em vários locais, também foi necessário criar um plano de controle distribuído globalmente para orquestrá-los.
- A combinação de uma rede global, um novo caminho de dados de rede e um plano de controle distribuído nos proporcionou um “gateway de aplicações distribuído globalmente”, que oferece segurança de confiança zero, conectividade de aplicações e confiabilidade de clusters sem conceder acesso à rede em toda essa rede global — uma “malha de serviços global” que simplifica o trabalho da nossa equipe de segurança e conformidade.
Onde estão os cabos? Por que construímos uma rede global?
Como nossos clientes estão desenvolvendo aplicações bastante complexas e de missão crítica — como manufatura inteligente, análise forense de vídeos para segurança pública, negociação algorítmica e transição das operadoras de telecomunicações para o 5G —, precisamos oferecer uma experiência sempre disponível, conectada e confiável tanto para as aplicações quanto para seus usuários finais. Algumas dessas aplicações executam pipelines de dados entre clusters em uma nuvem, precisam fazer backup de dados entre provedores de nuvem, exigem o encaminhamento confiável de solicitações de uma base global de usuários para os back-ends das aplicações ou necessitam de conectividade de alto desempenho entre suas máquinas e os back-ends executados em nuvens centralizadas.
Para atender a essas necessidades, havia dois requisitos para a rede física:
R1 — Nuvem a Nuvem — Conectividade de alto desempenho e sob demanda para aplicações entre ambientes de nuvem pública ou privada em todo o mundo
R2 — Da Internet para a Nuvem — Para que dispositivos e máquinas em locais de borda se conectassem de forma confiável ao backend da aplicação, precisávamos disponibilizar vários caminhos redundantes e encerrar as conexões o mais próximo possível desses usuários, em vez de transportar o tráfego pela internet até os backends.
Poderíamos ter atendido aos requisitos R1 e R2 recorrendo a um provedor de serviços de rede como a AT&T, mas ele não teria conseguido nos oferecer uma experiência de rede integrada e uma integração perfeita com nossos serviços de aplicação — configuração baseada em API, telemetria por streaming, capacidade de adicionar facilmente nossos próprios prefixos de IP ou os de nossos clientes, serviços de rede baseados em API etc. Além disso, obter cobertura global por meio de provedores de serviços é muito difícil ou tem um custo proibitivo. Poderíamos ter contratado dois ou três provedores de serviços diferentes para resolver todos esses problemas, mas acabaríamos com uma confusão de sistemas distintos, que se comportam de maneiras diferentes e têm diferentes modos de falha, SLAs e sistemas de suporte, além de APIs diferentes (ou nenhuma API).
Então, acabamos precisando construir nossa própria rede, o que significava que ela precisava ter três propriedades:
- Atender ao R1 significava que precisávamos criar uma rede privada abrangendo vários provedores de nuvem e diferentes partes do mundo para conectar todas as regiões — e a melhor abordagem para isso é estabelecer peering com provedores de nuvem nas principais regiões de nuvem, além de usar uma combinação de links de conexão direta nas principais instalações de colocation. O peering não garante os melhores SLAs, enquanto os links de conexão direta oferecem garantias de SLA dentro de uma região de nuvem.
- Resolver o R2 para máquinas em locais de borda significava que precisávamos oferecer suporte a vários links ativo-ativo em cada local de borda, podendo ser links de internet de baixo custo (via rede celular ou cabo/fibra) e/ou links dedicados de custo mais alto (via fibra/Ethernet). Para garantir desempenho e confiabilidade, o tráfego precisa ter a carga balanceada e ser terminado o mais próximo possível do local de borda, em vez de ser transportado por uma conexão de internet não confiável. No jargão do setor, esse recurso também é chamado de SD-WAN.
- Atender ao R2 para usuários da internet e aplicações de borda significava que precisávamos realizar a terminação do tráfego TLS na borda, e isso também precisava acontecer o mais próximo possível do usuário. Para isso, precisávamos criar pontos de presença na borda da rede com ampla interconexão com operadoras de telefonia móvel e provedores de conteúdo, além de encaminhar o tráfego por meio de vários provedores de trânsito para garantir o roteamento mais eficiente possível.
Para atender a essas três propriedades, precisamos fazer muitas coisas. No entanto, destacaremos cinco grandes categorias:
- PoPs de rede globais com nossos equipamentos de rede — acabamos tendo que construir vários PoPs de rede nos principais mercados metropolitanos. Nos primeiros dias de desenvolvimento da nossa plataforma, começamos por várias cidades europeias — Paris, Londres, Amsterdã e Luxemburgo — e por um PoP nos EUA, em Nova York. Depois, expandimos para Seattle, San Jose, Ashburn, Frankfurt, Singapura e Tóquio, o que nos proporcionou cobertura global e proximidade com todos os principais provedores de nuvem. Escolhemos a Equinix como nossa parceira global e complementamos sua infraestrutura com a Interxion, a Telehouse/KDDI e a Westin nos locais em que a Equinix não era a opção ideal. Como acreditamos em automação, optamos pela Juniper Networks para os equipamentos de comutação e roteamento e pela Adva para a interconectividade metropolitana por fibra com links de 400G e 100G.
- Backbone privado — Para conectar todos esses PoPs com alto desempenho e confiabilidade, decidimos não criar uma rede de sobreposição sobre vários provedores de trânsito. Em vez disso, optamos por construir um backbone privado global usando uma combinação de vários circuitos de 100G de provedores como Zayo, Centurylink, EuNetworks etc. Embora muitos provedores de CDN (por exemplo, Cloudflare e Fastly) e de segurança (por exemplo, Zscaler) dependam exclusivamente de conexões de trânsito e peering por atenderem ao tráfego de saída, acreditamos que há bons motivos para usar uma combinação de backbone privado e trânsito, pois lidamos com tráfego leste-oeste entre aplicações. Isso não é exclusividade nossa — todos os principais provedores de nuvem têm um backbone privado global que conecta suas regiões de nuvem.
- Provedores de peering e trânsito de Internet — Para aumentar a diversidade e obter o melhor desempenho ao acessar usuários e provedores de conteúdo ou SaaS, a solução ideal é estabelecer peering diretamente com o maior número possível de operadoras e provedores de conteúdo. Estabelecemos peering em vários pontos de troca de tráfego, conforme indicado no PeeringDB (ASN-35280 no PeeringDB). Nem todo o tráfego pode ser atendido pelas conexões de peering, e é aí que entram as conexões de trânsito. Os links de trânsito e as portas de peering precisam ser monitorados com muito cuidado para manter a qualidade — acabamos selecionando os melhores provedores Tier 1, como NTT, CenturyLink e Telia, para nos atender em vários locais ao redor do mundo.
- Peering e interconexões com provedores de nuvem — Recentemente, começamos a estabelecer peering diretamente com provedores de nuvem, mas eles não garantem nenhum SLA para essas conexões. Por exemplo, em nossa conexão de peering em Seattle (instalação Westin), conseguimos acessar diretamente os três principais provedores de nuvem. Embora essas conexões sejam melhores do que simplesmente usar provedores de trânsito, começamos a complementar nossa rede com conexões diretas a esses provedores de nuvem (chamadas AWS Direct Connect, Azure Express Route e GCP Dedicated Interconnect), pois elas incluem SLAs e recursos adicionais. Embora esses links sejam caros e permitam acesso apenas a sub-redes VPC/VNET internas, eles oferecem a melhor conectividade.
- Gateways de software — Em locais de nuvem ou de borda que não estão diretamente conectados aos nossos PoPs, instalamos nossos gateways de software. Abordaremos as funcionalidades avançadas oferecidas por esses gateways em uma seção posterior deste blog, mas uma das funcionalidades relacionadas à camada de transporte é a criação automática de túneis VPN seguros (IPsec ou SSL) para vários PoPs de rede, proporcionando redundância e balanceando o tráfego entre eles. Além disso, em uma implantação na nuvem, esses gateways estabelecem uma conexão de saída com o nosso PoP mais próximo por meio dos gateways NAT dos provedores de nuvem, servindo como ponto de acesso à nossa rede privada global — sem a necessidade de trafegar por redes públicas e/ou conectar clusters de aplicações entre diferentes locais de nuvem usando endereços IP públicos.
Percebemos logo no início do nosso desenvolvimento que criar e operar uma rede global exige tempo e competências específicas, e que precisávamos incorporar essa expertise. Após meses de conversas com os fundadores da Acorus Networks (uma empresa de segurança sediada em Paris, França), acabamos integrando a Acorus à Volterra. Isso nos ajudou a resolver o desafio da nossa infraestrutura global e da implantação da rede. A Acorus havia criado do zero uma excelente rede e uma equipe de operações que automatizou totalmente a configuração da rede física usando o Ansible, além de desenvolver APIs externas de telemetria e configuração que podiam ser utilizadas pela nossa equipe de software.
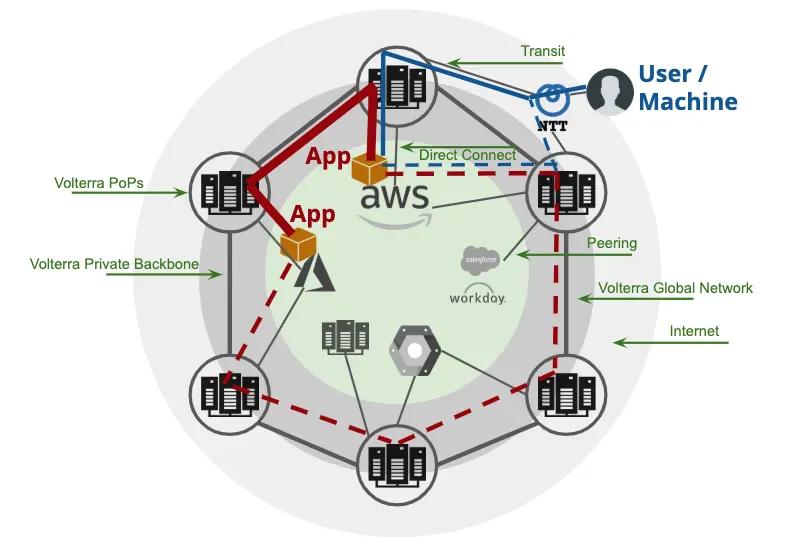
Agora que tínhamos uma equipe dedicada à implementação de uma rede privada global com alta confiabilidade e desempenho, podíamos resolver facilmente os desafios do tráfego entre aplicações e entre usuários/máquinas e aplicações em ambientes de borda ou de nuvem, conforme mostrado na Figura 1. Além disso, a infraestrutura de computação e armazenamento em nossos PoPs de rede também nos permitiu adicionar à nossa rede terminação de APIs, segurança de aplicações e transferência de cargas de trabalho (da borda ou da nuvem). Isso nos permitirá continuar aprimorando nossos recursos por muito tempo e expandir facilmente a abrangência da nossa rede e o catálogo de serviços de acordo com a demanda.
Serviços de rede para aplicações — multinuvem, nuvem privada ou edge?
Depois que estabelecemos uma rede global funcional, precisamos começar a adicionar clusters de aplicações e nossas cargas de trabalho. Essas cargas de trabalho precisam de seu próprio conjunto de serviços de conectividade e segurança no nível da aplicação.
Como explicamos em nosso blog anterior, nosso objetivo com a plataforma era aumentar a produtividade e reduzir a complexidade para as equipes que gerenciam cargas de trabalho executadas em vários ambientes (nuvem, edge e nossos PoPs de rede).
Todo provedor de nuvem exige a configuração, o gerenciamento e o monitoramento de diversos recursos de nuvem para garantir a conectividade segura com clusters de aplicações. Por exemplo, no Google Cloud, para configurar um serviço de rede de ponta a ponta para um cluster de aplicações, precisamos gerenciar diversos conjuntos de serviços:
Serviços de rede de longa distância (WAN)
Serviços de rede de aplicações
- Balanceadores de carga de aplicações, Balanceadores de carga de rede (APIs públicas)
- Balanceadores de carga de aplicações, Balanceadores de carga de rede (Interno)
- Malha de serviços (Aplicativo para aplicativo)
Serviços de roteamento e isolamento de rede
- Rede de nuvem privada virtual (rede VPC)
- Sub-redes, Intervalos de IP, Rotas
- Gateways NAT, Regras de firewall
Ótimo, embora fosse um grande desafio, poderíamos ter decidido enfrentá-lo criando uma camada de configuração e operações para uniformizar o funcionamento entre os diferentes provedores de nuvem. No entanto, sabíamos que isso não resolveria nossos problemas, pois os serviços dos provedores de nuvem não atendiam a todas as nossas necessidades (por exemplo, os CSPs não oferecem recursos de segurança para aplicações e APIs), não são os melhores do mercado e estão em constante mudança.
Além disso, e quanto aos nossos PoPs de rede e sites de borda? Teríamos que obter recursos semelhantes de fornecedores de hardware ou software e integrar tudo — por exemplo, Cisco/Juniper para roteamento+NAT+VPN, F5 para balanceamento de carga e firewall etc. Nos locais de borda, o problema é ainda maior, pois nem os provedores de nuvem nem os grandes fornecedores de soluções de rede conseguiam resolver os problemas de serviços de rede em um ambiente com recursos limitados. Outra possível opção para a borda seria transferir toda a conectividade de aplicações, a segurança e os serviços de rede para a nossa rede global — mas estava claro que isso não funcionaria, pois o tráfego entre aplicações dentro do mesmo site de borda também precisava de alguns desses serviços.
Depois de muitas discussões e de analisar o cenário, percebemos que integrar diversos provedores de serviços e fornecedores — incluindo configuração, telemetria, monitoramento e alertas — e acompanhar as mudanças em seus roadmaps e APIs ia contra nosso objetivo de simplicidade e agilidade.
Outro problema que precisávamos resolver em toda a plataforma era a multilocação — isso era mais fácil de implementar para serviços de WAN e roteamento de rede, mas era um desafio para os serviços de rede de aplicações, já que a maioria dos balanceadores de carga disponíveis no mercado oferece suporte muito limitado ou nenhum suporte à multilocação.
Um novo caminho de dados de rede L3-L7+
Como resultado, decidimos enfrentar esse desafio e criar um caminho de dados de rede de alto desempenho que oferecesse não apenas serviços de roteamento de rede, mas também serviços de aplicações, segurança e redes de longa distância. Isso nos permitiria unificar o portfólio de serviços em nosso ambiente de nuvem híbrida e distribuída, além de reduzir nossa dependência de serviços nativos nas nuvens públicas ao mínimo necessário.
Como a equipe tinha uma boa experiência em redes e já havíamos lidado com problemas semelhantes anteriormente na Contrail/Juniper, concluímos que a melhor maneira de resolver esse problema seria começar do zero e criar uma solução de rede totalmente nova, que integrasse serviços de L3 a L7+ em um único caminho de dados, capaz de operar em qualquer nuvem ou ambiente de borda e ser gerenciado de forma centralizada por nossa plataforma.
Escolhemos os melhores projetos para iniciar o desenvolvimento desse novo datapath — o OpenContrail vRouter (para L3-L4), no qual já havíamos trabalhado por seis anos, e o Envoy para L7, por contar com um enorme apoio da comunidade. Dito isso, tivemos que fazer diversas alterações e adições para criar um novo datapath unificado de L3 a L7+ — multilocação para o Envoy, dpdk para o Envoy, pilha TCP dpdk no espaço do usuário, políticas de rede, VPNs SSL/IPSec, http connect, proxy reverso dinâmico, proxy de encaminhamento transparente, gateway de API, políticas de aplicação programáveis, ACLs rápidas para proteção contra DDoS, integração de identidade com PKI, mecanismo Chrome v8, segurança de aplicações e redes etc.
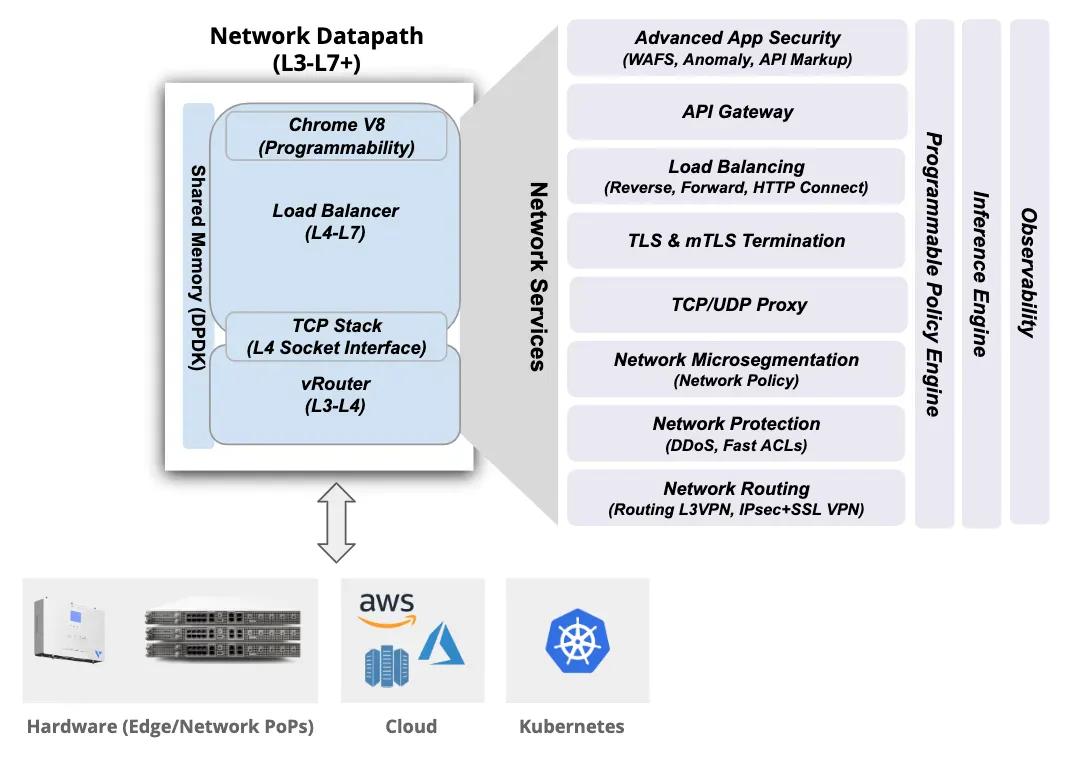
Esse caminho de dados (conforme mostrado na Figura 2) é implantado como gateway de entrada/saída para nossos clusters de aplicações, como gateway de software na borda, para fornecer recursos de malha de serviços dentro de um cluster ou entre vários clusters, ou para disponibilizar serviços de rede a partir de nossos PoPs globais.
Para atender à nossa necessidade de multilocação na plataforma (abordada no blog anterior), também precisávamos implementar multilocação completa nesse caminho de dados de rede. Isso foi relativamente simples para a camada de roteamento, pois o vRouter já oferecia suporte a VRFs, mas tivemos que fazer alterações no Envoy para torná-lo multilocatário. Como não estávamos usando a pilha TCP do kernel, alteramos a interface de soquete TCP do Envoy e adicionamos reconhecimento de VRF.
Esse caminho de dados também precisava garantir a segurança de APIs, de firewalls de aplicações e da rede — para isso, usamos uma combinação de técnicas algorítmicas e inferência de máquina, e abordaremos esse tema em uma próxima publicação no blog.
Obtivemos muitas vantagens ao criar esse caminho de dados de rede:
Recursos completos de L3 a L7+, com configuração, controle e observabilidade uniformes
O suporte à expansão horizontal em um único cluster nos permite atender desde dispositivos de borda compactos e de menor desempenho até capacidades de 100 Gbps ou mais em nossa rede ou em ambientes de nuvem pública
Adicione rapidamente novos recursos ao caminho de dados da rede sem depender de nenhum fornecedor de rede e/ou provedor de nuvem
Uma solução comum, com características semelhantes de falha e desempenho em qualquer ambiente — algo muito importante para nossas equipes de operações.
Agora que podíamos implantar vários clusters de aplicações com esse novo caminho de dados de rede, era fundamental criar um plano de controle distribuído globalmente para configurá-los, controlá-los e monitorá-los.
Plano de controle desenvolvido especificamente para redes distribuídas
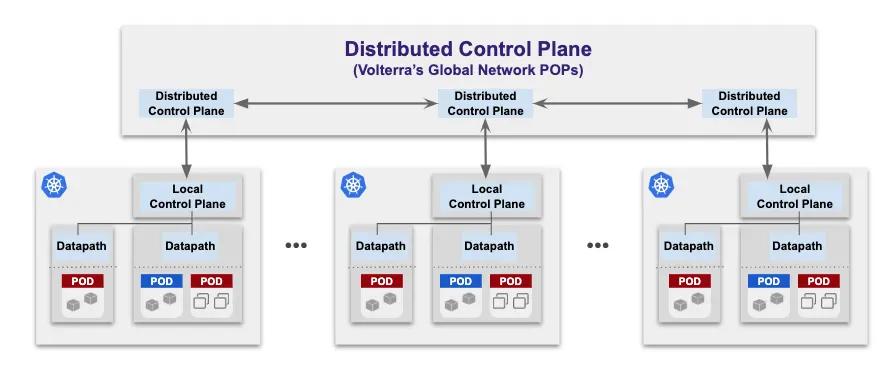
Há vários desafios que nossa equipe de plataforma precisou enfrentar ao criar um plano de controle distribuído para gerenciar um grande número de nós distribuídos de processamento do plano de dados. Como desenvolvemos um novo plano de dados, não havia um plano de controle pronto para uso que pudéssemos aproveitar, então tivemos que criar o nosso próprio: um Plano de Controle Local para gerenciar várias instâncias do plano de dados em um único cluster (nuvem, borda ou PoP de rede). Esses nós do plano de dados precisavam de um plano de controle local para gerenciar alterações de configuração e atualizações de rotas, realizar verificações de integridade e descoberta de serviços, estabelecer pareamento com outros dispositivos de rede usando um protocolo como o BGP, agregar métricas e logs de acesso etc. Plano de Controle Distribuído para gerenciar vários planos de controle locais — Há um plano de controle distribuído em execução em nossos PoPs de rede globais (Figura 3), responsável pelo gerenciamento da configuração dos planos de controle locais, pela distribuição do estado operacional entre cada um deles e pela coleta de dados de cada nó. Para distribuir o estado operacional, decidimos usar o BGP, pois ele oferece consistência eventual e é robusto. Como havíamos desenvolvido uma implementação de BGP multithread e altamente escalável como parte do OpenContrail, nós a aproveitamos e adicionamos extensões para balanceamento de carga — distribuição de verificações de integridade, endpoints http/api, propagação de políticas etc.
Além disso, há um plano de gerenciamento centralizado em execução em duas regiões de nuvem — AWS e Azure — que é usado em conjunto com o plano de controle distribuído para oferecer multilocação, conforme mostrado na Figura 4. Nossa equipe de SRE pode criar vários locatários, e cada um deles fica completamente isolado dos demais em toda a nossa rede global. Eles só podem rotear tráfego entre si usando a “rede pública”. Dentro de um locatário, os serviços em diferentes namespaces podem se comunicar entre si com base em regras de roteamento e segurança de HTTP/API/rede.
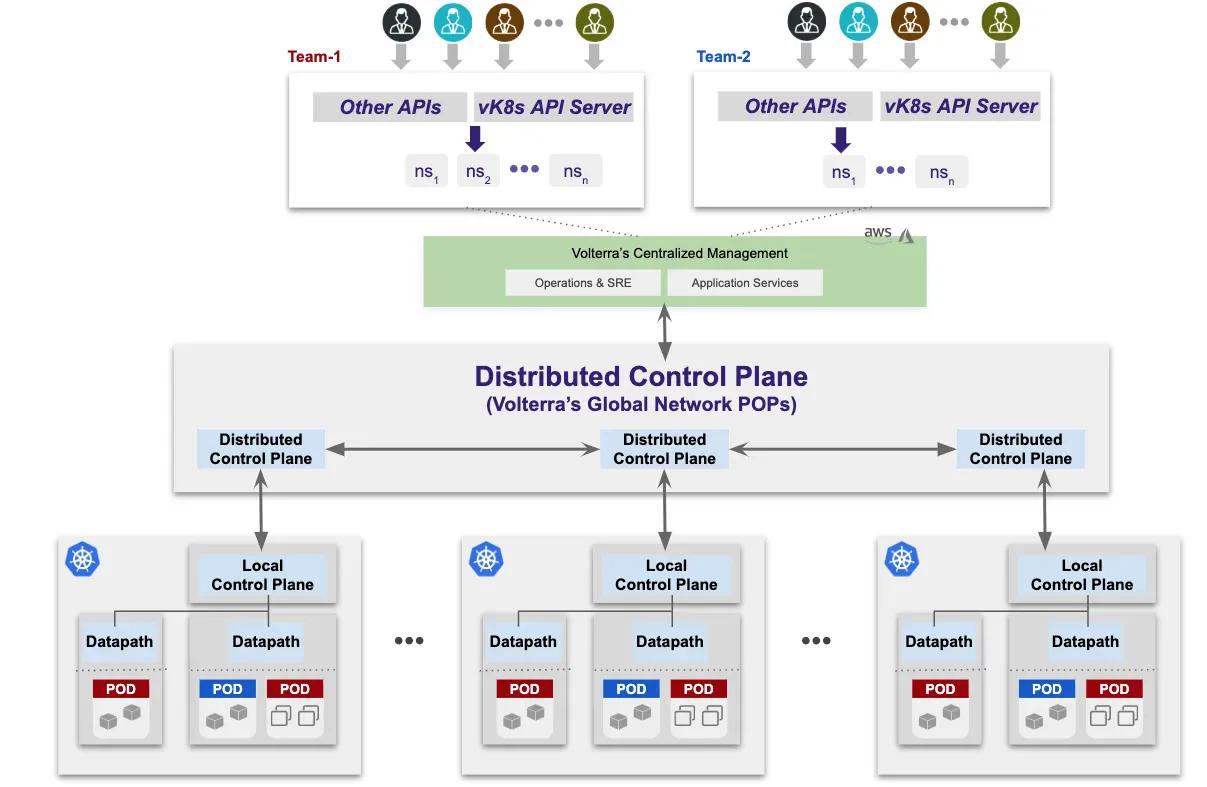
Os planos de controle são executados como cargas de trabalho do Kubernetes em um tenant separado e em um namespace isolado, controlado exclusivamente por nossas equipes de SRE. Dessa forma, nenhum desenvolvedor e/ou cliente pode interromper esse serviço. Além disso, como o plano de controle é distribuído, a indisponibilidade de um plano de controle em um local não afeta o serviço como um todo.
Gateway de Aplicações Distribuído Globalmente?
Depois que identificamos as necessidades da nossa rede global e definimos os requisitos dos serviços de rede L3-L7+ para clusters de aplicações (um novo caminho de dados e um plano de controle distribuído), nossa equipe de produto apresentou mais requisitos que tornaram nosso trabalho ainda mais empolgante. Basicamente, eles queriam que entregássemos uma malha de serviços global entre clusters com os seguintes recursos:
- Fornecer conectividade entre aplicações (roteamento, controle e observabilidade) em toda a rede global, mas não conectividade entre redes (pelo menos não por padrão) — O motivo era simples: conectar redes cria todo tipo de vulnerabilidade de segurança, que só pode ser solucionada com a criação de regras complexas de firewall, o que dificulta o gerenciamento de mudanças.
- Aprimorar os balanceadores de carga de borda nos PoPs da rede com informações sobre a integridade e a confiabilidade dos endpoints — Atualmente, nos balanceadores de carga de borda (por exemplo, AWS Global Accelerator ou Akamai Global Load Balancer), a decisão de roteamento do ponto de presença de borda para o backend se baseia na integridade do servidor de origem (na maioria dos casos, o servidor de origem é apenas mais um balanceador de carga, e não o endpoint que efetivamente atende às solicitações). Nossa equipe queria que cada um dos nossos balanceadores de carga de borda pudesse gerenciar o tráfego com base na integridade de todos os endpoints em todos os clusters, e não apenas na integridade dos balanceadores de carga de origem.
- Aprimorar a seleção do site de borda (PoP de rede) como parte da tomada de decisão do GSLB — Atualmente, o anycast ou o GSLB encaminha o usuário/cliente ao site de borda mais próximo para o tráfego de entrada. No entanto, por diversos motivos (carga no backbone e/ou nos provedores de trânsito), pode ser melhor encaminhar o usuário a outro site de borda de entrada.
Com os requisitos 2 e 3, o objetivo era melhorar o tempo de resposta e o desempenho da conectividade entre cliente e servidor, o que é realmente crítico na comunicação entre aplicações ou em aplicações SaaS de grande escala. Para atender aos requisitos 2 e 3, ficou claro que a melhor abordagem seria criar um proxy distribuído (Figura 5) — um proxy de entrada e um proxy de saída — e realizar o roteamento com base no endereçamento da aplicação, e não no endereçamento da rede. Além disso, decidimos distribuir o status de integridade dos endpoints de serviço (ou servidores) aproveitando o plano de controle distribuído e as extensões de BGP (conforme descrito anteriormente). Essa implementação do proxy distribuído é mostrada no diagrama abaixo.
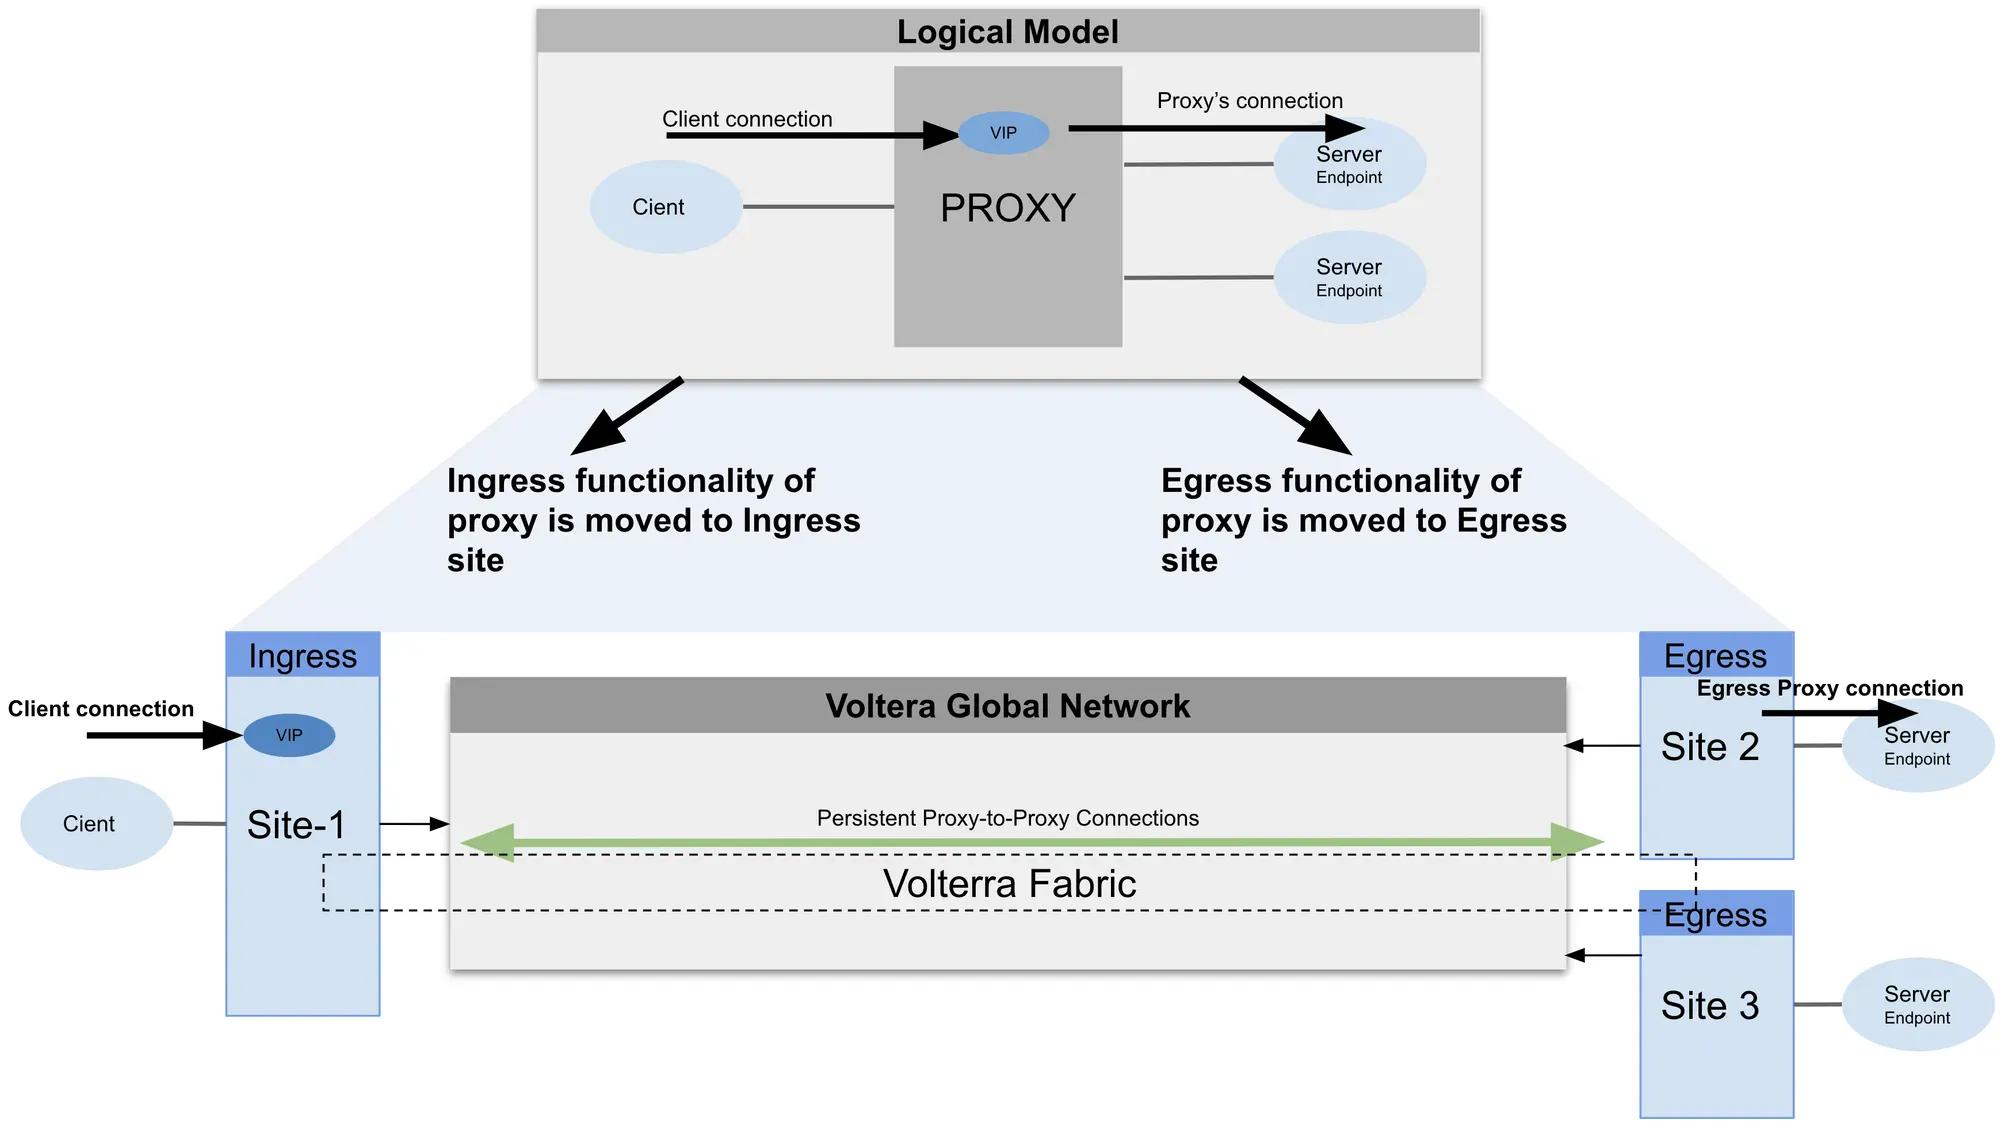
Como ele se tornou um proxy distribuído com uma pilha de rede L3-L7+ completa, nós o chamamos de gateway de aplicações distribuído globalmente. Todas as funcionalidades disponíveis em nosso caminho de dados de rede agora estão disponíveis em toda a nossa rede global — por exemplo, balanceamento de carga e roteamento com base em HTTP ou APIs, aplicação de políticas na borda, transformação de APIs, terminação TLS mais próxima do usuário etc.
Benefícios proporcionados pelo Gateway de Aplicações Distribuído
A equipe conseguiu obter diversos benefícios com a implementação de um gateway de aplicações distribuído globalmente. Esses benefícios abrangeram melhorias operacionais, segurança, desempenho e custo total de propriedade (TCO):
- Segurança e conformidade — A capacidade de fornecer acesso a aplicações entre sites sem acesso à rede melhorou significativamente a segurança e a conformidade dos clusters de aplicações em locais de borda ou na nuvem. Isso também reduziu a necessidade de um gerenciamento complexo das configurações de firewall, pois não há acesso à rede entre os sites, e os clusters de aplicações podem ser conectados, mas permanecer totalmente protegidos por NAT em cada site.
- Sobrecarga operacional — Um conjunto comum de serviços de rede em nossos PoPs de rede e sites de borda/nuvem eliminou a necessidade de nossas equipes de SRE ou DevOps integrarem a configuração e a observabilidade entre diferentes conjuntos de serviços.
- Melhorias de desempenho e confiabilidade — Como roteamos o tráfego do nosso PoP de rede para o endpoint ideal e íntegro, e não para o balanceador de carga ideal, a plataforma consegue oferecer um desempenho muito superior para o tráfego entre aplicações ou entre usuários e aplicações em comparação com qualquer outra solução do mercado.
- Ganhos de TCO — Em aplicações SaaS de grande escala, é comum haver centenas de réplicas do serviço sendo disponibilizadas a partir de vários data centers ao redor do mundo. Para fazer isso de forma eficaz, o provedor de SaaS precisa desenvolver recursos complexos, que agora estão disponíveis para todos os nossos clientes por meio deste gateway de aplicações distribuído.
Continua…
Esta série de posts abordará diversos aspectos do que foi necessário para criarmos e operarmos nosso serviço SaaS distribuído globalmente, com vários clusters de aplicações na nuvem pública, nossos PoPs de rede privada e sites de borda. O próximo tema é Segurança da plataforma e dos dados…
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...