Será que a automação de redes precisa mesmo ser tudo ou nada?
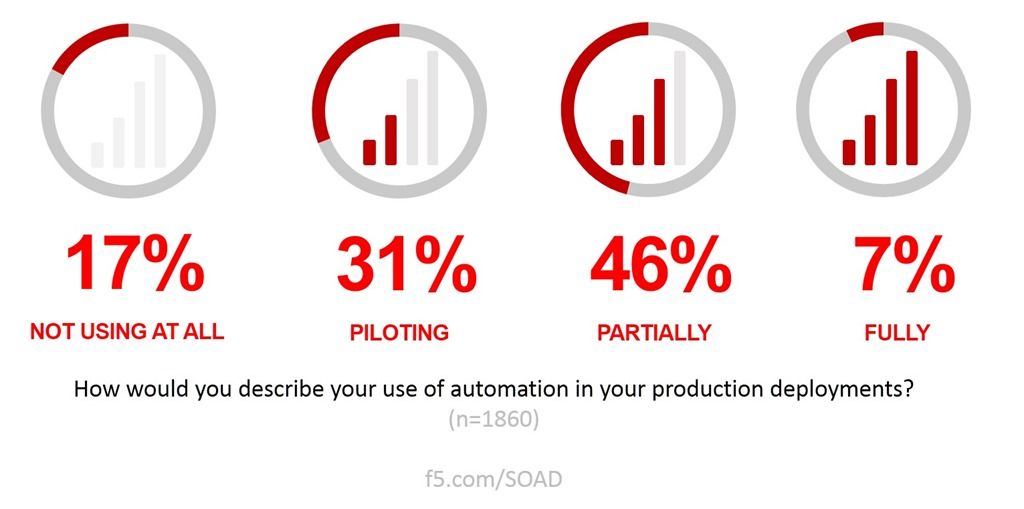
A automação de rede — a prática de aplicar DevOps ao pipeline de produção — já é utilizada por uma parcela significativa das organizações. Embora pouquíssimas a tenham adotado plenamente, a maioria (77%, de acordo com nosso relatório mais recente, Estado da Entrega de Aplicações) está realizando projetos-piloto ou usando parcialmente a automação em produção.
Um dos conceitos intimamente ligados ao DevOps — e, portanto, frequentemente associado ao NetOps — é a noção de produto mínimo viável (MVP).
Isso faz parte da metodologia Agile e é usado como uma forma de acelerar os ciclos de desenvolvimento e lançar soluções no mercado mais rapidamente. É algo de que precisamos desesperadamente na “rede”. Talvez você se lembre da pesquisa da Appian mencionada em um blog anterior que nos confrontou com dados indicando que 72% dos entrevistados não confiavam na capacidade da TI de se expandir para atender às necessidades da empresa.
Ai. Apesar do uso bastante amplo da automação em TI, os desenvolvedores e as partes interessadas da empresa ainda não confiam em nossa capacidade de fazer o trabalho acontecer.
Portanto, adotar ferramentas, tecnologias e metodologias de DevOps para acelerar as coisas (escalando de forma mais inteligente) não é uma ideia tão absurda assim. Mas, antes de descobrirmos como aplicar o MVP à rede, precisamos entender o que ele é. Para quem não conhece DevOps, Agile ou MVP, aqui está uma definição simples da Agile Alliance:
Um produto mínimo viável (MVP) é um conceito da metodologia Lean Startup que enfatiza o impacto do aprendizado no desenvolvimento de novos produtos. Eric Ries definiu um MVP como a versão de um novo produto que permite a uma equipe obter o máximo de aprendizado validado sobre os clientes com o mínimo de esforço. Esse aprendizado validado se traduz em descobrir se os clientes realmente comprarão o produto.
Uma premissa fundamental por trás da ideia de MVP é criar um produto real (que pode ser apenas uma landing page ou um serviço aparentemente automatizado, mas que, nos bastidores, é totalmente manual) para oferecê-lo aos clientes e observar como eles realmente interagem com o produto ou serviço. Observar o que as pessoas de fato fazem em relação a um produto é muito mais confiável do que perguntar o que elas fariam.
Uma equipe usa efetivamente o MVP como elemento central de uma estratégia de experimentação. Ela parte da hipótese de que seus clientes têm uma necessidade e de que o produto no qual está trabalhando atende a essa necessidade. Em seguida, a equipe entrega algo a esses clientes para descobrir se eles realmente usarão o produto para atender a essas necessidades. Com base nas informações obtidas nesse experimento, a equipe dá continuidade ao trabalho no produto, faz alterações ou o cancela.
É neste ponto deste tratado que observo que muitos dos conceitos associados ao DevOps (e às tecnologias e metodologias relacionadas) nem sempre se aplicam bem a uma iniciativa de NetOps. Experimentação não é um termo que engenheiros, arquitetos ou executivos de TI usam ao discutir alterações na rede.
É o raio de impacto, entende? Ele é amplo e tem grande influência. A maioria das organizações não tem muita tolerância a riscos operacionais, e com razão. As interrupções custam dinheiro de verdade — e, às vezes, empregos. A rede não é exatamente um bom lugar para experimentação.
Mas isso não significa que não exista uma implantação mínima viável (MVD) para NetOps.
Definindo uma MVD para NetOps
Atualmente, o pipeline de produção é composto tanto por recursos compartilhados, como switches, roteadores, DNS e roteamento multinuvem (GSLB), quanto por serviços específicos de cada aplicação, como balanceadores de carga, WAF e controle de acesso a aplicações.
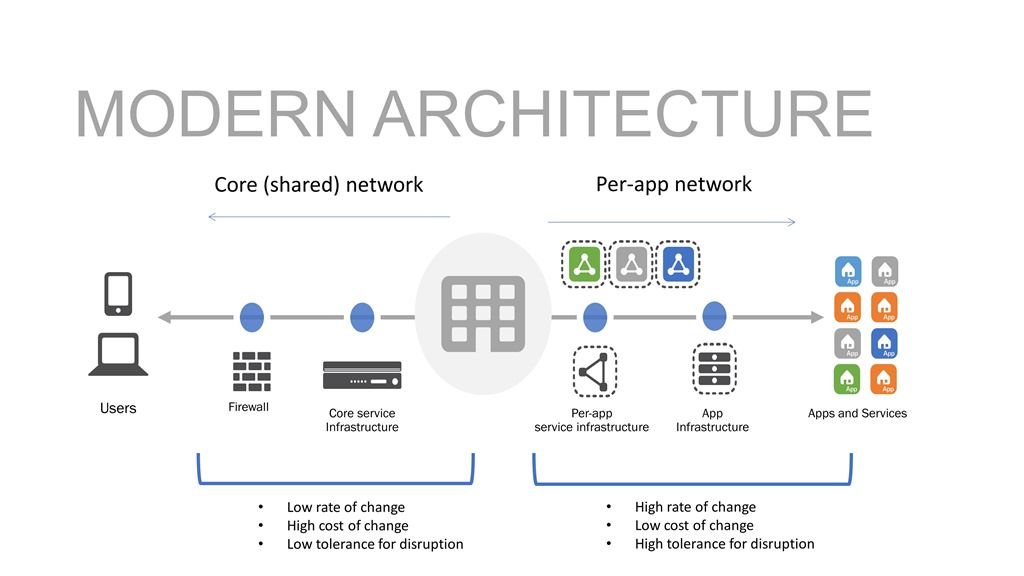
Curiosamente, se analisarmos a taxa de mudança associada aos recursos compartilhados, veremos que ela é relativamente baixa. Ou seja, esses recursos apresentam uma baixa taxa de mudança. Isso é positivo, pois eles também têm baixa tolerância a interrupções. Já nos recursos específicos de cada aplicativo, encontramos uma taxa de mudança mais alta e uma maior tolerância a interrupções.
Afinal, esse é um dos benefícios de uma arquitetura por aplicativo: o isolamento do caminho de dados, que protege outros aplicativos contra interrupções quando algo dá errado.
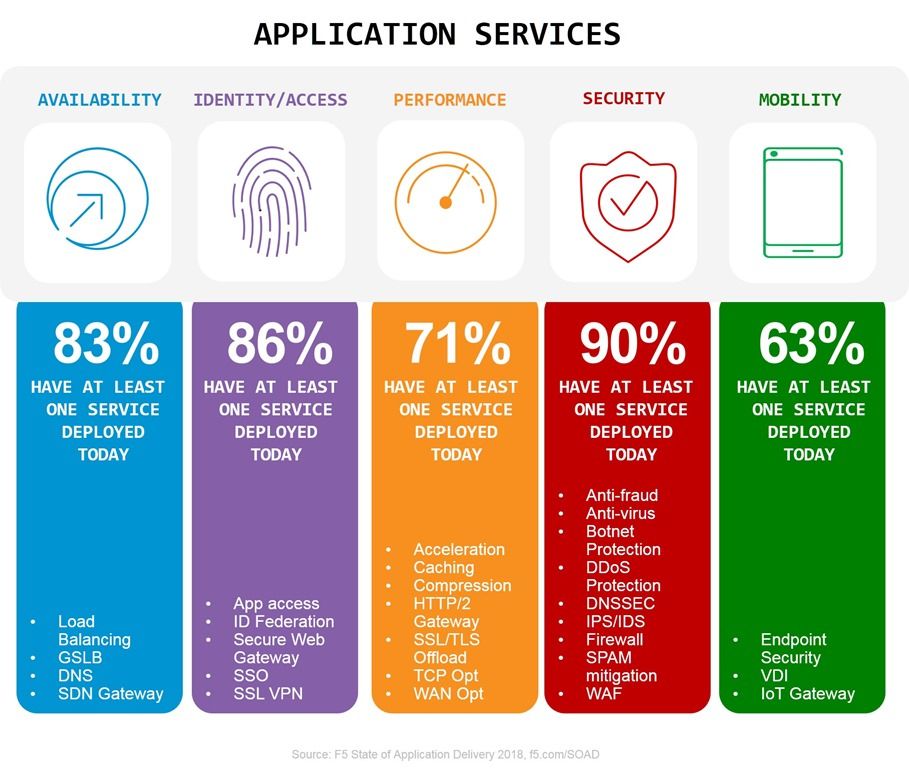
Ao longo desse caminho de dados, há, em média, dezesseis serviços de aplicação diferentes que, segundo nossa pesquisa, as organizações usam para disponibilizar e proteger suas aplicações. Alguns deles — como um firewall de rede e o DNS — são recursos compartilhados. Outros não são, ou pelo menos não precisam ser. Hoje, eles podem estar implantados em uma plataforma compartilhada, mas poderiam ser integrados ao próprio caminho de dados se houvesse um bom motivo para isso.
E é claro que é isso que vou apresentar a você.
O bom motivo é que você pode desenvolver efetivamente um MVD para um aplicativo se adotar uma arquitetura por aplicativo para os serviços de aplicação que, desde o início, estão fortemente acoplados ao aplicativo.
Como nos diz a definição de MVP, o “produto” (no nosso caso, a implantação de um aplicativo) não precisa ser totalmente automatizado. Se partirmos da premissa de que os recursos de maior risco e menos tolerantes devem continuar sendo configurados (e verificados) manualmente, ainda assim avançaremos. Firewalls e serviços essenciais, como DNS, têm uma taxa de mudança muito baixa, portanto podemos presumir que os métodos manuais não afetarão significativamente o cronograma de implantação. Isso é ainda mais verdadeiro se automatizarmos a maior parte dos serviços de aplicação específicos de cada aplicativo, pois assim liberamos tempo para que operadores e engenheiros façam as alterações manuais, se necessário.
Supondo que a proporção entre serviços essenciais (compartilhados) e serviços de aplicação específicos de cada aplicativo seja de aproximadamente um para três*, isso significa que uma organização típica tem pelo menos quatro recursos compartilhados para gerenciar manualmente e doze recursos específicos de cada aplicativo para automatizar.
Ao analisar a extensa lista de serviços de aplicações (atualmente, estamos monitorando trinta serviços distintos) observamos que alguns deles são necessários para disponibilizar ou proteger uma aplicação (DDoS, WAF, balanceamento de carga para escalabilidade, acesso à aplicação), enquanto outros são mais, digamos, aprimoramentos. Entre eles estão serviços de aplicações como opções de aceleração para melhorar o desempenho ou logon único (SSO) para aumentar a produtividade.
Portanto, se considerássemos a implementação de um MVD, poderíamos adotar uma abordagem ágil e nos concentrar nos serviços de aplicação essenciais para a entrega e a segurança desde o primeiro dia. Isso não significa que estamos ignorando as melhorias, mas apenas que, inicialmente, vamos nos concentrar nos serviços essenciais e automatizá-los primeiro. Ainda podemos gerenciar manualmente os serviços que aumentam a produtividade ou o desempenho, mas, para um MVD, queremos priorizar aqueles que afetam os lucros.
Uma abordagem de MVD para a rede ágil
Abordar a automação com o objetivo de definir e entregar um MVD significa avançar mais rapidamente (com mais agilidade) e nos dá a oportunidade de aprimorar e expandir a automação a cada sprint (medido em semanas, não em trimestres), até chegarmos a um produto sólido e sustentável (implantação automatizada).
Adotar uma estratégia de automação baseada em MVD exige comprometimento não apenas com uma arquitetura, mas também com uma abordagem e uma postura voltadas para as aplicações. Isso porque esse tipo de abordagem requer a compreensão da aplicação e de suas necessidades, tanto do ponto de vista operacional quanto do ponto de vista dos negócios. O MVD de uma aplicação pode não ser igual ao de outra. Esse é um dos motivos pelos quais a arquitetura por aplicação é um componente tão essencial na transição de uma rede fixa e manual para um pipeline ágil (automatizado).
Então, existe uma implantação mínima viável para NetOps. Isso significa que você pode adotar uma abordagem ágil para a automação de redes — que será infinitamente mais rápida (e segura) se, como parte de suas iniciativas de redes ágeis, você migrar para uma arquitetura por aplicativo.
Automatize (quase) tudo na rede.
*isso é totalmente um palpite baseado na lista, na minha experiência e na minha (forte) opinião. Sua experiência e sua definição podem variar.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...