Há apenas alguns anos, os microsserviços eram uma curiosidade discutida por desenvolvedores com certo entusiasmo eufórico diante das possibilidades e oportunidades oferecidas por essa arquitetura de aplicativos ainda incipiente.
Hoje, até nós, profissionais de redes, estamos falando sobre eles, porque praticamente se tornaram — como declara a pesquisa mais recente da Lightstep — padrão nas empresas. É sério. Em nosso relatório de 2018, State of Application Delivery , até mesmo os profissionais de funções relacionadas a redes indicaram que gostariam que os serviços de aplicações fossem disponibilizados em contêineres. Portanto, não é de surpreender que a pesquisa da Lightstep mencionada anteriormente tenha constatado que não apenas 91% dos entrevistados usam ou planejam usar microsserviços, mas também que 86% esperam que eles se tornem o padrão dentro de cinco anos.
Isso não quer dizer que não existam desafios. Na verdade, 99% dos participantes da pesquisa da Lightstep relataram enfrentar desafios ao usar microsserviços. Com base nas respostas, é razoável afirmar que praticamente tudo é mais difícil (e, às vezes, mais caro) com microsserviços.
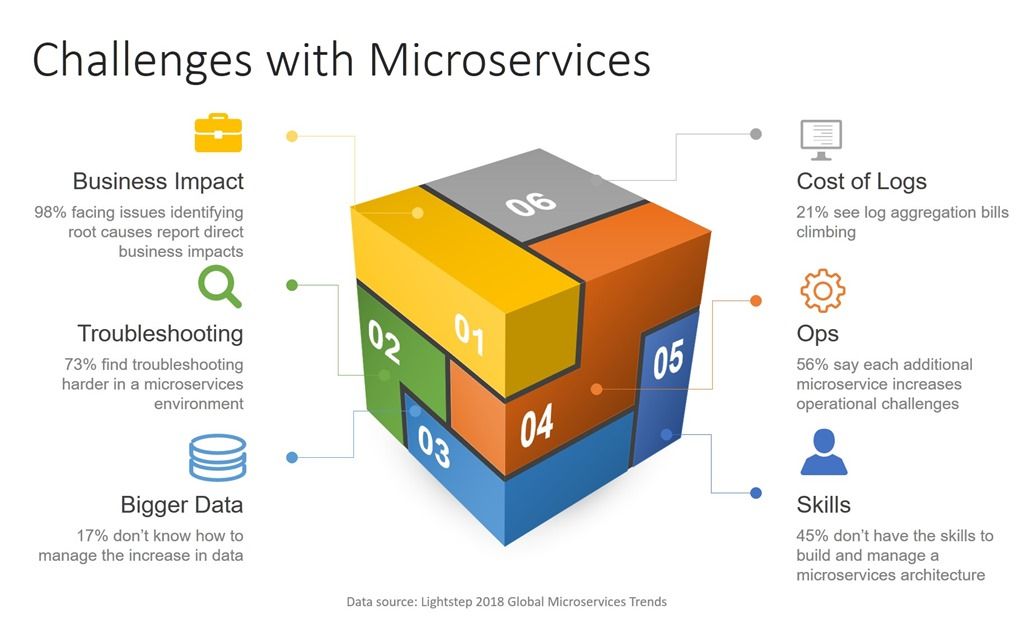
A pesquisa apontou desafios tanto comerciais quanto operacionais, que vão desde o aumento do custo da agregação de logs (21%) e a falta de clareza sobre o que fazer com o crescimento do volume de dados (17%) até dificuldades na resolução de problemas (73%).
Mais preocupante, porém, foi a constatação de que “98% das pessoas que enfrentam dificuldades para identificar a causa raiz de problemas em ambientes de microsserviços relatam que isso tem um impacto direto nos negócios”.
Esse é um dos principais desafios mencionados também em outros contextos, geralmente com o uso dos termos “visibilidade” ou “observabilidade”, dependendo de você estar do lado de redes ou junto à equipe de DevOps.
Ambos descrevem essencialmente os mesmos recursos: a capacidade de visualizar o que está acontecendo à medida que as mensagens trafegam pela rede, do cliente para o serviço e de volta. No ambiente de contêineres, isso é particularmente desafiador devido à abrangência e à escala dos serviços envolvidos.
Com um aplicativo web tradicional de três camadas, você tem três conjuntos de logs e três sistemas para monitorar. Com uma arquitetura de microsserviços — provavelmente disponibilizada por meio de uma API que pode ser usada tanto por clientes web quanto móveis —, talvez seja necessário monitorar dezenas ou centenas de serviços diferentes.
O modelo de escalabilidade continua o mesmo — fazemos a escalabilidade horizontal (para fora) com clones —, mas a escala em um ambiente de contêineres é significativamente maior. É como jogar um jogo de acertar toupeiras com cem buracos em vez de dez. Descobrir o caminho percorrido por uma determinada transação será, no mínimo, desafiador. Principalmente quando esse caminho pode ter desaparecido. Afinal, a premissa da maioria dos ambientes de contêineres é falhar rapidamente e substituir as instâncias, em vez de aguardar uma intervenção manual.
Há algumas maneiras de enfrentar esse desafio. A primeira e mais importante é a instrumentação que auxilia no rastreamento e na solução de problemas. Essa abordagem não é nova, mas se torna mais desafiadora devido à natureza volátil dos ambientes de contêineres. Ainda assim, a inserção de elementos de rastreamento (como cabeçalhos HTTP personalizados com identificadores exclusivos) pode ser extremamente útil para as equipes de operações ao tentar localizar erros ou problemas de desempenho. Embora normalmente não seja um recurso das opções nativas de escalabilidade de contêineres, essa é uma questão que as malhas de serviços estão abordando como parte de suas ofertas.
Em segundo lugar, há a possibilidade de colocar microsserviços com problemas em quarentena, permitindo que as equipes de operações e desenvolvimento examinem o sistema no estado que causou a falha. Basicamente, a quarentena remove o contêiner com problemas do ambiente ativo para que ele deixe de receber chamadas, mas o mantém em execução para análise e inspeção.
Não existe uma solução mágica, mas a capacidade de rastrear e colocar em quarentena contêineres em implantações baseadas em microsserviços pode contribuir muito para reduzir o tempo médio de resolução (MTTR) e o impacto sobre os negócios.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...