
Na Volterra, a função da equipe de SRE é operar uma plataforma de edge global baseada em SaaS. Precisamos superar diversos desafios ao gerenciar um grande número de clusters de aplicações em diferentes estados (por exemplo, online, offline, desativado pelo administrador etc.), e fazemos isso aproveitando o ecossistema e as ferramentas do Kubernetes com um modelo declarativo baseado em pull usando GitOps.
Neste blog, descreveremos:
Como usar GitOps para gerenciar e monitorar com eficiência uma grande frota de infraestrutura (hosts físicos ou na nuvem) e clusters K8s
- As ferramentas que desenvolvemos para resolver problemas relacionados a CI/CD
- Orquestração de objetos e gerenciamento de configurações
- Observabilidade em toda a frota de clusters de infraestrutura e K8s
Vamos nos aprofundar nas lições aprendidas em grande escala (3.000 sites de edge), tema que também abordei em minha palestra recente no Cloud Native Rejekts, em San Diego.
TL;DR (Resumo)
- Não conseguimos encontrar uma solução simples e pronta para uso que pudesse ser utilizada para implantar e operar milhares (e potencialmente milhões) de clusters de aplicações e infraestrutura em nuvens públicas, ambientes locais ou locais nômades
- Essa solução precisava fornecer o gerenciamento do ciclo de vida de hosts (físicos ou na nuvem), do plano de controle do Kubernetes e das cargas de trabalho das aplicações, além da configuração contínua de diversos serviços. Além disso, a solução precisava atender aos nossos requisitos de projeto de SRE — definição declarativa, ciclo de vida imutável, GitOps e nenhum acesso direto aos clusters.
- Após avaliar vários projetos de código aberto — como Kubespray+Ansible (para implantação do Kubernetes) ou Helm/Spinnaker (para gerenciamento de cargas de trabalho) —, concluímos que nenhuma dessas soluções poderia atender aos requisitos mencionados acima sem adicionar uma quantidade significativa de software desnecessário a cada local de borda. Por isso, decidimos desenvolver nosso próprio daemon de software baseado em Golang para realizar o gerenciamento do ciclo de vida do host (físico ou na nuvem), do plano de controle do Kubernetes e das cargas de trabalho das aplicações.
- À medida que escalamos o sistema para 3.000 clusters ou mais (em um único tenant), todas as nossas premissas sobre os provedores de nuvem pública, a escalabilidade dos nossos daemons de software, as ferramentas operacionais e a infraestrutura de observabilidade se mostraram sistematicamente equivocadas. Cada um desses aspectos exigiu a reformulação da arquitetura de alguns dos nossos componentes de software para superar esses desafios.
Definição da borda
- Customer Edge (CE) — São locais de clientes na nuvem (como AWS, Azure, GCP ou nuvem privada), locais on-premises (como chão de fábrica, instalações de petróleo e gás etc.) ou locais móveis (como veículos, robôs etc.). O CE é gerenciado pela equipe de SRE da Volterra, mas também pode ser implantado sob demanda pelos clientes nos locais de sua escolha.
- Edges regionais (RE) — São pontos de presença (PoP) da Volterra em instalações de colocation nos principais mercados metropolitanos, interconectados por nosso próprio backbone privado altamente interligado. Esses sites de edge regional também são usados para interconectar com segurança locais de edge do cliente (CE) e/ou disponibilizar serviços de aplicações na Internet pública. Os sites de RE pertencem à equipe de operações de infraestrutura da Volterra (Infra SRE) e são totalmente gerenciados por ela.
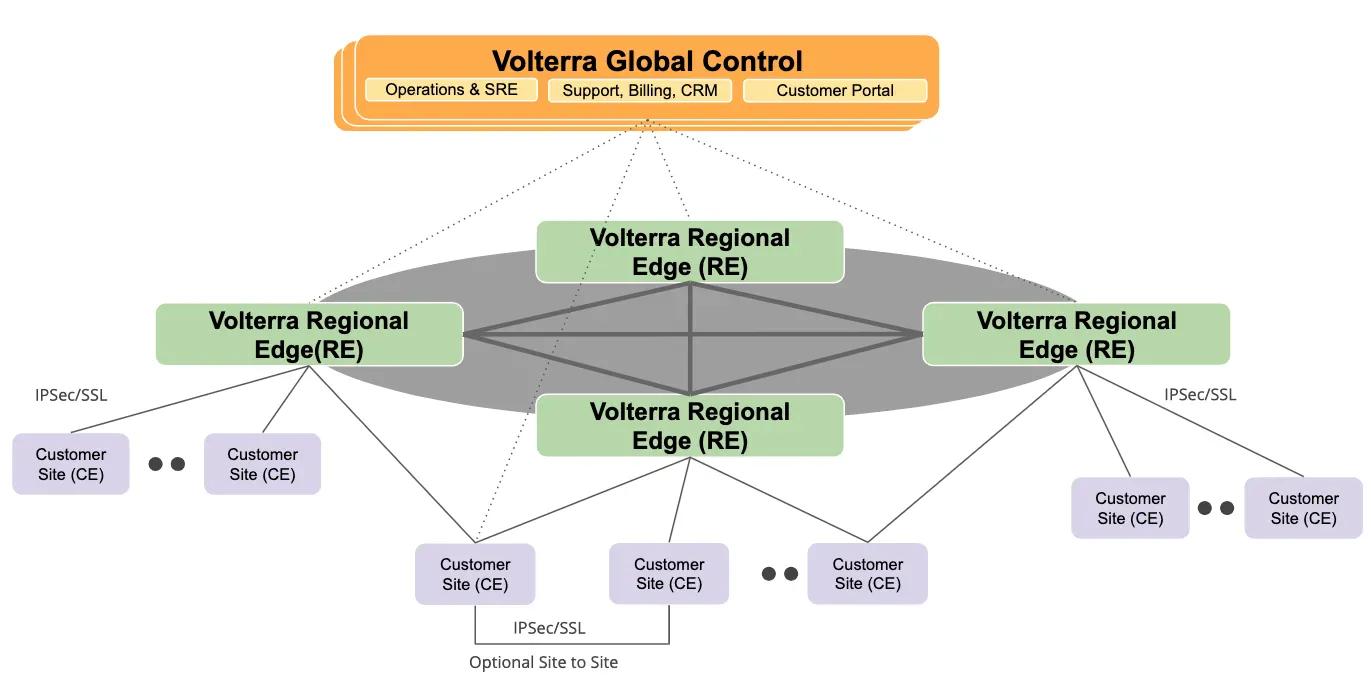
O diagrama de arquitetura acima (Figura 1) mostra a conectividade lógica entre nossos REs e CEs, em que cada CE estabelece conexões redundantes (VPN IPSec ou SSL) com o RE mais próximo.
Requisitos para o gerenciamento de borda
Quando começamos a projetar nossa plataforma, há cerca de dois anos, nossa equipe de produto nos pediu que solucionássemos os seguintes desafios:
- Escalabilidade do sistema — nossos clientes precisavam que oferecêssemos suporte a milhares (e, futuramente, milhões) de sites de borda, o que é muito diferente de operar alguns poucos clusters do Kubernetes em regiões de nuvem. Por exemplo, um de nossos clientes tem cerca de 17 mil lojas de conveniência, enquanto outro opera mais de 20 mil estações de recarga. Essa escala exigiu que desenvolvêssemos nossas ferramentas de forma muito diferente daquela usada para gerenciar apenas alguns clusters.
- Implantação sem intervenção — pois qualquer pessoa deve ser capaz de implantar um novo site sem precisar entender muito de hardware, software ou Kubernetes. O site de borda precisava funcionar como uma caixa-preta que liga, conecta-se à central e fica online.
- Gerenciamento de frota — gerenciamento simplificado de milhares de sites e cargas de trabalho, sem a necessidade de tratá-los individualmente. Qualquer site pode ficar offline ou indisponível no momento de uma alteração ou atualização solicitada. Por isso, os sites precisam buscar as atualizações quando voltam a ficar online.
- Tolerância a falhas — os sites de edge precisam continuar operacionais mesmo após a falha de qualquer componente. Tudo deve ser gerenciado remotamente e oferecer recursos como restauração das configurações de fábrica ou reconstrução do site em caso de falha. Tivemos que partir do pressuposto de que não haveria acesso físico ao local.
Princípios de design (sem Kubectl! Sem Ansible! Sem pacotes!)
Considerando nossos requisitos e os desafios de operar um sistema altamente distribuído, decidimos estabelecer alguns princípios que nossa equipe de SRE deveria seguir para reduzir problemas posteriores:
- Definição declarativa — todo o sistema deve ser descrito de forma declarativa, pois isso nos permite criar um modelo de abstração simples e realizar validações com base nesse modelo.
- Gerenciamento Imutável do Ciclo de Vida — no passado, trabalhávamos em grandes instalações de nuvem privada usando ferramentas de gerenciamento de ciclo de vida mutáveis, como Ansible, Salt ou Puppet. Desta vez, queríamos manter o sistema operacional básico bem simples e tentar distribuir tudo como contêiner, sem gerenciamento de pacotes nem a necessidade de ferramentas de gerenciamento de configuração.
- GitOps — fornece um modelo operacional padrão para gerenciar clusters do Kubernetes. Também nos permite contar, de forma nativa, com aprovações, auditorias e fluxos de trabalho para alterações, sem precisar criar um sistema adicional de gerenciamento de fluxos de trabalho. Por isso, decidimos que tudo deve passar pelo Git.
- Sem kubectl — Esse foi um dos princípios mais importantes, pois ninguém tem permissão para acessar diretamente os clusters de aplicações. Por isso, eliminamos a possibilidade de executar o kubectl em clusters de borda individuais ou de usar scripts executados a partir de locais centrais, incluindo sistemas de CD centralizados. Sistemas de CD centralizados que usam o método push são adequados para dezenas de clusters, mas certamente não para milhares sem a garantia de 100% de disponibilidade da rede.
- Nada de tecnologias (ou ferramentas) da moda — nossa experiência anterior mostrou que muitas das ferramentas populares de código aberto não correspondem às expectativas. Embora tenhamos avaliado vários projetos da comunidade para o provisionamento de infraestrutura, K8s e cargas de trabalho de aplicações (como Helm, Spinnaker e Terraform), acabamos usando apenas o Terraform para a parte de infraestrutura virtual e desenvolvemos um código personalizado que descreveremos nas próximas partes deste blog.
Gerenciamento do ciclo de vida do site
Como parte do gerenciamento do ciclo de vida dos sites de edge, tivemos que definir como provisionar o sistema operacional do host, realizar configurações básicas (por exemplo, gerenciamento de usuários, autoridade certificadora, hugepages etc.), inicializar o K8s, implantar cargas de trabalho e gerenciar alterações contínuas de configuração.
Uma das opções que consideramos, mas acabamos descartando, foi usar KubeSpray+Ansible (para gerenciar o sistema operacional e implantar o K8s) e Helm/Spinnaker (para implantar cargas de trabalho). Descartamos essa opção porque ela exigiria que gerenciássemos de duas a três ferramentas de código aberto e, depois, fizéssemos modificações significativas para atender aos nossos requisitos, que continuaram aumentando à medida que adicionávamos mais recursos, como escalonamento automático de clusters de borda, suporte a módulos TPM seguros, atualizações diferenciais etc.
Como nosso objetivo era manter tudo simples e minimizar o número de componentes executados diretamente no sistema operacional (fora do Kubernetes), decidimos desenvolver um daemon leve em Golang chamado Volterra Platform Manager (VPM). Esse é o único contêiner Docker gerenciado pelo systemd no sistema operacional e funciona como um canivete suíço, desempenhando diversas funções:
Ciclo de vida do host
O VPM é responsável por gerenciar o ciclo de vida do sistema operacional do host, incluindo instalação, atualizações, patches, configuração etc. Há muitos aspectos que precisam ser configurados (por exemplo, alocação de hugepages, /etc/hosts etc.)
- Gerenciamento de atualizações do sistema operacional — infelizmente, a edge não se resume apenas ao Kubernetes, e precisamos gerenciar a versão do kernel e do sistema operacional como um todo. Nossa edge é baseada no CoreOS (ou no CentOS, dependendo das necessidades do cliente), com uma partição ativa e outra passiva. Quando uma atualização é agendada, ela é sempre baixada para a partição passiva. A reinicialização é a última etapa da atualização, quando as partições ativa e passiva são alternadas. O único ponto crítico é a estratégia de reinicialização (em clusters com vários nós), pois nem todos os nós podem ser reinicializados ao mesmo tempo. Implementamos nosso próprio bloqueio de reinicialização no etcd (no VPM), que permite reinicializar os nós de um cluster um de cada vez.
- Gerenciamento do acesso de usuários ao sistema operacional — precisamos restringir os usuários e o acesso remoto deles via ssh e ao console. O VPM realiza todas essas operações, como a rotação de CAs de ssh.
- Como desenvolvemos nosso próprio datapath L3-L7, precisamos configurar hugepages de 2 MB ou 1 GB no sistema operacional do host, de acordo com o tipo de hardware (ou VM na nuvem)
Ciclo de vida do Kubernetes
Gerenciamento para fornecer o ciclo de vida do manifesto do Kubernetes. Em vez de usar o Helm, decidimos usar a biblioteca client-go do K8s, que integramos ao VPM e da qual utilizamos vários recursos:
- Implantação otimista vs. pessimista — esse recurso nos permite categorizar os aplicativos para os quais precisamos aguardar até que estejam íntegros. Ele simplesmente verifica a anotação no manifesto do K8s ves.io/deploy: optimistic.Otimista = cria o recurso e não aguarda o status. É muito semelhante ao comando kubernetes apply, no qual não se sabe se os pods realmente serão iniciados com sucesso. Pessimista = aguarda o estado do recurso do Kubernetes. Por exemplo, a implantação aguarda até que todos os pods estejam prontos. Isso é semelhante ao novo comando kubectl wait.
- Ações de pré-atualização, como o pré-pull — às vezes, não é possível depender das atualizações contínuas do K8s, especialmente quando o plano de dados da rede é implantado. Isso ocorre porque o pod antigo é destruído e, em seguida, é feito o pull do novo pod. No entanto, no caso do plano de dados, a conectividade de rede é perdida. Portanto, não é possível fazer o pull da nova imagem do contêiner, e o pod nunca será iniciado. A anotação de metadados ves.io/prepull, com uma lista de imagens, aciona a ação de pull antes que o manifesto do K8s seja aplicado.
- Novas tentativas e reversões em caso de falhas na aplicação. Essa é uma situação muito comum quando um servidor de API do K8s apresenta indisponibilidades intermitentes.
Configuração contínua
Além das configurações relacionadas aos manifestos do K8s, também precisamos configurar vários serviços da Volterra por meio de suas APIs. Um exemplo são as configurações de VPN IPsec/SSL — o VPM recebe as configurações do nosso plano de controle global e as aplica a cada nó.
Restauração de fábrica
Esse recurso permite redefinir remotamente um equipamento para o estado original e refazer todo o processo de instalação e registro. É um recurso essencial para recuperar um site sem a necessidade de acesso físico ou via console.
Embora o gerenciamento do ciclo de vida do K8s possa parecer um grande tema de discussão para muitas pessoas, para a nossa equipe ele provavelmente representa apenas 40–50% do volume total de trabalho.
Provisionamento sem intervenção
O provisionamento sem intervenção do site de borda em qualquer local (nuvem, ambiente local ou borda nômade) é uma funcionalidade essencial, pois não podemos contar com o acesso a cada site individualmente, nem queremos contratar tantos especialistas em Kubernetes para instalar e gerenciar cada site. Isso simplesmente não é escalável para milhares de sites.
O diagrama a seguir (Figura 2) mostra como o VPM participa do processo de registro de um novo site:
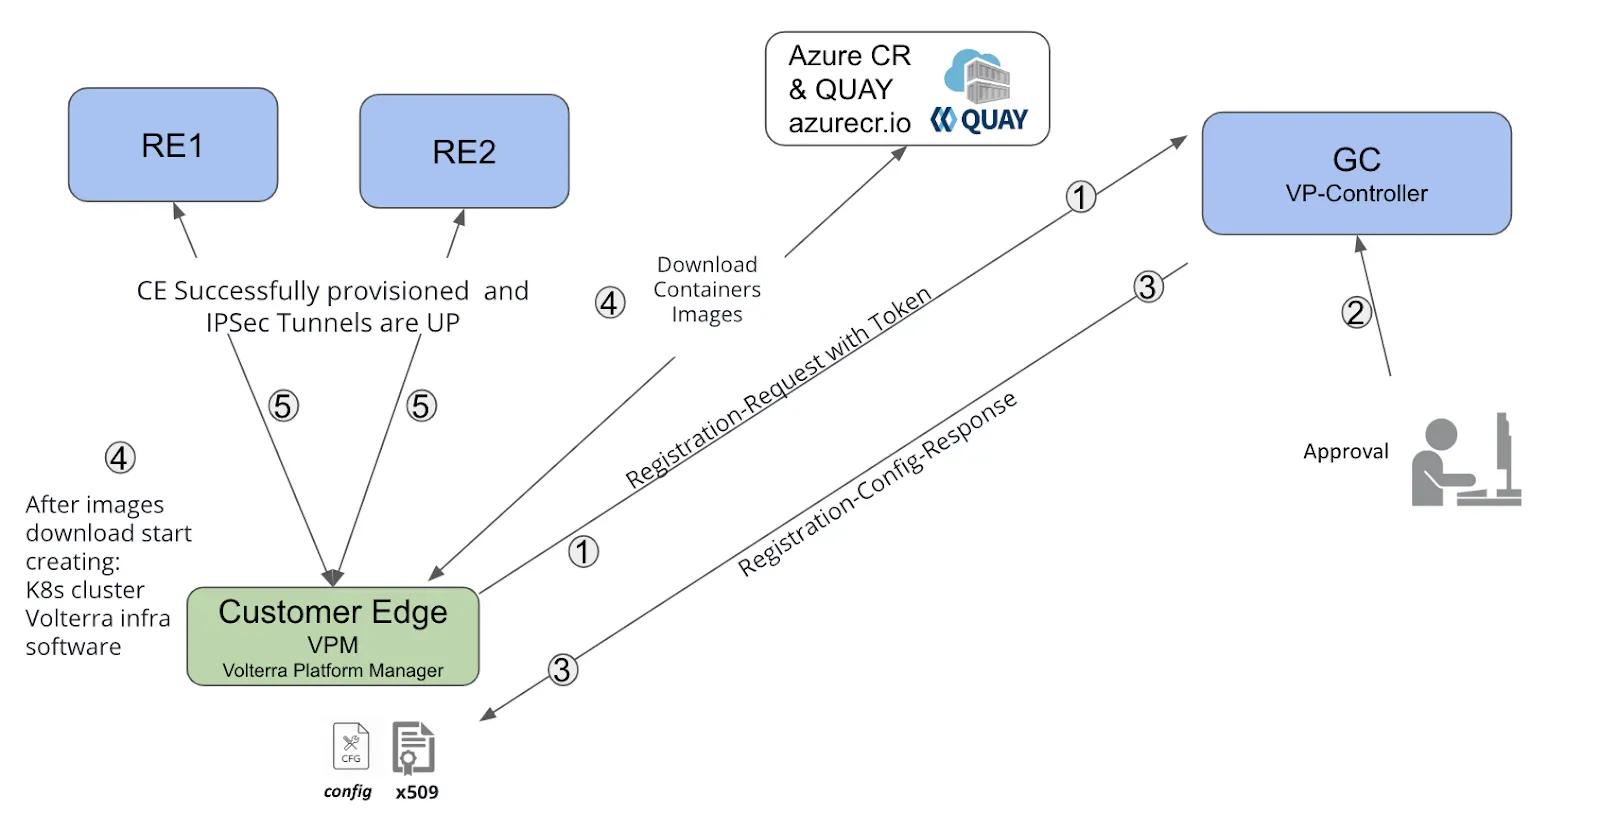
- Depois de ligado, o VPM em execução no CE (representado pela caixa verde) apresentará um token de registro ao nosso plano de controle global (GC) para criar um novo registro. O token de registro é fornecido como parte do cloud-init da VM na nuvem e pode ser uma chave inserida por uma pessoa durante o processo de inicialização ou programada no TPM para hardware de borda.
- O GC recebe a solicitação com o token, o que permite criar um novo registro em um tenant (codificado no token). O operador do cliente pode visualizar imediatamente o novo site de borda no mapa e aprová-lo, podendo inserir um nome e outros parâmetros de configuração.
- O VP-Controller no GC gera a configuração (por exemplo, decide quem será o mestre do K8s, o minion etc.) e os certificados para etcd, K8s e VPM.
- O VPM inicia a configuração do site, incluindo o download de imagens do Docker, a configuração de hugepages, a instalação do cluster K8s e a inicialização dos serviços do plano de controle da Volterra.
- O VPM configura túneis redundantes (VPN IPSec/SSL) para os dois sites de borda regional mais próximos, que serão usados para o tráfego de dados e a interconectividade entre sites e com a rede pública.
Como você pode ver, todo o processo é totalmente automatizado, e o usuário não precisa conhecer os detalhes da configuração nem executar nenhuma etapa manual. Leva cerca de 5 minutos para que todo o dispositivo fique online e pronto para atender às solicitações e aos aplicativos dos clientes.
Atualizações de software da infraestrutura
A atualização é uma das questões mais complexas que tivemos de resolver. Vamos definir o que está sendo atualizado nos sites de borda:
- Atualizações do sistema operacional — isso abrange o kernel e todos os pacotes do sistema. Quem já administrou uma distribuição padrão do sistema operacional Linux conhece a dificuldade de atualizar entre versões secundárias (por exemplo, do Ubuntu 16.04.x para o 16.04.y) e a dificuldade ainda maior de atualizar entre versões principais (por exemplo, do Ubuntu 16.04 para o 18.04). No caso de milhares de sites, as atualizações precisam ser determinísticas e não podem se comportar de maneira diferente entre os sites. Por isso, escolhemos o CoreOS e o CentOS Atomic, que permitem realizar atualizações A/B com duas partições e um sistema de arquivos somente leitura nos caminhos. Isso nos permite reverter imediatamente uma atualização alterando a ordem das partições de inicialização e manter o sistema operacional consistente sem precisar gerenciar seus pacotes. No entanto, não podemos mais atualizar componentes individuais do sistema, como o servidor openssh, simplesmente instalando um novo pacote. As alterações em componentes individuais precisam ser lançadas como uma nova versão imutável do sistema operacional.
- Atualizações de software — isso abrange o VPM, o etcd, o Kubernetes e os serviços de controle da Volterra executados como cargas de trabalho do K8s. Como já mencionei, nosso objetivo é ter tudo dentro do K8s sendo executado como contêiner systemd. Felizmente, conseguimos converter tudo em cargas de trabalho do K8s, exceto três serviços: VPM, etcd e kubelet.
Há dois métodos conhecidos que podem ser usados para distribuir atualizações aos sites de borda:
- Baseado em push — um método de push geralmente é executado por uma ferramenta centralizada de CD (entrega contínua), como Spinnaker, Jenkins ou uma ferramenta de gerenciamento de configuração baseada em Ansible. Nesse caso, uma ferramenta central precisaria ter acesso ao site ou cluster de destino e estar disponível para executar a ação.
- Baseado em pull — um método baseado em pull busca informações de atualização de forma independente, sem nenhum mecanismo centralizado de entrega. Ele oferece maior escalabilidade e também elimina a necessidade de armazenar as credenciais de todos os sites em um único local.
Nosso objetivo com a atualização era maximizar a simplicidade e a confiabilidade, de forma semelhante às atualizações padrão de celulares. Além disso, havia outras considerações que a estratégia de atualização precisava atender: o contexto da atualização poderia estar disponível apenas para o operador do site, ou o dispositivo poderia ficar offline ou indisponível por algum tempo devido a problemas de conectividade, entre outros fatores. Esses requisitos poderiam ser atendidos mais facilmente com o método pull e, por isso, decidimos adotá-lo para atender às nossas necessidades.
GitOps
Além disso, escolhemos o GitOps porque ele facilitou o fornecimento à nossa equipe de SRE de um modelo operacional padrão para gerenciar clusters do Kubernetes, fluxos de trabalho e alterações de auditoria.
Para resolver os problemas de escalabilidade de milhares de sites, desenvolvemos a arquitetura de SRE apresentada na Figura 3:
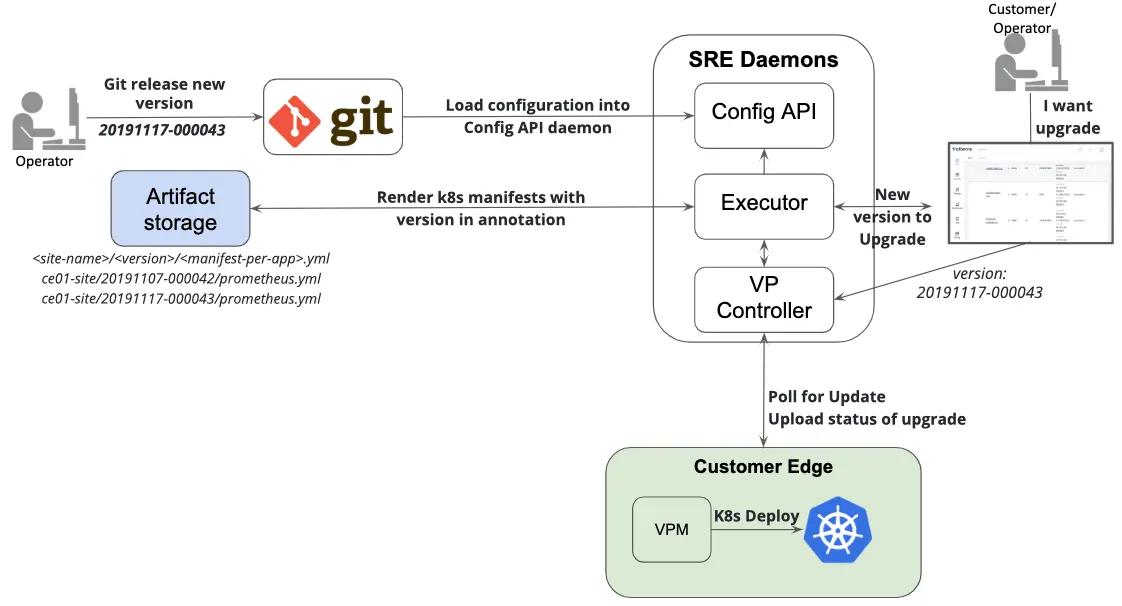
Primeiro, quero enfatizar que não usamos o Git apenas para armazenar estados ou manifestos. Isso porque nossa plataforma precisa lidar não só com manifestos do K8s, mas também com configurações contínuas de API, versões do K8s etc. No nosso caso, os manifestos do K8s representam cerca de 60% de toda a configuração declarativa. Por esse motivo, tivemos que criar nossa própria abstração de DSL sobre essa estrutura, que é armazenada no Git. Além disso, como o Git não oferece uma API nem recursos para mesclar parâmetros, tivemos que desenvolver daemons adicionais em Golang para SRE: Config API, Executor e VP Controller.
Vamos analisar o fluxo de trabalho para lançar uma nova versão do software na infraestrutura de borda do cliente usando nossa plataforma SaaS:
- O operador decide lançar uma nova versão e abre uma solicitação de merge (MR) no modelo do Git
- Assim que esse MR é aprovado e mesclado, a CI aciona o carregamento de uma configuração do modelo git em nosso daemon SRE Config-API. Esse daemon disponibiliza várias APIs para mesclagem de parâmetros, configuração de DNS interno etc.
- A Config-API é monitorada pelo daemon Executor; imediatamente após as alterações do git serem carregadas, ele começa a renderizar os manifestos finais do K8s com a versão na anotação. Em seguida, esses manifestos são enviados para o armazenamento de artefatos (semelhante ao S3) no caminho ce01-site//.yml
- Depois que a nova versão é renderizada e enviada para o armazenamento de artefatos, o Executor gera um novo status na API do cliente, indicando que há uma versão disponível; isso é muito semelhante à notificação de nova versão disponível em celulares
- O cliente (ou operador) pode agendar a atualização de seu site para a versão mais recente, e essas informações são repassadas ao VP-Controller. O VP-Controller é o daemon responsável pelo gerenciamento do site, incluindo provisionamento, desativação ou migração para outro local. Isso já foi parcialmente explicado no provisionamento sem intervenção e é responsável por atualizar os sites de borda por meio da API mTLS
- A última etapa do diagrama ocorre no site de borda — assim que a conexão VPN IPSec/SSL é estabelecida, o VP-Controller notifica o VPM na borda para baixar as atualizações da nova versão; no entanto, se a conexão for interrompida ou apresentar problemas intermitentes, o VPM verifica se há atualizações a cada 5 minutos
- Novos manifestos e configurações do K8s são obtidos e implantados no K8s. Usando o recurso de implantação pessimista descrito na seção anterior, o VPM aguarda até que todos os pods estejam prontos
- Como última etapa, o VPM envia o status da atualização de volta ao VP Controller, que então o encaminha como status para a API do cliente.
Você pode assistir a uma demonstração de todo o fluxo de trabalho aqui:
Lições aprendidas com testes em 3.000 sites de edge
Nas seções anteriores, descrevemos como nossas ferramentas são usadas para implantar e gerenciar o ciclo de vida dos sites de borda. Para validar nosso projeto, decidimos criar um ambiente de grande escala com três mil sites de borda de clientes (como mostrado na Figura 4).
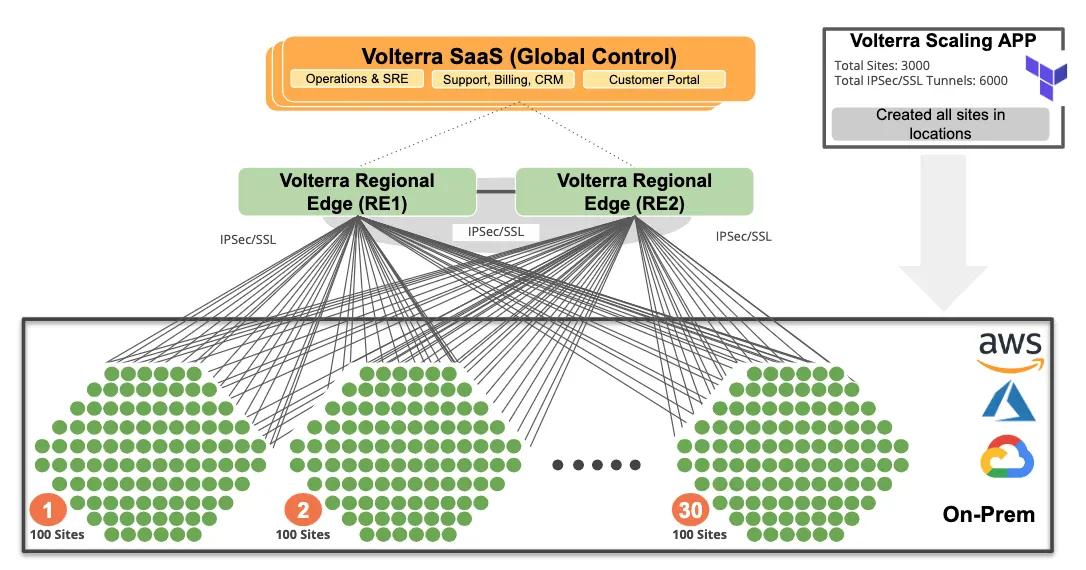
Usamos o Terraform para provisionar 3.000 VMs na AWS, no Azure, no Google e em nossa própria nuvem local de bare metal para simular a operação em escala. Todas essas VMs eram CEs (sites de borda do cliente) independentes que estabeleceram túneis redundantes com nossos sites de borda regionais (também conhecidos como PoPs).
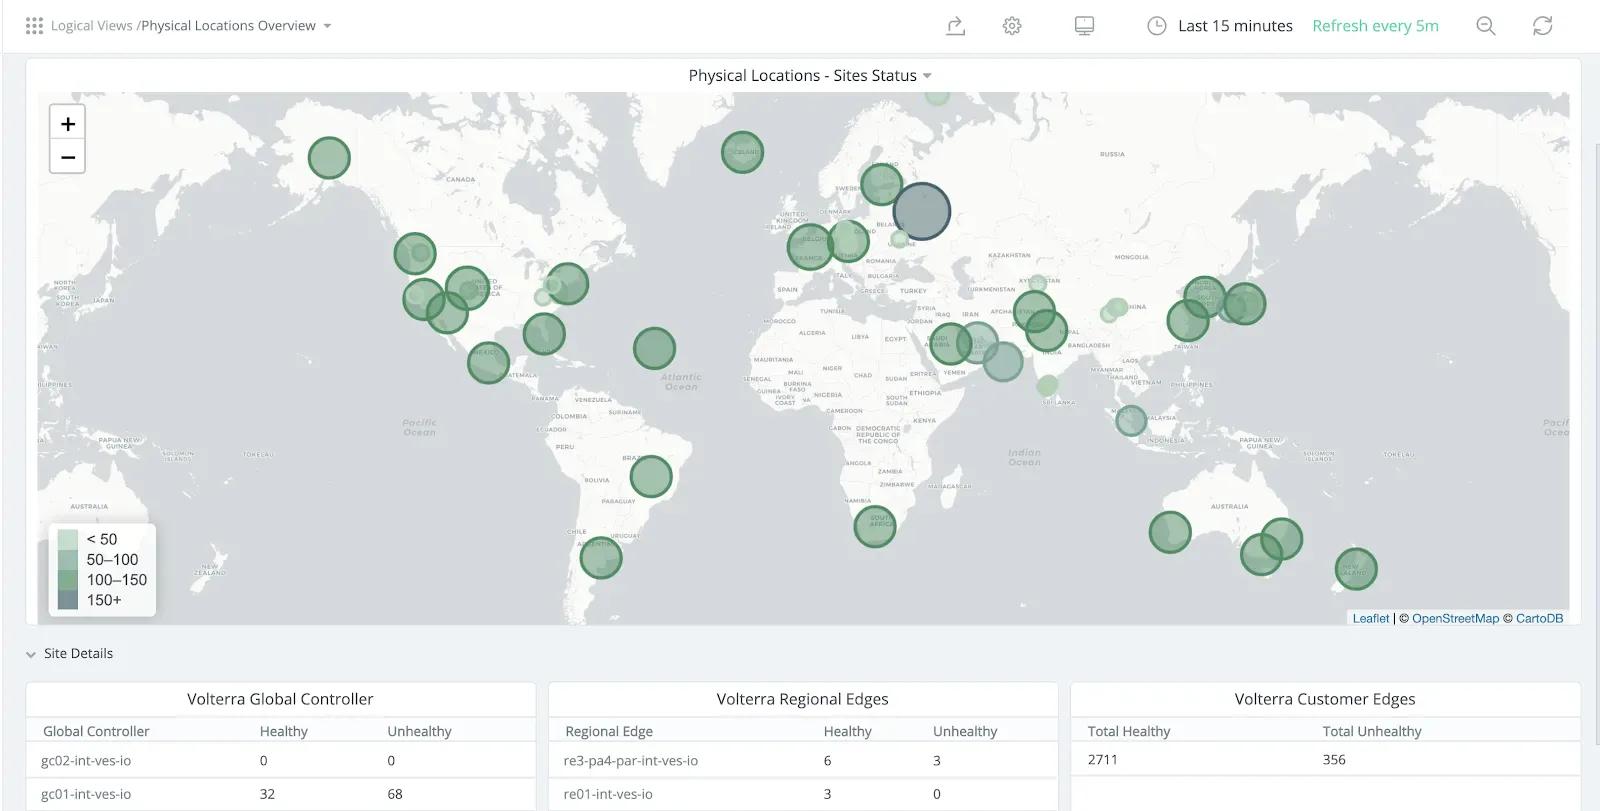
A captura de tela abaixo é do nosso painel de SRE e mostra a quantidade de edges em cada local, representada pelo tamanho do círculo. No momento em que a captura foi feita, tínhamos cerca de 2.711 sites de edge íntegros e 356 com problemas.
Principais conclusões: Operações
Como parte do processo de escalabilidade, identificamos alguns problemas de configuração e operação que exigiram modificações nos daemons do nosso software. Além disso, enfrentamos diversos problemas com um provedor de nuvem, o que nos levou a abrir vários chamados de suporte — por exemplo, latência nas respostas da API, impossibilidade de obter mais de 500 VMs em uma única região etc.
- Otimizar o VP-Controller — inicialmente, processávamos os registros de forma sequencial, e cada um levava cerca de dois minutos, pois precisávamos emitir vários certificados para etcd, kubernetes e VPM. Reduzimos esse tempo usando chaves pré-geradas com maior entropia e paralelização com um número maior de workers. Isso nos permitiu processar o registro de 100 sites em menos de 20 segundos. Conseguimos atender a todos os 3.000 sites de borda consumindo apenas cerca de uma vCPU e 2 GB de RAM em nosso VP-Controller.
- Otimizar a entrega de imagens Docker — quando começamos a escalar, percebemos que o volume de dados transmitidos para os sites de borda era enorme. Cada site de borda baixava cerca de 600 MB (multiplicados por 3.000), totalizando 1,8 TB de dados transmitidos. Além disso, recriamos os sites de borda várias vezes durante nossos testes, portanto esse volume seria, na verdade, muito maior. Por isso, tivemos que otimizar o tamanho das nossas imagens Docker e criar imagens para nuvem e imagens ISO com as imagens Docker já baixadas, a fim de reduzir o volume de downloads. Embora ainda estejamos usando um serviço público de registro de contêineres na nuvem, estamos trabalhando ativamente em um projeto para distribuir nosso registro de contêineres por meio de REs (PoPs) e realizar atualizações incrementais (por diferenças binárias).
- Otimizar as operações do banco de dados de controle global — todos os nossos serviços de controle da Volterra são baseados no framework de serviços Golang, que usa o ETCD como banco de dados. Cada site é representado como um objeto de configuração. Cada objeto de configuração de site tem alguns StatusObjects, como software-upgrade, hardware-info ou ipsec-status. Esses StatusObjects são gerados por vários componentes da plataforma e todos são referenciados em uma API de configuração global. Quando chegamos a 3.000 sites, tivemos que fazer algumas otimizações no esquema dos nossos objetos. Por exemplo, limitar o número de tipos de StatusObjects aceitos pela API de configuração global ou transferi-los para uma instância dedicada do ETCD, a fim de reduzir o risco de sobrecarregar o banco de dados de objetos de configuração. Isso nos permite oferecer maior disponibilidade e um melhor tempo de resposta para o banco de dados de configuração, além de possibilitar a reconstrução do banco de dados de status em caso de falhas. Outro exemplo de otimização foi deixar de executar operações desnecessárias de listagem de objetos de site em todos os tenants ou introduzir índices secundários para reduzir a carga sobre o banco de dados.
Principais conclusões: observabilidade
A observabilidade em um sistema distribuído apresentou um conjunto muito maior de desafios à medida que escalamos o sistema.
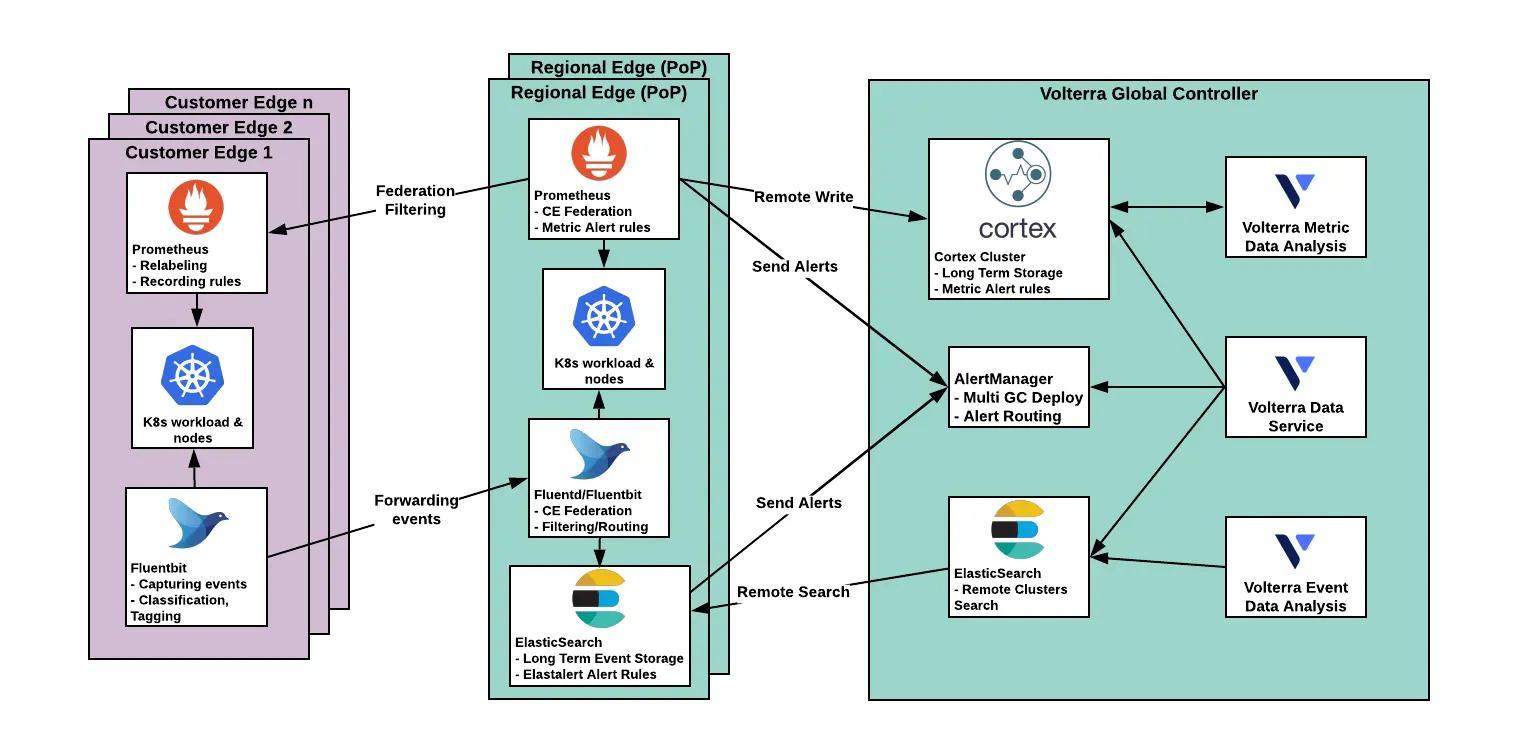
Inicialmente, para as métricas, começamos com a federação do Prometheus — um Prometheus central no controle global federando instâncias do Prometheus nas bordas regionais (REs), cada uma coletando as métricas de seus serviços e federando as métricas dos CEs conectados a ela. O Prometheus de nível superior avaliava alertas e servia como fonte de métricas para análises posteriores. Rapidamente atingimos os limites dessa abordagem (por volta de 1.000 CEs) e tentamos minimizar o impacto do número crescente de CEs. Começamos a gerar séries pré-calculadas para histogramas e outras métricas de alta cardinalidade. Isso nos deu uma folga de um ou dois dias, mas depois tivemos que adotar listas de permissões para as métricas. No fim, conseguimos reduzir o número de séries temporais de cerca de 60.000 para 2.000 por site de CE.
Por fim, após continuarmos a expansão para mais de 3.000 sites de CE e operarmos por muitos dias em produção, ficou claro que essa abordagem não era escalável e que precisávamos repensar nossa infraestrutura de monitoramento. Decidimos remover o Prometheus de nível superior (no controle global) e dividir o Prometheus de cada RE em duas instâncias separadas: uma responsável por coletar as métricas dos serviços locais e outra por federar as métricas dos CEs. Ambas geram alertas e enviam métricas para o armazenamento central no Cortex. O Cortex é usado como fonte para análises e visualizações, não fazendo parte do fluxo principal de alertas de monitoramento. Testamos várias soluções de métricas centralizadas, entre elas Thanos e M3db, e concluímos que o Cortex era a mais adequada às nossas necessidades.
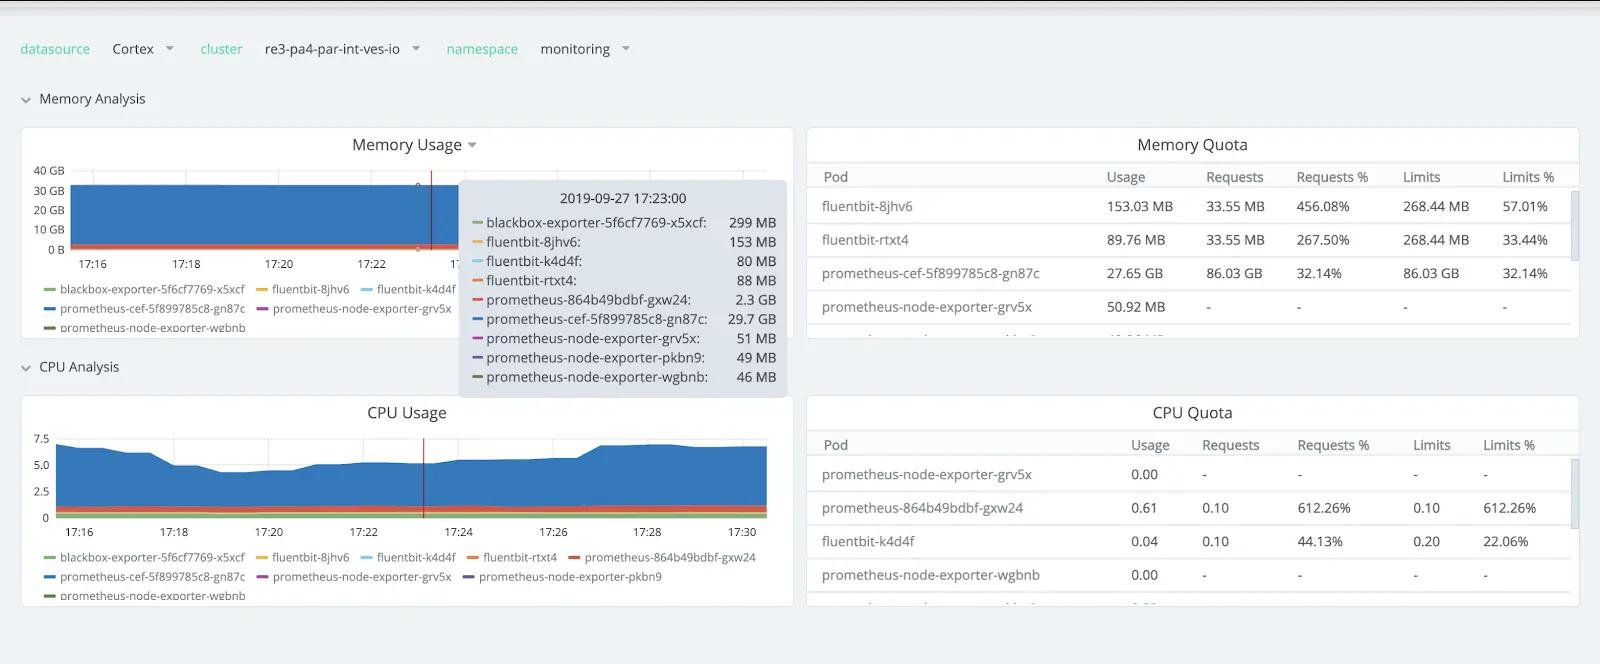
A captura de tela a seguir (Figura 7) mostra o consumo de memória da coleta realizada pelo prometheus-cef com 3.000 endpoints. O ponto interessante são os 29,7 GB de RAM consumidos, o que, na verdade, não é tanto considerando a escala do sistema. Isso pode ser ainda mais otimizado dividindo a coleta em várias instâncias ou transferindo a gravação remota no Cortex diretamente para a própria borda.
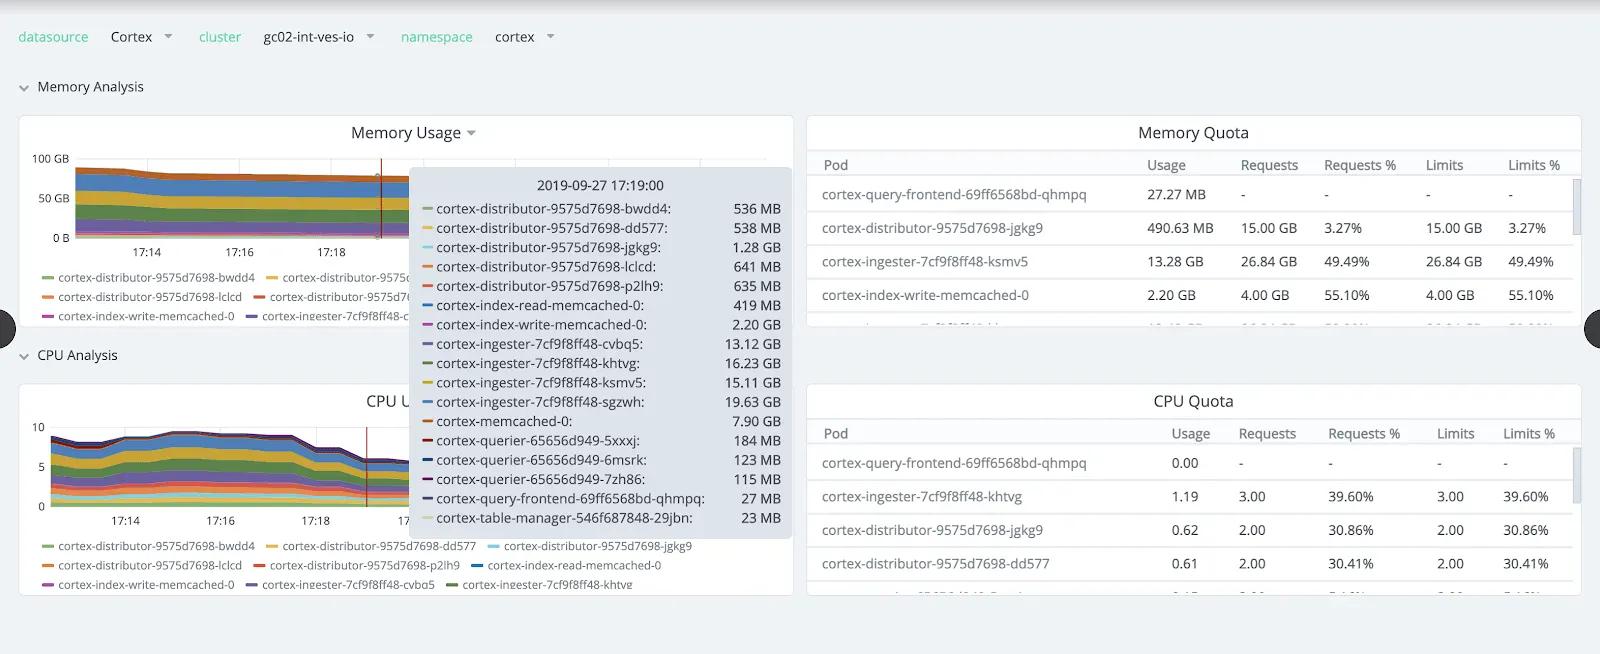
A próxima captura de tela (Figura 8) mostra a quantidade de memória e recursos de CPU de que precisamos para os ingestors (máximo de 19 GB de RAM) e distributors do Cortex nessa escala. A maior vantagem do Cortex é o escalonamento horizontal, que nos permite adicionar mais réplicas, em comparação com o Prometheus, no qual o escalonamento precisa ocorrer verticalmente.
Para a infraestrutura de logs em CEs e REs, usamos serviços Fluentbit em cada nó, que coletam os eventos de log dos serviços e do sistema e os encaminham ao Fluentd na RE conectada. O Fluentd encaminha os dados ao ElasticSearch presente na RE. Os dados do ElasticSearch são avaliados pelo Elastalert, e regras são configuradas para criar alertas no Alertmanager. Usamos nossa integração personalizada entre o Elastalert e o Alertmanager para gerar alertas com os mesmos rótulos produzidos pelo Prometheus.
Os principais pontos da nossa jornada de monitoramento:
- Uso de novos filtros de federação do Prometheus para descartar métricas e rótulos não utilizados- Inicialmente, tínhamos cerca de 50.000 séries temporais por CE, com uma média de 15 rótulos. Otimizamos esse número para uma média de 2.000 por CE usando listas de permissões simples para nomes de métricas e listas de bloqueios para nomes de rótulos
- Migração da federação global do Prometheus para um cluster Cortex- O Prometheus centralizado coletava dados das instâncias do Prometheus de todos os REs e CEs - Ao atingir 1.000 CEs, tornou-se inviável gerenciar a quantidade de métricas - Atualmente, temos o Prometheus em cada RE (federando as instâncias do Prometheus dos CEs conectados), com gravação remota (RW) no Cortex
- Clusters e logs do Elasticsearch- Arquitetura de logs descentralizada - O Fluentbit, atuando como coletor em cada nó, encaminha os logs para o Fluentd (agregador) no RE - O ElasticSearch é implantado em cada RE e usa a pesquisa em clusters remotos para consultar logs a partir de uma única instância do Kibana
Resumo
Espero que este blog ajude você a entender tudo o que precisa ser considerado para gerenciar milhares de sites de borda e clusters implantados ao redor do mundo. Embora tenhamos conseguido atender e validar a maioria dos nossos requisitos iniciais de projeto, ainda há muitas melhorias pela frente…
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...