Já escrevemos bastante sobre como você pode usar o NGINX Plus e o NGINX Open Source para balancear a carga dos seus sites e aplicativos, garantindo disponibilidade e confiabilidade ideais. O balanceamento de carga é uma ferramenta fundamental para melhorar o desempenho dos aplicativos, disponibilizar aplicativos em grande escala, e implantar contêineres e microsserviços.
Já explicamos anteriormente como você pode implantar o NGINX Plus no data center (talvez junto a controladores de entrega de aplicações legados), em contêineres e em ambientes de nuvem, incluindo a Amazon Web Services (AWS), o Google Cloud Platform e o Microsoft Azure.
Neste post, vamos nos concentrar nas técnicas de balanceamento de carga (também chamadas de métodos ou algoritmos de balanceamento de carga) no NGINX Plus e no NGINX, além de oferecer algumas orientações sobre como escolher o método certo para diferentes casos de uso. O NGINX oferece quatro técnicas de balanceamento de carga (Round Robin, Hash, IP Hash e Least Connections), e o NGINX Plus acrescenta mais uma (Least Time). Todos os métodos para tráfego HTTP também estão disponíveis para TCP (e UDP, no NGINX Plus Release 9 e versões posteriores), exceto IP Hash.
[Editor – NGINX Plus R16 e NGINX Open Source 1.15.1 introduziram o algoritmo Aleatório com Duas Escolhas como uma opção adicional de balanceamento de carga. Para saber mais, consulte NGINX e o algoritmo de balanceamento de carga “O Poder de Duas Escolhas” em nosso blog.]
Análise das técnicas de balanceamento de carga
Vamos supor que você conheça os conceitos básicos de configuração do balanceamento de carga, mas, se quiser relembrá-los, consulte estes recursos:
- Os artigos do Guia do Administrador do NGINX Plus oferecem uma visão geral completa.
- Balanceamento de carga de alto desempenho contém links para discussões detalhadas sobre recursos avançados do NGINX Plus que podem aumentar ainda mais a eficiência de um método de balanceamento de carga.
- Balanceamento de carga com NGINX e NGINX Plus, Parte 1 e Parte 2 é um guia passo a passo que transforma um proxy reverso simples em uma solução abrangente de balanceamento de carga com os recursos avançados do NGINX Plus.
- A página de soluções de balanceamento de carga contém links para outros recursos, incluindo e-books, webinars e white papers.
Para simplificar, vamos nos concentrar no balanceamento de carga HTTP, que você configura no contexto http. Já o balanceamento de carga TCP é configurado no contexto stream (assim como o balanceamento de carga UDP no NGINX Plus Release 9 e posteriores). Embora os balanceadores de carga HTTP e TCP/UDP tenham os mesmos recursos, as diretivas e os parâmetros disponíveis diferem um pouco devido às diferenças inerentes entre os protocolos. Para obter detalhes, consulte a documentação sobre os módulos Upstream para HTTP e TCP/UDP.
Você habilita o balanceamento de carga com dois blocos de configuração, que mostraremos em sua forma básica, sem parâmetros opcionais nem recursos auxiliares:
- O bloco
serverdefine um servidor virtual que recebe tráfego com as características especificadas e o encaminha para um grupo nomeado de servidores upstream. Em nossos exemplos, o servidor virtual recebe, na porta padrão (80), o tráfego HTTP enviado para www.example.com, e o encaminha para o grupo de servidores upstream chamado backend. Esse bloco é o mesmo em todos os nossos exemplos.
server {    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}- (O NGINX Plus e o NGINX também podem balancear a carga de servidores de backend FastCGI, memcached, SCGI e uwsgi. Substitua
proxy_passpela diretiva apropriada –fastcgi_pass,memcached_pass,scgi_passouuwsgi_pass.) - O bloco
upstreamnomeia um grupo upstream e lista os servidores que pertencem a ele, identificados pelo nome do host, endereço IP ou caminho do soquete de domínio UNIX. Em nossos exemplos, o grupo upstream chamado backend inclui três servidores: web1, web2 e web3. O blocoupstreamé onde você especifica a técnica de balanceamento de carga, portanto, vamos destacá-la nas seções a seguir. Como exemplo, este é o bloco do método padrão, Round Robin:
upstream backend {    server web1;
    server web2;
    server web3;
}
Round Robin
Round Robin é a técnica de balanceamento de carga padrão tanto para o NGINX Plus quanto para o NGINX. O balanceador de carga percorre sequencialmente a lista de servidores upstream, atribuindo a próxima solicitação de conexão a cada um deles, alternadamente.
Considerando o seguinte exemplo de configuração do grupo upstream backend, o balanceador de carga envia as três primeiras solicitações de conexão, na ordem, para web1, web2 e web3, a quarta para web1, a quinta para web2 e assim por diante.
upstream backend {    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Hash
Com o método Hash, para cada solicitação, o balanceador de carga calcula um hash com base na combinação de texto e variáveis do NGINX que você especificar e associa o hash a um dos servidores. Ele envia todas as solicitações com esse hash para esse servidor, portanto, esse método estabelece um tipo básico de persistência de sessão.
No exemplo a seguir, a diretiva hash usa o esquema (http ou https) e o URI completo da solicitação como base para o hash:
upstream backend {    hash $scheme$request_uri;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Hash de IP
IP Hash (disponível apenas para HTTP) é uma variante predefinida do método Hash, na qual o hash é baseado no endereço IP do cliente. Você pode configurá-lo com a diretiva ip_hash.
upstream backend {    ip_hash;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Se o cliente tiver um endereço IPv6, o hash será baseado no endereço inteiro. Se tiver um endereço IPv4, o hash será baseado apenas nos três primeiros octetos do endereço. Isso foi projetado para otimizar o funcionamento para clientes de provedores de internet que recebem endereços IP dinamicamente de uma faixa de sub-rede (/24). Em caso de reinicialização ou reconexão, o endereço do cliente geralmente muda para outro dentro da faixa de rede /24, mas a conexão ainda representa o mesmo cliente, portanto não há motivo para alterar o mapeamento para o servidor.
No entanto, se a maior parte do tráfego do seu site vier de clientes na mesma rede /24, o IP Hash não fará sentido, pois mapeará todos os clientes para o mesmo servidor. Nesse caso (ou se, por algum outro motivo, você quiser gerar o hash com base nos quatro octetos), use o método Hash com a variável $remote_addr.
hash $remote_addr;Menor número de conexões
Com o método de Menor Número de Conexões, o balanceador de carga compara o número atual de conexões ativas que mantém com cada servidor e envia a solicitação ao servidor com menos conexões. Esse método é configurado com a diretiva least_conn.
upstream backend {
    least_conn;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Menor tempo
Com o método Least Time (disponível apenas no NGINX Plus), o balanceador de carga combina matematicamente duas métricas para cada servidor — o número atual de conexões ativas e uma média ponderada do tempo de resposta de solicitações anteriores — e envia a solicitação ao servidor com o menor valor.
A escolha do parâmetro na diretiva least_time controla qual dos dois tempos de resposta é monitorado: o tempo para receber o cabeçalho da resposta (header) ou o tempo para receber a resposta completa (last_byte).
upstream backend {    least_time (header | last_byte);

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Observações:
- Para o balanceamento de carga TCP e UDP (no contexto
stream), você pode escolher entre três tipos de tempo de resposta usando estes parâmetros da diretivaleast_time:connect– Tempo para se conectar ao servidor upstreamfirst_byte– Tempo para receber o primeiro byte dos dados da respostalast_byte– Tempo para receber o último byte dos dados da resposta
- Para tráfego HTTP e TCP/UDP, no NGINX Plus R12 e versões posteriores, adicione o parâmetro
inflightpara incluir conexões incompletas em cada métrica; nas versões anteriores, essas conexões são incluídas por padrão.
Escolhendo uma técnica de balanceamento de carga
Então, como saber qual das técnicas de balanceamento de carga é a melhor para o seu site ou aplicativo?
Os padrões de tráfego variam tanto de um site para outro — e até mesmo dentro de um único site em diferentes horários do dia — que não faz sentido basear a escolha da técnica de balanceamento de carga em uma única característica (como tráfego em rajadas versus tráfego constante, conexões de curta duração versus conexões de longa duração e assim por diante). Dito isso, analisaremos os prós e os contras de cada método para ajudar você a restringir o leque de opções a considerar.
Executando testes para comparar métodos
Independentemente do subconjunto de métodos de balanceamento de carga que você considerar, recomendamos testá-los para descobrir qual funciona melhor para o seu tráfego. “Melhor” geralmente significa o menor tempo para entregar respostas aos clientes, mas você pode ter critérios diferentes.
Gerenciamento de desempenho de aplicações são ferramentas muito úteis para esse tipo de teste – você pode criar telas personalizadas com gráficos para cada servidor do grupo upstream, permitindo compará-los em tempo real à medida que os valores mudam durante o teste. Várias soluções de APM oferecem plug-ins personalizados para NGINX Plus e NGINX, incluindo AppDynamics, Datadog, Dynatrace e New Relic.
O teste é mais simples quando todos os servidores têm a mesma capacidade. Caso contrário, é necessário definir os pesos dos servidores para que as máquinas com maior capacidade recebam mais solicitações. Consulte Definição de pesos quando os servidores não são idênticos abaixo.
Algumas métricas a serem verificadas durante os testes são:
- Carga de CPU e memória – Verifique a porcentagem da capacidade total utilizada tanto pela CPU quanto pela memória. Se a carga não estiver distribuída igualmente entre todos os servidores, o tráfego não estará sendo distribuído de forma eficiente.
- Tempo de resposta do servidor – Se o tempo for consistentemente maior para alguns servidores do que para outros, solicitações mais “pesadas” (que exigem mais processamento ou chamadas a um banco de dados ou a outros serviços) estão sendo direcionadas a eles de forma desequilibrada. Tente ajustar os pesos, pois o desequilíbrio pode ser causado por pesos incorretos, e não por um problema com a técnica de balanceamento de carga.
- Tempo total de resposta ao cliente – Novamente, tempos consistentemente mais altos em alguns servidores sugerem que eles estão recebendo uma parcela desproporcional de solicitações demoradas. Mais uma vez, você pode tentar ajustar os pesos para verificar se isso elimina o problema.
- Erros e solicitações com falha – Você precisa garantir que o número de solicitações com falha e outros erros durante os testes não seja maior do que o habitual para o seu site. Caso contrário, sua decisão estará sendo baseada em condições de erro, e não em tráfego realista. Para alguns erros, o servidor pode enviar a resposta mais rapidamente do que quando a solicitação é bem-sucedida. Por exemplo, no caso do código de resposta HTTP
404(Arquivonãoencontrado), o servidor provavelmente retorna o erro muito mais rapidamente do que conseguiria entregar o arquivo real, caso ele existisse. Com os algoritmos de balanceamento de carga Menor Número de Conexões e Menor Tempo, isso pode fazer com que o balanceador de carga favoreça um servidor que, na verdade, não está funcionando bem.
Prós, contras e casos de uso
Agora, vamos analisar as vantagens e desvantagens de cada técnica de balanceamento de carga e descrever alguns casos de uso para os quais elas são particularmente adequadas. Vamos abordá-las em ordem crescente de adequação à maioria dos casos de uso. Como uma breve prévia: consideramos Least Connections (e, no caso do NGINX Plus, Least Time) as melhores opções para a mais ampla variedade de casos de uso.
Hash e Hash de IP
As técnicas de balanceamento de carga Hash e IP Hash criam uma associação fixa entre um determinado tipo de solicitação do cliente (representado pelo valor de hash) e um servidor específico. Isso também é conhecido como persistência de sessão: todas as solicitações com um determinado valor de hash são sempre encaminhadas ao mesmo servidor.
A maior desvantagem desses métodos é que não há garantia de que eles distribuam as solicitações em quantidades iguais entre os servidores, muito menos de que equilibrem a carga de maneira uniforme. O algoritmo de hash divide uniformemente o conjunto de todos os valores de hash possíveis em “grupos”, um para cada servidor no grupo upstream, mas não há como prever se as solicitações que realmente ocorrerem terão hashes distribuídos de maneira uniforme. Suponha, por exemplo, que dez clientes estejam acessando um site e que o algoritmo IP Hash associe o hash de sete dos endereços IP ao servidor web1, o de um ao servidor web2 e os de dois ao servidor web3. O servidor web1 acaba recebendo mais que o dobro de solicitações dos outros servidores juntos.
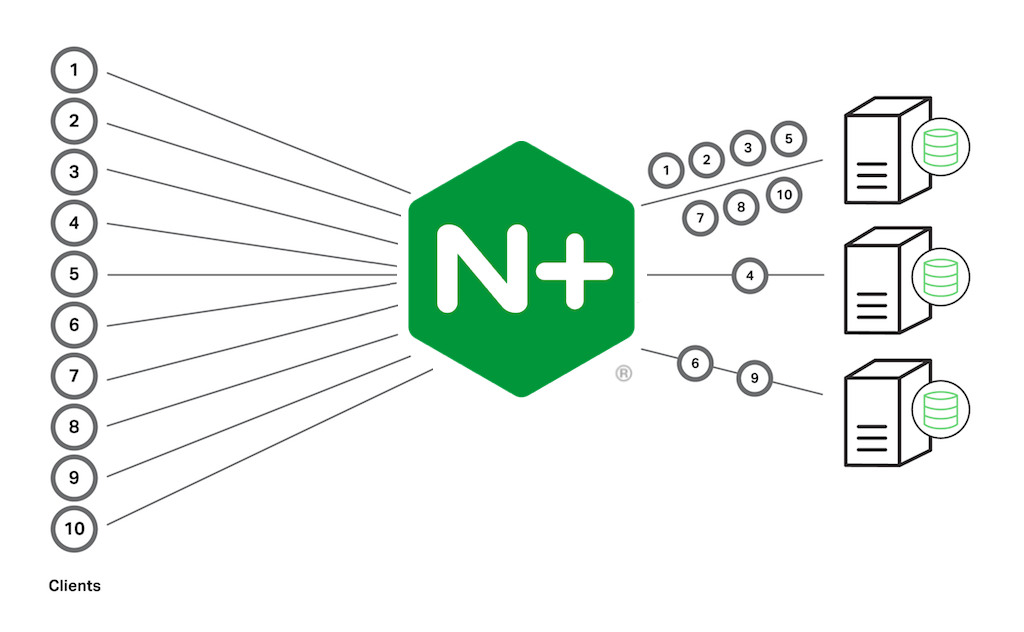
Portanto, faz sentido usar Hash ou IP Hash quando o benefício de manter as sessões supera os possíveis efeitos negativos de uma carga desbalanceada. Essas são as únicas formas de persistência de sessão disponíveis no NGINX. O NGINX Plus oferece outros três mecanismos de persistência de sessão mais sofisticados, que funcionam em conjunto com o balanceamento de carga propriamente dito (eles são configurados com a diretiva sticky). No entanto, mesmo com o NGINX Plus, você pode optar por Hash ou IP Hash, pois esses três mecanismos não funcionam nos seguintes casos:
- O navegador ou aplicativo cliente não aceita cookies, e o aplicativo não tem como usar os mecanismos de persistência de sessão sem cookies. Use o método IP Hash para associar cada cliente (mais especificamente, seu endereço IP) a um servidor específico.
- Você quer enviar sempre as solicitações de uma determinada URL para o mesmo servidor, a fim de aproveitar o cache no próprio servidor. Use o método Hash com a variável
$request_uripara buscar o arquivo sempre no mesmo servidor. Por exemplo, suponha que você saiba que disponibilizar um determinado arquivo .php exige várias chamadas demoradas ao banco de dados, mas os dados obtidos não mudam com frequência e, portanto, podem ser armazenados em cache. Se você direcionar todas as solicitações desse arquivo para o mesmo servidor, apenas o primeiro cliente enfrentará uma longa espera devido às chamadas ao banco de dados. Para todos os clientes seguintes, os dados serão recuperados rapidamente do cache. Outra vantagem é que apenas um servidor precisa armazenar esse conjunto específico de dados em cache. Como você evita armazenar os mesmos dados em cache de forma duplicada em todos os servidores, pode usar caches menores.
Há alguns casos em que o IP Hash — e o Hash quando o endereço IP do cliente faz parte da chave — não funcionam:
- Quando o endereço IP do cliente pode mudar durante a sessão, por exemplo, quando um cliente móvel alterna de uma rede Wi-Fi para uma rede celular.
- Quando as solicitações de um grande número de clientes passam por um proxy de encaminhamento, pois o endereço IP do proxy é usado para todos eles.
Os hashes são determinísticos (o algoritmo de hash produz sempre os mesmos resultados). Isso gera alguns efeitos colaterais positivos: todas as instâncias do NGINX Plus ou NGINX em uma implantação fazem o balanceamento de carga das solicitações exatamente da mesma maneira, e o mapeamento de hash para servidor persiste após as reinicializações do balanceador de carga. (Na verdade, ele é recalculado após a reinicialização, mas, como o resultado é sempre o mesmo, na prática ele persiste.)
Por outro lado, alterar o conjunto de servidores upstream geralmente força o recálculo de pelo menos alguns dos mapeamentos, interrompendo a persistência da sessão. É possível reduzir um pouco o número de mapeamentos recalculados:
- Para o método Hash, inclua o parâmetro
consistentna diretivahash; o NGINX Plus usa o algoritmo de hash ketama, o que resulta em menos remapeamentos. - Para o método IP Hash, antes de remover temporariamente um servidor do grupo upstream, adicione o parâmetro
downà diretivaservercorrespondente, como no caso de web2 no exemplo a seguir. Os mapeamentos não são recalculados, pois se pressupõe que o servidor voltará a operar em breve.
upstream backend {    ip_hash;

    server web1;
    server web2 down;
    server web3;
}
Round Robin
Como mencionado anteriormente, o Round Robin é o método de balanceamento de carga padrão no NGINX Plus e no NGINX. Isso certamente faz dele o método mais fácil de escolher — você não precisa configurar nada além do próprio grupo upstream.
O consenso geral é que o Round Robin funciona melhor quando as características dos servidores e das solicitações dificilmente farão com que alguns servidores fiquem sobrecarregados em relação a outros. Algumas dessas condições são:
- Todos os servidores têm aproximadamente a mesma capacidade. Esse requisito é menos importante se as diferenças entre os servidores forem representadas com precisão pelos pesos atribuídos a eles.
- Todos os servidores hospedam o mesmo conteúdo.
- As solicitações são bastante semelhantes em termos do tempo ou da capacidade de processamento de que precisam. Se houver uma grande variação no peso das solicitações, um servidor poderá ficar sobrecarregado caso o balanceador de carga acabe enviando a ele muitas solicitações pesadas em rápida sucessão.
- O volume de tráfego não é alto o suficiente para levar os servidores a operar perto da capacidade máxima com muita frequência. Se os servidores já estiverem sob carga elevada, é mais provável que a distribuição mecânica de solicitações do Round Robin leve alguns deles a ultrapassar o limite e ficar sobrecarregados, conforme descrito no item anterior.
O Round Robin é particularmente adequado para cenários de teste, pois garante que as solicitações sejam distribuídas entre todos os servidores em quantidades iguais (ou na proporção ponderada apropriada). Alguns outros métodos nem sempre distribuem o tráfego uniformemente quando o volume é baixo, o que pode distorcer os resultados dos testes.
A natureza uniforme da distribuição também pode revelar se os caches estão funcionando bem e em sua capacidade máxima: como não há como usar o Round Robin para enviar solicitações de um determinado arquivo sempre ao mesmo servidor, é provável que cada servidor acabe fornecendo e armazenando em cache uma grande variedade de arquivos (e, geralmente, muitos dos mesmos arquivos que os demais servidores), o que aumenta a probabilidade de o cache ficar cheio.
Por fim, a distribuição inicial uniforme ajuda a identificar problemas de persistência de sessão no NGINX Plus (conforme configurado com a diretiva sticky).
Menor número de conexões e menor tempo
Como mencionamos acima, Least Connections é a técnica de balanceamento de carga mais adequada para a maior variedade de casos de uso, especialmente para o tráfego de produção. Isso é corroborado por relatos de nossos clientes. Seu desempenho é estável e previsível.
O algoritmo Menor Número de Conexões também distribui de forma eficaz a carga de trabalho entre os servidores de acordo com a capacidade de cada um. Um servidor mais potente atende às solicitações com mais rapidez e, portanto, em qualquer momento, provavelmente terá menos conexões ainda sendo processadas (ou até mesmo aguardando o início do processamento) do que um servidor com menor capacidade. O algoritmo Menor Número de Conexões encaminha cada solicitação ao servidor com o menor número de conexões ativas e, assim, tem maior probabilidade de encaminhar solicitações aos servidores mais potentes. (No entanto, a definição de pesos permite uma distribuição ainda mais eficiente das solicitações, conforme descrito em Definição de pesos quando os servidores não são idênticos abaixo.)
Você pode considerar o Least Time (somente no NGINX Plus) uma versão mais sensível do Least Connections. Ao incluir o tempo médio de resposta, ele leva em conta o histórico recente de desempenho do servidor (na verdade, trata-se de uma média móvel exponencialmente ponderada, portanto, os tempos de resposta mais antigos influenciam menos a média do que os mais recentes).
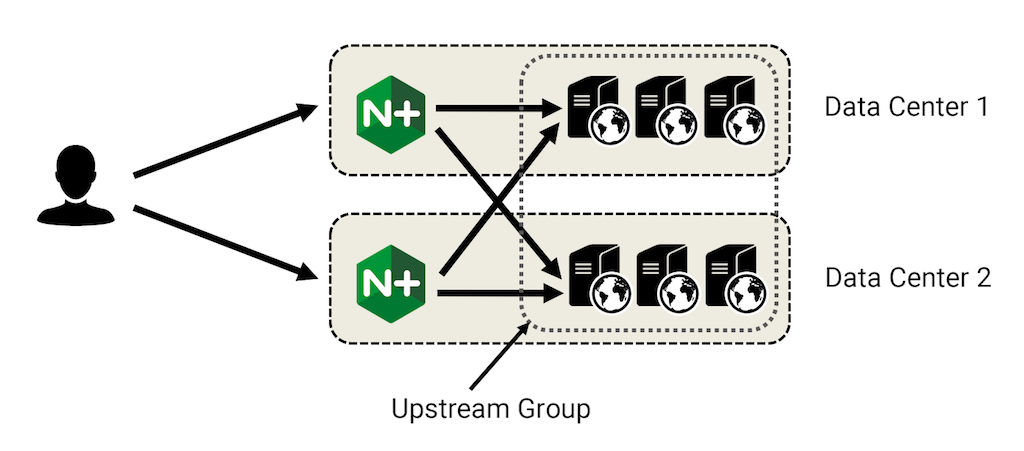
O método Least Time é particularmente adequado quando os servidores upstream apresentam tempos médios de resposta muito diferentes. Se, por exemplo, você tiver servidores em diferentes data centers para fins de recuperação de desastres, o Least Time tenderá a enviar mais solicitações aos servidores locais, pois eles respondem mais rapidamente. Outro caso de uso são os ambientes de nuvem, nos quais o desempenho dos servidores costuma ser bastante imprevisível.
Definindo pesos quando os servidores não são idênticos
Já mencionamos várias vezes a importância de definir pesos para os servidores quando os servidores do grupo upstream têm capacidades diferentes. Isso é particularmente importante para o balanceador de carga Round Robin, que, caso contrário, envia o mesmo número de solicitações a cada servidor. Isso provavelmente fará com que um servidor menos potente fique sobrecarregado, enquanto outro mais potente permanece parcialmente ocioso.
Para definir pesos, inclua o parâmetro weight em uma ou mais diretivas server no bloco upstream. O valor padrão é 1.
Você pode entender o efeito da definição de pesos para as diferentes técnicas de balanceamento de carga da seguinte maneira. Lembre-se de que as descrições estão conceitualmente corretas, mas a implementação no código do NGINX Plus não necessariamente usa as operações matemáticas indicadas. Este é o grupo upstream usado em nossos exemplos:
upstream backend {    server web1 weight=6;
    server web2 weight=3;
    server web3;
}- Round Robin – Cada servidor recebe uma porcentagem das solicitações de entrada igual ao seu peso dividido pela soma dos pesos. Em nosso exemplo, a cada dez solicitações, web1 recebe seis (60%), web2 recebe três (30%) e web3 recebe uma (10%).
- Hash e Hash de IP – Lembre-se de que, sem pesos, o algoritmo de hash divide uniformemente o conjunto de todos os valores de hash possíveis em “buckets”, um para cada servidor no grupo upstream. Com pesos, ele soma os pesos, divide o conjunto de hashes possíveis por esse número de buckets e associa cada servidor a uma quantidade de buckets equivalente ao seu peso. Em nosso exemplo, há dez buckets, cada um contendo 10% dos hashes possíveis. Seis buckets (60% dos hashes possíveis) estão associados ao web1, três buckets (30%) ao web2 e um bucket (10%) ao web3.
- Menor número de conexões e Menor tempo – Mencionamos anteriormente que, mesmo sem pesos, esses algoritmos são bastante eficazes na distribuição da carga de trabalho entre os servidores de acordo com a capacidade de cada um. A definição de pesos melhora ainda mais o desempenho deles nesse aspecto. Lembre-se de que os algoritmos Menor número de conexões e Menor tempo enviam cada solicitação ao servidor com a menor “pontuação” (respectivamente, o número de conexões ou uma combinação matemática de conexões e tempo). Quando você atribui pesos, o balanceador de carga divide a pontuação de cada servidor pelo respectivo peso e, novamente, envia a solicitação ao servidor com o menor valor. Veja um exemplo do algoritmo Menor número de conexões usando nossos pesos de exemplo e o número indicado de conexões ativas: a pontuação do web1, que é 100, é a menor, por isso ele recebe a solicitação, embora sua contagem de 600 conexões seja 1,5 vez maior que a do web2 e mais de 4 vezes maior que a do web3.
- web1 – 600 conexões ativas ÷ 6 = 100
- web2 – 400 conexões ativas ÷ 3 = 133
- web3 – 125 conexões ativas ÷ 1 = 125
Resumo
Após analisar os prós e os contras das técnicas de balanceamento de carga disponíveis no NGINX Plus e no NGINX, consideramos que o Least Connections (e, no caso do NGINX Plus, o Least Time) é o mais adequado para a maior variedade de casos de uso. No entanto, é importante testar vários métodos em sua implantação, pois a combinação específica de características de tráfego e de servidores pode fazer com que outro método seja mais adequado para você.
Para experimentar o balanceamento de carga do NGINX Plus, inicie sua avaliação gratuita de 30 dias hoje mesmo ou entre em contato conosco para conversar sobre seus casos de uso.
Gostaríamos muito de conhecer suas experiências com balanceamento de carga em diferentes casos de uso. Compartilhe-as na seção de comentários abaixo.
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.