Este post foi adaptado de uma apresentação de Kevin Reedy, da Belly Card, na nginx.conf, em outubro de 2014. Embora isso tenha ocorrido há alguns anos, o conteúdo continua muito relevante. Você pode assistir a uma gravação da apresentação no YouTube.
Sumário
0:00 Introdução Visão geral Aviso legal1:16 O que é a Belly? Stack da Belly1:44 Versão 0: A Era das Trevas2:04 Versão 1: Uma Nova Esperança2:35 Versão 2: Página inicial e API separadas Termo da moda do dia: arquitetura orientada a serviços! Habilitando a SOA NGINX substitui o ELB Configuração de upstream e servidor virtual Resultados4:43 Configuração com Chef Receitas Arquivos Templates Cookbooks6:49 Exemplo: Chef para NGINX Instalação, configuração e ajustes Roteamento do tráfego da API9:46 Exemplo prático de uso do Chef10:08 Versão 2: implantação de aplicativos10:40 Versão 3: SOA em tudo Então surgiu o Heartbleed SSL em tudo12:25 Versão 4: Docker Benefícios Implantação de contêineres15:45 Estratégias de implantação17:43 Opções de descoberta de serviços18:33 Arquitetura do Consul19:30 Recursos do Consul22:07 Consul Template Comando para iniciar o Consul Template Configuração do NGINX com o Consul Template Gerenciamento de configuração com o Consul Template24:35 Uso do Chef para implantar o Consul25:44 Dicas profissionais Pesquisa parcial do Chef DNS Como evitar configurações desatualizadas30:35 Perguntas36:31 Informações de contato
0:00 Introdução
Bom dia a todos. Meu nome é Kevin Reedy e trabalho para uma empresa chamada Belly Card, sediada em Chicago. Temos cerca de cem funcionários e vinte engenheiros. Hoje vou falar sobre como fazemos nosso balanceamento de carga, especificamente em uma infraestrutura dinâmica que está sempre mudando.
0:21 Visão geral
Então, primeiro vou contar a vocês como nossa pilha de infraestrutura evoluiu ao longo do tempo, começando pela versão 0, que chamo de Idade das Trevas. Em seguida, veremos como usamos o Chef para configurar o NGINX. Depois disso, falaremos sobre como deixamos essa abordagem de lado e passamos a usar dados de uma plataforma de descoberta de serviços chamada Consul para configurar o NGINX. Se o tempo permitir, tenho algumas dicas profissionais sobre a configuração do NGINX, especialmente no que diz respeito ao gerenciamento de configurações.
0:49 Aviso
Então, embora eu vá falar com vocês sobre o Chef e o Consul, quero deixar claro que nada nesta palestra é específico a essas ferramentas. Chef, Puppet, Ansible, Salt, CFEngine e todas as demais são ótimos produtos, e vocês deveriam usar um deles. Gostamos do Chef, e tenho certeza de que muitas outras pessoas também gostam.
O mesmo vale para a descoberta de serviços. Consul, etcd e ZooKeeper são excelentes, então use o que funcionar melhor para você.
1:16 O que é o Belly?
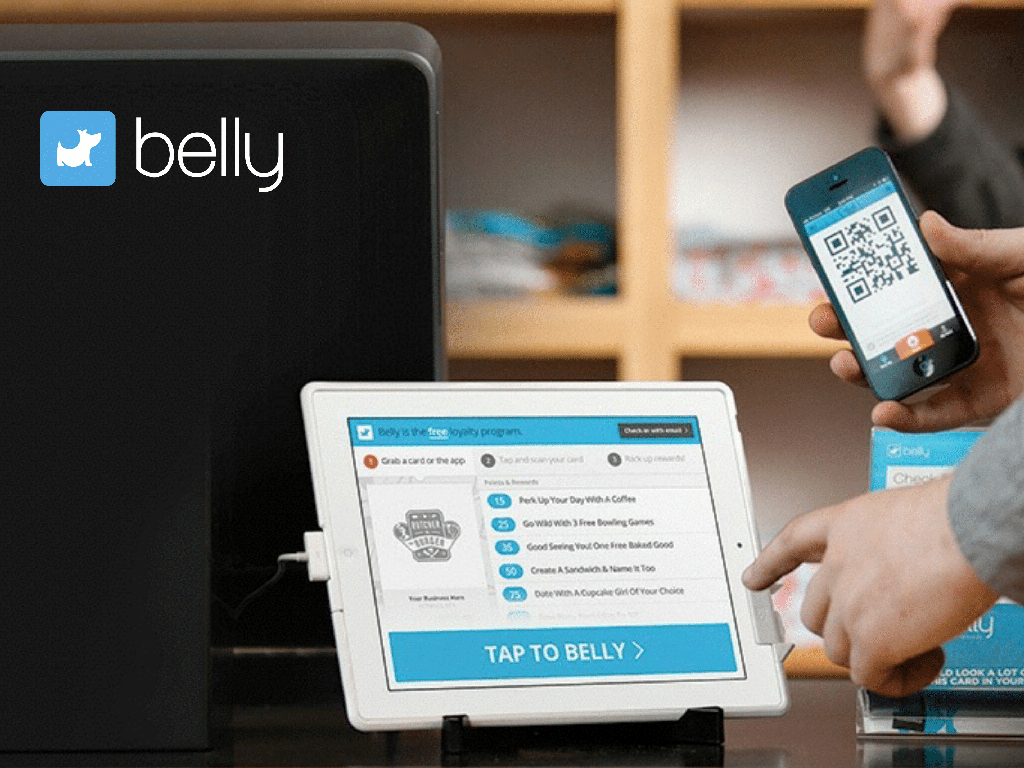
O que é o Belly? Basicamente, é uma versão digital do cartão de fidelidade de uma cafeteria, no qual você compra dez bebidas e ganha uma grátis. Colocamos um iPad no estabelecimento, os clientes fazem a leitura usando o celular ou um cartão físico com um código QR, nós acompanhamos os pontos, concedemos as recompensas e ainda criamos ferramentas de marketing com base nisso.
1:36 A stack da Belly
Mas não estou aqui para falar com vocês sobre a belly como empresa. Se tiverem interesse nisso, basta acessar nosso site. Vou falar sobre nossa stack de infraestrutura.
1:44 Versão 0: A Era das Trevas
Então, a versão 0. Na época em que havia três desenvolvedores, antes de eu trabalhar lá, o Belly era uma aplicação monolítica em Ruby on Rails, o que significava que todas as chamadas de API e todas as partes do nosso site eram direcionadas para uma única aplicação Rails. Ela usava MySQL, MongoDB e Memcached como infraestrutura de dados, e nós a implantávamos no Heroku, que é um ótimo lugar para começar.
2:04 Versão 1: Uma Nova Esperança
Então, versão 1 – Uma Nova Esperança. Decidimos que o Heroku não atenderia mais às nossas necessidades, então começamos a fazer deploy usando uma ferramenta chamada Capistrano, que é essencialmente algo “melhor do que um script de shell”, escrito em Ruby. Ela ajuda você a fazer deploy de aplicações.
Tínhamos cerca de seis servidores no Amazon Web Services EC2. Esse era um número fixo, mas nós o aumentávamos quando sabíamos que algo grande estava para acontecer e o reduzíamos novamente quando necessário. À frente deles, tínhamos o AWS Elastic Load Balancer.
2:35 Versão 2: Página inicial e API separadas
Então, surgiu um projeto em que queríamos separar nossa página inicial do restante da API. Queríamos fazer isso para agilizar o desenvolvimento da página inicial e permitir que diferentes desenvolvedores trabalhassem nela.
2:47 Palavra da moda do dia: arquitetura orientada a serviços!
A grande palavra da moda na época — e ainda hoje — é arquitetura orientada a serviços.
2:50 Implementar SOA
Então, a versão 2 da nossa stack foi criada para viabilizar uma arquitetura orientada a serviços. Nosso primeiro plano era separar a página inicial da API. Parece bem simples: basta termos www.bellycard.com e api.bellycard.com.
Mas acabou sendo algo realmente complexo e nada simples, porque alguns dos nossos aplicativos móveis tinham sido programados de forma estática para usar www.bellycard.com/api e /api‑assets. Nossos provedores de e-mail e todos os links de clique que já haviam sido enviados por e-mail às pessoas usavam /eo para “abertura de e-mail” e /ec para “clique no e-mail”. Nosso aplicativo do Facebook estava configurado para usar /facebook/callback.
3:28 NGINX substitui o ELB
Isso significava que o AWS Elastic Load Balancer já não nos oferecia a flexibilidade necessária para direcionar esse tráfego a diferentes aplicações. Foi então que o NGINX veio salvar o dia. Mais especificamente, podíamos ter vários upstreams e regras de reescrita para direcionar o tráfego às nossas diferentes aplicações.
3:44 Configuração de upstream e servidor virtual
Neste exemplo bastante básico, definimos um bloco upstream com seis servidores para a API e um bloco com dois servidores para a página inicial.
Há também dois blocos server [que definem servidores virtuais]. Em um deles, escutamos as requisições para api.bellycard.com e direcionamos todo esse tráfego aos servidores da API. No outro, escutamos as requisições para www.bellycard.com e direcionamos o tráfego conforme necessário.
Resultados de 4:02
Isso funcionou muito bem. Permitiu que nossos desenvolvedores avançassem rapidamente. Nossa equipe de frontend estava trabalhando em um projeto sem ficar bloqueada pela nossa API. Então, implantamos um terceiro serviço. Acredito que fosse para integração com o Passbook da Apple. Depois, veio um quarto — transferimos para ele todas as nossas funcionalidades do Facebook. O quinto foi criado para lidar com os eventos dos usuários em nosso site.
Então alguém decidiu que seria uma ótima ideia escrever aquilo em Node.js, e assim passamos a ter cinco serviços distintos em duas linguagens. Todos eram implantados de forma independente, sem muito gerenciamento de configuração, e editávamos o NGINX manualmente, que é como tenho certeza de que muita gente começa.
4:43 Configuração com o Chef
Precisávamos de uma maneira melhor de dimensionar esse processo, então fizemos isso com o Chef.
O Chef é um conjunto de ferramentas de gerenciamento de configuração. Ele foi escrito em Ruby, e você pode escrever o gerenciamento de configuração propriamente dito em Ruby, o que o torna excelente para desenvolvedores. learnchef.com é um recurso incrível para aprender sobre o Chef; ele pode ensinar muito mais sobre o Chef do que eu conseguiria em 45 minutos.
No entanto, vou abordar alguns conceitos básicos só para garantir que todos estejamos na mesma página.
Receitas de 5:17
O primeiro tipo de componente básico do Chef é uma receita. O Chef usa vários nomes criativos, como faca para uma ferramenta e receita, e tudo fica em um livro de receitas. Isso torna tudo mais divertido e fácil de entender, além de criar uma ótima metáfora, mas também dificulta muito pesquisar qualquer coisa no Google.
Então, esta é a receita mais básica que consegui imaginar. Instale o pacote nginx e inicie e habilite o serviço nginx.
5:56 Arquivos
Você também pode ter recursos de arquivo. Por exemplo, quero gravar o conteúdo Hello World! no arquivo /usr/share/NGINX/html/index.html.
6:08 Modelos
Você também pode incorporar isso a um sistema de templates. Aqui, tenho duas variáveis: g e w, que correspondem a Hello e Kevin, e posso passar essas variáveis para um arquivo de template no formato ERB (um script de templates do Ruby).
Assim, em vez de simplesmente escrever o conteúdo manualmente, podemos criar um modelo para definir a leitura e quem deve ser cumprimentado.
6:19 Livros de receitas
O último grande componente é um cookbook, que consiste em uma coleção de receitas, arquivos e modelos. Ele também inclui recursos, provedores e bibliotecas, que são elementos mais complexos. Há inúmeros cookbooks de código aberto e de outros tipos disponíveis em https://supermarket.getchef.com, incluindo cookbooks para NGINX, MySQL, Java, apt e yum, e até mesmo para gerenciar seus arquivos ssh_known_hosts. Praticamente todos os principais componentes necessários para o que você pretende fazer no gerenciamento de configurações já podem ser encontrados em um cookbook.
6:49 Exemplo: Chef para NGINX
Vamos ver um exemplo bem rápido de uso do NGINX com o Chef, no qual instalaremos o NGINX e o configuraremos alterando algumas variáveis. Usaremos o Chef para descobrir onde nossa aplicação está sendo executada e, em seguida, configuraremos o NGINX para direcionar o tráfego para ela.
7:14 Instalação, configuração e otimização
Então, neste exemplo, a primeira coisa que fazemos é definir alguns atributos do nó. Para cada nó, você pode definir valores de atributos anexando um documento JSON. Vamos usar um cookbook de terceiros para NGINX que procura as configurações desses atributos. Estamos definindo worker_connections com um determinado valor, a diretiva worker_rlimit_nofile, o tipo de event que usaremos no NGINX e até mesmo client_max_body_size.
Depois disso, incluímos duas receitas do cookbook do NGINX. A primeira é nginx::repo, que configura um repositório apt ou yum, dependendo do seu sistema operacional. Em seguida, [a receita nginx] instala o NGINX. Você também pode instalar o NGINX a partir do código-fonte, mas usar pacotes é mais rápido.
Em seguida, aproveitamos os recursos de busca do Chef. Ao executar o Chef, você pode executá-lo como um agente na máquina ou no modo solo, que basicamente funciona como um script. Quando há um agente em uma máquina, você pode consultar o servidor Chef para buscar nós e outros atributos.
Aqui, estamos pedindo ao Chef que nos forneça uma lista de todos os nós que têm a receita belly‑api associada a eles. Depois disso, geramos, a partir de um template, um arquivo de site chamado /sites‑enabled/api. A origem dele é o template [arquivo chamado api.erb que] mostrarei a seguir. As variáveis que passamos são os nós que pesquisamos logo antes.
A última novidade aqui é uma instrução notifies para recarregar o serviço nginx. Isso indica que, sempre que este template for alterado, esse serviço deverá ser recarregado.
8:54 Roteando o tráfego da API
Então, nosso arquivo de modelo aqui é bem simples. Temos um upstream chamado api e, no ERB, iteramos por todos os servidores que passamos como uma variável, especificando cada servidor pelo endereço IP e pela porta 8080. Incluímos até mesmo um comentário com o nome do servidor. Quando um operador estiver tentando entender o que está acontecendo com esse serviço, esse comentário será útil.
Também definimos um bloco server para escutar em api.bellycard.com. Eu simplesmente encaminho todo o tráfego para o upstream api.
9:46 Exemplo real com Chef
Também quero apresentar um exemplo do mundo real. Talvez esteja pequeno demais para vocês conseguirem ler, mas dá para ter uma ideia de como as receitas do Chef podem ficar complexas. Este é o template e a receita reais usados atualmente em alguns dos nossos servidores de produção.
10:08 Versão 2: Implantação de aplicativos
Agora, voltando à nossa stack. Eu disse que tínhamos implantado cerca de cinco aplicações e que tudo estava indo muito bem. Passamos a ter uma forma de direcionar o tráfego para elas, então nossos desenvolvedores aproveitaram a oportunidade e, hoje, já temos cerca de 40 aplicações Ruby implantadas em nossos servidores usando o Chef. O tráfego é direcionado de forma totalmente dinâmica usando o NGINX.
Nossos desenvolvedores não precisam fazer praticamente nada além de editar uma receita para incluir o nome do novo serviço. Todo o tráfego é roteado pelo NGINX e configurado dinamicamente com o Chef.
10:40 Versão 3: SOA em Tudo
Também tínhamos cerca de dez aplicações JavaScript de frontend que eram apenas arquivos estáticos, implantados no S3 com uma CDN, o [Amazon] CloudFront, à frente. Disponibilizávamos o arquivo index.html diretamente pelo bucket do S3, e os demais recursos pelo CloudFront. Também tínhamos cerca de outros cinco aplicativos que os desenvolvedores simplesmente enviaram para o Heroku porque eram projetos pontuais que acabaram entrando em produção sem que ninguém fosse realmente informado.
11:10 Então aconteceu o Heartbleed
[Os cinco aplicativos no Heroku] ficavam separados — completamente fora da nossa infraestrutura — até um belo dia de abril, quando a vulnerabilidade Heartbleed foi anunciada. Muita gente entrou em pânico. Heartbleed era uma vulnerabilidade no OpenSSL que permitia que pessoas potencialmente extraíssem suas chaves privadas.
Como usamos o Chef, conseguimos atualizar a infraestrutura do OpenSSL em todos os nossos servidores assim que uma correção ficou disponível. Acredito que ela tenha sido implantada em toda a nossa infraestrutura em cerca de 20 minutos. No entanto, a AWS (e, consequentemente, o Heroku) levou cerca de 24 horas para corrigir seus Elastic Load Balancers.
Isso nos levou a transferir todo o nosso balanceamento de carga e encerramento de SSL para o NGINX, independentemente de onde estivesse implantado – tanto no S3 quanto no Heroku. Isso acarreta uma pequena perda de desempenho, mas, pelo menos naquele dia de abril, valeu a pena para nós.
11:57 SSL em tudo
Assim, a versão 3 da nossa stack deixou de ser “SOA em tudo” e passou a ser “SSL em tudo”. Todo o tráfego para bellycard.com e seus subdomínios passa pelos nossos balanceadores de carga. Na prática, nossos recursos ainda são fornecidos pelo CloudFront em outro domínio para melhorar o desempenho. Não queremos a sobrecarga do SSL e, além disso, temos apenas um data center na Costa Leste.
12:25 Versão 4: Docker
Versão 4 – a palavra da moda de que todos estão falando este ano é Docker. Desde quando o Docker estava, se não me engano, na versão 0.5, nossos desenvolvedores já estavam ansiosos para começar a usá-lo.
12:38 Benefícios
Os motivos [para usar o Docker] são simples.
Isso simplifica muito a implantação de aplicações. Não é preciso escrever receitas. Você não precisa se preocupar com a forma de compilar os assets. Não importa se você está desenvolvendo sua aplicação em Ruby enquanto outra pessoa desenvolve a dela em Python.
Essencialmente, isso separa as responsabilidades de Desenvolvimento e Operações. Seus desenvolvedores podem se preocupar com o código, quais bibliotecas usar e até mesmo quais pacotes Linux instalar. A equipe de Operações pode se preocupar com questões como: onde vou implantar isso? Como vou capturar os logs? Como vou monitorar isso? Depois que esses problemas operacionais forem resolvidos, qualquer aplicação funcionará, independentemente da linguagem em que foi escrita.
Uma vantagem adicional é que isso permite que nossos desenvolvedores iniciem facilmente os serviços dos quais dependem em seus próprios laptops. Como mencionei, já temos cerca de 55 aplicações diferentes, muitas das quais agora estão em contêineres Docker.
Digamos que você esteja trabalhando em um novo serviço para enviar campanhas de e-mail. Ele depende do serviço de e-mail. Então, na sua máquina de desenvolvimento, normalmente você baixaria o código, executaria bundle install, iniciaria o serviço em segundo plano e pensaria: “ah, mas, na verdade, ele depende de outro serviço, o serviço de usuários”.
Esse serviço depende de uma coisa, que por sua vez depende de outra. Então, na verdade, o novo serviço de campanhas de e-mail depende de cerca de cinco outros serviços, além de MySQL, Elasticsearch, Redis, e a lista continua.
Com o Docker, podemos criar esses contêineres usando as mesmas receitas do Chef que utilizamos em produção e disponibilizar aos nossos desenvolvedores contêineres que eles podem baixar com extrema rapidez.
Assim, isso agiliza a implantação e o desenvolvimento.
14:23 Implantação de contêineres
Então, na versão 4, deixamos de implantar nossos aplicativos usando o Chef e passamos a implantá-los em contêineres. Há inúmeras soluções para fazer isso, e tenho certeza de que surgirão ainda mais.
A primeira opção é o CoreOS e o Fleet. O CoreOS é um sistema operacional Linux enxuto que executa um mecanismo de descoberta de serviços chamado etcd. O Fleet permite definir coisas como: “Quero um contêiner em execução em cinco instâncias e não quero que ele seja executado nas mesmas máquinas que este outro serviço”.
Há outra chamada Deis, que é semelhante ao Heroku por ter uma interface de Git Push. Há também o Mesos, da Apache, e o Kubernetes, do Google; o Flynn é outra opção que surgiu recentemente. Na verdade, desenvolvemos nossa própria solução porque, quando iniciamos essa jornada, a maioria dessas ferramentas ainda não estava em um estágio em que pudéssemos usá-las.
O nosso se chama Jockey e tem funcionado muito bem porque nosso processo de implantação segue convenções bastante rígidas. O melhor do Docker é que ele basicamente fornece um conjunto de APIs comuns para conteinerização. Não precisamos nos preocupar com muitas das coisas que teríamos de considerar se estivéssemos usando apenas os contêineres LXC do Linux.
Planejamos disponibilizá-lo como código aberto, mas, como mencionei, nosso processo de implantação segue diretrizes bem específicas, e o que funciona para nós pode não funcionar para você.
15:45 Estratégias de implantação
Além disso, nossa estratégia de implantação mudou um pouco quando migramos para o Docker. Antes, fazíamos implantações sem tempo de inatividade, instalando uma nova versão da aplicação no mesmo local. Isso significa que, se tivéssemos aquele serviço de fax para usuários em quatro máquinas, usaríamos o Chef para baixar a nova versão, instalá-la sobre [a versão antiga] e, em seguida, enviar um sinal ao servidor web para recarregar. O Unicorn é um excelente mecanismo Ruby para fazer isso.
No entanto, os contêineres são imutáveis. Depois que um contêiner está em execução, se você quiser criar uma nova build, deverá criar um novo contêiner. É possível se conectar a ele, executar comandos adicionais e depois salvá-lo — mais ou menos como você faria no Git. Mas, para realmente aproveitar ao máximo o Docker, seu contêiner deve ser completamente imutável.
Isso significa que tivemos que encontrar uma nova estratégia de implantação, pois não podemos mais fazer implantações no ambiente existente. Há algumas opções disponíveis. A implantação blue-green é uma delas e é bastante interessante. Nesse modelo, se você tiver uma aplicação em execução em quatro máquinas, você a coloca em funcionamento em outras quatro máquinas e configura o balanceador de carga para direcionar o tráfego para as novas máquinas. Depois de confirmar que tudo está funcionando conforme o esperado, você pode desativar o ambiente blue, e o ambiente green passa a ser o novo blue. A Amazon oferece ferramentas excelentes para fazer isso com a AWS.
Também há implantações “canário”, nas quais implanto uma versão em uma nova máquina, monitoro-a e, se ela passar nas verificações de métricas e de integridade, posso dar continuidade à implantação.
A diferença com os contêineres aqui é que você realmente vai desativá-los e criar novos, então precisa de algum tipo de sistema para rastrear a localização de cada aplicação em execução na sua infraestrutura.
Na verdade, o Chef está começando a se tornar uma ótima maneira de fazer isso. Há um cookbook chamado Chef Metal que está sendo incorporado e permite tratar os contêineres como qualquer outro recurso da sua infraestrutura do Chef.
17:43 Opções de descoberta de serviços
Há também a descoberta de serviços. ZooKeeper é uma ferramenta muito popular, usada em todo o Hadoop. A [Airbnb] tem um ótimo produto chamado SmartStack, que permite fazer implantações e acompanhá-las no ZooKeeper.
Eu mencionei o etcd, que é essencialmente um armazenamento distribuído de chave-valor com uma interface REST. Isso é ótimo em comparação com o ZooKeeper, que funciona mais como uma biblioteca cliente Java, porque agora você pode se comunicar com o etcd a partir de qualquer um dos seus aplicativos. Muitas dessas soluções de Plataforma como Serviço de código aberto que mencionei anteriormente – como Deis, Flynn e até o Kubernetes do Google – usam o etcd. Se você usa o CoreOS, o etcd já está disponível e integrado.
Surgiu outra opção, também baseada em REST, chamada Consul. Ela foi lançada pelo pessoal da HashiCorp, que desenvolve o Vagrant, o Packer e várias outras ferramentas incríveis. Na verdade, decidimos usar o Consul.
18:33 Arquitetura do Consul
Este é um diagrama dos conceitos mais básicos do Consul. Como você pode ver, há vários data centers, cada um com três servidores. No Data Center 1, também há clientes. O interessante é que, entre os agentes de servidor, um agente principal é eleito, e todos os clientes têm conhecimento não apenas de todos os servidores, mas também de todos os outros clientes. Em seguida, eles usam um protocolo de gossip para se comunicar com todos os outros agentes.
Isso me lembra um antigo comercial da AT&T em que você conta para dois amigos, que contam para outros dois amigos, que por sua vez contam para mais dois, e assim a mensagem se espalha por toda a sua rede de nós. [Editor – Bem, quase: era um comercial do xampu Faberge Organics.] Isso contrasta com o etcd ou o ZooKeeper, nos quais você basicamente tem apenas agentes de servidor, aos quais seus clientes se conectam.
Na abordagem do Consul, você executaria um cliente Consul em praticamente todos os servidores, em todos os lugares onde implantamos o Docker e onde executamos nossos balanceadores de carga. Assim, você sempre pode se comunicar com essa API no localhost, pela porta 8500.
19:30 Recursos do Consul
Assim como o etcd, o [Consul] é um armazenamento distribuído de chave-valor. Você pode definir e obter chaves, e ele manterá a linearizabilidade para garantir que elas sejam sempre consistentes. Há algumas ressalvas, mas a documentação deles sobre onde esses problemas ocorrem é excelente. No entanto, ao contrário do etcd, eles tratam a descoberta de serviços como um recurso de primeira classe.
Além de simples pares de chave-valor, você também pode registrar serviços, como uma API. Ao registrar um serviço, você informa ao Consul em qual nó ele está sendo executado. Isso significa que, quando implantamos um contêiner, também instruímos o Consul a registrar a API desse serviço nesse host.
Além disso, o Consul conta com verificações de integridade distribuídas, permitindo definir verificações de integridade no estilo do Nagios diretamente na sua plataforma de descoberta de serviços. Ao consultar o Consul, você pode solicitar uma lista de todos os locais onde o serviço de API está em execução. É possível enviar um sinalizador para “todos”, “somente os aprovados” ou “somente os que apresentam problemas”.
Ele também oferece suporte a vários data centers. Mencionei que você deve executar esse cliente do Consul em todos os lugares. Ao iniciá-lo, você passa um parâmetro que especifica o data center. Se você tiver um Data Center Leste e um Data Center Oeste, poderá consultar seu cliente local do Consul sem precisar saber em qual data center ele está, solicitando um endereço ou algo do tipo.
Na verdade, usamos o data center como uma divisão entre nossos ambientes de staging e produção. A configuração de uma aplicação em staging poderia dizer: “informe onde está o MySQL.services.consul”. Independentemente de ele estar sendo executado em um nó de staging ou de produção, você receberá o valor correto sem precisar saber qual é o data center nem qual é o ambiente.
Outra grande vantagem dele (e também do etcd) é que sua interface HTTP oferece long polling. Isso significa que você pode fazer uma consulta e solicitar uma lista de todos os servidores que estão executando esse serviço, além de manter a conexão aberta por 60 segundos e ser notificado imediatamente caso algo mude. O tempo de polling pode chegar a até 10 minutos. Assim, você pode receber notificações instantâneas sobre qualquer alteração na sua infraestrutura.
A outra coisa que já mencionei é que você pode criar a capacidade de escalar horizontalmente seus agentes mantendo clientes em todos os lugares. Isso é ótimo porque você sempre pode se comunicar com o localhost.
A grande questão, porém, é: agora que tenho esses dados em uma plataforma distribuída de descoberta de serviços, como configuro o NGINX a partir deles?
22:07 Consul Template
Felizmente, existe uma ferramenta chamada Consul Template. Ela foi lançada literalmente ontem, o que me fez alterar os slides de hoje deste ponto em diante. Antes, ela se chamava “Consul HAProxy”, um nome péssimo, porque, na verdade, não era específica para o HAProxy.
O Consul Template oferece uma interface muito simples para criar templates que acompanham alterações nos serviços, nas verificações de integridade desses serviços e até mesmo em um armazenamento de chave-valor. Assim, você pode armazenar configurações como [o número de] workers do NGINX no armazenamento de chave-valor e gerar novamente sua configuração quando esse valor mudar.
O principal recurso aqui é gerar arquivos a partir de modelos, o que parece muito semelhante ao que fazíamos antes com o Chef. A maior diferença é que ele usa a linguagem de templates do Golang em vez do ERB, que é do Ruby. Ao alterar um arquivo, você pode, opcionalmente, executar um comando em resposta à alteração, por exemplo, service nginx reload.
22:59 Comando para iniciar o Consul Template
Então, aqui está um exemplo de como executar o Consul Template pela linha de comando. Você o direciona para o host real do Consul, que, neste caso, é consul‑prod.example.com. Em um ambiente de produção real, eu recomendaria executar o Consul em todos os lugares e se conectar ao localhost.
Em seguida, você informa um arquivo de modelo, que é um template do Golang. No nosso caso, estamos informando /etc/consul‑templates/api. Depois, você informa em qual arquivo a saída deve ser gravada; no nosso caso, /etc/NGINX/sites‑enabled/api. Por fim, o comando a ser executado: service nginx reload.
23:32 Configuração do NGINX com o Consul Template
O template do Consul é muito parecido com um slide que mostrei anteriormente, mas, em vez de ERB, ele usa Golang. Então, definimos dois upstreams aqui. Um se chama api e o outro se chama homepage. Temos uma instrução range para a API do serviço, além de variáveis integradas para obter o IP e a porta em que esse serviço está realmente sendo executado.
23:54 Gerenciamento de configuração com o Consul Template
O melhor do Consul Template e de usá-lo dessa forma é que a convergência das alterações nos serviços é rápida. Antes de começarmos a implantar com o Docker, o Chef era executado a cada 5 ou 10 minutos, dependendo da máquina. Isso era rápido o suficiente para nós, pois fazíamos as implantações no próprio ambiente.
Agora que estamos criando um sistema de implantação mais avançado, precisamos ser notificados dessas alterações em questão de segundos, e não de minutos. Na verdade, recebemos essas notificações em milissegundos — em média, provavelmente cerca de 200 milissegundos.
No entanto, o gerenciamento de configuração ainda é necessário para gerar modelos. Não podemos simplesmente substituir o Chef pelo Consul. Ainda precisamos definir como vamos implantar o Consul, o Consul Template e tudo mais.
24:35 Usando o Chef para implantar o Consul
Na verdade, estamos usando templates do Chef para implantar nossos templates do Consul, o que parece um pouco complicado. Primeiro, em nossa receita do Chef, consultamos nosso host do Consul para obter uma lista de todos os serviços. Em seguida, geramos um template do Consul [com as instruções template e source] e informamos os locais do certificado SSL e da chave, e recarregamos o consul‑template. [Editor – o Sr. Reedy inicialmente se referiu ao consul‑haproxy, que aparece na primeira notifies instrução do slide. Em seguida, ele se corrigiu e esclareceu que o slide é anterior ao lançamento do Consul Template.]
Também geramos um arquivo de configuração para o Consul Template e passamos [variáveis que especificam] o host do Consul, a origem, o destino e o comando de recarga. Esse é realmente o cerne de como usamos o Chef e o Consul em conjunto para obter atualizações instantâneas nas nossas configurações do NGINX.
25:44 Dicas profissionais
A seguir, tenho algumas dicas profissionais sobre a configuração do Chef, do Consul e do NGINX em geral.
25:52 Pesquisa parcial do Chef
A primeira dica é: se você usa a busca do Chef para descobrir onde seus serviços estão sendo executados, vale a pena conhecer a busca parcial do Chef. O problema da busca do Chef é que ela cria uma cópia do nó inteiro, incluindo todos os atributos. Se você salvar muitas informações nos atributos do nó, terá que transferi-las pela rede ao se comunicar com o servidor Chef e também armazená-las na memória.
Se a busca do Chef retornar centenas ou milhares de servidores, é fácil perceber como sua receita pode ficar sem memória. A busca parcial permite retornar apenas as chaves relevantes para você.
Por exemplo, primeiro tínhamos
nodes = search(:node, 'recipe:belly-api')Essa busca retorna absolutamente todas as informações sobre cada objeto. Isso inclui informações sobre espaço em disco, RAM, CPU e todos os aplicativos que gravaram seus próprios atributos de nó.
Em vez disso, podemos usar a pesquisa parcial, criando um novo hash chamado search_keys e fornecendo a ele uma lista das chaves que nos interessam — neste caso, apenas o nome e o endereço IP. Em seguida, usamos uma API muito semelhante chamada partial_search e passamos o parâmetro adicional [keys].
26:53 DNS
O segundo problema que enfrentamos quando passamos a usar balanceamento de carga na frente do S3 e do Heroku foi que o NGINX usa o DNS para resolver os nomes de host nos blocos upstream somente quando a configuração é recarregada. Isso significa que, se você configurar um servidor upstream como s3.amazonaws.com ou anything.herokuapp.com e o endereço mudar, seu balanceador de carga não saberá qual é o novo endereço IP até a próxima recarga.
A forma que encontramos de contornar isso foi fazer a resolução de DNS no Chef e, quando houver alguma alteração, acionar o recarregamento do NGINX. Isso levou a um segundo problema: [a ordem dos endereços em uma resposta de DNS] nem sempre é a mesma, portanto, certifique-se também de ordenar a resposta antes de inseri-la no seu template.
27:36 Evitando configurações desatualizadas
O outro problema quando você começa a implantar uma grande quantidade de serviços é evitar configurações desatualizadas. [Editor – O Sr. Reedy interrompe brevemente a apresentação para responder a uma pergunta da plateia.] No Apache, no NGINX e em outros sistemas UNIX, um padrão comum de configuração é ter uma pasta conf.d e carregar tudo a partir dela. Portanto, se eu implantar os serviços A, B e C, crio os arquivos service-a.conf, service-b.conf e service-c.conf.
Então, decido substituir o serviço B pelo D e agora tenho quatro configurações na pasta de configuração do NGINX, mas o serviço B não existe mais. Isso pode acabar gerando conflitos entre B e D, pois eles têm nomes de host semelhantes.
No passado, tentamos fazer isso [remover configurações obsoletas] de duas maneiras. Com os templates, é possível adicionar uma função :delete, mas isso rapidamente se tornou difícil de gerenciar. Basicamente, tínhamos uma lista de serviços antigos que sempre tentávamos excluir caso existissem. Essa abordagem não era muito escalável.
Outra coisa que você pode fazer é renderizar todas as configurações dos seus sites em um único arquivo. Muitas pessoas chamam isso de “elevar a idempotência”. Basicamente, em vez de ter uma configuração do NGINX que carrega dados de várias fontes, coloque tudo no seu arquivo nginx.conf.
Isso realmente torna as coisas um pouco difíceis de gerenciar quando você acessa a máquina, mas esperamos estar chegando ao ponto em que não seja mais necessário solucionar problemas em um arquivo de configuração diretamente no ambiente de produção. Se isso ainda for um pouco difícil de gerenciar nas suas receitas do Chef, o que fazemos é usar um único arquivo nginx.conf que carrega uma série de sites diferentes. Por exemplo, um dos nossos arquivos de configuração de sites lista cerca de 30 serviços; depois, temos um para o Heroku, outro para todos os serviços do S3 e assim por diante.
Portanto, se você renderizar todas as configurações dos seus sites em um único arquivo ou em poucos arquivos, não precisará se preocupar em fazer a limpeza depois. Se, do ponto de vista do Chef, um serviço deixar de existir, o Chef simplesmente deixará de renderizá-lo no arquivo propriamente dito.
30:35 Perguntas
P: Como tem sido sua experiência com o Consul até agora?
R: Nós adoramos o Consul, e o que eu realmente gosto nele, em comparação com algo como o etcd, é que há serviços que continuam sendo desenvolvidos sobre ele. Não preciso me preocupar com a descoberta de serviços. Na verdade, se você tiver aplicações legadas e implantar, digamos, seus servidores MySQL usando o Consul, ele também oferece uma interface DNS.
Sua aplicação não precisa ter conhecimento do Consul; ela pode simplesmente consultar “qual endereço obtenho de mysqldb.services.consul?”. Nesse caso, o Consul é o servidor DNS. Você configura sua infraestrutura de DNS para que, se o TLD [domínio de nível superior] terminar em .consul, a consulta seja encaminhada ao Consul.
A escalabilidade tem funcionado muito bem para nós. Temos cerca de 3 nós em produção para os agentes de servidor e aproximadamente 60 clientes. Não tivemos nenhum problema. Eles continuam adicionando recursos sem comprometer a compatibilidade com versões anteriores, então as atualizações sempre foram muito tranquilas.
P: Você usa o NGINX Plus?
R: Não usamos. Analisamos essa possibilidade justamente para isso quando começamos a trabalhar com o Consul. Se não precisássemos de um sistema de templates, seria ótimo, pois poderíamos simplesmente ter um script que escutasse esse long polling HTTP e se comunicasse com a API do NGINX em seu nome. O único problema é que provavelmente também seria necessário um sistema de templates para o caso de o NGINX reiniciar. Assim, ele recarregaria imediatamente as configurações dos seus servidores upstream.
Outras pessoas também fizeram alguns trabalhos com NGINX Lua para consultar o Consul diretamente. Ainda não vi uma boa implementação, porque elas geralmente se enquadram em uma de duas categorias. Na primeira, o Consul é consultado a cada solicitação HTTP, o que é lento. Na segunda, os dados são carregados durante a configuração, e você acaba tendo o mesmo problema que ocorre com o DNS. Portanto, por enquanto, usar templates é a melhor opção, mas não me surpreenderia se, no futuro, surgisse uma maneira de fazer isso com NGINX Lua.
P: Você consideraria deixar de usar o Chef?
R: O Consul não oferece uma boa maneira nativa de manter esses templates, e já estamos implantando o NGINX com o Chef. A essa altura, nossas receitas relacionadas a isso têm centenas, se não milhares, de linhas, por causa de todas as outras coisas que fazemos com o NGINX, incluindo registro de logs, rastreamento e um pouco de OAuth. Não vejo a possibilidade de abandonarmos e substituirmos o Chef em nossa infraestrutura, mas ele é um ótimo complemento e uma boa maneira de receber notificações rapidamente.
P: Qual é a sobrecarga gerada pelo Chef?
R: Como a maioria das nossas máquinas executa uma única tarefa, a sobrecarga real do Chef é bem baixa. O uso de RAM é baixo enquanto ele está ocioso. Na verdade, ele fica aguardando um temporizador e pode criar um processo separado. Outras pessoas também o executam em um cron quando não se importam com a rapidez da convergência. Observamos um pequeno aumento no uso da CPU em algumas das nossas receitas mais pesadas, mas nada que não possamos resolver simplesmente implantando outro servidor.
P: Quanto você já trabalhou com o CloudFormation?
R: Ainda não estamos usando o CloudFormation. Ele está nos nossos planos, mas uma mudança que fizemos foi passar a utilizar muito mais grupos de Auto Scaling. O funcionamento será o seguinte: quando uma instância for iniciada, ela terá dados de usuário contendo sua lista de execução do Chef.
Uma nova máquina será iniciada em um cluster com uma chave já definida com base em sua imagem, o que permitirá que ela se comunique com nosso servidor Chef, registre-se e baixe os cookbooks necessários. Isso resolve para nós a maior parte das questões relacionadas ao CloudFormation, pois não usamos muitas das outras ferramentas da AWS que normalmente seriam utilizadas em conjunto com ele.
P: Como vocês lidam com a destruição de um servidor?
R: Se um servidor deixar de funcionar em um grupo do Auto Scaling, você poderá usar o Amazon SNS [Serviço de Notificação Simples] para receber uma notificação. Temos um serviço muito simples que monitora essas notificações e, em seguida, faz a limpeza no servidor Chef.
P: Você já usou o OpsWorks da AWS?
R: Não usamos. Desde o início, usamos o Chef hospedado, e ele tem funcionado muito bem para nós. Não tenho certeza, mas acredito que o OpsWorks seja mais parecido com o Chef Solo, no qual ele é usado apenas para provisionamento. Ainda executamos o Chef Agent em quase todas as nossas máquinas e usamos essas mesmas receitas do Chef para gerar contêineres Docker para desenvolvimento.
36:31 Informações de contato
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.