É bem conhecido que o NGINX usa uma abordagem assíncrona e orientada a eventos para lidar com conexões. Isso significa que, em vez de criar outro processo ou thread dedicado para cada solicitação (como fazem os servidores com uma arquitetura tradicional), ele lida com várias conexões e solicitações em um único processo de trabalho. Para isso, o NGINX trabalha com sockets em modo não bloqueante e usa métodos eficientes, como epoll e kqueue.
Como o número de processos completos é pequeno (geralmente apenas um por núcleo da CPU) e constante, o consumo de memória é muito menor e os ciclos da CPU não são desperdiçados com a alternância de tarefas. As vantagens dessa abordagem são bem conhecidas, como demonstra o próprio NGINX. Ele processa com sucesso milhões de solicitações simultâneas e oferece excelente escalabilidade.
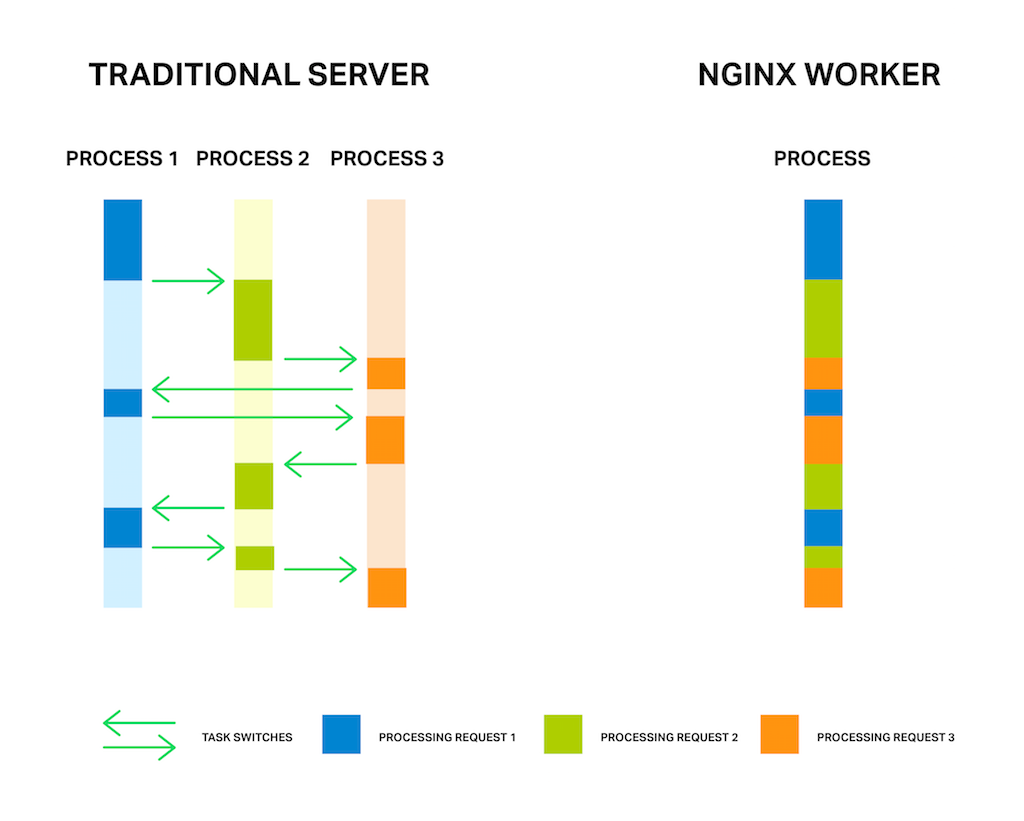
Mas a abordagem assíncrona e orientada a eventos ainda tem um problema. Ou, como gosto de pensar, um “inimigo”. E o nome desse inimigo é: bloqueio. Infelizmente, muitos módulos de terceiros usam chamadas bloqueantes, e os usuários (e, às vezes, até mesmo os desenvolvedores dos módulos) não estão cientes das desvantagens. Operações bloqueantes podem comprometer o desempenho do NGINX e devem ser evitadas a todo custo.
Mesmo no código oficial atual do NGINX, não é possível evitar operações bloqueantes em todos os casos. Para resolver esse problema, o novo mecanismo de “pools de threads” foi implementado no NGINX versão 1.7.11 e no NGINX Plus Release 7. Veremos mais adiante o que ele é e como deve ser usado. Agora, vamos encarar nosso inimigo de frente.
Editor – Para uma visão geral do NGINX Plus R7, consulte Anúncio do NGINX Plus R7 em nosso blog.
Para discussões detalhadas sobre outros novos recursos do NGINX Plus R7, consulte estas publicações relacionadas no blog:
- HTTP/2 agora é totalmente compatível com o NGINX Plus
- Fragmentação de sockets no NGINX
- O novo painel do NGINX Plus na versão 7<.htmla>
- Balanceamento de carga TCP no NGINX Plus R7<.htmla>
O problema
Primeiro, para entender melhor o problema, algumas palavras sobre como o NGINX funciona.
Em geral, o NGINX é um manipulador de eventos, um controlador que recebe do kernel informações sobre todos os eventos que ocorrem nas conexões e, em seguida, instrui o sistema operacional sobre o que fazer. Na prática, o NGINX realiza todo o trabalho complexo ao orquestrar o sistema operacional, enquanto este executa as tarefas rotineiras de leitura e envio de bytes. Por isso, é muito importante que o NGINX responda de forma rápida e oportuna.
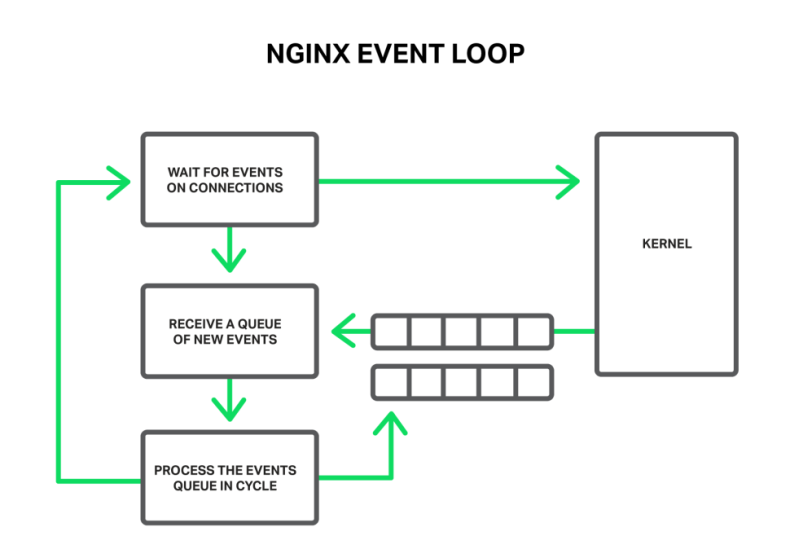
Os eventos podem ser tempos limite, notificações sobre sockets prontos para leitura ou gravação ou notificações sobre um erro ocorrido. O NGINX recebe um conjunto de eventos e os processa um a um, executando as ações necessárias. Assim, todo o processamento é realizado em um loop simples sobre uma fila em uma única thread. O NGINX retira um evento da fila e reage a ele, por exemplo, gravando ou lendo um socket. Na maioria dos casos, isso é extremamente rápido (talvez exigindo apenas alguns ciclos de CPU para copiar alguns dados na memória), e o NGINX processa todos os eventos da fila em um instante.
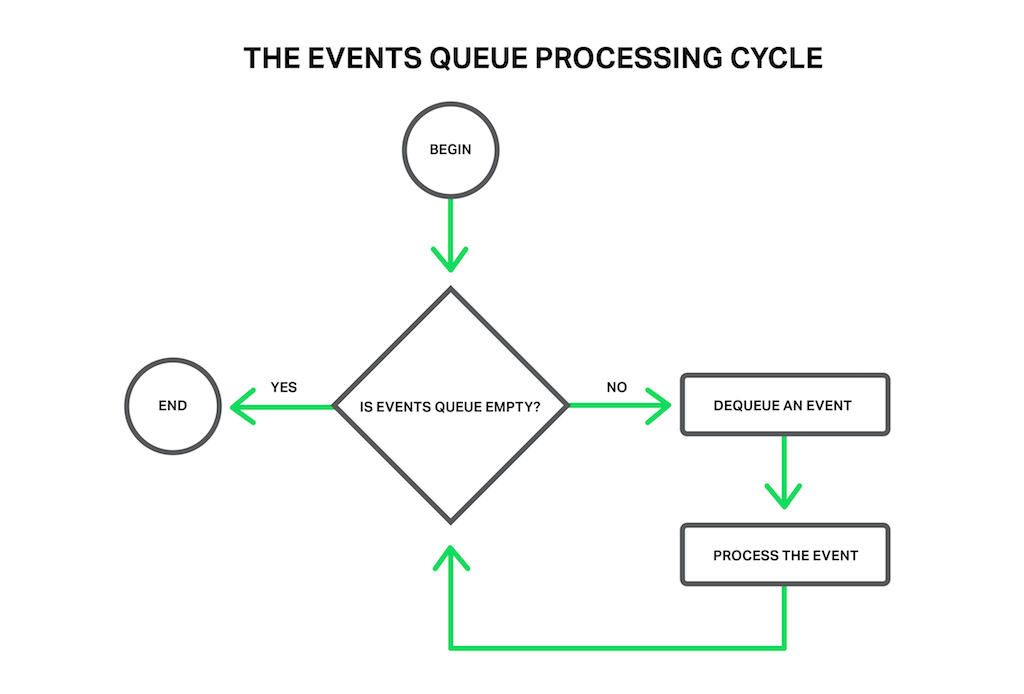
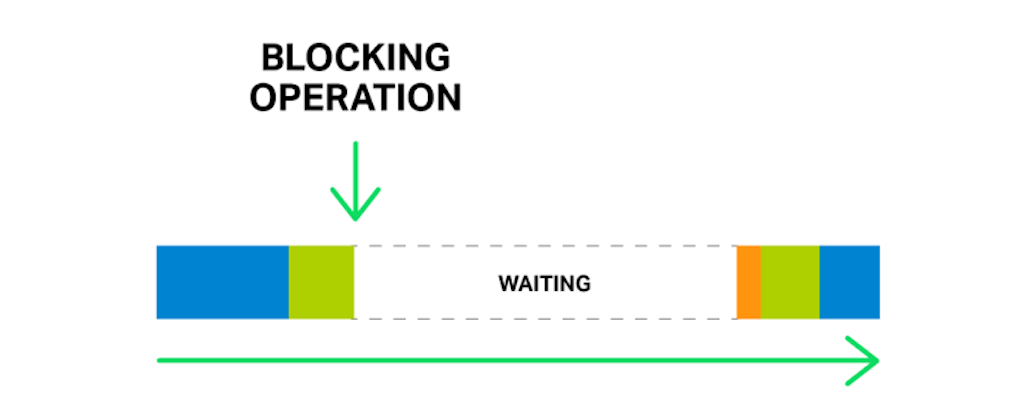
Mas o que acontecerá se alguma operação longa e pesada for executada? Todo o ciclo de processamento de eventos ficará travado, aguardando a conclusão dessa operação.
Assim, quando dizemos “uma operação bloqueante”, queremos dizer qualquer operação que interrompa o ciclo de processamento de eventos por um período significativo. As operações podem ser bloqueantes por vários motivos. Por exemplo, o NGINX pode estar ocupado com um processamento demorado e intensivo em CPU ou pode precisar aguardar o acesso a um recurso (como um disco rígido, um mutex ou uma chamada de função de biblioteca que obtém respostas de um banco de dados de forma síncrona etc.). O ponto principal é que, durante o processamento dessas operações, o processo de trabalho não pode fazer mais nada nem processar outros eventos, mesmo que haja mais recursos do sistema disponíveis e alguns eventos na fila possam utilizá-los.
Imagine um vendedor em uma loja com uma longa fila à sua frente. A primeira pessoa da fila pede algo que não está na loja, mas está no depósito. O vendedor vai até o depósito buscar a mercadoria. Agora, toda a fila precisa esperar algumas horas por essa entrega, e todos ficam insatisfeitos. Consegue imaginar a reação das pessoas? O tempo de espera de cada pessoa na fila aumenta em várias horas, embora os itens que elas pretendem comprar possam estar ali mesmo na loja.
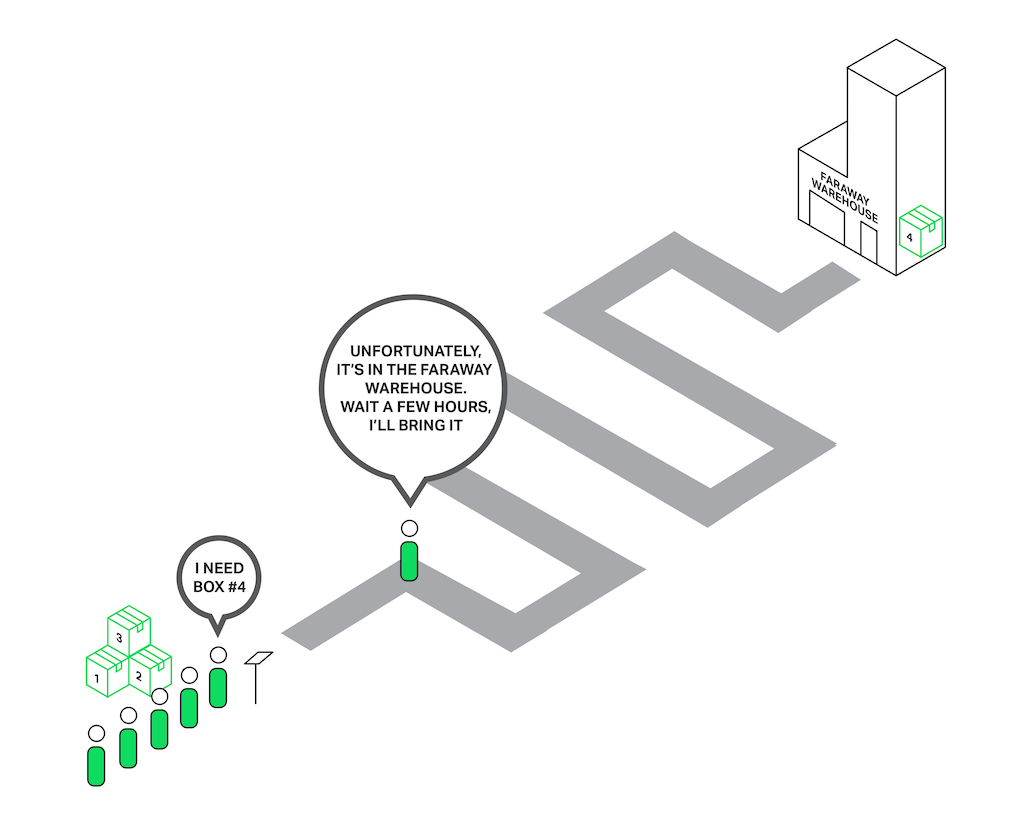
Uma situação praticamente igual ocorre com o NGINX quando ele solicita a leitura de um arquivo que não está armazenado em cache na memória e precisa ser lido do disco. Os discos rígidos são lentos (especialmente os mecânicos) e, embora as outras solicitações na fila talvez não precisem acessar o disco, elas são obrigadas a esperar mesmo assim. Como resultado, a latência aumenta e os recursos do sistema não são totalmente utilizados.
Alguns sistemas operacionais fornecem uma interface assíncrona para leitura e envio de arquivos, e o NGINX pode usar essa interface (consulte a diretiva aio). Um bom exemplo é o FreeBSD. Infelizmente, não podemos dizer o mesmo sobre o Linux. Embora o Linux forneça uma espécie de interface assíncrona para leitura de arquivos, ela apresenta algumas desvantagens significativas. Uma delas são os requisitos de alinhamento para o acesso a arquivos e buffers, mas o NGINX lida bem com isso. O segundo problema, porém, é pior. A interface assíncrona exige que a flag O_DIRECT seja definida no descritor de arquivo, o que significa que qualquer acesso ao arquivo ignorará o cache na memória e aumentará a carga sobre os discos rígidos. Isso definitivamente não é ideal em muitos casos.
Para resolver especificamente esse problema, os pools de threads foram introduzidos no NGINX 1.7.11 e no NGINX Plus Release 7.
Agora, vamos entender melhor o que são pools de threads e como eles funcionam.
Pools de threads
Voltemos ao nosso pobre vendedor, que busca mercadorias em um depósito distante. Mas ele ficou mais esperto (ou talvez tenha aprendido depois de apanhar da multidão de clientes furiosos?) e contratou um serviço de entrega. Agora, quando alguém pede algo que está no depósito distante, em vez de ir pessoalmente até lá, ele simplesmente encaminha o pedido ao serviço de entrega, que cuida de tudo enquanto o vendedor continua atendendo os outros clientes. Assim, apenas os clientes cujas mercadorias não estão na loja precisam esperar pela entrega, enquanto os demais podem ser atendidos imediatamente.
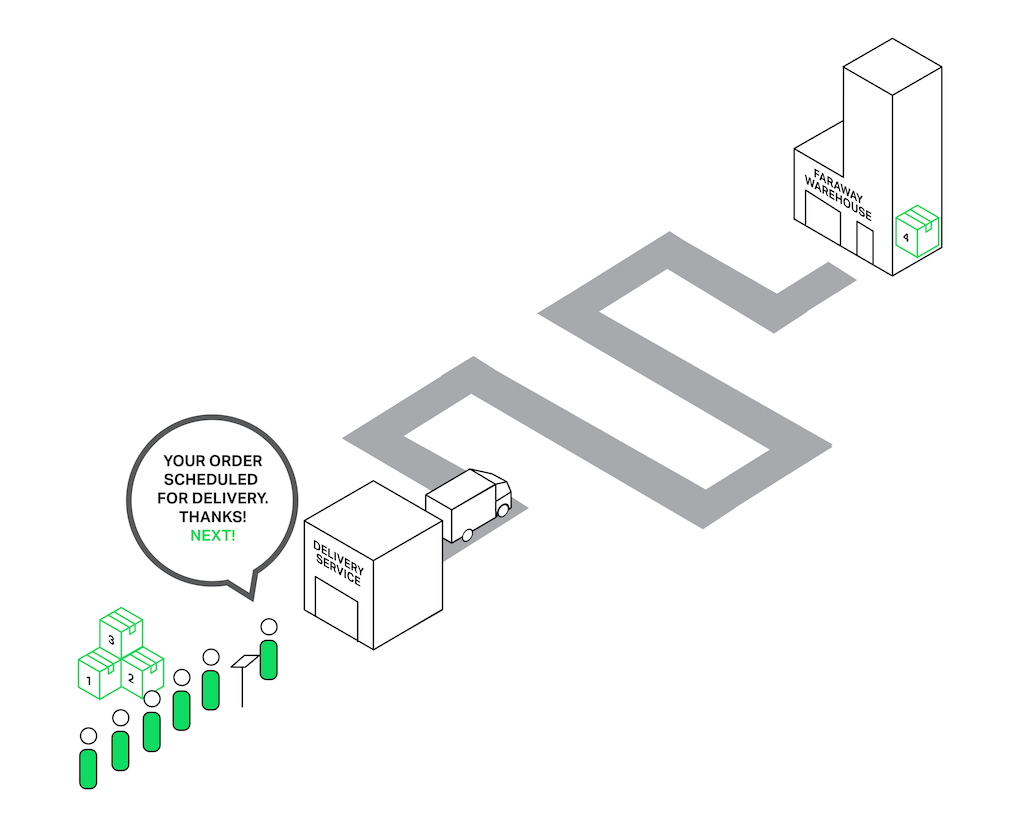
No contexto do NGINX, o pool de threads desempenha as funções do serviço de entrega. Ele consiste em uma fila de tarefas e várias threads que processam essa fila. Quando um processo de trabalho precisa executar uma operação potencialmente demorada, em vez de processá-la por conta própria, ele coloca uma tarefa na fila do pool, de onde ela pode ser retirada e processada por qualquer thread livre.
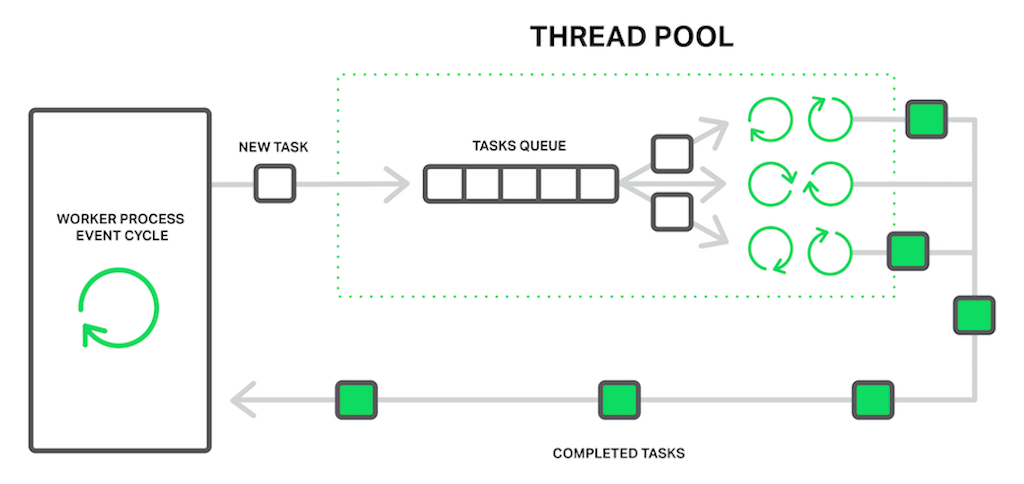
Parece, então, que temos outra fila. Certo. Mas, nesse caso, a fila é limitada por um recurso específico. Não podemos ler dados de uma unidade mais rapidamente do que ela é capaz de fornecê-los. Agora, pelo menos, a unidade não atrasa o processamento de outros eventos, e somente as solicitações que precisam acessar arquivos ficam aguardando.
A operação de “leitura do disco” costuma ser usada como o exemplo mais comum de uma operação bloqueante, mas, na verdade, a implementação de pools de threads no NGINX pode ser usada para qualquer tarefa que não seja adequada para processamento no ciclo de trabalho principal.
No momento, o descarregamento para pools de threads está implementado apenas para três operações essenciais: a chamada de sistema read() na maioria dos sistemas operacionais, sendfile() no Linux e aio_write() no Linux, usada ao gravar alguns arquivos temporários, como os do cache. Continuaremos testando e avaliando o desempenho da implementação e, em versões futuras, poderemos descarregar outras operações para os pools de threads caso haja um benefício claro.
Editor – O suporte à aio_write() chamada de sistema foi adicionado no NGINX 1.9.13 e no NGINX Plus R9.
Benchmarking
É hora de passar da teoria à prática. Para demonstrar o efeito do uso de pools de threads, realizaremos um benchmark sintético que simula a pior combinação de operações bloqueantes e não bloqueantes.
Isso requer um conjunto de dados que certamente não caiba na memória. Em uma máquina com 48 GB de RAM, geramos 256 GB de dados aleatórios em arquivos de 4 MB e, em seguida, configuramos o NGINX 1.9.0 para disponibilizá-los.
A configuração é bem simples:
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}
Como você pode ver, alguns ajustes foram feitos para melhorar o desempenho: logging e accept_mutex foram desativados, sendfile foi ativado e sendfile_max_chunk foi configurado. Essa última diretiva pode reduzir o tempo máximo gasto em chamadas bloqueantes de sendfile(), pois o NGINX não tentará enviar o arquivo inteiro de uma só vez, mas o fará em blocos de 512 KB.
A máquina tem dois processadores Intel Xeon E5645 (12 núcleos e 24 threads com HT no total) e uma interface de rede de 10 Gbps. O subsistema de disco é composto por quatro discos rígidos Western Digital WD1003FBYX configurados em uma matriz RAID10. Todo esse hardware é executado no Ubuntu Server 14.04.1 LTS.
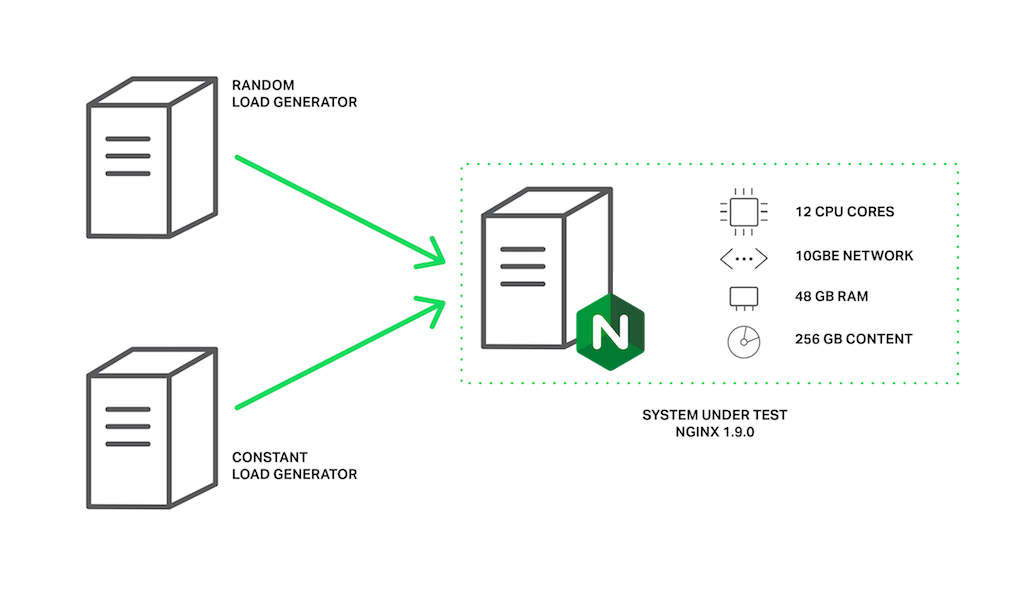
Os clientes são representados por duas máquinas com as mesmas especificações. Em uma dessas máquinas, wrk gera carga usando um script Lua. O script solicita arquivos do nosso servidor em ordem aleatória usando 200 conexões paralelas, e cada solicitação provavelmente resultará em uma falha de cache e em uma leitura bloqueante do disco. Vamos chamar essa carga de carga aleatória.
Na segunda máquina cliente, executaremos outra instância do wrk que solicitará o mesmo arquivo várias vezes usando 50 conexões paralelas. Como esse arquivo será acessado com frequência, ele permanecerá na memória o tempo todo. Em circunstâncias normais, o NGINX atenderia a essas solicitações muito rapidamente, mas o desempenho cairá se os processos de trabalho forem bloqueados por outras solicitações. Vamos chamar essa carga de carga constante.
O desempenho será medido monitorando a taxa de transferência da máquina servidora com o uso do ifstat e obtendo os resultados do wrk no segundo cliente.
Agora, a primeira execução sem pools de threads não nos traz resultados muito animadores:
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
Como você pode ver, com essa configuração, o servidor consegue gerar cerca de 1 Gbps de tráfego no total. Na saída do top, podemos ver que todos os processos de trabalho passam a maior parte do tempo em operações de E/S bloqueantes (eles estão no estado D):
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart    20   0   40304   4160    2208 S   0.0  0.0  0:00.53 zsh
Nesse caso, a taxa de transferência é limitada pelo subsistema de disco, enquanto a CPU fica ociosa na maior parte do tempo. Os resultados do wrk também são muito baixos:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
E lembre-se: isso é para o arquivo que deveria ser servido a partir da memória! As latências excessivamente altas ocorrem porque todos os processos de trabalho estão ocupados lendo arquivos das unidades para atender à carga aleatória gerada por 200 conexões do primeiro cliente e não conseguem processar nossas solicitações em tempo hábil.
É hora de colocar nossos pools de threads em ação. Para isso, basta adicionar a diretiva aio threads ao bloco location:
location / {    root /storage;
    aio threads;
}
e peça ao NGINX para recarregar sua configuração.
Depois disso, repetimos o teste:
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50  9.50e+06
Agora nosso servidor produz 9,5 Gbps, em comparação com cerca de 1 Gbps sem pools de threads!
Provavelmente, ele poderia produzir ainda mais, mas já atingiu a capacidade máxima prática da rede. Portanto, neste teste, o NGINX está limitado pela interface de rede. Os processos de trabalho passam a maior parte do tempo apenas ociosos, aguardando novos eventos (eles estão no estado S no top):
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
Ainda há muitos recursos de CPU disponíveis.
Os resultados do wrk:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
O tempo médio para servir um arquivo de 4 MB foi reduzido de 7,42 segundos para 226,32 milissegundos (33 vezes menos), e o número de requisições por segundo aumentou 31 vezes (250 contra 8)!
A explicação é que nossas solicitações não ficam mais aguardando processamento na fila de eventos enquanto os processos de trabalho estão bloqueados em operações de leitura; em vez disso, elas são tratadas por threads livres. Enquanto o subsistema de disco faz o melhor possível para atender à nossa carga aleatória proveniente da primeira máquina cliente, o NGINX usa os recursos restantes da CPU e a capacidade disponível da rede para atender, a partir da memória, às solicitações do segundo cliente.
Ainda não é uma solução milagrosa
Depois de todos os nossos receios em relação às operações bloqueantes e de alguns resultados animadores, provavelmente a maioria de vocês já está pensando em configurar pools de threads nos servidores. Não se precipitem.
A verdade é que, felizmente, a maioria das operações de leitura e envio de arquivos não precisa lidar com discos rígidos lentos. Se você tiver RAM suficiente para armazenar o conjunto de dados, o sistema operacional será inteligente o bastante para manter os arquivos usados com frequência em uma área de cache conhecida como “cache de páginas”.
O cache de páginas funciona muito bem e permite que o NGINX apresente um ótimo desempenho em quase todos os casos de uso comuns. A leitura do cache de páginas é bastante rápida, e ninguém pode chamar essas operações de “bloqueantes”. Por outro lado, delegar o processamento a um pool de threads gera alguma sobrecarga.
Portanto, se você tiver uma quantidade razoável de RAM e seu conjunto de dados de trabalho não for muito grande, o NGINX já funcionará da melhor maneira possível sem usar pools de threads.
Transferir as operações de leitura para o pool de threads é uma técnica aplicável a tarefas muito específicas. Ela é mais útil quando o volume de conteúdo solicitado com frequência não cabe no cache de memória virtual do sistema operacional. Esse pode ser o caso, por exemplo, de um servidor de streaming de mídia baseado em NGINX e submetido a uma carga intensa. Essa é a situação que simulamos em nosso benchmark.
Seria ótimo se pudéssemos aprimorar a transferência das operações de leitura para pools de threads. Precisamos apenas de uma maneira eficiente de saber se os dados necessários do arquivo estão ou não na memória; somente neste último caso, a operação de leitura deve ser transferida para uma thread separada.
Voltando à nossa analogia de vendas, atualmente o vendedor não tem como saber se o item solicitado está na loja e precisa optar entre sempre encaminhar todos os pedidos ao serviço de entrega ou sempre cuidar deles por conta própria.
O problema é que os sistemas operacionais não oferecem esse recurso. As primeiras tentativas de adicioná-lo ao Linux por meio da chamada de sistema fincore() ocorreram em 2010, mas não foram adiante. Posteriormente, houve várias tentativas de implementá-lo como uma nova chamada de sistema preadv2() com a opção RWF_NONBLOCK (consulte Operações de leitura de arquivos em buffer sem bloqueio e Operações assíncronas de leitura em buffer no LWN.net para obter detalhes). O destino de todos esses patches ainda é incerto. O lamentável é que o principal motivo pelo qual esses patches ainda não foram aceitos no kernel parece ser a constante discussão sobre detalhes irrelevantes.
Por outro lado, os usuários do FreeBSD não precisam se preocupar. O FreeBSD já conta com uma interface assíncrona suficientemente boa para a leitura de arquivos, que deve ser usada em vez de pools de threads.
Configurando pools de threads
Portanto, se você tem certeza de que o uso de pools de threads pode trazer algum benefício para o seu caso de uso, é hora de se aprofundar na configuração.
A configuração é bastante simples e flexível. Primeiro, você deve ter o NGINX versão 1.7.11 ou posterior, compilado com o argumento --with-threads no comando configure. Os usuários do NGINX Plus precisam da versão 7 ou posterior. No caso mais simples, a configuração é bem direta. Basta incluir a diretiva aio threads no contexto apropriado:
# in the 'http', 'server', or 'location' contextaio threads;Esta é a configuração mínima possível dos pools de threads. Na verdade, é uma versão abreviada da seguinte configuração:
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;
Isso define um pool de threads chamado default com 32 threads de trabalho e um tamanho máximo de 65.536 tarefas para a fila. Se a fila de tarefas ficar sobrecarregada, o NGINX rejeitará a solicitação e registrará este erro:
thread pool "NAME" queue overflow: N tasks waitingO erro significa que talvez as threads não consigam processar o trabalho com a mesma rapidez com que ele é adicionado à fila. Você pode tentar aumentar o tamanho máximo da fila, mas, se isso não resolver, significa que o sistema não é capaz de atender a tantas solicitações.
Como você já percebeu, com a diretiva thread_pool é possível configurar o número de threads, o tamanho máximo da fila e o nome de um pool de threads específico. Isso significa que você pode configurar vários pools de threads independentes e usá-los em diferentes partes do arquivo de configuração para atender a diferentes finalidades:
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}
Se o parâmetro max_queue não for especificado, o valor padrão usado será 65536. Como mostrado, é possível definir max_queue como zero. Nesse caso, o pool de threads só poderá processar uma quantidade de tarefas igual ao número de threads configuradas; nenhuma tarefa ficará aguardando na fila.
Agora, imagine que você tenha um servidor com três discos rígidos e queira que ele funcione como um “proxy de cache”, armazenando em cache todas as respostas dos seus backends. A quantidade esperada de dados em cache excede em muito a RAM disponível. Na verdade, trata-se de um nó de cache para a sua CDN pessoal. É claro que, nesse caso, o mais importante é obter o máximo desempenho dos discos.
Uma das opções é configurar um arranjo RAID. Essa abordagem tem seus prós e contras. Agora, com o NGINX, você pode adotar outra:
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}
Nesta configuração, as diretivas thread_pool definem um pool de threads dedicado e independente para cada disco, e as diretivas proxy_cache_path definem um cache dedicado e independente em cada disco.
O módulo split_clients é usado para balancear a carga entre os caches (e, consequentemente, entre os discos), o que atende perfeitamente a essa finalidade.
O parâmetro use_temp_path=off da diretiva proxy_cache_path instrui o NGINX a salvar os arquivos temporários nos mesmos diretórios em que os dados de cache correspondentes estão localizados. Isso é necessário para evitar a cópia de dados de resposta entre os discos rígidos durante a atualização dos caches.
Tudo isso, em conjunto, nos permite obter o máximo desempenho do subsistema de discos atual, pois o NGINX interage com as unidades de forma paralela e independente por meio de pools de threads separados. Cada unidade é atendida por 16 threads independentes, com uma fila de tarefas dedicada à leitura e ao envio de arquivos.
Aposto que seus clientes gostam dessa abordagem personalizada. Pode ter certeza de que seus discos rígidos também gostam.
Este exemplo demonstra bem a flexibilidade com que o NGINX pode ser ajustado especificamente para o seu hardware. É como se você desse instruções ao NGINX sobre a melhor maneira de interagir com a máquina e o seu conjunto de dados. E, ao fazer o ajuste fino do NGINX no espaço do usuário, você pode garantir que o software, o sistema operacional e o hardware trabalhem juntos da melhor forma possível para utilizar todos os recursos do sistema com a máxima eficiência.
Conclusão
Em resumo, os pools de threads são um excelente recurso que leva o desempenho do NGINX a novos patamares ao eliminar um de seus inimigos mais conhecidos e antigos — o bloqueio —, especialmente quando estamos falando de volumes realmente grandes de conteúdo.
E ainda há muito mais por vir. Como mencionado anteriormente, essa interface totalmente nova permite, potencialmente, transferir qualquer operação demorada e bloqueante sem perda de desempenho. O NGINX abre novos horizontes para a criação de uma grande variedade de novos módulos e funcionalidades. Muitas bibliotecas populares ainda não oferecem uma interface assíncrona e não bloqueante, o que antes as tornava incompatíveis com o NGINX. Podemos gastar muito tempo e recursos desenvolvendo nosso próprio protótipo não bloqueante de uma biblioteca, mas será que esse esforço sempre valerá a pena? Agora, com os pools de threads, é possível usar essas bibliotecas com relativa facilidade, criando módulos desse tipo sem afetar o desempenho.
Fique ligado.
Experimente você mesmo os pools de threads no NGINX Plus — comece hoje mesmo sua avaliação gratuita de 30 dias ou entre em contato conosco para conversar sobre seus casos de uso.
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.