Os aplicativos estão sob ataque. As invasões ocorrem com uma frequência alarmante — a cada 39 segundos, segundo uma pesquisa realizada pela Universidade de Maryland — e têm uma probabilidade de sucesso preocupantemente alta.
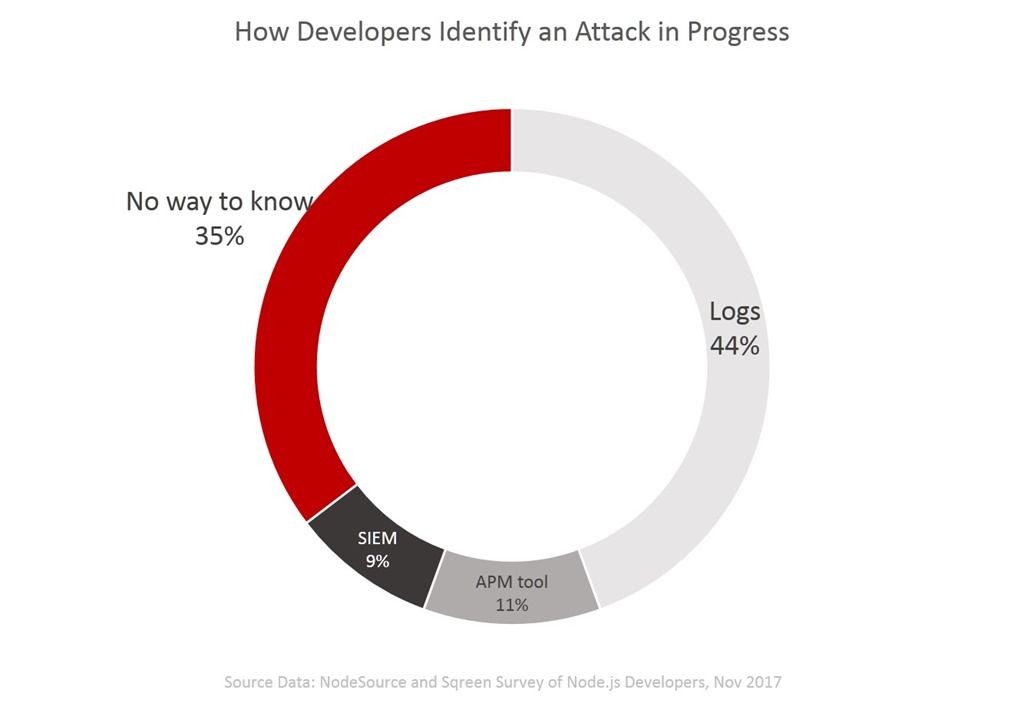
Os desenvolvedores, que assumem cada vez mais a responsabilidade de proteger esses aplicativos, estão bem cientes da ameaça. Uma pesquisa realizada no final de 2017 com desenvolvedores de node.js pela NodeSource e pela Sqreen constatou que “mais de um terço de todos os entrevistados (34%) acredita que há uma grande probabilidade de sua organização ser alvo de um ataque em larga escala nos próximos seis meses”. Considerando nossas próprias descobertas de que, em 86% dos ataques, o vetor de ataque inicial é o próprio aplicativo ou as identidades, essa percepção é mais do que razoável.
Pode ser preocupante descobrir, então, que “35% dos entrevistados não sabiam ao certo como identificar um ataque enquanto ele está acontecendo”. Eles esperam que isso ocorra, mas não sabem ao certo como reconhecer o ataque quando ele acontece. Se você não sabe ao certo como identificar um ataque em andamento, é extremamente difícil detê-lo.
Isso torna ainda mais preocupante o fato de 23% dos desenvolvedores de Node.js (23 por cento) não usarem nenhuma forma de proteção em tempo real contra ataques.
A boa notícia é que, com base em nossa própria pesquisa para o State of Application Delivery 2018, a maioria das organizações usa algum tipo de proteção em tempo real contra ataques. Quatro em cada cinco usam duas ou mais tecnologias, incluindo firewall de aplicações web (57%), autoproteção de aplicações em tempo de execução (11%) e análise do comportamento dos usuários (26%).
A característica que todas essas tecnologias têm em comum é justamente o que muitas vezes falta aos desenvolvedores: visibilidade. A visibilidade é necessária porque, para detectar (e, espera-se, identificar) um ataque, é preciso ser capaz de reconhecer comportamentos anormais.
Os aplicativos e seus serviços apresentam padrões de uso bastante previsíveis. Por exemplo, aplicativos de logon único (SSO) costumam ter uso intenso nas manhãs de segunda-feira e uso reduzido nas tardes de sexta-feira. Aplicativos financeiros tendem a ser muito utilizados pouco antes de eventos financeiros, como dias de pagamento, encerramentos de períodos fiscais e fechamentos de exercícios fiscais.
Até mesmo os aplicativos voltados ao consumidor apresentam padrões de uso previsíveis, que podem ser usados para ajudar a detectar comportamentos incomuns (e potencialmente perigosos). Por exemplo, em abril de 2017 a Malauzai Software publicou um de seus relatórios mensais de “pequenos dados” com base em dados de uso coletados de mais de “435 bancos e cooperativas de crédito, abrangendo 13,2 milhões de acessos de 730.000 usuários ativos de serviços bancários pela Internet e por dispositivos móveis”. Nele, descobrimos que “100% dos usuários finais consultam seus saldos e analisam o histórico de transações recentes. Isso ocorre porque os saldos e o histórico recente são exibidos na página inicial para que todos possam vê-los. E é por isso que eles acessam o serviço. Em 77% das vezes. Em 77% das vezes, tudo o que o usuário faz é consultar saldos e o histórico. Apenas 23% do total de interações em serviços bancários digitais vão além da consulta de saldos e do histórico para realizar alguma outra tarefa.”
Pode-se inferir, então, que um interesse repentino por outros tipos de transações pode ser um indício de ataque.
Infelizmente, essas estatísticas nem sempre estão prontamente disponíveis para todas as aplicações. Por isso, a visibilidade (monitoramento) é importante, pois permite estabelecer uma linha de base em relação à qual as anomalias se tornam evidentes. É claro que nem todas as anomalias indicam um ataque. Um pico no uso do serviço de SSO no meio da semana pode ocorrer devido a um prazo para a alteração das senhas corporativas ou porque segunda e terça-feira foram feriados e ninguém estava no escritório. Ainda assim, ter uma linha de base ajuda a identificar comportamentos que podem indicar que um ataque está em andamento.
Faça questão de investigar estes três padrões anormais de uso para verificar se eles são, de fato, um ataque. Porque, muitas vezes, são.
1. Aumento drástico no número de conexões. Talvez você tenha acabado de viralizar, mas é bem provável que haja algo mais acontecendo. Ao observar um aumento significativo na taxa de conexões, é recomendável verificar imediatamente se houve um aumento correspondente no tráfego de rede. Caso contrário, seu sentido aranha deve ficar alerta, pois isso pode indicar um ataque. As inundações de GET são os ataques DDoS baseados em HTTP mais fáceis de executar, pois consistem simplesmente em disparar uma quantidade enorme de solicitações HTTP GET contra uma aplicação, sem nada além disso. Muitas vezes, os invasores nem sequer tentam acessar URLs reais, pois o objetivo é apenas consumir o maior número possível de conexões e forçar uma situação de sobrecarga.
Se o aumento estiver direcionado especificamente a URLs ou serviços que oferecem login, você pode estar sendo vítima de um ataque de força bruta para obter acesso.
Procure por erros no servidor, degradação progressiva do desempenho e esgotamento de recursos como sinais de um ataque em andamento.
2. Tamanho da resposta de saída. Uma resposta de saída repentinamente grande pode indicar um ataque de exfiltração bem-sucedido, no qual o invasor obteve acesso a dados aos quais não deveria ter acesso. Esse é um dos principais sinais de alerta de um ataque de SQLi bem-sucedido, pois os invasores costumam usar curingas para obter acesso não autorizado a dados. Seria de se esperar que, por ser um vetor de ataque tão conhecido, a SQLi já estivesse devidamente controlada. No entanto, todos os anos, a SQLi aparece de forma recorrente entre os ataques mais bem-sucedidos em diversos relatórios do setor.
Basicamente, o ataque é projetado para contornar as restrições de acesso aos dados. Assim, em vez de receber um único registro (ou mesmo apenas alguns), o invasor pode receber milhares. Portanto, um ataque bem-sucedido será perceptível porque a quantidade de dados retornada será significativamente maior do que o normal.
Qualquer diferença significativa no tamanho da resposta deve ser suficiente para justificar uma investigação imediata.
3. Falhas e travamentos. Embora possam ser explicados por defeitos ou por entradas acidentalmente “inválidas”, eles também podem indicar tentativas de estourar buffers em bibliotecas de terceiros, plataformas de servidores web (ou em seu aplicativo), na esperança de explorar uma vulnerabilidade nova (ou antiga). Embora seja bom que hoje os sistemas possam simplesmente “reiniciar” sozinhos, não é bom ignorar o motivo pelo qual precisaram ser reiniciados.
Embora possa ser tentador ignorar uma falha ocasional, não faça isso.
Não ignore falhas e travamentos e considere arquiteturas que permitam isolar sistemas defeituosos até que você possa analisá-los.
Obviamente, esta não é uma lista completa, mas é um bom ponto de partida para identificar quando um aplicativo pode estar sob ataque — e detê-lo imediatamente.
Mantenha-se seguro!
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog
Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...