Este blog dá continuidade a “O que é um bom plano de controle para operar um grande número de clusters do Kubernetes”. O blog anterior descreveu a abordagem exclusiva de Operações de Frota da Volterra para gerenciar uma frota de sites de infraestrutura e aplicações. Este blog aborda especificamente um dos principais desafios enfrentados por uma equipe de operações ao fazer alterações de configuração em um grande número de clusters ou sites: a divergência de configuração. Chamo esse desafio de “Tempo para Efetivação”.
O que é tempo para efetivação?
Pode ser descrito simplesmente como o tempo necessário para que a intenção de uma operação produza efeito. Alguns exemplos incluem:
- Quanto tempo levará para que a configuração da minha política de segurança entre em vigor em todos os meus sites?
- Quanto tempo levará para que a versão mais recente do meu aplicativo seja propagada para todos os sites?
- Quanto tempo levará para atualizar o sistema operacional ou o software de infraestrutura em todos os meus sites distribuídos globalmente?
Por que isso é importante?
Essa pergunta pode ser respondida com alguns exemplos reais de clientes:
- Meltdown e Spectre — Depois que as notícias sobre o Meltdown/Spectre vieram à tona, a principal preocupação de todos os CISOs era como aplicar rapidamente as correções do sistema operacional em toda a infraestrutura. A equipe de operações era avaliada a cada hora pelo tempo necessário para que a ação pretendida (ou seja, atualizar a versão do sistema operacional) fosse efetivada.
- Você deve ter ouvido falar da frota de máquinas de venda automática que causou um ataque de negação de serviço contra uma universidade, certo? Aqui vai um resumo, caso você não tenha acompanhado o ataque: hackers exploraram uma vulnerabilidade de dia zero e instalaram um malware que se conectou a outras máquinas de venda automática, criando uma frota de bots. Em seguida, ela enviou um enorme volume de tráfego e causou um ataque de negação de serviço contra a universidade. Ao detectar o ataque, a universidade teve que configurar regras de política de rede em cada máquina, uma por uma, para impedir o acesso ao servidor de comando e controle. Era extremamente importante que a intenção da universidade (ou seja, bloquear o acesso a um site específico) entrasse em vigor imediatamente em todas as máquinas para conter os danos.
O tempo para efetivação é importante para diversas categorias, como software de infraestrutura, software de aplicação, políticas de rede e políticas de segurança.
Qual é o desafio?
A gravidade do desafio é sentida principalmente quando a equipe de operações precisa gerenciar
- Um grande número de sites
- Sites distribuídos globalmente
- Ambientes heterogêneos, ou seja, sites em nuvens privadas, públicas e de telecomunicações, além de dispositivos de borda
- Conectividade inconsistente entre os sites
Um ótimo exemplo seria uma equipe de operações de um fabricante de equipamentos originais (OEM) do setor automotivo, responsável por atualizar o software e gerenciar a conectividade de seus veículos (doravante denominados sites de clientes). Uma implantação típica incluiria um data center privado, a partir do qual a equipe de operações controla seus veículos globalmente (ou regionalmente, dependendo da estrutura organizacional).
Para entender o desafio, vamos analisar as soluções que a equipe de operações tem à disposição. A maioria das soluções oferece um software de gerenciamento hospedado no data center privado do cliente para gerenciar centralmente a grande quantidade de sites distribuídos. Quando a montadora configura uma política que precisa ser aplicada a todos os veículos, o software de gerenciamento central basicamente baixa um script de configuração em cada carro, um por um. O script de configuração pode ser um playbook do Ansible ou um chart do Helm que executa uma série de comandos de configuração em cada site. Isso pode ser visualizado conforme mostrado no diagrama abaixo.
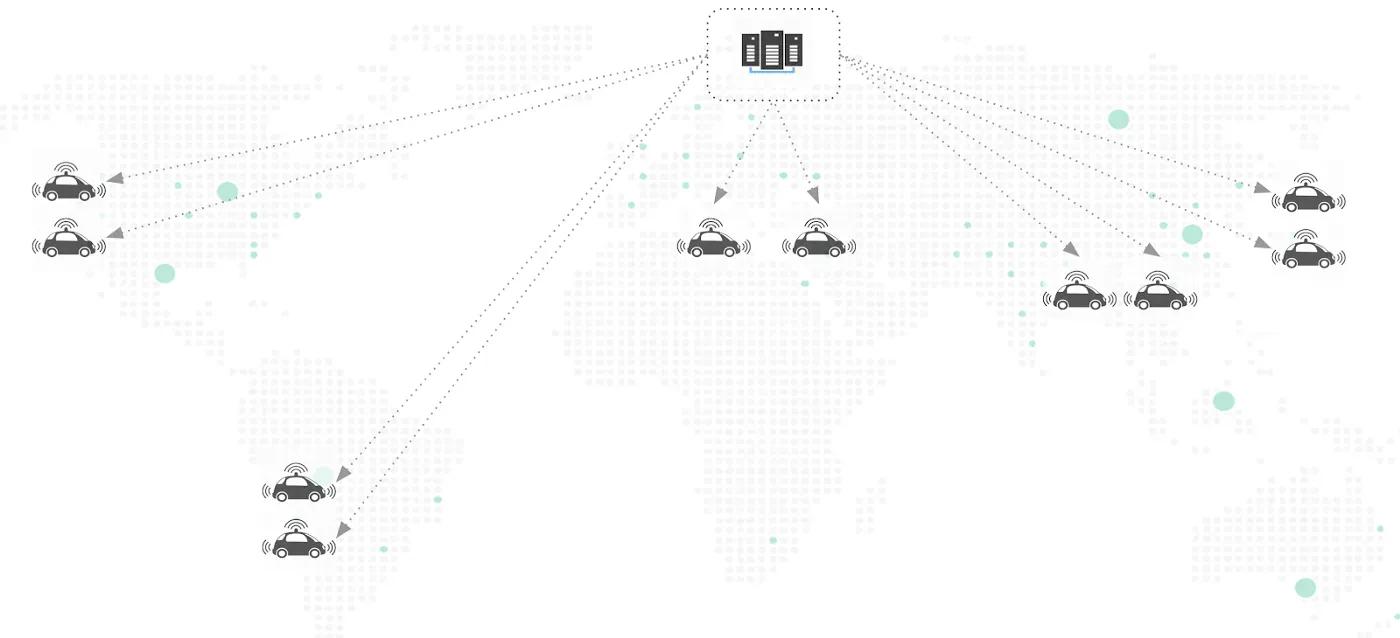
O problema é que o Tempo para Produzir Efeito é diretamente proporcional ao número de sites. Os fornecedores de software de gerenciamento centralizado argumentarão que, desde que todas as operações possam ser realizadas remotamente e de forma automatizada, esse é o melhor resultado possível.
A Volterra discorda, e podemos provar isso neste blog. Criamos um plano de controle distribuído com uma abordagem arquitetônica hierárquica e horizontalmente escalável, projetada para garantir um tempo mínimo para que as alterações entrem em vigor.
Arquitetura da Volterra para minimizar o tempo até a aplicação
Os componentes fundamentais para alcançar um Tempo até o Efeito mínimo são:
- Arquitetura hierárquica baseada em árvore
- Plano de controle distribuído desenvolvido especificamente para essa finalidade
A seguir, é apresentada uma visão geral da arquitetura em alto nível.
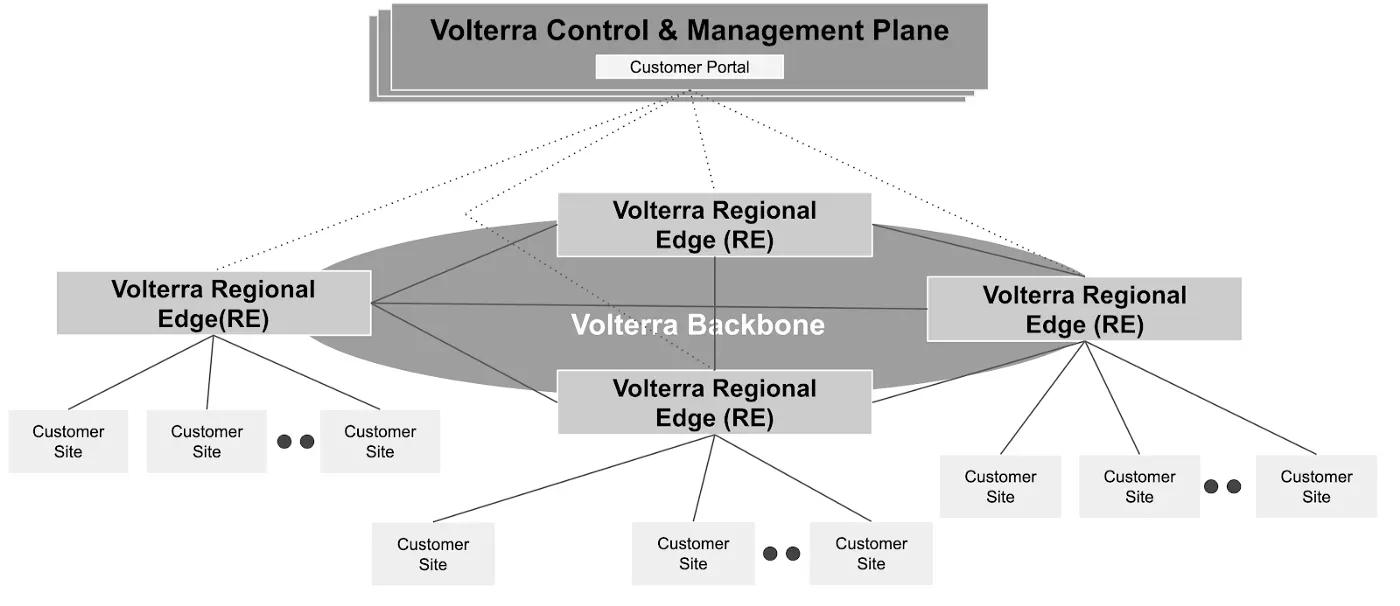
A abordagem de arquitetura hierárquica da Volterra consiste em criar uma árvore de nós para distribuir a configuração. Cada nó armazena e encaminha — ou seja, armazena a configuração localmente e depois a encaminha aos seus nós filhos. Isso pode ser mais bem explicado com um exemplo. Quando um usuário configura um objeto, como uma política de rede, no Volterra Console, o plano de controle e gerenciamento distribui a configuração aos nós filhos imediatos, os Regional Edges (REs). Cada RE armazena a configuração localmente e a encaminha aos seus nós filhos. Os nós filhos dos REs são sites de clientes conectados a esses REs.
Uma arquitetura hierárquica baseada em árvore garante um tempo mínimo para efetivação. O tempo para efetivação é limitado pelo número de níveis na árvore e pelo número de nós filhos por nó. O número máximo de níveis na árvore é três (controlador → RE → site do cliente). O número de nós filhos por nó é diretamente proporcional ao número de sites conectados ao RE. Uma instância de serviço é iniciada no RE para processar a configuração de um conjunto de sites. O plano de controle escalável da Volterra inicia novas instâncias de serviço sob demanda caso haja um aumento no número de sites conectados ao RE.
Configuração do teste
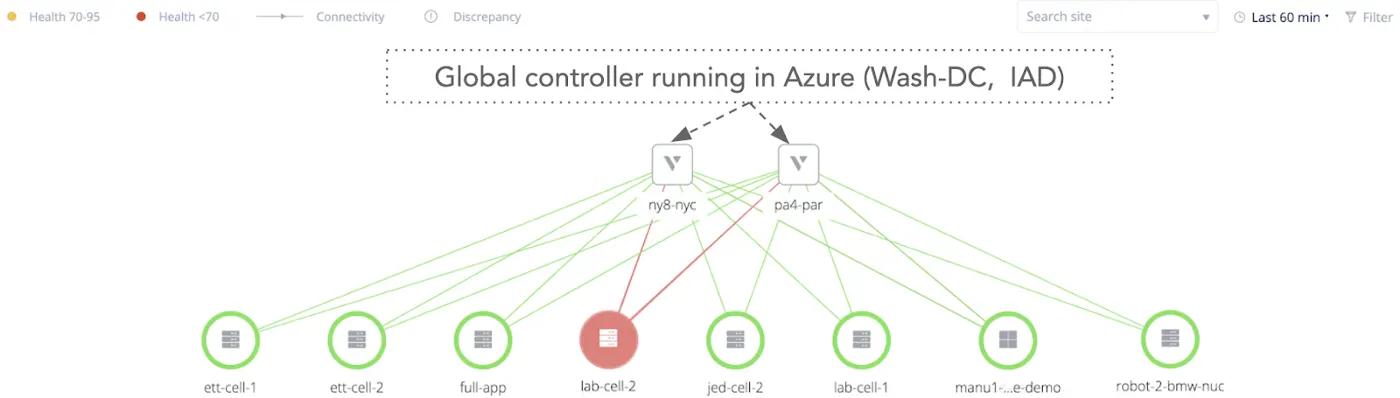
A medição do tempo para que as alterações entrassem em vigor foi realizada em grande escala em sites de clientes conectados a dois edges regionais localizados em Nova York (NY8-NYC) e Paris (PA4-PAR). Os sites dos clientes estavam distribuídos globalmente por Santa Clara (CA), Houston (Texas), Madri (Espanha), Praga (República Tcheca), Londres (Reino Unido), entre outros locais. Além disso, os sites dos clientes abrangiam ambientes heterogêneos, como AWS, máquinas virtuais (ESXi) e gateways de edge, incluindo Intel NUCs e Fitlet2.
O portal do cliente e o plano de controle global da Volterra estavam em execução no Azure (Washington-IAD). Os sites dos clientes estavam distribuídos entre vários namespaces e tenants para representar um ambiente operacional real.
As condições de falha foram simuladas encerrando instâncias de serviço no RE e usando links de conectividade de baixa qualidade entre o RE e os sites dos clientes. Uma visão instantânea de um segmento de toda a frota, em um único namespace, é mostrada na Figura 3.
Metodologia de teste
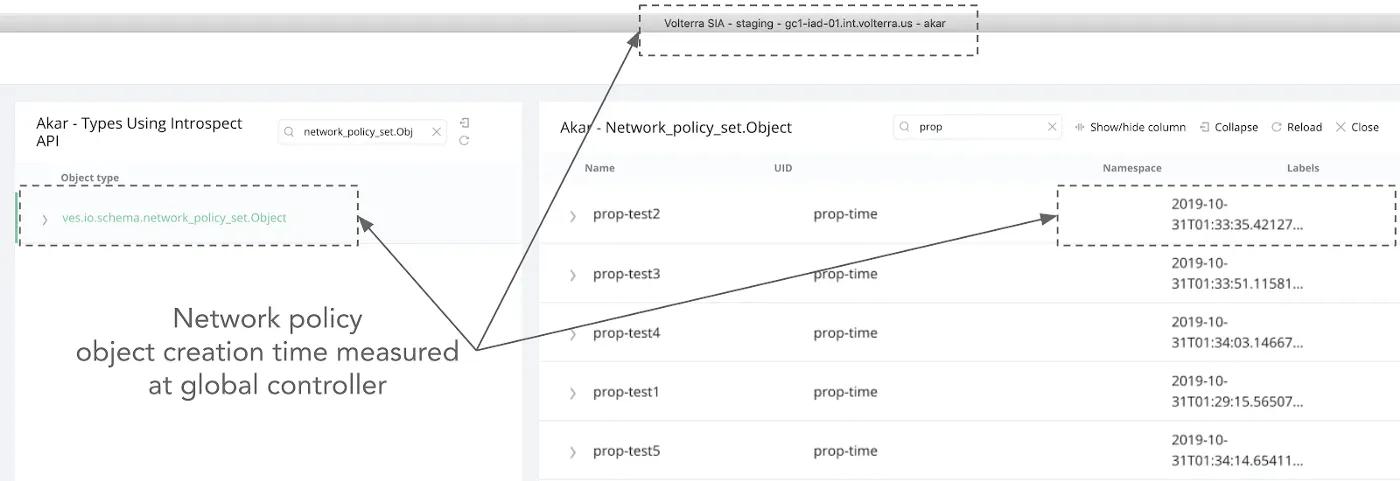
Os logs de auditoria, com registros de data e hora, são capturados no sistema Volterra sempre que objetos são configurados no console do Volterra e a configuração é aplicada em cada site do cliente. O tempo de propagação foi medido como a diferença entre o momento da configuração no portal e o momento em que ela foi aplicada no site do cliente. Um processo detalhado, passo a passo, é descrito a seguir.
- Configure objetos no portal do cliente.
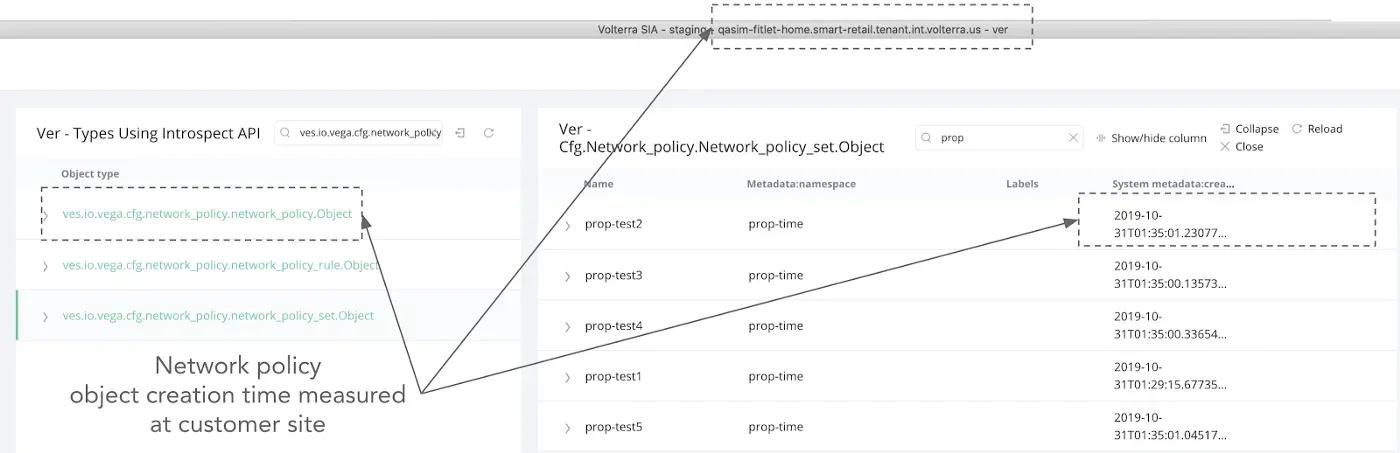
- Meça o horário de início considerando o horário de criação do objeto no portal do cliente (denominado neste documento como Volterra Global Controller). Consulte a figura 4 para ver um exemplo.
- Meça o horário de término como o horário de criação do objeto no site do cliente. Veja a figura 5 como exemplo.
Observe que as capturas de tela exibidas são apenas exemplos e não se referem à mesma iteração de medição.
Hora de início da configuração
Horário de término da configuração
Resultados dos testes
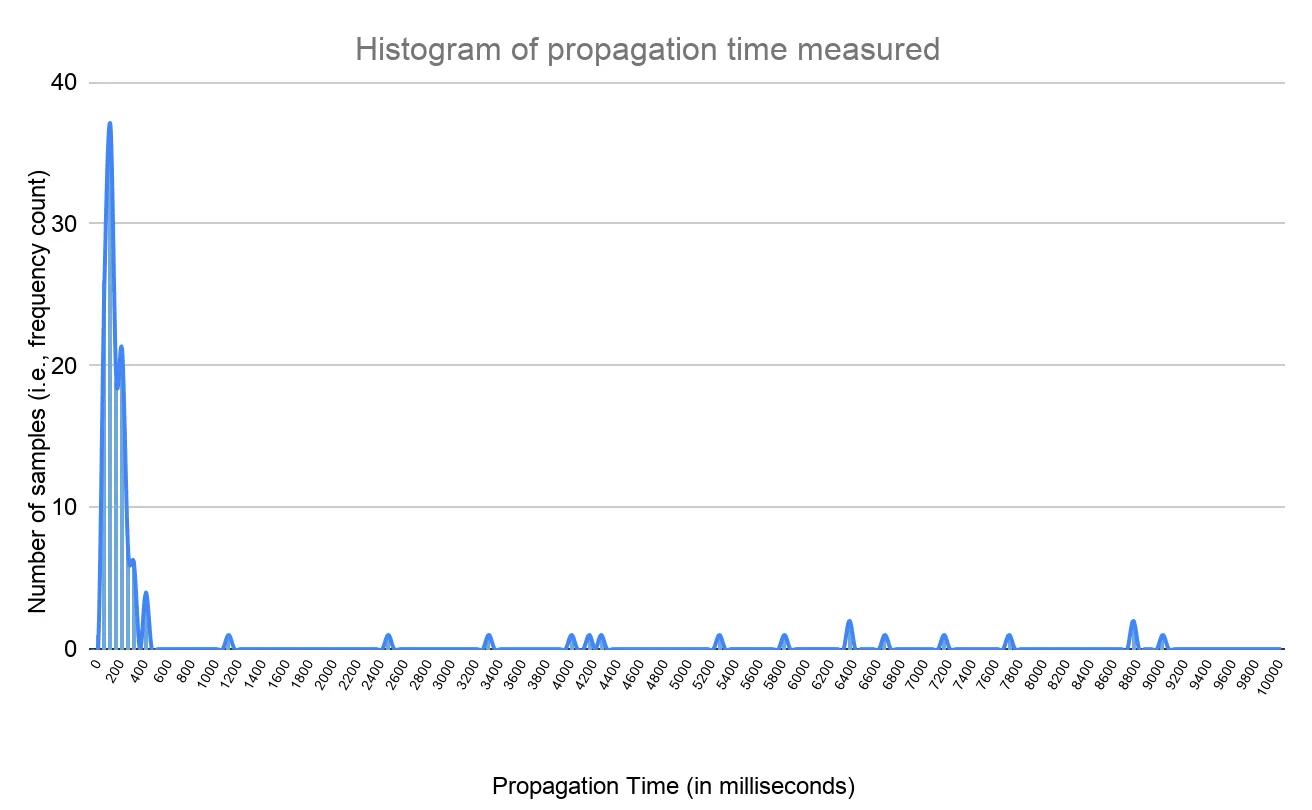
Os resultados dos testes dos tempos de propagação são apresentados nas figuras 6 e 7. O gráfico da figura 6 indica que a maioria das amostras de medição apresentou um tempo de propagação entre 0 e 400 ms. Isso significa que todos os sites dos clientes são atualizados com uma nova configuração em um intervalo de 0 a 400 ms. Como mencionado anteriormente, as condições de falha foram simuladas reiniciando serviços no RE e introduzindo falhas/atrasos de conectividade no site do cliente. Nessas condições de falha, o tempo de propagação da configuração é maior e, nesses testes específicos, variou de 600 ms a 9 segundos, dependendo do tipo de falha. Por exemplo, uma falha de conectividade entre o RE e os sites dos clientes aumentará o tempo necessário para que a configuração chegue ao site do cliente. No entanto, a vantagem do plano de controle distribuído da Volterra é que ele segue o paradigma de configuração com consistência eventual, ou seja, continua tentando garantir que a configuração em todos os sites dos clientes esteja alinhada à intenção definida pelo cliente.
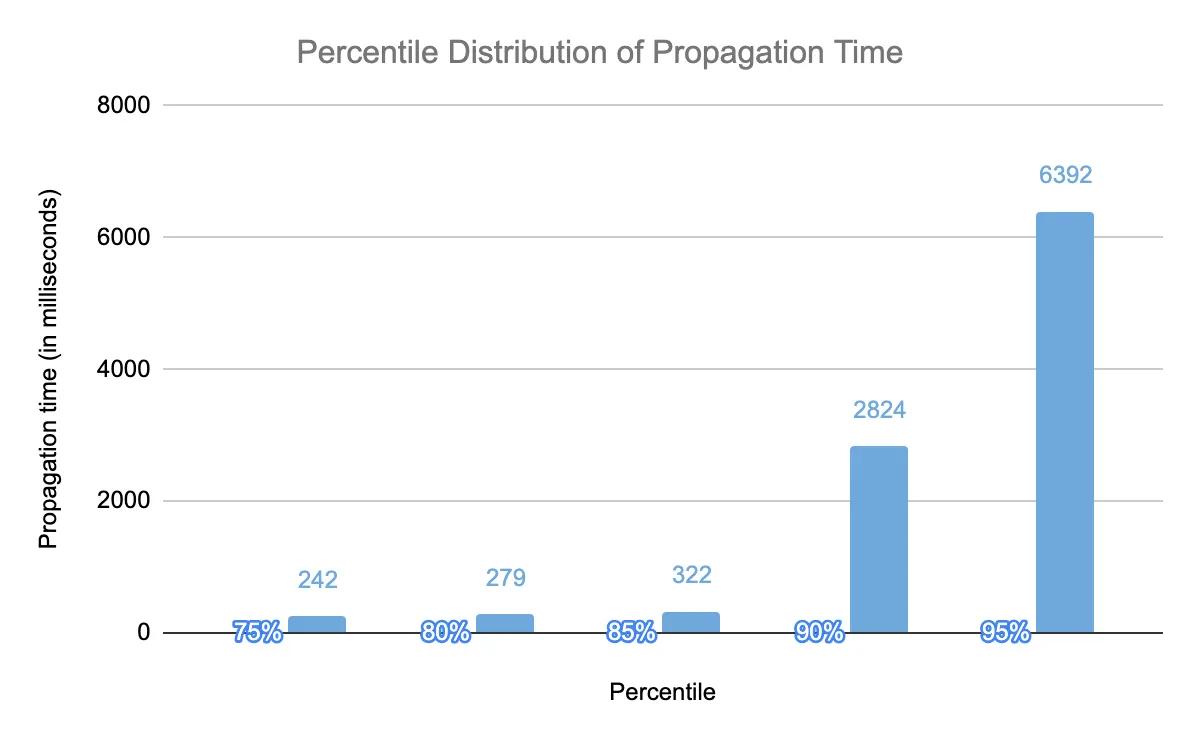
O gráfico da figura 7 indica que, em 85% dos casos, todos os sites dos clientes são atualizados com uma nova configuração em até 322 milissegundos. Quando são introduzidas condições de falha, alguns sites de clientes podem apresentar um tempo de propagação de aproximadamente 3 a 9 segundos.
Aviso: Essas medições estão intimamente relacionadas à topologia, à escala, ao ambiente de implantação e às situações de falha simuladas. Não medimos todas as possíveis situações de falha nem outros ambientes. Portanto, não podemos fazer afirmações sobre o atraso de propagação em situações ou ambientes que não foram testados. Por exemplo, se houver uma falha no cluster do Kubernetes, o sistema terá que aguardar a detecção da falha, a reinicialização e uma nova tentativa de configuração, resultando em um atraso de propagação maior.
Blogs relacionados
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...