A disponibilidade é coisa séria em uma economia na qual os aplicativos são moeda corrente. Aplicativos que não respondem são imediatamente excluídos e criticados na internet com a rapidez e o sarcasmo de uma avaliação negativa no Yelp.
Desde os primórdios da Internet, as organizações buscam garantir que os aplicativos (antigamente, sites) estejam disponíveis 24 horas por dia, 7 dias por semana, 365 dias por ano. Afinal, a Internet nunca dorme, nunca tira férias e nunca fica de licença médica.
Para atender a essa necessidade (na verdade, um requisito), a escalabilidade surgiu como um dos primeiros serviços de aplicação voltados a garantir a disponibilidade. O serviço de aplicação mais visível — e mais bem compreendido — para atender às necessidades de disponibilidade é o balanceamento de carga.
No entanto, há muitas formas de balanceamento de carga e padrões de escalabilidade que podem ser implementados usando essa tecnologia essencial. Hoje, vou destacar os cinco principais padrões de escalabilidade usados para manter os aplicativos e a Internet online e disponíveis 24 horas por dia, 7 dias por semana, 365 dias por ano.
Balanceamento Global de Carga de Servidores (GSLB)
GSLB é um nome extremamente inadequado. Na verdade, nunca se tratou de balanceamento de carga de servidores , mas sim da disponibilidade do site . Hoje, esse conceito também está se ampliando para incluir a disponibilidade de aplicativos.
O GSLB é o recurso que permite garantir que, se um data center (na nuvem ou tradicional) não estiver respondendo, seja possível encontrar outro. O GSLB pode ser aplicado no nível do domínio ou do host. Assim, você pode usá-lo para alternar example.com entre diferentes locais, bem como api.example.com.
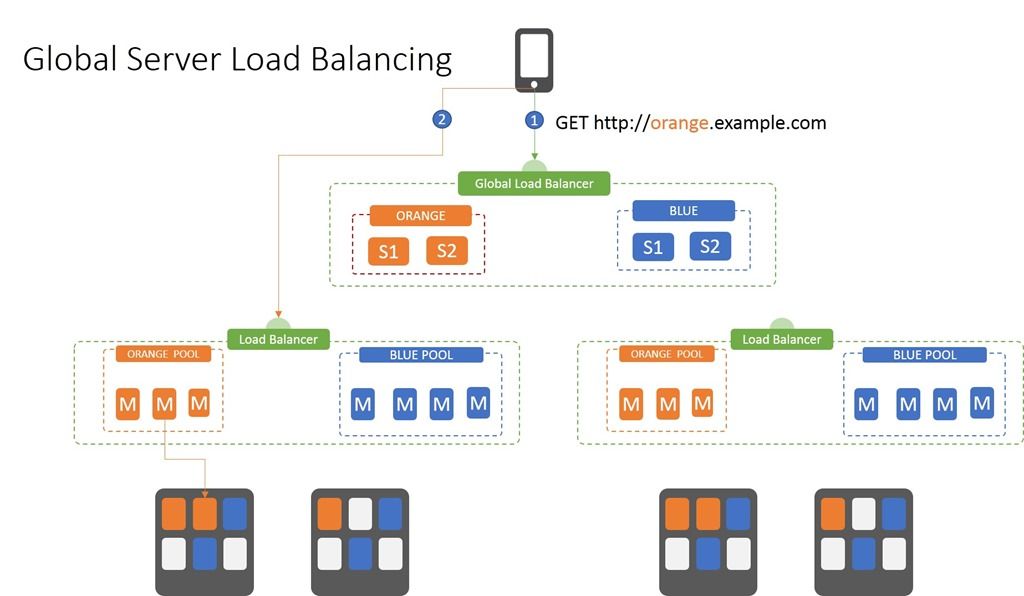
Em sua forma mais básica, o GSLB usa um balanceamento de carga rudimentar baseado em DNS. Isso significa que ele mantém uma lista de endereços IP associados a um domínio ou host e, se o primeiro não estiver disponível, as solicitações serão direcionadas ao segundo da lista — ou ao terceiro, ao quarto e assim por diante.
Esse processo tem duas etapas:
- Solicite ao balanceador de carga global o endereço IP apropriado. Essa é a desvantagem sempre associada ao GSLB: se você fez uma solicitação nos últimos 15 minutos, ou dentro do período definido pelo TTL atual do endereço IP de cheese.com, receberá a última resposta obtida. Portanto, se esse site ficar fora do ar nesse intervalo, você não conseguirá se conectar.
- Faça a solicitação ao endereço IP do site retornado pela consulta ao GSLB. Muitas vezes, ele acaba sendo um balanceador de carga local que usa seus próprios algoritmos e processo de tomada de decisão para encaminhar a solicitação ao recurso apropriado.
Em geral, a decisão tomada na etapa 1 não envolve nenhum tipo de inteligência; ela se baseia estritamente no fato de um determinado site estar respondendo ou não. Ainda assim, é dessa forma que você pode usar vários locais — nuvem, provedor de hospedagem, infraestrutura local — para garantir a disponibilidade. Ao escolher estrategicamente locais em diferentes áreas geográficas, você pode evitar o impacto de desastres naturais ou interrupções da Internet.
Mas esse é mais um cenário de DR (recuperação de desastres) ou BC (continuidade de negócios). Há outros cenários que aproveitam serviços de aplicação GSLB mais inteligentes, como geolocalização e desempenho de aplicações. Portanto, se a aplicação no Site A estiver apresentando baixo desempenho, talvez seja melhor direcionar os visitantes ao Site B até que o problema seja resolvido. Ou talvez você queira direcionar os usuários ao local geograficamente mais próximo para ajudar a melhorar o desempenho (porque a velocidade da luz continua sendo uma limitação, e a distância afeta o desempenho das aplicações).
Independentemente de como a decisão seja tomada, o padrão básico permanece o mesmo: o GSLB distribui as solicitações entre vários sites fisicamente separados, retornando o endereço IP de um dos sites disponíveis. Seja para APIs ou aplicativos, o GSLB é um padrão de alto nível para garantir a disponibilidade.
Balanceamento de carga tradicional (POLB)
Disponibilidade baseada em conexão
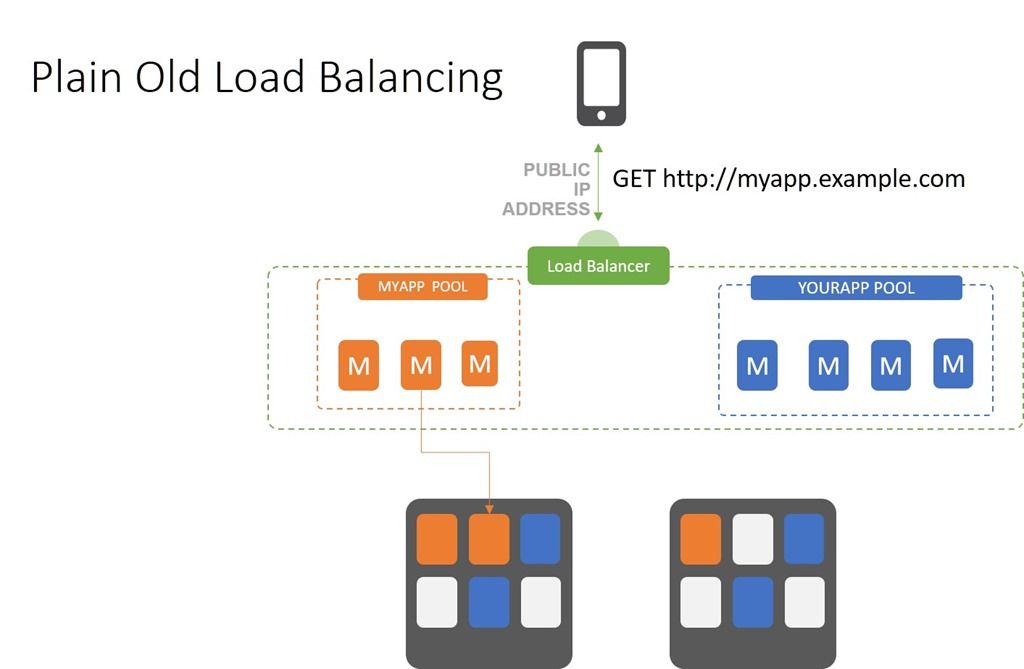
Plain Old Load Balancing (POLB) é um termo que gosto de usar para descrever o balanceamento de carga padrão baseado em TCP. Nesse padrão, a disponibilidade é obtida simplesmente clonando os aplicativos e garantindo que seja possível estabelecer uma conexão entre o cliente (usuário, dispositivo) e o aplicativo.
O balanceador de carga (ou proxy, se preferir) recebe uma solicitação de conexão, seleciona uma instância disponível do aplicativo e encaminha a conexão. Essa é a última vez que o balanceador de carga participa ativamente. É como aquele “e-mail de apresentação” em que você coloca dois colegas em contato. Você participa ativamente da interação inicial, mas depois passa para o campo Cc e, em geral, não volta a se envolver.
Uso o termo POLB porque a escolha de como direcionar as solicitações envolve apenas algoritmos. Infelizmente, muitas coisas podem dar errado dependendo do algoritmo usado para distribuir as solicitações. Por exemplo, o round robin não leva em conta a capacidade nem o desempenho. Ele simplesmente seleciona “o próximo aplicativo” e encaminha a solicitação. A escolha de “menos conexões” pode afetar rapidamente o desempenho ao sobrecarregar um recurso, enquanto outros poderiam ser mais rápidos. A escolha dos algoritmos torna-se um componente essencial para manter a disponibilidade.
O POLB é o método padrão de balanceamento de carga em ambientes de contêineres e em muitos serviços de balanceamento de carga nativos da nuvem.
Persistência
Sessões persistentes e SSL
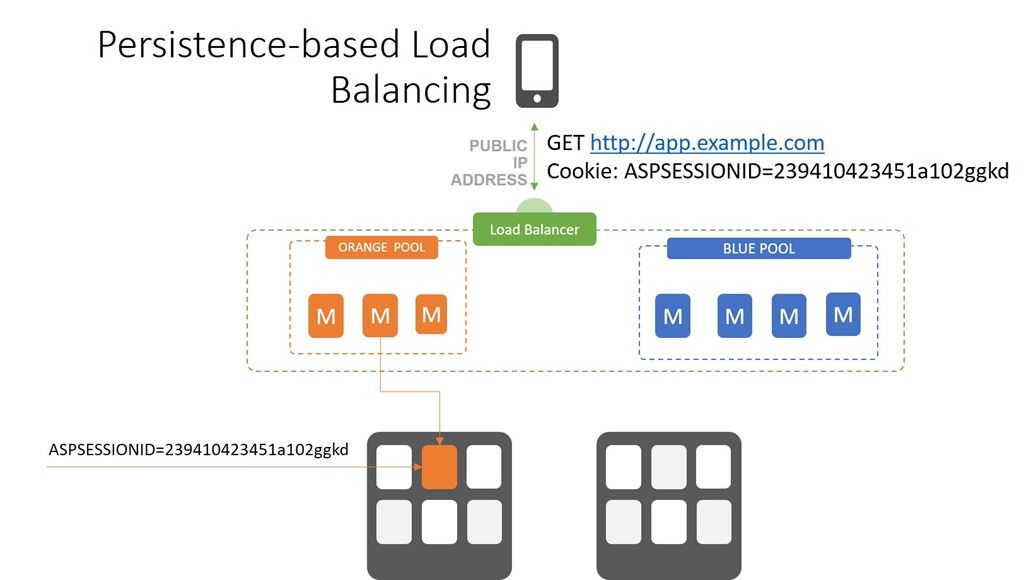
Uma das realidades das aplicações de três camadas é que, em geral, elas mantêm estado. Isso significa que armazenam, entre requisições e respostas, informações essenciais para o funcionamento da aplicação. Seu carrinho de compras, suas credenciais, seu status, a última página que você visitou e a etapa atual de um processo são alguns dos dados frequentemente armazenados como parte da “sessão”. A questão é que muitas aplicações desenvolvidas com frameworks de três camadas acabaram armazenando essa sessão no servidor de aplicações ou no servidor web, e não em um banco de dados. Isso significava que, depois de se conectar a um servidor, você precisava continuar acessando esse mesmo servidor para garantir que todas as suas informações estivessem disponíveis.
Os balanceadores de carga implementavam a persistência de várias maneiras, sendo a mais popular baseada em cookies. Os IDs de sessão eram armazenados em um cookie e, em seguida, usados pelo balanceador de carga para garantir que as solicitações fossem encaminhadas ao servidor correto, contornando efetivamente um processo de seleção algorítmica.
Quando o uso de SSL/TLS se tornou um requisito essencial para que os consumidores se sentissem seguros, surgiram os mesmos problemas. O SSL/TLS estabelece uma sessão segura entre um cliente e um servidor de aplicação específico. Para garantir que ambas as partes da comunicação pudessem descriptografar e usar os dados trocados por essa conexão, o balanceador de carga precisava encaminhar as solicitações do cliente para o mesmo servidor em que a sessão havia sido iniciada. Usando as mesmas técnicas que viabilizam a persistência baseada em sessão, os balanceadores de carga passaram a oferecer suporte à persistência baseada em SSL/TLS.
Independentemente do tipo específico de persistência utilizado, o padrão é o mesmo. Se houver um indicador de que uma sessão já foi estabelecida, o balanceador de carga mantém a conexão existente e garante que ela permaneça ativa durante toda a sessão do usuário. Caso contrário, o balanceador de carga seleciona um recurso com base em sua configuração e em seus algoritmos e estabelece a conexão.
Isso tem implicações no planejamento de capacidade ao selecionar um algoritmo de balanceamento de carga. O algoritmo de menor número de conexões é uma boa opção para esse cenário, pois garante que nenhum recurso fique sobrecarregado com sessões em andamento enquanto outros permanecem ociosos. Com outros algoritmos, existe a possibilidade de um único recurso acabar mantendo muitas sessões de usuários simultaneamente, o que afeta negativamente o desempenho de todos os usuários direcionados a esse servidor.
Balanceamento de carga baseado em host
Servidores virtuais
O balanceamento de carga baseado em host é um dos padrões de escalabilidade mais comuns e amplamente suportados. Você pode achar que não precisa de um balanceador de carga para implementá-lo, já que todos os servidores web podem se passar por vários hosts ao mesmo tempo. Mas precisa. Embora um servidor web/de aplicativos possa hospedar vários servidores virtuais, ele não necessariamente distribui a carga entre eles. Portanto, você ainda precisa de um balanceador de carga para escalar. A questão é: o balanceador de carga separará os hosts ou você deixará essa tarefa a cargo do servidor web/de aplicativos?
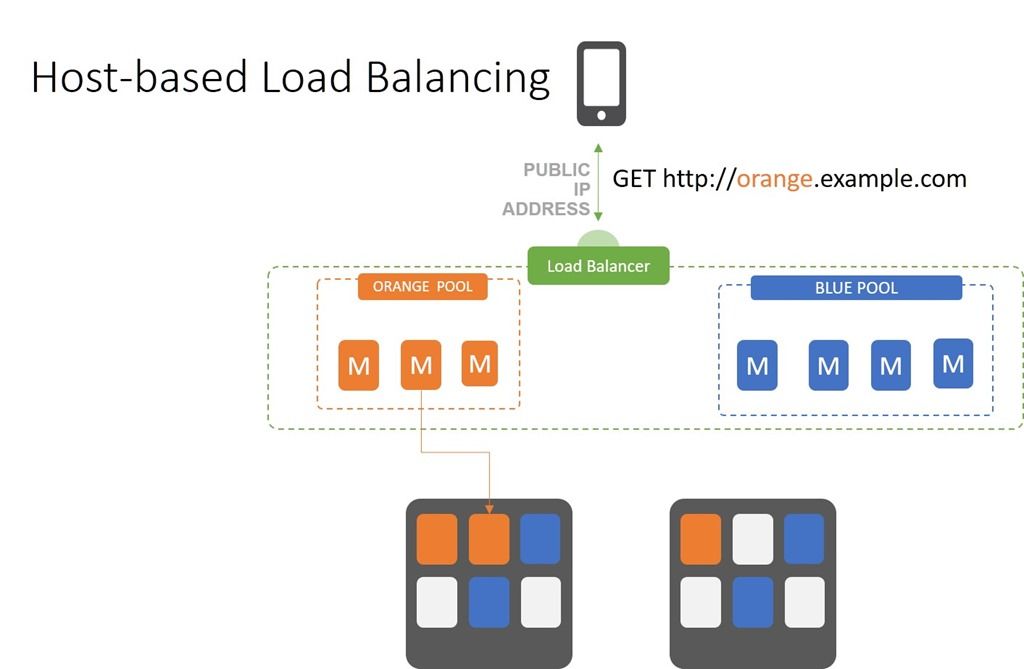
Seja usando diretivas do servidor web/de aplicativos ou um balanceador de carga externo, o fluxo permanece o mesmo. Uma solicitação é feita e recebida pelo destino (balanceador de carga ou servidor web/de aplicativos). Em seguida, o servidor de destino inspeciona os cabeçalhos HTTP e identifica o valor do host antes de direcionar a solicitação ao servidor virtual apropriado.
A vantagem de usar um balanceador de carga para separar hosts está na capacidade de isolar domínios com base no host e dimensioná-los individualmente. Isso é mais eficiente e pode reduzir o número de servidores (hardware e software) necessários para dimensionar uma aplicação. Além disso, facilita o planejamento de capacidade, pois permite prever melhor a carga que cada servidor host pode suportar em um determinado momento.
Isso ocorre porque a execução da lógica de negócios não exige o mesmo nível de processamento que a solicitação de uma imagem. Combinar diferentes hosts no mesmo domínio de escalabilidade gera uma carga volátil e uma capacidade imprevisível. Se você optar por usar um balanceador de carga para realizar apenas o balanceamento de carga convencional, o servidor web/de aplicativos ficará responsável por separar os hosts e direcionar as solicitações ao servidor virtual apropriado. Essa abordagem também apresenta outras desvantagens relacionadas ao compartilhamento da infraestrutura, como conflitos de versão, aplicação de patches e atualizações de aplicativos, que podem gerar atritos entre os servidores virtuais.
A crescente adoção de contêineres e microsserviços está impulsionando o uso do balanceamento de carga baseado em host na forma de controladores de ingresso.
Roteamento e retorno
Balanceamento de carga na camada 7 (HTTP)
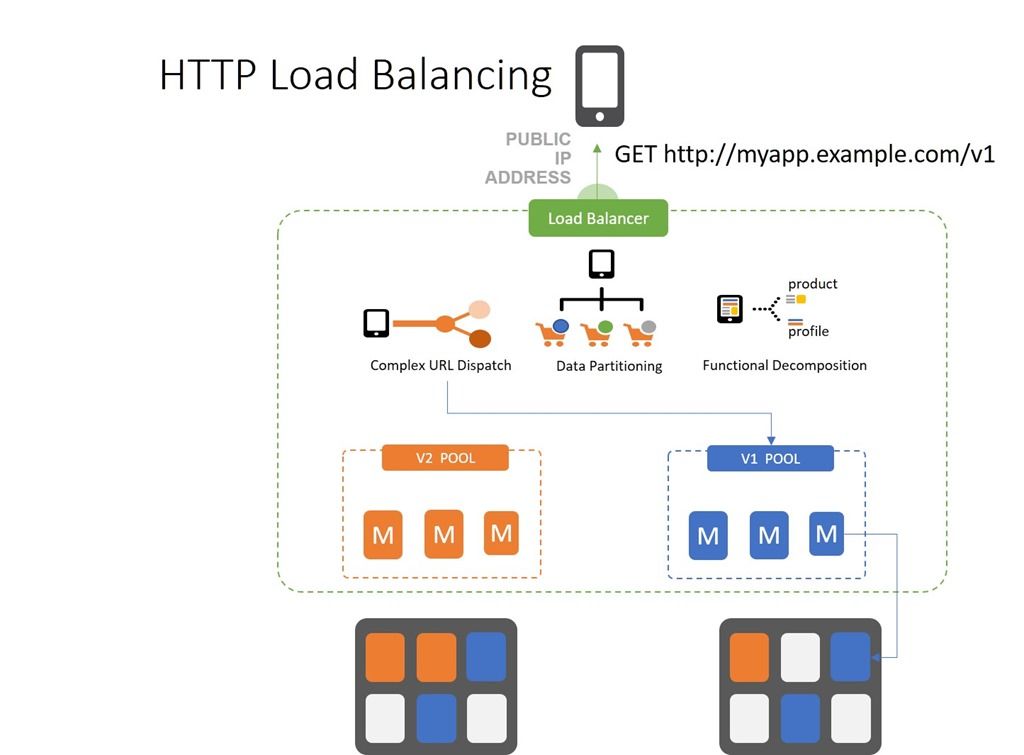
O balanceamento de carga na camada 7 (HTTP) é o meu favorito graças à versatilidade (agilidade?) que oferece. É possível balancear as solicitações com base em qualquer elemento HTTP — inclusive o payload. A maioria das pessoas (acertadamente, na minha opinião) restringe suas regras de balanceamento de carga ao que pode ser encontrado no cabeçalho HTTP. Isso inclui o host, o método HTTP, o tipo de conteúdo, os cookies, os cabeçalhos personalizados e o agente do usuário, entre outros.
O balanceamento de carga HTTP envolve primeiro o roteamento e, depois, o balanceamento de carga. Um padrão típico de balanceamento de carga HTTP segue o formato rotear –> distribuir. Isso significa que primeiro é tomada uma decisão sobre para qual servidor virtual uma solicitação deve ser direcionada e, em seguida, um algoritmo seleciona um recurso do pool que dá suporte a esse servidor virtual.
O balanceamento de carga HTTP permite padrões como o versionamento de APIs, em que a versão da API é incorporada ao URI (ou a um cabeçalho HTTP personalizado). O balanceador de carga consegue separar as versões e garantir que os clientes sejam encaminhados ao serviço de back-end correto para execução. Isso permite uma migração gradual dos clientes em situações nas quais não é possível forçar a atualização.
Esse tipo de padrão de escalabilidade também oferece suporte a outros padrões, como decomposição funcional e particionamento de dados. É o padrão de escalabilidade mais robusto e ágil entre os disponíveis e oferece uma ampla variedade de opções para expandir aplicativos e, cada vez mais, microsserviços.
Então, resumindo, temos cinco padrões principais de escalabilidade, a maioria dos quais pode ser (e muitas vezes é) combinada para permitir o uso mais eficiente dos recursos e o melhor desempenho possível. É bem provável que, se você ainda não estiver usando um deles, venha a usá-lo. Portanto, entender sua composição básica é uma boa base para criar uma arquitetura escalável, independentemente do tipo de aplicativo que você usa ou de onde ele esteja implantado.
Continue escalando!
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...