
Contexto
Em dois artigos anteriores, abordamos aspectos do design orientado por dados e, mais especificamente, como os dados empresariais representam um valor de negócio latente. A principal mensagem foi que uma arquitetura de dados estruturada é a base técnica que permite extrair esse valor inerente. No entanto, esses artigos se concentraram em apresentar os tópicos relevantes em um nível conceitual. Hoje, gostaria de demonstrar esses conceitos no contexto de um exemplo mais concreto e próximo da realidade: uma história sobre como pensar a arquitetura de uma aplicação de acordo com uma mentalidade que prioriza os dados.
Mas, antes de tudo — por que isso deveria me interessar?
Antes de irmos direto à história, porém, vamos relembrar por que os dados são mais importantes hoje do que no passado. Historicamente, muitas empresas coletam e armazenam dados principalmente como um fim em si mesmo, por motivos de governança, como auditoria e conformidade. Por isso, a coleta e o armazenamento de dados têm sido vistos como uma espécie de “imposto” sobre as operações empresariais, com pouco valor operacional direto percebido para o negócio.
O que mudou agora é a compreensão mais ampla de que os dados coletados podem ser explorados para otimizar os processos de negócios e melhorar a experiência do cliente. Por exemplo, de acordo com uma pesquisa recente com empresas de varejo digital, esses dois objetivos — aprimorar os processos de negócios e a experiência do cliente — foram os principais impulsionadores da transformação digital para 57% de todas as empresas pesquisadas. A observação crucial, a essência de “por que isso é importante”, é que os fluxos de trabalho orientados por dados afetam os negócios tanto em áreas voltadas para o público externo (como a experiência do cliente) quanto em áreas internas, relacionadas aos principais processos de negócios. É por isso que uma estratégia de dados criteriosa e deliberada é fundamental para garantir a qualidade e a relação custo-benefício dos fluxos de trabalho mais importantes da empresa. Além disso, quando os fluxos de trabalho são instrumentados para transmitir os dados residuais observados a uma infraestrutura de coleta e análise de dados, eles próprios podem ser continuamente analisados e aprimorados, resultando em fluxos de trabalho empresariais constantemente adaptáveis e otimizados.
Como observação adicional, a maior preocupação dessas mesmas empresas em relação à transformação digital era garantir a segurança cibernética desses processos digitais — que, por sinal, é outra área em que essa mesma abordagem de telemetria e análise de dados desempenha um papel fundamental —, mas deixarei esse assunto para outro artigo.
A aplicação: pedidos e entregas de restaurantes
Prosseguindo com nosso experimento mental, escolhi uma situação com a qual muitos de nós provavelmente conseguimos nos identificar no atual estilo de vida adaptado ao coronavírus: um aplicativo que oferece um serviço on-line para pedir comida de restaurantes e recebê-la por entrega. As refeições são pedidas on-line em um restaurante escolhido pelo cliente, e o usuário pode optar por retirar o pedido pessoalmente ou solicitar que o serviço também faça a entrega.
Nesta história, desempenharemos o papel de Proprietário da Aplicação. Nessa função, precisamos lidar com diversas questões, que dividiremos em duas categorias: primeiro, as atividades operacionais necessárias; segundo, as questões estratégicas voltadas para o futuro.
O primeiro conjunto — atividades operacionais obrigatórias — inclui questões como:
- Encontrar e caracterizar restaurantes, incluindo sua localização e horário de funcionamento
- Compilação de dados sobre itens do cardápio e preços
- Informar os restaurantes sobre os pedidos
- Processamento de pagamentos
- Manter dados sobre a disponibilidade de recursos humanos para coletar e entregar pedidos
- Acompanhamento da preparação do pedido e do status da entrega
O segundo conjunto de questões está menos relacionado às operações do dia a dia, mas não é menos importante. Essas questões, se consideradas desde o início, permitirão que a empresa seja ágil, adaptável e esteja em constante aprimoramento. Alguns exemplos desse tipo de questão são:
- Como a demanda pode ser prevista? Pode-se considerar simplesmente a demanda agregada por horário do dia ou dia da semana, ou adotar uma granularidade maior, como por restaurante.
- Que tipos de ferramentas, processos ou fluxos de trabalho fornecem insights de negócios aos meus fornecedores (restaurantes)?
- Como os preços — seja dos alimentos ou da entrega — podem ser ajustados dinamicamente?
- Supondo que minha aplicação esteja hospedada na nuvem pública, como posso otimizar meus custos operacionais de infraestrutura?
Este é, naturalmente, apenas um subconjunto de toda a variedade de questões que teríamos, mas mesmo esse conjunto menor é suficiente para promover uma boa discussão que ressalte a importância de uma arquitetura de dados estruturada para dar suporte a um pipeline extensível de processamento de dados.
Arquitetura de dados ou pipeline de dados: o ovo ou a galinha
Em nosso papel hipotético de Proprietário do Aplicativo, ao considerarmos nossa estratégia geral de dados, podemos começar enumerando nossos fluxos de trabalho de negócios e identificando as necessidades de processamento de dados de cada um. Um exemplo é o fluxo de trabalho que localiza restaurantes abertos nas proximidades e, em seguida, apresenta as opções do cardápio e os preços dos itens de cada um — ele precisaria filtrar os restaurantes por localização e horário de funcionamento e, depois, consultar as opções do cardápio de um restaurante especificamente selecionado, talvez também considerando a disponibilidade de entregadores. Poderíamos fazer isso para cada fluxo de trabalho — processamento de pagamentos, associação de entregadores a entregas e assim por diante.
Ou, de forma igualmente razoável, poderíamos começar nossas considerações pelos “átomos” básicos de dados — os componentes fundamentais de dados necessários. Identificaríamos e enumeraríamos os átomos de dados importantes, dando atenção especial à uniformidade de sua representação e à consistência de sua semântica, bem como a qualquer vocabulário de metadados necessário para dar suporte aos nossos fluxos de trabalho de negócios. Exemplos de átomos de dados em nosso aplicativo de exemplo incluiriam: dados de localização de restaurantes, clientes e entregadores; itens alimentícios necessários para cardápios e faturas; tempo, usado para filtragem e acompanhamento da qualidade da entrega; e informações de pagamento, associadas aos fluxos de trabalho de pagamentos de clientes e entregadores.
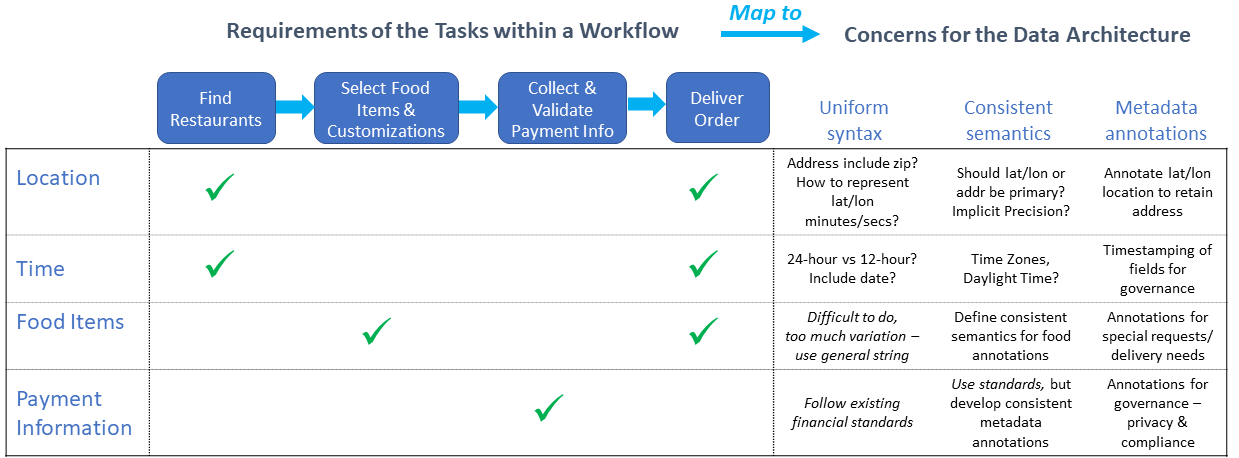
A escolha de qual desses dois possíveis pontos de partida usar em nossa estratégia de dados — o pipeline de processamento de dados dos fluxos de trabalho ou, alternativamente, os “átomos” de dados — é uma questão de quem veio primeiro, o ovo ou a galinha. Ambas as perspectivas são úteis e, mais importante, interdependentes. Não podemos analisar o pipeline de processamento de dados sem pensar nos átomos de dados subjacentes, nem desenvolver a arquitetura de dados sem considerar as necessidades do pipeline de processamento. Dito isso, em geral, eu recomendaria uma abordagem em que se faça uma análise inicial dos fluxos de trabalho para enumerar os átomos de dados e, em seguida, se passe ao projeto estruturado da arquitetura de dados antes de elaborar o projeto detalhado do pipeline de dados. Isso porque os fluxos de trabalho são mais dinâmicos: eles são adicionados e modificados à medida que a empresa evolui, enquanto os dados subjacentes têm mais história e inércia — e, portanto, a arquitetura de dados se beneficia mais de um planejamento antecipado.
Aplicando uma abordagem holística de arquitetura e pipeline de dados a exemplos concretos
Voltando ao nosso exemplo, vamos supor que, como Proprietário do Aplicativo, tenhamos uma visão bastante desenvolvida dos principais fluxos de trabalho críticos para os negócios e dos átomos de dados necessários para sustentá-los. Anteriormente nesta discussão, identificamos alguns dos elementos de dados fundamentais necessários para nossos fluxos de trabalho: localização, horário, itens alimentícios e informações de pagamento. E, recapitulando os artigos anteriores, a arquitetura de dados deve viabilizar três objetivos principais: uniformidade da sintaxe, consistência da semântica e um vocabulário de metadados para analisar e governar os dados. Agora, podemos aplicar esses princípios para discutir as considerações de arquitetura de dados referentes aos átomos de dados específicos enumerados no exemplo de hoje.
Analisando mais de perto o átomo de dados de localização, considere cada um dos três principais objetivos da arquitetura de dados.
- Primeiro, qual é a sintaxe uniforme de representação de dados?
Uma ideia inicial pode ser representar a localização por meio do endereço, já que é assim que restaurantes e clientes normalmente representam sua localização. No entanto, considere as necessidades de localização para rastrear os entregadores durante as entregas — eles geralmente estão em movimento, talvez em uma rodovia importante ou em um local que não seja bem descrito por um endereço. Em vez disso, especificar a latitude e a longitude pode ser uma forma melhor de representar a localização nesse fluxo de trabalho, e esse formato ainda funcionaria para as localizações de restaurantes e clientes. Porém, como os entregadores normalmente precisam se deslocar até um restaurante ou até a localização de um cliente, ainda deve haver uma forma de relacionar a localização (lat/long) de um entregador à localização (endereço) de um cliente. Portanto, uma escolha mais criteriosa pode ser normalizar todos os dados de localização em latitude e longitude (a representação “canônica” obrigatória), mas com a possibilidade de converter endereços em lat/long quando o endereço for fornecido pela primeira vez (um fluxo de trabalho de “ingestão”). - A segunda consideração diz respeito à consistência semântica.
Supondo que a localização seja normalizada como latitude/longitude, isso é relativamente simples, pois esse é um padrão bem estabelecido e de interpretação inequívoca. No entanto, outro aspecto da consistência semântica está relacionado à precisão — a exatidão implícita dos dados. Como os dados de GPS e de mapeamento terão uma exatidão inerentemente limitada, podemos optar por especificar a localização com uma precisão constante (por exemplo, até o segundo de arco mais próximo, aproximadamente 30 metros) ou com uma precisão variável, dependendo da qualidade da fonte de dados. Se escolhermos a segunda opção para obter maior flexibilidade, precisaremos indicar — usando metadados, descritos a seguir — a precisão de cada instância de dados de localização. - O terceiro objetivo da arquitetura de dados é ter a capacidade de anotar e enriquecer os elementos de dados coletados.
No caso da localização, isso pode incluir a precisão dos dados, conforme mencionado anteriormente. Além disso, também podemos querer anotar a localização com um endereço para facilitar a compreensão por pessoas e, principalmente, para que os dados de endereço importados possam ser preservados. Isso é especialmente importante nos casos em que vários endereços podem corresponder à mesma latitude/longitude, como em um condomínio residencial. Outro enriquecimento possível seria registrar a data e a hora em que o campo de localização foi coletado, o que pode ser relevante para um motorista em movimento, pois os dados de localização ficam desatualizados rapidamente.
Até agora, falamos apenas sobre os requisitos de localização e poderíamos fazer agora uma análise semelhante para cada um dos outros campos de dados. No entanto, em vez de enumerar todas as questões relacionadas a cada um dos elementos de dados, destacarei algumas observações importantes:
- Com relação ao átomo de dados Tempo: a representação de um valor de tempo é notoriamente complexa. Ela pode variar tanto sintaticamente (por exemplo, formato de 24 horas em vez de 12 horas com AM/PM) quanto semanticamente (por exemplo, o conceito de fusos horários e as variações na adoção do horário de verão). Portanto, provavelmente será necessário padronizar a representação do tempo (por exemplo, normalizando-a para GMT ou usando segundos “desde a época”, para usuários de Unix/Linux).
- Item alimentar pode ter instâncias bastante variadas, com necessidades específicas. Como esses átomos de dados geralmente têm formato livre, um vocabulário canônico de metadados é mais útil do que tentar adotar uma sintaxe uniforme. Alguns campos de metadados seriam destinados a propriedades estáticas de cada item, como “precisa ser mantido refrigerado” ou “contém nozes”, enquanto outros seriam necessários para informações específicas de cada instância (cada pedido) do item alimentar, como “nível de picância” ou “condimentos preferidos”. Em ambos os casos, o objetivo do projeto exige sintaxe uniforme e semântica consistente para os campos de metadados, para que possam ser compartilhados por todo o inventário de itens do cardápio.
- Outras considerações importantes são a conformidade e a governança de dados. Um dos aspectos é a política de retenção de dados, segundo a qual alguns campos — como o endereço IP de um cliente ou o histórico de localização de um entregador — só podem ser armazenados por um curto período. Outra consideração comum é que alguns campos podem estar sujeitos a restrições de segurança ou privacidade; um exemplo são as informações de pagamento. O enriquecimento com metadados é uma solução para ambos os casos. Os metadados devem ser usados para associar a um endereço IP ou valor de localização um prazo de expiração para fins de retenção de dados. No caso das informações de pagamento, os metadados podem ser usados para indicar requisitos de segurança — como a necessidade de criptografar os dados em repouso — ou para especificar restrições de geolocalização do armazenamento persistente de dados.
Embora este exemplo tenha apenas arranhado a superfície, ele destacou muitas das questões associadas a cenários reais. No mundo real, porém, o processo de reflexão sobre a estratégia de dados não terminaria aqui, mas seria iterativo e contínuo. À medida que os elementos de dados fossem inseridos nos pipelines de processamento de dados que materializam os fluxos de trabalho de negócios, ajustes e aprimoramentos iterativos seriam feitos na arquitetura de dados. À medida que os fluxos de trabalho existentes fossem aprimorados e novos fluxos fossem adicionados, descobriríamos requisitos adicionais de arquitetura de dados para os átomos de dados existentes, além de novos átomos de dados.
Considerações finais
Embora este exemplo tenha sido simplificado para fins de concisão, ele ainda demonstra os princípios fundamentais do mapeamento dos fluxos de trabalho e de suas implicações para a arquitetura de dados. O processo sempre começa pela análise das necessidades do negócio — a experiência do cliente e os processos de negócio necessários para atender a essas necessidades. Os processos de negócio, por sua vez, definem os elementos de um vocabulário de negócios. No nível seguinte de especificidade, os processos são mapeados para um pipeline de dados, que utiliza um vocabulário de dados.
O princípio fundamental é que uma arquitetura de dados robusta — que defina sintaxe, semântica e anotações — estabelece uma base que permite aprimorar o pipeline de dados com eficiência e adicionar novos fluxos de trabalho com facilidade. No nível de abstração da camada de negócios, isso significa que os processos de negócios existentes podem ser facilmente modificados, e processos novos ou emergentes podem ser rapidamente colocados em operação. Por outro lado, deixar de tomar decisões criteriosas em qualquer uma dessas áreas — vocabulário de dados, estrutura da arquitetura de dados ou vinculação desses elementos às necessidades do negócio — acabará resultando em um sistema rígido e frágil, incapaz de se adaptar com agilidade a novos requisitos de negócios.
Sobre o autor
Publicações relacionadas no blog

O estado da maturidade digital empresarial: a transformação digital ainda não terminou
Explore como a IA impacta as empresas, as aplicações da IA generativa, as estratégias para modernizar as operações de TI e os benefícios da maturidade digital com a F5.
Como a IA generativa acelera a transformação digital
Veja como a IA generativa impulsiona a transformação digital nas empresas, acelerando tendências como a integração de APIs, os desafios dos modelos operacionais de TI híbrida e a adoção de AIOps.
Seis capacidades técnicas para acelerar a transformação digital
As arquiteturas empresariais atuais carecem dos fatores necessários de agilidade, escalabilidade, segurança e observabilidade, essenciais para impulsionar a mudança tecnológica. No entanto, estas seis capacidades fundamentais ajudarão as empresas a gerenciar riscos e desafios ao longo de sua transformação digital.
Inverter a API é a transformação digital de que as empresas precisam para participar e competir em uma economia de APIs
As organizações detêm um valor latente — na forma de APIs internas — que precisam explorar para competir em uma economia de APIs. Embora os desafios técnicos e de segurança possam desestimular algumas delas, as empresas precisam reconhecer que inverter suas APIs permitirá liberar o valor da organização como plataforma.
A modernização da TI começa pela infraestrutura
O hardware e o software evoluíram rapidamente desde os primórdios da internet, mas, para aproveitar ao máximo os benefícios resultantes dessa evolução, as organizações precisam avaliar e modernizar sua infraestrutura e a entrega de aplicativos. Acelere os esforços de modernização com a nova F5 rSeries.