IA escalável
Sistemas de IA que continuam operando de forma confiável à medida que conjuntos de dados, modelos, populações de usuários e cargas de trabalho crescem.
IA escalável refere-se à capacidade de sistemas, modelos, pipelines de dados, infraestrutura e operações de IA de manter o desempenho, a confiabilidade e a eficiência de custos à medida que a demanda e a complexidade aumentam. É a diferença entre um projeto-piloto de IA que funciona em laboratório e uma solução de IA capaz de atender a cargas de trabalho empresariais reais em grande escala.
O que é IA escalável?
A IA escalável cria sistemas que se expandem para gerenciar mais dados, mais usuários, modelos maiores e locais distribuídos, sem perda de desempenho nem custos elevados. A verdadeira escalabilidade exige um crescimento sincronizado em toda a pilha de IA, incluindo pipelines de dados, modelos, clusters de GPUs, redes, inferência e operações.
Um modelo que funciona no ambiente de desenvolvimento muitas vezes não avança quando chega à escala de produção: os pipelines de dados não estão prontos, os endpoints de inferência têm dificuldades para lidar com acessos simultâneos ou a rede se torna o gargalo, em vez da capacidade computacional.
A escalabilidade se manifesta em várias dimensões fundamentais:
- Escalabilidade de dados: Migração de conjuntos de dados pontuais para pipelines em tempo real e de alto rendimento
- Escalabilidade de modelos: Expansão de um único modelo para vários modelos e variantes implantados em diferentes regiões
- Escalabilidade da infraestrutura: Garantir que GPU/CPU, armazenamento e rede acompanhem o crescimento
- Escalabilidade operacional: Aprimoramento dos processos de lançamento, da observabilidade, da engenharia de tráfego e da gestão de custos
Quando implementada de forma eficaz, a IA escalável oferece um desempenho confiável e consistente à medida que as cargas de trabalho aumentam. Essa transformação faz com que a IA deixe de ser apenas um conjunto de experimentos-piloto e se torne uma capacidade robusta em toda a empresa. Ao estabelecer uma base sólida para o gerenciamento de tráfego, a segurança e a visibilidade — áreas nas quais a F5 concentra seus esforços —, as empresas podem escalar a IA com rapidez e confiança, sem correr o risco de causar instabilidade nos sistemas ou acumular uma dívida operacional oculta.
Por que a IA escalável é importante?
Sem escalabilidade, as iniciativas de IA rapidamente atingem um limite. As organizações podem criar provas de conceito (POCs), mas escalar para atender a milhares ou milhões de solicitações diárias é um desafio diferente.
É fundamental abordar a IA escalável porque:
- A demanda dos negócios supera a capacidade das arquiteturas iniciais, e a integração da IA acelera o crescimento do tráfego de forma imprevisível. A maioria das implementações de IA começa com um único modelo, fluxo de trabalho e equipe. Após a demonstração de valor, a adoção se expande entre as unidades, causando picos de tráfego à medida que novos aplicativos se conectam a endpoints compartilhados. Sistemas inicialmente projetados para processar milhares de solicitações por hora passam a processar milhões por dia. Sem uma infraestrutura de rede escalável, esse rápido crescimento pode sobrecarregar a infraestrutura.
- Os sistemas de IA podem apresentar falhas sutis em grande escala, causando picos de latência, subutilização de GPUs, sobrecarga de modelos ou interrupções nos pipelines de dados que comprometem a confiabilidade. As falhas de IA raramente causam grandes indisponibilidades; geralmente, elas resultam em degradação do desempenho. Muitas vezes, as GPUs ficam ociosas, as filas de inferência se acumulam sob alta carga ou ocorrem picos de latência nos horários de maior demanda. Um padrão de tráfego direcionado incorretamente ou um fragmento de dados lento pode interromper todo o pipeline. Esses problemas sistêmicos geralmente surgem sob carga real, o que dificulta o diagnóstico sem a observabilidade adequada e recursos inteligentes de gerenciamento de tráfego.
- Os custos operacionais aumentam rapidamente devido a caminhos de inferência ineficientes, concorrência não gerenciada e tráfego mal dimensionado, o que pode duplicar ou triplicar os gastos com a nuvem. Os custos de inferência aumentam devido à má gestão do tráfego, a solicitações não agrupadas em lotes, à distribuição desigual da carga, a caminhos de GPU sem aquecimento ou ao roteamento inadequado, levando a escalonamento desnecessário e provisionamento excessivo. As GPUs na nuvem são caras; sem uma gestão adequada, as equipes acabam pagando por GPUs ociosas ou réplicas excedentes. Muitas empresas constatam que os problemas de rede, e não a complexidade dos modelos, são os principais responsáveis pelos custos e gastos com inferência.
- Conformidade e governança exigem ferramentas empresariais. A IA em produção requer mecanismos de proteção que os projetos-piloto não exigem. Os primeiros projetos-piloto de IA muitas vezes não contam com controles formais, como segurança de APIs, rastreamento da linhagem de modelos e governança de dados. No entanto, quando a IA lida com dados de clientes, fluxos de trabalho regulamentados ou conteúdo sensível, as organizações precisam garantir medidas de proteção, como aplicação de políticas, trilhas de auditoria, controles de acesso, criptografia e gerenciamento de versões. Essas medidas são essenciais para implantar IA nos setores financeiro, de saúde e governamental, bem como em empresas globais.
- A vantagem competitiva aumenta à medida que a escala cresce. Inferências mais rápidas, mais iterações dos modelos e experiências de usuário aprimoradas geram uma diferenciação duradoura. A escalabilidade protege o sistema e impulsiona a inovação. As equipes que retreinam modelos rapidamente, implantam atualizações ou oferecem inferência de baixa latência conquistam vantagens competitivas. Os usuários percebem respostas mais ágeis, os recursos são lançados com mais rapidez e os modelos são aprimorados com maior frequência. Essa agilidade operacional cria uma barreira competitiva difícil de superar.
A IA escalável permite que uma empresa amplie seus casos de uso com confiança, seja para atender a um número maior de usuários, implementar modelos mais complexos ou implantar IA em diversas regiões e plataformas de nuvem.
Como funciona a IA escalável?
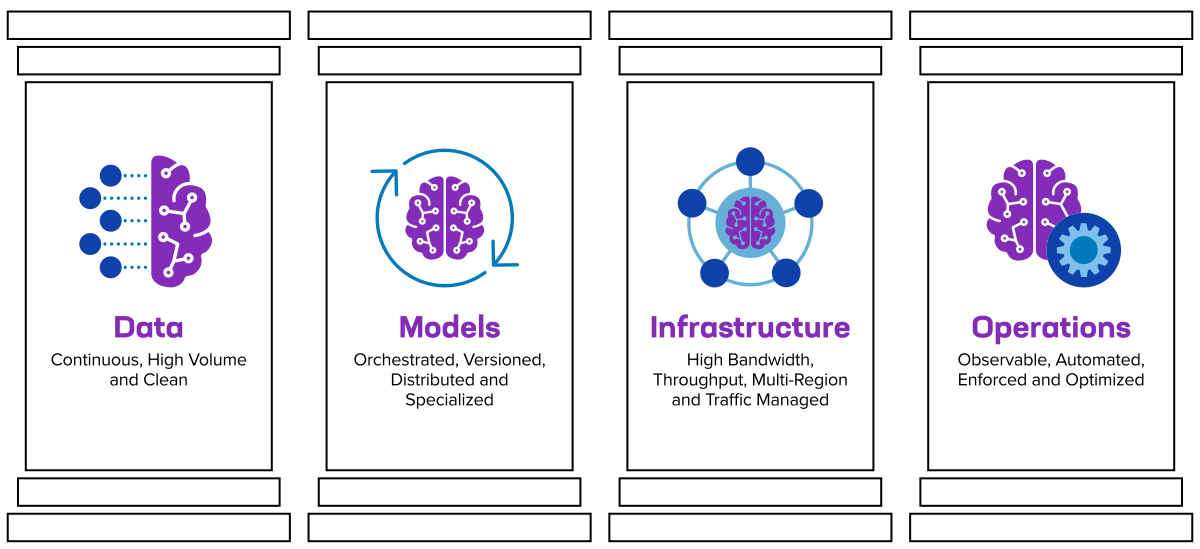
A IA escalável funciona por meio da coordenação de quatro pilares de crescimento: dados, modelos, infraestrutura e operações. Todos os quatro precisam estar alinhados. Se apenas um deles ficar para trás, todo o sistema ficará limitado.
1. Escalabilidade de dados
Os dados costumam ser o primeiro gargalo. Os sistemas de IA precisam de pipelines de dados contínuos, limpos e de alto volume para viabilizar o treinamento e a inferência sem sobrecarregar as GPUs nem interromper os fluxos de trabalho, mesmo com o aumento do volume de dados.
- Ingestão contínua de dados: Os pipelines de IA devem coletar dados em tempo real de várias fontes de forma confiável e segura, garantindo que os modelos usem dados de entrada atualizados e precisos.
- Pipelines de dados de alto desempenho: Os sistemas devem fornecer dados rapidamente para manter as GPUs totalmente utilizadas e evitar períodos de ociosidade causados por fluxos de entrada lentos ou inconsistentes.
- Repositórios de atributos e bancos de dados vetoriais: Esses sistemas padronizam, armazenam e disponibilizam atributos ou embeddings em escala, garantindo reprodutibilidade e inferência de baixa latência.
- Controles de qualidade e consistência dos dados: Dados limpos, validados e com rastreabilidade de linhagem reduzem o desvio do modelo, evitam falhas no pipeline e aumentam a confiança nos resultados gerados pelo modelo.
- Sistemas de armazenamento escaláveis: O armazenamento subjacente deve crescer junto com o conjunto de dados, permitindo acesso paralelo, recuperação rápida e desempenho previsível à medida que o volume aumenta.
2. Modelos de escalabilidade
As empresas passam rapidamente de um único modelo para centenas deles, incluindo versões destiladas, variantes específicas para determinadas tarefas e modelos com ajuste fino. A escalabilidade de modelos vai além do simples aumento do número de parâmetros; ela inclui:
- Orquestração de múltiplos modelos: A coordenação de vários modelos garante que o modelo certo seja executado no momento adequado, sem sobrecarregar o endpoint.
- Versionamento, implantações e reversões: O gerenciamento de versões de modelos com implantações controladas e reversões instantâneas evita interrupções e possibilita melhorias contínuas e seguras.
- Inferência distribuída: Executar a inferência em vários nós ou regiões reduz a latência e equilibra a carga, evitando gargalos em uma única GPU ou em um único cluster.
- Especialização de modelos por região ou caso de uso: A implantação de variantes personalizadas para diferentes mercados ou tarefas melhora o desempenho e a eficiência ao adequar cada modelo ao seu contexto ideal.
3. Escalabilidade da infraestrutura
As cargas de trabalho de IA exigem computação, armazenamento e redes de alto desempenho. À medida que o uso aumenta, as organizações precisam ampliar a capacidade de GPUs e:
- Rede de alta largura de banda: A rede deve oferecer caminhos de baixa latência e alta taxa de transferência para que as GPUs continuem recebendo dados, em vez de ficarem ociosas devido a conexões congestionadas.
- Armazenamento de alto desempenho: Os sistemas de armazenamento precisam fornecer acesso contínuo e paralelo a enormes conjuntos de dados para evitar gargalos de E/S durante o treinamento e a inferência.
- Implantação multirregional: Distribuir a infraestrutura entre diferentes regiões aumenta a resiliência e reduz a latência ao posicionar os recursos computacionais e os modelos mais perto dos usuários e das fontes de dados
- Direcionamento de tráfego e balanceamento de carga à velocidade de linha: O roteamento de tráfego inteligente e de alta velocidade garante que as solicitações de inferência sejam distribuídas uniformemente, mantendo os clusters de GPUs totalmente utilizados e evitando pontos de sobrecarga.
A infraestrutura precisa permanecer eficiente porque a capacidade de GPU é cara, e o roteamento ineficiente do tráfego resulta em desperdício.
4. Escalonamento das operações
Nem mesmo o hardware mais robusto consegue compensar operações deficientes. A IA empresarial exige:
- Observabilidade de latência, taxa de transferência e custo por inferência: As equipes precisam de visibilidade em tempo real sobre o comportamento do modelo e da infraestrutura para detectar gargalos, otimizar o desempenho e evitar falhas silenciosas.
- Resposta a incidentes de degradação do modelo: Quando a precisão cai ou a latência aumenta repentinamente, as organizações precisam diagnosticar rapidamente as causas-raiz e restabelecer a estabilidade do serviço sem afetar os usuários.
- Pipelines automatizados para implantação: Uma automação confiável garante que as atualizações dos modelos sejam transferidas com segurança do ambiente de desenvolvimento para o de produção, sem os riscos associados a etapas manuais.
- Aplicação de políticas e governança: Controles robustos são necessários para proteger os endpoints dos modelos, aplicar regras de acesso e garantir a conformidade em ambientes complexos de IA
- Visibilidade e otimização de custos: Monitorar o uso de GPUs, a inferência e a eficiência do roteamento ajuda as equipes a controlar os custos e evitar eventos de escalonamento desnecessários.
Como a F5 aborda as principais dimensões da IA escalável?
A F5 analisa a IA escalável sob a perspectiva dos principais desafios que as empresas enfrentam em engenharia de tráfego, segurança e visibilidade. Essas camadas muitas vezes se tornam o gargalo à medida que as cargas de trabalho de IA aumentam, mesmo em organizações equipadas com muitas GPUs e arquiteturas de modelos avançadas.
A F5 ajuda as empresas a escalar a IA por meio de:
- Maximizando a utilização de GPUs por meio do roteamento inteligente de tráfego: A taxa de transferência da inferência de IA varia conforme a distribuição das solicitações. O F5 BIG-IP Local Traffic Manager (LTM) oferece balanceamento de carga, roteamento com reconhecimento de modelos e caminhos de tráfego otimizados para baixa latência, mantendo os clusters de GPUs plenamente utilizados e eficientes, em vez de ficarem ociosos devido a fluxos de solicitações lentos ou irregulares.
- Eliminação de gargalos de rede: A inferência com alta simultaneidade pode sobrecarregar as pilhas de rede tradicionais muito antes de a capacidade computacional atingir o limite. A plataforma F5 BIG-IP e o F5 Distributed Cloud App Connect gerenciam situações de largura de banda extrema e reduzem o congestionamento, garantindo que o tráfego de inferência flua sem interrupções para todos os endpoints.
- Proteção de endpoints de inferência e APIs de modelos: Os serviços de IA dependem de APIs que precisam de proteção real de aplicações na camada 7, e não apenas de filtragem de pacotes. F5 BIG-IP Advanced WAF, F5 Distributed Cloud Web App and API Protection (WAAP) e F5 BIG-IP SSL Orchestrator oferecem inspeção aprofundada (inclusive de tráfego criptografado), aplicação de políticas, prevenção contra bots e abusos e proteções em tempo de execução para proteger modelos confidenciais e rotas de inferência.
- Fornecimento de visibilidade em ambientes híbridos de IA: O tráfego de IA ocorre em vários ambientes, muitas vezes com padrões pouco claros e inconsistentes. O F5 Distributed Cloud App Stack, juntamente com a função de streaming de telemetria do BIG-IP, fornece às equipes dados em tempo real sobre latência, taxa de transferência, desempenho dos endpoints de modelos, profundidade da fila e integridade das APIs, permitindo que os operadores otimizem o desempenho e resolvam problemas antes que afetem os usuários.
- Compatibilidade com pipelines de dados modernos, de alto throughput e compatíveis com S3: Para pipelines de ingestão e treinamento de IA com uso intensivo de dados, o BIG-IP acelera o tráfego de alto volume para o armazenamento de objetos compatível com S3. Com parceiros como a NetApp StorageGRID, a F5 garante que os pipelines de dados sejam dimensionados de forma eficiente para acompanhar as cargas de trabalho de treinamento e recuperação de modelos.
As camadas de tráfego, segurança e visibilidade da F5, fornecidas por meio do BIG-IP e dos Distributed Cloud Services, foram projetadas para garantir que as cargas de trabalho de IA permaneçam confiáveis, eficientes e com alto desempenho diante da crescente demanda.
Por que a escalabilidade é importante desde o início do desenvolvimento
Atualmente, os sistemas de IA evoluem mais rapidamente do que a infraestrutura que lhes dá suporte. Os modelos crescem, os casos de uso ampliam seu escopo e a simultaneidade aumenta à medida que as organizações integram a IA a produtos, fluxos de trabalho e experiências dos clientes. Ao mesmo tempo, as expectativas em relação aos custos se tornam mais rigorosas, e os requisitos de governança elevam os padrões de disciplina operacional.
A escalabilidade não se resume à otimização; ela é um requisito fundamental para tornar a IA confiável e replicável em toda a organização. Sem uma base sólida e escalável, cada nova aplicação de IA corre o risco de se tornar um projeto personalizado, com desempenho inconsistente e custos crescentes.
As empresas que investem desde cedo em uma infraestrutura de IA escalável como base operacional de suas iniciativas de IA obtêm:
- Ciclos de iteração mais rápidos
- Custos operacionais mais baixos
- Desempenho mais consistente
- Maior confiabilidade e segurança
- Um caminho sustentável para a adoção em toda a empresa
Arquitetura e infraestrutura para IA escalável
A escalabilidade da IA depende de uma infraestrutura capaz de atender às demandas das cargas de trabalho. As empresas geralmente consideram quatro opções de arquitetura: nuvem, local, híbrida e de borda.
- Escalabilidade da IA baseada em nuvem: A nuvem acelera a experimentação e a expansão da capacidade, mas enfrenta problemas de custo e latência em grande escala. Entre as limitações estão a engenharia de tráfego, a disponibilidade de GPUs e a previsibilidade do desempenho.
- Escalabilidade da IA on-premises: As opções on-premises oferecem custos previsíveis, governança rigorosa de dados e desempenho estável, mas exigem um planejamento cuidadoso de energia, refrigeração e rede, especialmente para clusters densos de GPUs.
- Arquiteturas de IA híbrida: A maioria das empresas opera nesse modelo, geralmente realizando o treinamento na nuvem, a inferência na borda e o ajuste fino em um cluster de GPUs dedicado. A escalabilidade depende de redes, roteamento e segurança confiáveis em diferentes ambientes.
- IA de borda — escalabilidade: A inferência na borda reduz custos e latência, mas exige destilação de modelos, estratégias de replicação e gerenciamento eficiente do tráfego entre os dispositivos de borda e a nuvem.
Principais tecnologias que viabilizam a IA escalável:
- Contêineres e orquestração
- Bancos de dados vetoriais e repositórios de atributos
- Frameworks de treinamento distribuído
- CI/CD para ML (pipelines de MLOps)
- Registros e versionamento de modelos
- Gerenciamento de tráfego e roteamento de camada 7
- Pipelines de armazenamento de objetos compatíveis com S3
A rede é essencial para uma IA escalável, pois clusters densos de GPUs geram um alto volume de tráfego leste-oeste, e as tarefas de inferência exigem resiliência, baixa latência e roteamento inteligente. Os recursos da F5 são fundamentais nesse contexto.
Práticas recomendadas para escalar modelos de IA
O escalonamento de modelos de IA diz respeito, fundamentalmente, ao design do serviço, e não apenas ao ajuste do modelo. Para oferecer inferência confiável e econômica, as organizações precisam alinhar sua arquitetura e seus processos operacionais.
- Projete serviços sem estado e horizontalmente escaláveis: Separe o ambiente de execução do modelo do estado e garanta que os endpoints possam escalar automaticamente de acordo com o tráfego.
- Use processamento em lote, cache e divida os dados em partes gerenciáveis (sharding): Essas práticas reduzem a pressão sobre as GPUs e atenuam os picos de simultaneidade. Muitas organizações conseguem reduzir substancialmente os custos ao aplicar esses padrões de forma consistente.
- Gerencie as versões dos modelos com rigor: Lançamentos, testes A/B e reversões devem ser rápidos e seguros. O gerenciamento inadequado de versões continua sendo uma das principais causas de incidentes de inferência.
- Monitore métricas essenciais: A latência, a taxa de transferência, o custo por inferência, a utilização da GPU, as taxas de tempo limite e o tamanho da fila devem ser monitorados em tempo real.
- Resolva a imaturidade dos dados desde o início: Problemas de qualidade dos dados, como pipelines isolados, rótulos incorretos e ausência de rastreabilidade, tornam-se obstáculos persistentes à medida que a escala aumenta. Investir na preparação dos dados costuma trazer mais benefícios do que simplesmente ampliar a infraestrutura de dados e as GPUs.
- Integre o roteamento com reconhecimento de modelo: Os padrões de tráfego de IA não são uniformes. O roteamento por tipo e tamanho do modelo, tamanho da fila ou região do usuário melhora significativamente o desempenho e a eficiência.
Desafios na implementação de IA escalável
Escalar a IA traz desafios relacionados à tecnologia, à organização e aos custos.
- Gargalos técnicos incluem infraestrutura fragmentada, redes subdimensionadas ou configuradas incorretamente, sistemas de armazenamento incapazes de oferecer suporte a GPUs e endpoints de inferência sensíveis à latência que enfrentam problemas de carga.
- Lacunas organizacionais incluem equipes de IA e infraestrutura isoladas, baixa maturidade em MLOps e falta de definição de responsabilidades e prestação de contas pela IA em produção.
- Restrições de custo e capacidade incluem escassez de GPUs, tráfego de inferência imprevisível, picos nos custos de nuvem e roteamento ineficiente, o que reduz a utilização das GPUs.
- Segurança e governança são fundamentais. Ativos de modelos confidenciais exigem isolamento, o tráfego criptografado (que oculta ameaças) deve ser inspecionado, o acesso às APIs deve ser gerenciado de forma consistente, e a visibilidade em tempo real é essencial para detectar desvios e usos indevidos dos modelos.
É nesse ponto que a F5 oferece uma vantagem, eliminando gargalos de rede, protegendo o tráfego e as APIs e proporcionando a visibilidade necessária para que as equipes ampliem o uso da IA com confiança, em vez de depender de soluções improvisadas.
IA escalável | Perguntas frequentes
O que é IA escalável na prática?
IA que mantém um desempenho confiável à medida que a demanda, os dados e a complexidade dos modelos aumentam.
Qual é a diferença entre escalabilidade e adicionar GPUs?
Alcançar uma escalabilidade real depende do crescimento sincronizado de pipelines de dados, redes, operações e arquiteturas de modelos, e não apenas de melhorias isoladas de hardware.
Quais fatores influenciam a escalabilidade da IA?
A prontidão dos dados, a arquitetura do modelo, a capacidade de rede, a utilização de GPUs, o gerenciamento de simultaneidade e a governança são elementos essenciais nos quais se concentrar.
Como as organizações devem avaliar a nuvem em comparação com a infraestrutura local?
A nuvem acelera a experimentação, enquanto a infraestrutura local aumenta a previsibilidade e a governança. Por isso, a maioria das empresas costuma adotar uma abordagem híbrida.
O que faz com que projetos-piloto de IA fiquem estagnados antes de serem ampliados para produção?
As causas comuns incluem baixa maturidade dos dados, capacidade de rede limitada, GPUs subutilizadas, roteamento ineficiente, processos operacionais deficientes e falta de clareza sobre as responsabilidades.
Como a rede afeta a inferência escalável?
A latência, a taxa de transferência e a utilização da GPU são afetadas pelo roteamento, pelo gerenciamento da simultaneidade e pela engenharia de tráfego.
Por onde as equipes devem começar?
Concentre-se na visibilidade. Identifique as limitações atuais, como rede, dados e saturação de GPUs, e então desenvolva um roteiro com base nesses gargalos.
Como a F5 ajuda
A IA escalável é a base para uma IA empresarial eficaz. Ela exige pipelines de dados integrados, arquiteturas de modelos robustas, infraestrutura de alto desempenho, redes confiáveis, governança sólida e operações disciplinadas. As organizações que investirem agora poderão expandir as aplicações de IA com confiança e de forma econômica, sem comprometer o desempenho ou a segurança.
Saiba mais sobre como a F5 Application Delivery and Security Platform ajuda as organizações a ampliar suas iniciativas de IA em f5.com/solutions/ai-delivery-and-security.