Política no payload: preparando-se para arquiteturas de agentes de IA
Os agentes de IA estão mudando a forma como as aplicações interagem com a infraestrutura. Ao contrário dos sistemas tradicionais, os agentes carregam seus próprios objetivos, contexto e lógica de decisão em cada solicitação — o que fazer, como se recuperar de falhas e o que caracteriza o sucesso. Essa mudança rompe com premissas há muito estabelecidas sobre o gerenciamento de tráfego e exige repensar a infraestrutura corporativa. Roteamento estático, recursos compartilhados e políticas centralizadas já não são suficientes em um mundo de autonomia por solicitação.
As arquiteturas de agentes exigem que a infraestrutura evolua da execução reativa para a interpretação em tempo real da intenção incorporada às solicitações. As empresas que reconhecem essa mudança podem se preparar adaptando os investimentos existentes, em vez de descartá-los.
Introdução
Os agentes de IA não são apenas aplicações inteligentes. Eles representam uma mudança estrutural na forma como as aplicações operam, tomam decisões e se adaptam. Ao contrário dos sistemas tradicionais, os agentes não apenas seguem políticas de tráfego: eles trazem suas próprias políticas. Cada requisição que enviam carrega não apenas dados, mas também uma lógica embutida: o que deve acontecer, como o mecanismo de fallback deve se comportar e o que caracteriza o sucesso.
Essa mudança transfere a tomada de decisões dos planos de controle estáticos para o próprio ambiente de execução. Ela elimina a separação histórica entre os planos de controle e de dados, obrigando a infraestrutura de tráfego — balanceadores de carga, gateways e proxies — a interpretar políticas específicas de cada requisição, em vez de apenas executar passivamente rotas pré-configuradas.
Este artigo explora como as arquiteturas de agentes rompem com premissas fundamentais da engenharia de tráfego, desde verificações de integridade e lógica de fallback até observabilidade e aplicação de controles de segurança. Ele explica por que estruturas tradicionais, como pools estáticos e métricas de integridade baseadas em médias, já não são suficientes em um cenário em que cada requisição tem sua própria intenção. Além disso, defende que a infraestrutura de camada 7 precisa evoluir para não se tornar uma infraestrutura básica comoditizada: confiável, mas estrategicamente invisível. Para se adaptar, as organizações precisam repensar sua stack de tráfego, tornando-a programável em tempo de execução, sensível ao contexto e alinhada a protocolos nativos de agentes, como o Model Context Protocol (MCP). Isso inclui reformular a lógica de fallback, adotar a observabilidade semântica e permitir a aplicação de políticas originadas por agentes. Ferramentas emergentes, como a rotulagem de dados em tempo real, oferecem suporte essencial para essa mudança.
Em resumo, o futuro do gerenciamento de tráfego não se resume à entrega de pacotes, mas à execução de um propósito.
Arquiteturas de agentes: principais características
As arquiteturas de agentes introduzem um novo modelo operacional no qual componentes autônomos baseados em IA generativa — chamados de agentes — executam tarefas orientadas a objetivos, tomam decisões em tempo real e mantêm o contexto necessário para adaptar sua execução dinamicamente. Esses agentes atuam de forma muito semelhante ao encadeamento de serviços atual, mas sem depender de fluxos de trabalho pré-configurados. Em vez disso, determinam o fluxo de execução adequado em tempo de execução com base nos objetivos, no estado do ambiente e nos resultados observados.
Essa mudança representa a transição de sistemas tradicionais, orquestrados de forma centralizada e com fluxos de trabalho predefinidos, para sistemas descentralizados e dinâmicos, capazes de construir caminhos de execução em tempo real. Ela substitui a previsibilidade das cadeias estáticas de microsserviços por uma tomada de decisão fluida e responsiva, orientada por dados em tempo real e pela intenção.
Os sistemas baseados em agentes são definidos pelas seguintes características:
- Execução orientada a objetivos: Os agentes agem com base em prompts ou missões, não em fluxos de trabalho estáticos. Eles selecionam APIs, modificam parâmetros e ajustam o curso de suas ações conforme estejam ou não alcançando seu objetivo. Exemplo: Um agente encarregado de “resolver uma reclamação de cliente” pode acionar APIs de faturamento, conta e mensagens de maneiras diferentes, dependendo dos resultados anteriores.
- Contexto portátil: Os agentes carregam sua própria memória, seu estado e suas políticas. Por meio do Model Context Protocol (MCP) ou de metadados estruturados, eles incorporam esse contexto a cada solicitação.
- Adaptação em tempo de execução: Em vez de esperar que a infraestrutura decida, os agentes se adaptam dinamicamente, fazendo novas tentativas, redirecionando, escalonando ou ajustando os caminhos de execução em tempo real.
- Observabilidade integrada: Cada ação descreve a si mesma. Os agentes podem relatar por que escolheram um caminho, o que foi avaliado e se um objetivo foi alcançado. Isso é observabilidade como comportamento, não apenas logs e métricas.
Juntos, esses elementos transformam o cenário das aplicações, que deixa de ser previsível e passa a ser adaptativo e em constante evolução.
Impacto no gerenciamento de tráfego tradicional
Os sistemas atuais de gestão de tráfego são estruturados com base em limites bem definidos:
- O plano de controle define a intenção: quais endpoints são válidos, quais caminhos priorizar e quais políticas se aplicam.
- O plano de dados executa decisões: roteia solicitações, aplica medidas de segurança e balanceia a carga.
Esse modelo tem funcionado bem há décadas, especialmente em arquiteturas orientadas a serviços e ambientes de microsserviços. Ele pressupõe que os fluxos de tráfego possam ser modelados com antecedência e que as cargas de trabalho sigam padrões previsíveis.
Exemplos:
- Um balanceador de carga direciona
/api/loginpara um pool e/api/imagespara outro. - As verificações de integridade marcam os nós como disponíveis ou indisponíveis.
- Limites estáticos determinam as condições de failover.
Esses sistemas dependem de:
- Forte acoplamento de políticas e configurações a recursos estáticos, como pools e membros específicos
- Estruturas estáticas como pools e membros
- Roteamento determinístico baseado em caminho, cabeçalho ou protocolo
- Orquestração centralizada para descoberta de serviços, verificações de integridade e lógica de contingência
Mas os sistemas baseados em agentes introduzem fluidez, autonomia e uma lógica autodirigida que rompem com essas premissas.
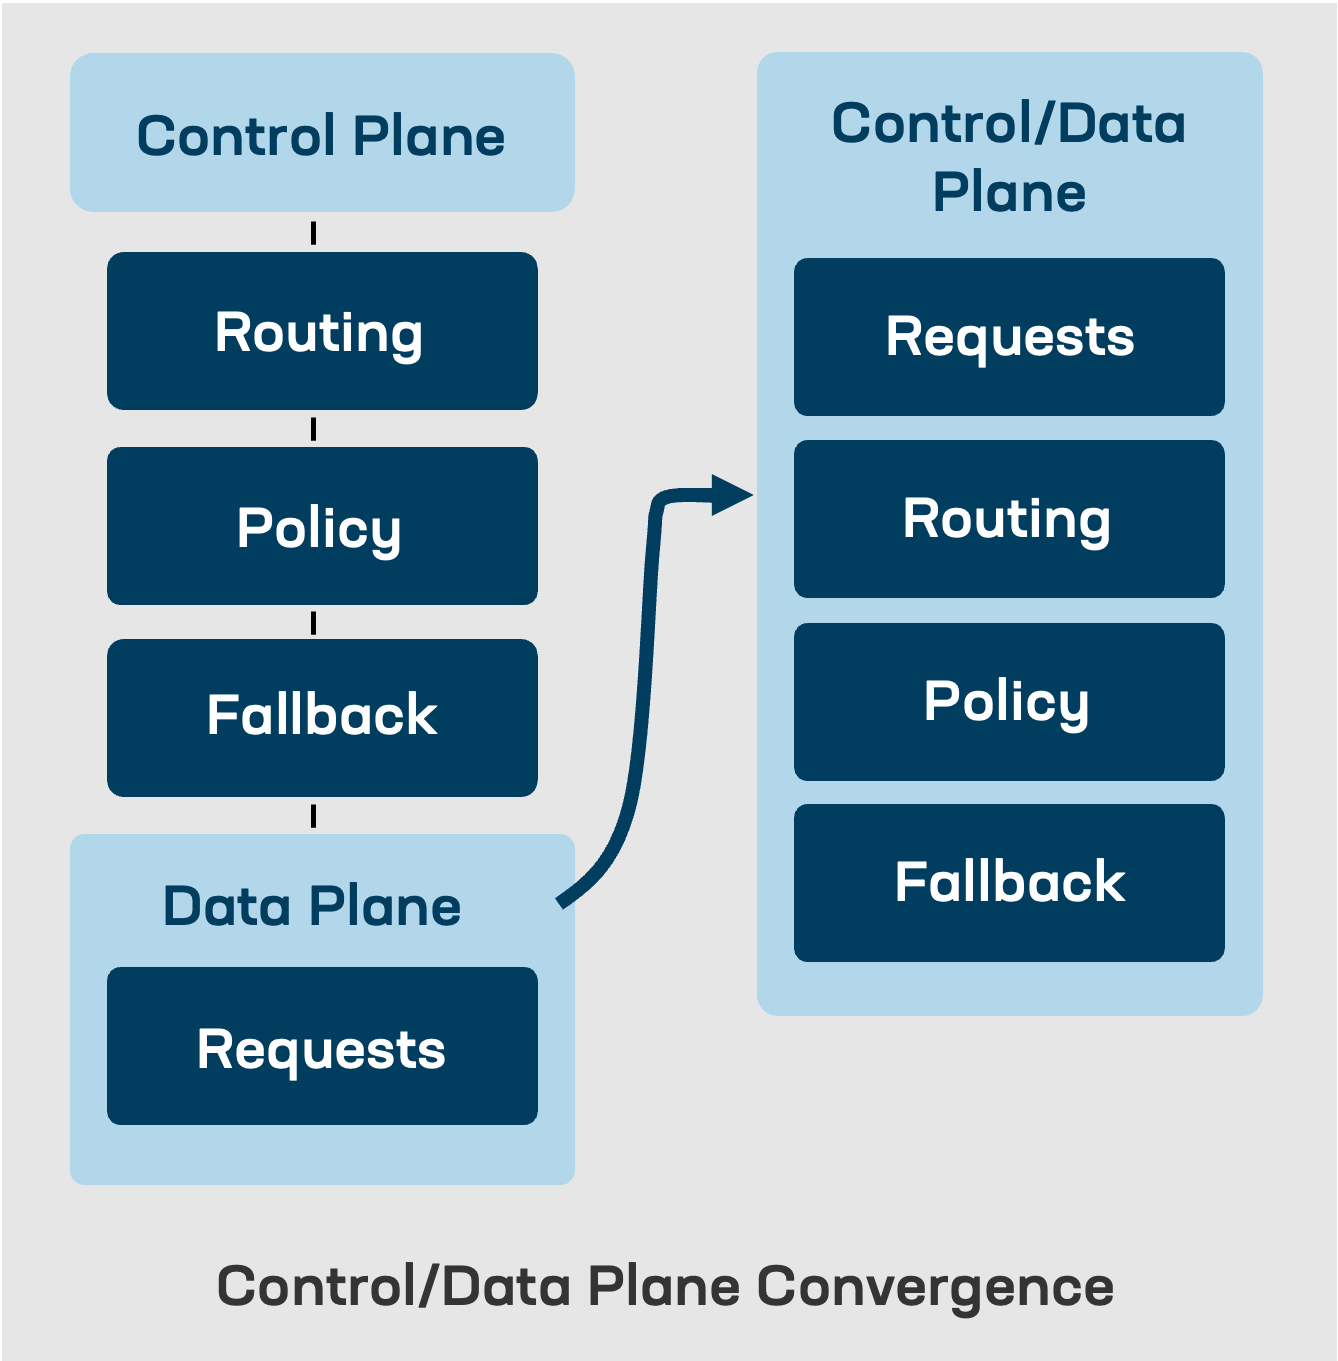
Nas arquiteturas de agentes, a separação tradicional entre o plano de controle e o plano de dados começa a se desfazer. Os agentes não apenas executam solicitações; eles incorporam a lógica que define o que é a solicitação, quais condições devem acionar mecanismos de contingência, como o sucesso é medido e até mesmo qual deve ser a rota preferencial. Tradicionalmente, essas questões são de responsabilidade do plano de controle, mas os agentes as codificam em cabeçalhos, tokens ou metadados que acompanham a própria solicitação pelo plano de dados.
Essa convergência significa que o plano de dados não pode mais atuar como um executor passivo de decisões centralizadas. Ele precisa interpretar ativamente as políticas em tempo real. A solicitação deixa de ser apenas um pacote e passa a ser um artefato de política. Como resultado, balanceadores de carga, gateways e camadas de roteamento precisam evoluir de componentes reativos para intérpretes, em tempo real, da intenção transmitida pelos agentes.
Essa mudança coloca em xeque a premissa arquitetural fundamental de que o plano de controle é estático e centralizado. Em vez disso, a lógica de decisão se torna distribuída, portável e personalizada, acompanhando cada requisição e sendo executada em tempo de execução. Não se trata apenas de uma mudança na implantação, mas de uma mudança em onde e como as decisões são tomadas.
Isso efetivamente conclui o que o Kubernetes começou ao abstrair a infraestrutura subjacente — rede, armazenamento e até mesmo o roteamento de tráfego L4 — e transformar tudo isso em um "encanamento" nos bastidores de uma interface de controle declarativa. Ele não eliminou essas camadas, mas reduziu sua importância. Elas se tornaram invisíveis, automatizadas e subordinadas a um novo sistema orientado por intenção.
As arquiteturas de agentes fazem o mesmo, mas com toda a pilha, não apenas com a infraestrutura.
Disrupções críticas no gerenciamento de tráfego
Para ilustrar essas interrupções com um exemplo real, considere um cenário de entrega local de aplicações:
Exemplo: Um site regional de comércio eletrônico usa um ADC para gerenciar o tráfego interno de APIs. Um agente de IA recebe a tarefa de otimizar a velocidade de processamento dos pedidos. Ele identifica que um endpoint específico da API, por exemplo, /api/inventory/check, está apresentando degradação de desempenho devido ao aumento da complexidade das solicitações e à disputa por recursos no banco de dados de backend. Os algoritmos tradicionais de balanceamento de carga, incluindo o de "resposta mais rápida", não conseguem captar as nuances dessa lentidão porque calculam o desempenho como uma média geral de todas as respostas de um determinado membro do pool, e não por tarefa ou por chamada.
Para cumprir seu SLA, o agente redireciona essas solicitações de verificação de estoque para um grupo alternativo de nós otimizado para consultas transacionais. Para isso, ele marca cada solicitação com um cabeçalho de contexto, como X-Task-Profile: inventory-sensitive. O balanceador de carga, se configurado corretamente, pode interpretar esse cabeçalho e direcionar o tráfego de acordo com ele. No entanto, como esses nós não foram previamente atribuídos ao pool estático associado a /api/inventory, os serviços de direcionamento de tráfego devem ser capazes de respeitar as diretivas transmitidas pelo agente e determinar o roteamento dinamicamente, sem depender de estruturas estáticas.
Esse cenário destaca as limitações de estruturas estáticas, como pools, e a necessidade de uma execução de tráfego sensível ao contexto e programável dinamicamente.
Sistemas baseados em agentes rompem com várias premissas fundamentais da engenharia de tráfego:
Convergência dos planos de controle e de dados: Se antes as decisões de roteamento se baseavam em regras estáticas, agora elas se originam da própria solicitação. Isso rompe com a lógica tradicional de aplicação de políticas.
Roteamento baseado em intenção: Os agentes roteiam o tráfego com base em objetivos, não apenas em endpoints. Um único endpoint como /api/process pode lidar com centenas de fluxos de tarefas diferentes, dependendo das diretrizes do agente.
Pools estáticos se tornam obsoletos: Os pools tradicionais pressupõem funções fixas. Mas os agentes podem precisar de acesso à GPU em um momento e de otimização de CPU no seguinte, tornando a alocação em pools rígida demais.
As alternativas de contingência e o failover tornam-se estratégicos: Antes, failover significava “tentar o próximo servidor”. Agora, os agentes avaliam o desempenho em tempo real, os resultados anteriores e decidem estrategicamente como proceder.
Os padrões de tráfego surgem, não se repetem: Os agentes criam fluxos de trabalho sob demanda. Não é possível definir previamente todos os caminhos; eles se formam conforme as necessidades.
Essas mudanças disruptivas desafiam os balanceadores de carga, gateways e stacks de observabilidade a se adaptarem a uma lógica de tráfego dinâmica e em tempo real.
Repensando as métricas de integridade e desempenho
As métricas de integridade e desempenho sempre foram fundamentais para o gerenciamento de tráfego. As decisões de balanceamento de carga dependem de saber se um servidor está disponível, com que rapidez ele responde e qual é sua carga. Mas, em sistemas orientados por agentes, a integridade não é binária, e o desempenho não pode ser calculado como uma média de categorias amplas. As métricas devem refletir se um destino é adequado para uma tarefa específica, e não apenas se está em operação.
Por que isso importa: As métricas de integridade influenciam diretamente o direcionamento do tráfego, as decisões de failover e a otimização do desempenho. Em um ambiente nativo de agentes, cada solicitação tem uma intenção diferente e pode exigir um caminho ou uma garantia de resposta específicos. As abordagens tradicionais não conseguem atender a essa necessidade porque:
- Eles se baseiam em métricas agregadas superficiais (por exemplo, tempo médio de resposta) que ocultam variações específicas de cada tarefa.
- Eles avaliam a integridade apenas da perspectiva do servidor, sem visibilidade sobre o sucesso ou a satisfação no nível do agente.
- Eles pressupõem homogeneidade do tráfego, o que não se sustenta quando as solicitações são moldadas por decisões tomadas em tempo de execução.
Exemplo: Todos os servidores de API de um pool podem ser considerados "saudáveis" pelas verificações de integridade, mas um deles pode falhar consistentemente em fornecer respostas em menos de 100 ms para consultas com X-Task-Profile: inventory-sensitive. Um agente que espera esse perfil de latência perceberá uma falha, mesmo que a infraestrutura indique normalidade.
O que é necessário:
- Telemetria em tempo real para cada solicitação, que reflita a intenção e os resultados observados.
- Pontuação de integridade específica por tarefa que identifica quando um nó apresenta degradação em algumas tarefas, mesmo estando íntegro para outras.
- Ciclos de feedback que incorporam o sucesso ou a falha relatados pelos agentes à lógica de roteamento e priorização.
As ferramentas de rotulagem de dados podem desempenhar um papel fundamental aqui, ao rotular o tráfego em tempo real e registrar o desempenho e o alinhamento com o contexto. Isso permite que os sistemas analisem não apenas o que aconteceu, mas também se isso atendeu ao objetivo do agente que iniciou a ação.
Recursos de fallback, circuit breakers e novas tentativas em arquiteturas de agentes
Na infraestrutura tradicional, os mecanismos de fallback, como novas tentativas, redirecionamento para nós de backup ou acionamento de circuit breakers, são implementados na camada de infraestrutura. Balanceadores de carga, proxies e gateways usam limites predefinidos (por exemplo, tempos limite e taxas de erro) para determinar quando parar de rotear o tráfego para um destino e tentar uma alternativa.
As arquiteturas de agentes invertem essa lógica.
Os agentes trazem suas próprias estratégias de contingência. Eles incluem políticas de novas tentativas, lógica de escalonamento e prioridades centradas em objetivos na própria solicitação. Isso introduz complexidade e possíveis conflitos com os mecanismos de failover no nível da infraestrutura.
Por que isso é importante:
- A infraestrutura pode interpretar uma falha como recuperável, enquanto o agente a considera inaceitável (ou vice-versa).
- Tanto o agente quanto a infraestrutura podem tentar acionar mecanismos de contingência simultaneamente, levando a novas tentativas redundantes, aumento da latência ou loops de tráfego.
- Circuit breakers projetados para condições típicas de tráfego podem bloquear o acesso a serviços que um agente ainda considera ideais.
Principais riscos:
- Fallback duplo: Tanto o agente quanto a infraestrutura fazem novas tentativas, gerando carga desnecessária.
- Condições de corrida: O agente recorre a uma opção mais cara ou menos segura, quando o sistema teria resolvido o problema em milissegundos.
- Falha do failover determinístico: Políticas estáticas não conseguem lidar com as nuances do agente.
- Corrupção: Os metadados do agente estão malformados, ausentes ou ilegíveis.
Orientações de adaptação:
- A infraestrutura deve evoluir para reconhecer as prioridades de fallback especificadas pelo agente (por exemplo, por meio de
X-Fallback-Order,X-Timeout-Preference). - Os disjuntores devem levar em conta a intenção para oferecer suporte a lógicas específicas por tarefa ou por agente, em vez de limites globais.
- Considere introduzir uma lógica de failover que leve em conta a negociação, na qual os agentes proponham estratégias preferenciais e os gateways arbitrem com base na integridade do sistema, na carga e nas políticas.
- Os sistemas de tráfego devem oferecer suporte a uma lógica de execução padrão quando os metadados dos agentes estiverem ausentes, incompletos ou não passarem na validação do esquema, garantindo uma degradação controlada.
- A infraestrutura deve detectar e impedir a delegação recursiva ou tentativas conflitantes de repetição por parte dos agentes que possam desencadear loops ou aumentar o tráfego durante a degradação do sistema.
Exemplo: Um agente encarregado de verificar fraudes em tempo real solicita uma resposta em até 50 ms. Sua lógica de contingência prioriza um resultado parcial em cache em vez de uma consulta completa e lenta. Uma infraestrutura que desconheça essa preferência ainda pode encaminhar a solicitação ao backend de serviço completo, causando uma demora perceptível para o usuário. Um modelo mais cooperativo respeitaria a prioridade de contingência do agente e forneceria a resposta mais rápida, ainda que com funcionalidade reduzida.
À medida que a tomada de decisões avança para as camadas superiores da pilha, as estratégias de contingência devem acompanhar esse movimento. Os mecanismos de circuit breaker e a lógica de novas tentativas não podem permanecer estáticos ou opacos; devem se adaptar às preferências expressas pelos agentes, preservando a segurança e a equidade do sistema.
Alta disponibilidade e failover continuam sendo importantes
Embora as arquiteturas de agentes transfiram a tomada de decisões e a coordenação para a camada de requisições, a infraestrutura subjacente continua responsável por garantir a confiabilidade fundamental do sistema. Isso significa que a alta disponibilidade (HA) e os mecanismos de failover na camada de infraestrutura continuam sendo essenciais. Na verdade, eles se tornam ainda mais críticos à medida que os sistemas passam a apresentar um comportamento mais dinâmico e autônomo.
Os agentes podem direcionar o tráfego com base em objetivos e contexto, mas ainda dependem da rede para garantir que os serviços permaneçam acessíveis e resilientes quando ocorrem problemas. Os balanceadores de carga devem detectar nós inacessíveis, serviços com falhas ou ambientes degradados e redirecionar o tráfego em tempo real, independentemente da estratégia de contingência do agente.
Responsabilidades fundamentais que não mudam:
- Monitorar os membros do pool e a integridade dos serviços de backend
- Detectar partições de rede ou falhas de roteamento
- Redirecionar o tráfego com base no estado de atividade, na disponibilidade ou na degradação do sistema
- Manter a alta disponibilidade de serviços ou sessões com estado quando necessário
Os agentes podem conter lógica para determinar “o que deve acontecer a seguir”, mas o balanceador de carga continua sendo responsável por “quão rapidamente nos recuperamos quando um nó fica indisponível”.
É essencial que a lógica de roteamento adaptativa e ciente dos agentes não comprometa a estabilidade operacional. Uma infraestrutura bem instrumentada deve manter:
- Failover instantâneo e rebalanceamento de tráfego quando os nós ficam indisponíveis
- Topologias resilientes de alta disponibilidade que protegem agentes e serviços contra falhas em componentes upstream
- Recuperação rápida e automatizada que complementa a lógica de contingência dos agentes, em vez de entrar em conflito com ela
Em resumo, arquiteturas orientadas por agentes não eliminam a necessidade de failover — elas tornam essa capacidade ainda mais crítica. A infraestrutura agora precisa responder mais rápido, com maior sensibilidade ao contexto e sem se tornar um gargalo para o comportamento autônomo.
Implicações para o gerenciamento de tráfego corporativo
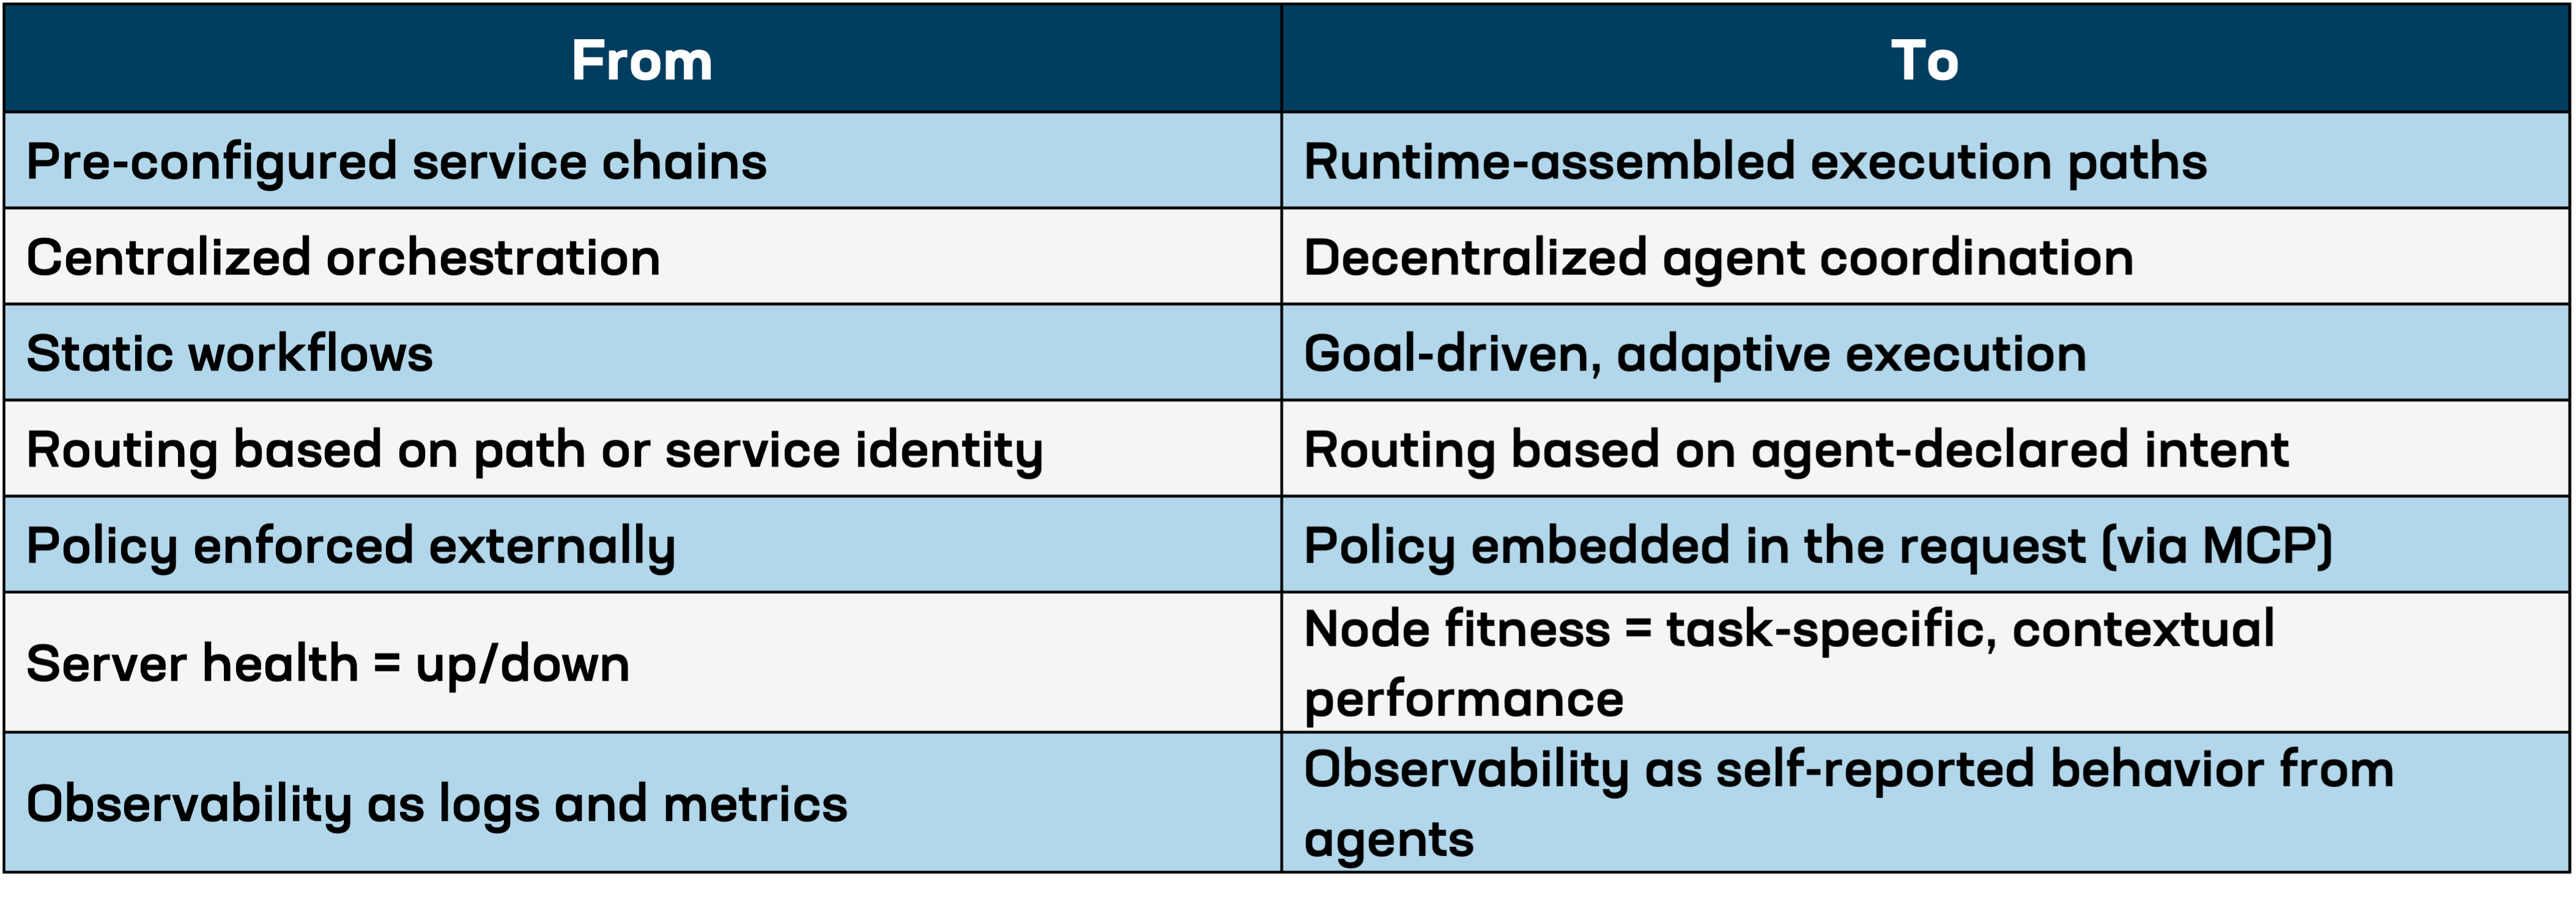
A transição para arquiteturas baseadas em agentes introduz uma mudança fundamental na forma como sistemas de tráfego, como balanceadores de carga e gateways, devem operar. Enquanto os sistemas de tráfego tradicionais tomavam decisões com base em políticas pré-configuradas — muitas vezes externas à requisição —, os sistemas orientados por agentes incorporam essas políticas à própria requisição. Essa é a base do que o Model Context Protocol (MCP) viabiliza: a execução de políticas incorporadas em cada requisição.
Chamaremos esse modelo de "política no payload". Em vez de fazer com que sistemas centralizados analisem cada caso excepcional, o agente codifica decisões de política relevantes (como estratégia de fallback, preferência de nó, tolerância a erros ou requisitos de privacidade) em cada solicitação. A infraestrutura deve então ler, interpretar e agir de acordo com essas instruções de política em tempo real.
Esse novo modelo de execução transforma o papel dos componentes de gerenciamento de tráfego:
- De decisores a executores: A infraestrutura não determina mais para onde o tráfego vai; ela aplica a decisão transmitida pelo agente.Exemplo: Um balanceador de carga que lê
X-Route-Preference: gpu-optimizeddeve encaminhar o tráfego de acordo com essa preferência, mesmo que esse nó não fizesse parte do pool original. - Programável em tempo de execução: As iRules e as políticas devem avaliar cabeçalhos como
X-Intent,X-ContextouX-Goal. Isso transfere a lógica de caminhos pré-configurados para uma interpretação dinâmica, realizada durante o processamento. - Roteamento sensível ao contexto: ADCs e serviços semelhantes precisam rotear com base na identidade, na intenção e no contexto, não apenas no host ou no caminho.
- Observabilidade semântica: Os logs devem mostrar não apenas o que aconteceu, mas também por quê: “Agente redirecionado porque o limite de latência foi excedido” é mais útil do que apenas “roteado para o Pool B.”
Tecnologias de rotulagem de dados e ferramentas semelhantes podem apoiar essa mudança ao marcar e classificar o contexto das requisições em tempo real, tornando viáveis o roteamento semântico e a observabilidade.
Preparando a infraestrutura corporativa para arquiteturas de agentes
Os agentes de IA não operarão de forma isolada. Eles interagirão com sistemas legados, acessarão APIs tradicionais, manipularão a lógica de negócios em bancos de dados corporativos e chamarão funções hospedadas tanto em backends monolíticos quanto em microsserviços. Para as empresas, isso significa que não dá para começar do zero: é preciso evoluir.
A realidade: os agentes vão se comunicar com tudo
As stacks empresariais são uma combinação de:
- APIs SOAP de décadas atrás ainda usadas na área financeira
- Serviços RESTful que dão suporte a aplicações web
- Filas de mensagens para sistemas de estoque assíncronos
- Microsserviços nativos da nuvem
- APIs SaaS com limites de requisições e autenticação complexa
- LLMs e agentes com ajuste fino
Os agentes precisam aprender a atuar em todo esse ambiente. E sua infraestrutura precisa aprender a mediar essa interação em tempo real, aplicando políticas que levem em conta o contexto.
O que as equipes das empresas precisam preparar
1. Disponibilize sistemas internos por meio de interfaces orientadas à intenção
Os agentes não querem cinco endpoints, querem alcançar um objetivo. Exponha funcionalidades de negócio (por exemplo, “consultar o status do pedido”) por meio de camadas de abstração ou composições de APIs que os agentes possam consumir por um único ponto de entrada semântico.
Etapa de preparação: Use gateways de API ou malhas de serviços para consolidar endpoints orientados a tarefas com contratos de entrada e saída bem definidos.
2. Instrumente para obter contexto, não apenas métricas
O registro tradicional de logs se concentra no método, no caminho e no tempo de resposta. Mas os agentes se importam com:
- Qual era a tarefa
- Qual alternativa foi tentada
- Se o objetivo foi alcançado
Etapa preparatória: Adote ferramentas de observabilidade semântica que identifiquem o tráfego com rótulos como X-Intent, X-Task-Type e X-Agent-Outcome.
3. Ofereça suporte à avaliação de políticas incorporadas em tempo de execução
Os agentes incluem instruções de contingência, preferências de tempo limite e requisitos de segurança na própria requisição. A infraestrutura existente descarta esses dados.
Etapa de preparação: Amplie as políticas de tráfego para interpretar os metadados dos agentes e agir com base neles (por exemplo, X-Route-Preference, X-Fallback-Order, X-Data-Class). Comece com iRules ou scripts semelhantes executados em tempo de execução.
4. Reformule o controle de acesso e a governança
Os agentes são autônomos. Você precisa saber:
- Qual agente está agindo em nome de quem
- A quais ferramentas ele tem acesso
- Quais escopos de dados ele tem permissão para acessar
Etapa de preparação: Integre acesso baseado em identidade e controles de políticas baseados em atributos (ABAC), não apenas listas de IPs permitidos ou RBAC estático.
5. Desacople a lógica de fallback da lógica de novas tentativas
A infraestrutura e os agentes não podem competir entre si para se recuperar. Deixe que um cuide dos objetivos em tempo de execução e que o outro aplique as salvaguardas sistêmicas.
Etapa de preparação: Separe claramente o escopo das ações de contingência dos agentes (o que eles controlam) do failover da infraestrutura (o que está sob sua responsabilidade). Defina regras de negociação e condições para sobrepor decisões.
Conclusão
À medida que a IA evolui de modelos isolados para agentes autônomos, as empresas se deparam com um ponto de inflexão estratégico. Esses agentes não operarão em ambientes criados do zero — eles se integrarão a aplicações existentes, farão chamadas a APIs legadas e orientarão decisões em sistemas críticos para os negócios. Isso significa que as empresas precisam se preparar desde já para dar suporte a eles, não apenas com novas ferramentas, mas repensando como sua arquitetura lida com intenção, execução e governança.
Este não é o momento de descartar tudo e começar do zero. É um momento de convergência — em que os sistemas tradicionais e os comportamentos emergentes dos agentes devem interoperar com precisão e propósito.
As arquiteturas de agentes estão chegando. As empresas que se prepararem agora não vão apenas acompanhar essa evolução: vão liderá-la.
LORI MACVITTIE
PUBLICADO EM 01 DE JULHO DE 2025