
Segurança Zero Trust: por que o modelo Zero Trust é importante (e não apenas para o acesso)
Resumo
Um dos principais temas relacionados ao acesso a redes e aplicações nos últimos anos tem sido o conceito de “confiança zero”. Neste artigo, mostramos como, em sua essência, a confiança zero pode ser caracterizada por um pequeno conjunto de princípios simples que podem ser aplicados não apenas ao acesso, mas também de forma mais ampla em todo o campo da cibersegurança.
Este artigo apresenta uma estrutura que abrange os conceitos amplos relacionados à confiança zero, associando-os ao atual contexto empresarial que orienta os líderes de negócios na área de segurança de aplicações. Por fim, o artigo caracteriza o sistema de crenças da confiança zero — o elemento que impulsiona as ferramentas e implementações de segurança voltadas às ameaças atuais e emergentes, que serão o foco de um artigo subsequente.
Este artigo tem dois objetivos: primeiro, transmitir a mentalidade de segurança que os líderes de negócios de aplicações devem adotar e, segundo, apresentar uma estrutura para profissionais de segurança que será aprofundada em futuros white papers.
ZTS: Comece pelos princípios, não pelas tecnologias
O termo “confiança zero” está associado a diversos conceitos em diferentes níveis de abstração: às vezes, como uma arquitetura de solução específica; outras, como uma recomendação para aplicar determinadas tecnologias; e, em outros casos, como uma propriedade de um produto. Acreditamos que a segurança de confiança zero é, em sua essência, uma mentalidade — um sistema de crenças — do qual surgem técnicas e táticas que utilizam tecnologias específicas e podem ser aplicadas para enfrentar um amplo espectro de ameaças à segurança.
O sistema de crenças que fundamenta a segurança de confiança zero (ZTS) pode ser visto como a próxima etapa na evolução de uma mentalidade de segurança que começou, anos atrás, com a “defesa em profundidade”. A defesa em profundidade baseia-se na crença de que, embora qualquer camada defensiva isolada tenha uma probabilidade pequena, mas real, de ser violada, a adição de mais camadas de proteção aos ativos essenciais reduz essa probabilidade, retardando os invasores e, ao mesmo tempo, obrigando-os a empregar mais recursos para realizar um ataque bem-sucedido.
A confiança zero representa o amadurecimento dessa mentalidade em três dimensões:
- Primeiro, ele faz com que a premissa da proteção deixe de ser um conjunto de “filtros” simples que controlam o acesso à aplicação e passe a ser um conjunto de proteções mais adequado aos ativos, aplicado de forma contextual a qualquer transação do sistema. A abordagem para cada transação é entender: quem está tentando realizar qual ação sobre quem. O “quem” e o “sobre quem” podem ser qualquer componente dentro do sistema ou que o utilize, seja uma pessoa, um processo automatizado ou um trecho de código. O conceito de identidade é fundamental para definir quem e sobre quem, e o conceito de privilégios concedidos a uma identidade é usado para determinar o que pode ser feito.
- Em segundo lugar, considera a avaliação da decisão de segurança não como algo estático e absoluto, mas sim mais dinâmico e adaptável, a ser continuamente reavaliado à luz dos comportamentos observados. A decisão sobre o tratamento de cada transação — seja permitir a interação, bloqueá-la, obter mais confiança e assim por diante — também deve considerar o contexto mais amplo dos negócios e, especificamente, a relação entre risco e benefício.
- Por fim, parte-se do princípio de que, independentemente de quantas camadas de proteção sejam implementadas, um adversário suficientemente motivado ou afortunado conseguirá violar ou contornar as proteções. Portanto, a detecção oportuna de qualquer comprometimento e a mitigação de tentativas de exploração também devem ser elementos fundamentais da estratégia geral.
Essa evolução resultou, em parte, do tempo e da experiência, mas é cada vez mais impulsionada pela convergência de duas outras tendências de segurança de aplicações. Especificamente, as arquiteturas de aplicações atuais abrem um espaço potencial muito maior para vulnerabilidades — sobretudo ameaças provenientes de “dentro” da infraestrutura da aplicação — que podem ser exploradas graças à crescente sofisticação dos adversários atuais. Felizmente, os avanços simultâneos nas ferramentas de segurança, especialmente quando usadas em conjunto com recursos modernos de coleta e análise de dados, viabilizaram a implementação prática dos principais componentes da estratégia de defesa.
O restante desta introdução apresenta uma visão geral da estrutura de nossa abordagem à segurança de confiança zero, bem como de seu escopo. A partir daí, as seções seguintes aprofundam a definição do problema e sua relação com outras abordagens contemporâneas de confiança zero, levando a uma discussão sobre as convicções fundamentais — o “porquê” — que devem orientar a escolha das tecnologias de solução e sua aplicação. Artigos futuros se aprofundarão no “como” — os requisitos impostos a tecnologias específicas, como autenticação, controle de acesso e análises assistidas por IA, no contexto do modelo de maturidade de confiança zero.
ZTS: Tudo começa pelo porquê
A abordagem “Comece pelo porquê”, de Simon Sinek, é uma ferramenta eficaz para comunicar a estrutura de ZTS, conforme mostrado na Figura 1 abaixo. Você pode visualizar este gráfico de fora para dentro, começando pelas categorias de ameaças abordadas pela ZTS, aprofundando-se nos métodos de segurança utilizados e, por fim, sintetizando tudo em princípios comuns. Ou pode visualizá-lo de dentro para fora, partindo das crenças fundamentais como norte, das quais surgem as ferramentas e técnicas adequadas, que, por sua vez, permitem lidar com uma ampla variedade de ameaças.
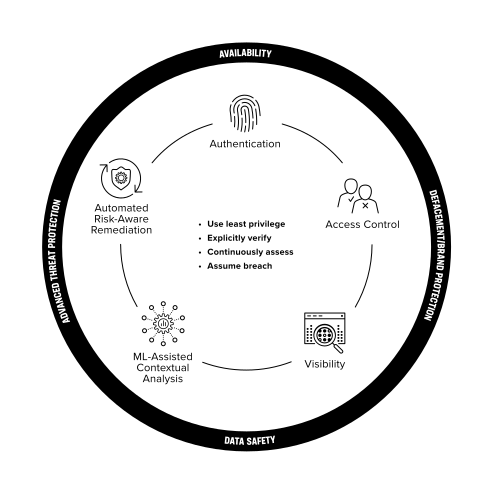
As seções posteriores exploram em detalhes cada camada concêntrica deste diagrama, mas, em resumo:
- As crenças fundamentais da abordagem decorrem da formulação do caso de uso da seguinte forma:
“Quem está tentando fazer o quê (ação) a quem?”- Para determinar quem e a quem, verifique explicitamente qualquer declaração de identidade.
- Depois de determinar Quem, use o princípio do menor privilégio para limitar O que pode ser feito.
- Avalie e reavalie continuamente todos os três fatores de Quem, O quê e A quem, e continue validando-os em relação às restrições da política.
- Sempre presuma que violações e comprometimentos ocorrerão. Esteja preparado para intervir caso a ação (O quê para Quem), com base em uma análise de risco versus benefício (a probabilidade de fraude na autenticação, ponderada pelo impacto comercial da aprovação indevida de uma transação), exceda um limite de segurança aceitável predeterminado.
- Os métodos utilizados são:
- Autenticação e controle de acesso para determinar Quem com algum nível de confiança e, em seguida, limitar os privilégios relativos a Quais ações devem ser permitidas a essa identidade em relação a um Alvo específico.
- Visibilidade e análise assistida por aprendizado de máquina para observar e avaliar continuamente o contexto completo de cada transação – Quem faz o quê para quem.
- Remediação automatizada e consciente dos riscos para intervir em uma transação quando o nível de risco-retorno ultrapassar o limite de tolerância especificado.
- Combata uma ampla variedade de ataques cibernéticos aplicando estes métodos:
- Ataques tradicionais, como desfiguração ou exfiltração de dados – Você pode combater esses ataques detectando o comprometimento de identidades ou a elevação de privilégios e usando técnicas de autenticação e controle de acesso para limitar Quem pode fazer O quê por meio de políticas.
- Ataques de disponibilidade/DDoS — Combata esses ataques combinando autenticação e controle de acesso com medidas corretivas baseadas em riscos. Por exemplo, bloqueie (ou limite a taxa de) acesso de agentes não autenticados ou com autenticação insuficiente que tentem realizar transações que consumam muitos recursos.
- Ameaças avançadas, como ransomware ou ataques à cadeia de suprimentos — Você pode lidar com essas ameaças detectando mudanças e anomalias nos comportamentos de Quem está fazendo O quê a Quem, novamente em conjunto com medidas corretivas baseadas em riscos.
O escopo do ZTS
A segurança de confiança zero se estende de forma holística por toda a pilha de aplicações, infraestrutura e entrega, e deve abranger todo o pipeline de desenvolvimento. Mais especificamente, isso deve incluir:
- Pilha completa de aplicações e infraestrutura, de ponta a ponta
- Substrato de computação de hardware, incluindo servidores, placas de interface de rede, coprocessadores e componentes da placa de sistema
- Firmware de baixo nível e BIOS para o hardware.
- O sistema operacional da camada mais baixa, como o hipervisor ou o executivo de tempo de execução.
- O sistema operacional no nível da aplicação/do contêiner.
- Componentes de aplicativos de terceiros importados, sejam eles comerciais ou de código aberto.
- Qualquer software aplicativo desenvolvido internamente ou sob medida.
- Pilha completa de entrega de aplicações, da esquerda para a direita
- A cadeia de suprimentos usada para a manutenção contínua e as atualizações de cada elemento da pilha “de cima para baixo”.
- Quaisquer componentes em linha para entrega de aplicações, como firewalls, balanceadores de carga, gateways de API, controladores de entrada/saída/malha e dispositivos em linha para mitigação de fraudes.
- Quaisquer componentes de entrega de aplicações que afetem indiretamente o processamento do tráfego, como resolvedores do Sistema de Nomes de Domínio (DNS), ou que recebam metadados indiretamente, como soluções de gerenciamento de eventos e informações de segurança (SIEM) ou serviços de identidade federada.
Tradicionalmente, o foco da confiança zero tem sido direcionado às equipes de desenvolvimento e entrega de aplicações, frequentemente representadas pelos perfis de Dev, DevOps, DevSecOps e SRE. Destacamos isso principalmente para chamar a atenção para o panorama mais amplo: uma abordagem abrangente de confiança zero deve, idealmente, incluir perfis e infraestruturas não tradicionais, bem como fluxos de trabalho adicionais, como a estratégia de aquisição da cadeia de suprimentos.
Definição do problema
Uma das principais prioridades do CIO e do CISO é modernizar a tecnologia da informação para ajudar a acelerar os negócios. Eles também desempenham um papel fundamental na governança de riscos corporativos. Seu objetivo é ajudar a empresa a encantar os clientes com novas experiências digitais, aumentar a eficiência operacional por meio da conectividade digital com terceiros e permitir que os funcionários sejam produtivos de qualquer lugar, minimizando os riscos para o negócio. Para isso, as organizações do CIO e do CISO precisam dar às suas equipes a liberdade de usar as tecnologias, arquiteturas e práticas recomendadas mais recentes para obter agilidade e, ao mesmo tempo, incumbir essas mesmas pessoas de adotar medidas de segurança adequadas e estabelecer controles sobre o comportamento das pessoas, as informações que acessam e a tecnologia que utilizam, a fim de evitar a exposição a perdas.
As organizações devem compreender e controlar os riscos relacionados a mudanças nas condições de mercado e macroeconômicas, no comportamento do consumidor, na cadeia de suprimentos e na exposição a ameaças de segurança. Uma avaliação precisa dos riscos e a capacidade de adotar rapidamente medidas de mitigação representam uma vantagem competitiva para as empresas. Neste documento, abordamos o risco de exposição a ameaças de segurança, que, entre outras consequências, pode causar perda de propriedade intelectual, interrupção de processos de negócios, perda de informações de identificação pessoal e multas impostas por órgãos reguladores. O risco de segurança pode ser calculado por meio da avaliação dos seguintes aspectos da situação em questão:
- Valor dos ativos envolvidos
Os ativos envolvidos em transações têm diferentes níveis de importância. Por exemplo, um banco de dados que contém informações de identificação pessoal é mais valioso do que um banco de dados que lista os pontos de venda que comercializam produtos fabricados pela empresa. As equipes de segurança e TI podem usar um processo determinístico para criar um inventário de todos os ativos, classificados por uma pontuação que representa o “valor” do ativo. - Impacto do comprometimento
A natureza do comprometimento determina o impacto associado a ele. Por exemplo, o impacto do furto de informações no repositório de dados que contém informações de identificação pessoal é muito maior do que o de uma interrupção na disponibilidade desse repositório. Embora seja um conceito um pouco mais abstrato, é possível listar vários tipos de comprometimento e atribuir a eles uma pontuação de “impacto”. - Probabilidade de comprometimento
A probabilidade de uma transação resultar no comprometimento de um ativo é o fator menos determinístico na avaliação do risco associado à transação. Os seres humanos não conseguem lidar com a escala das observações necessárias, por isso as organizações empregam aprendizado de máquina e inteligência artificial para aumentar a confiabilidade do cálculo da probabilidade de comprometimento.
O desafio em questão é calcular, praticamente em tempo real, o risco associado a cada transação e adotar as medidas de mitigação adequadas para controlar o impacto de um possível comprometimento.
Reconhecendo o problema
As demandas por aceleração dos negócios levam a novas práticas que agravam os riscos de segurança cibernética. Abordamos esse ponto em mais detalhes a seguir.
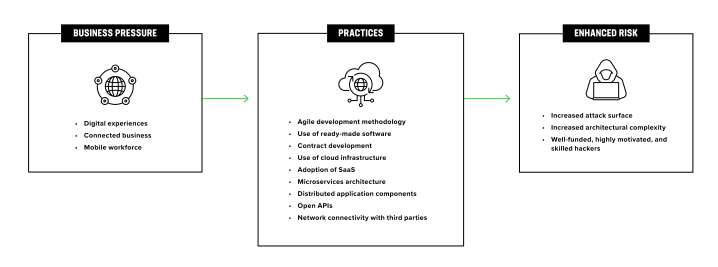
- Demandas de aceleração dos negócios
- Experiências digitais
Os consumidores têm um desejo insaciável por experiências digitais e exigem melhorias frequentes em diversas plataformas (PC, tablet e celulares). - Negócios conectados
Os processos de negócios digitais exigem conectividade com parceiros, fornecedores, distribuidores e serviços prestados por outras empresas. - Força de trabalho móvel
Os funcionários precisam poder acessar os aplicativos empresariais de qualquer lugar para garantir a eficiência operacional.
- Experiências digitais
- Práticas para atender às demandas empresariais
- Metodologia de desenvolvimento ágil
As empresas adotaram a abordagem incremental e iterativa do desenvolvimento ágil, com forte foco na satisfação do cliente, em vez da abordagem sequencial em cascata, que prioriza a entrega dos projetos dentro do prazo. - Uso de software pronto para uso
Para oferecer novas experiências digitais o mais rápido possível, os desenvolvedores reutilizam códigos disponibilizados como código aberto por outros profissionais do setor. - Desenvolvimento terceirizado
Terceirizar o trabalho para desenvolvedores contratados ajuda as empresas a ampliar suas equipes conforme a demanda. - Uso de infraestrutura em nuvem
A agilidade, a flexibilidade, a escalabilidade e a facilidade de uso da nuvem permitem que os desenvolvedores obtenham a infraestrutura necessária sob demanda. - Adoção de SaaS
O software como serviço (SaaS) é vantajoso para aplicações de operações empresariais, pois reduz significativamente o trabalho de adquirir, implantar e manter essas aplicações em data centers privados. - Arquitetura de microsserviços
As equipes usam microsserviços para viabilizar a entrega contínua e reduzir o tempo de lançamento no mercado. - Componentes de aplicações distribuídas
As organizações ganham eficiência ao executar microsserviços em uma infraestrutura que oferece as melhores ferramentas para desenvolver ou disponibilizar as funcionalidades do serviço. Extensões recentes de fluxos de trabalho legados são implementadas usando arquiteturas de aplicações modernas que precisam se comunicar com os elementos legados, e ambos geralmente são executados em infraestruturas diferentes. - APIs abertas
Um ecossistema de diversos serviços é mais eficiente do que uma empresa desenvolver todos os serviços por conta própria. - Conectividade de rede com terceiros
As empresas se conectam entre si por meio de túneis criptografados com seus parceiros, fornecedores e distribuidores para automatizar e otimizar os processos de negócios.
- Metodologia de desenvolvimento ágil
- Risco de segurança elevado
- Maior superfície de ataque
O uso de software de terceiros e bibliotecas de código aberto cria oportunidades para ataques à cadeia de suprimentos, além de fazer com que todas as vulnerabilidades de softwares desenvolvidos externamente sejam herdadas. Desenvolvedores terceirizados são incentivados a concluir as funcionalidades dentro do prazo, e a segurança não é responsabilidade deles. Além disso, depois que entregam o software e deixam o projeto, é difícil e demorado para as equipes internas analisarem o código e encontrarem falhas de segurança. As sprints ágeis são muito eficientes na entrega de funcionalidades, mas o ritmo acelerado de desenvolvimento não deixa muito tempo para auditorias e testes de segurança detalhados. Um único microsserviço vulnerável capaz de se comunicar com outros microsserviços aumenta o risco de segurança de todo o sistema. Embora empresas interconectadas melhorem a eficiência operacional, uma consequência grave é que as falhas de segurança em qualquer uma delas afetam todas as demais. Os invasores encontram o elo mais fraco para se disseminar pelo restante do ecossistema. Uma vulnerabilidade ou falha de segurança na plataforma SaaS ou na infraestrutura de nuvem torna-se um vetor de ataque adicional, e o modelo de responsabilidade compartilhada pode dificultar a detecção e a correção precoces. - Maior complexidade arquitetural
Elementos de aplicações distribuídas, desenvolvidos com diferentes arquiteturas e implantados em várias infraestruturas, têm necessidades distintas de segurança e conformidade. Isso dificulta o trabalho das equipes de segurança na criação e implementação de mecanismos adequados para proteger aplicações e dados corporativos, bem como atender aos requisitos de conformidade regulatória. - Hackers bem financiados, altamente motivados e qualificados
Da Operação Aurora, em 2010, ao Solargate, em 2020, tivemos uma década de ataques cibernéticos avançados que só foram descobertos depois de causarem grandes danos. As violações ocorreram em organizações equipadas com as melhores tecnologias de segurança e administradas por equipes de segurança altamente treinadas. Os invasores permaneceram na infraestrutura de TI dessas organizações por longos períodos antes de serem detectados. Propriedade intelectual e informações de identificação pessoal foram roubadas, operações comerciais foram interrompidas e organizações foram mantidas reféns por ransomware, mesmo com as equipes de TI e segurança indo além do necessário para cumprir as regulamentações criadas para impedir ataques cibernéticos.
- Maior superfície de ataque
Diretrizes do governo dos EUA
Após uma série de ataques cibernéticos persistentes contra diversos órgãos governamentais federais, estaduais e locais dos EUA, bem como várias empresas norte-americanas, o presidente Joe Biden emitiu uma ordem executiva para aprimorar a segurança cibernética do país em 12 de maio de 2021. Um dos principais elementos dessa ordem determina que os órgãos governamentais adotem os princípios de confiança zero para se prepararem contra ataques cibernéticos. Posteriormente, o governo Biden emitiu um memorando do Escritório de Gestão e Orçamento (OMB) destinado aos chefes dos departamentos e órgãos do Poder Executivo em 26 de janeiro de 2022. Esse memorando do OMB “estabelece uma estratégia federal de arquitetura de confiança zero (ZTA), exigindo que os órgãos cumpram normas e objetivos específicos de segurança cibernética até o final do ano fiscal de 2024, a fim de reforçar as defesas do governo contra campanhas de ameaças cada vez mais sofisticadas e persistentes.”1 Tanto a ordem executiva quanto o memorando do OMB fazem referência à arquitetura de confiança zero descrita na publicação SP 800-207 do Instituto Nacional de Padrões e Tecnologia (NIST), publicada em agosto de 2020, e exigem que os órgãos governamentais a adotem.
Arquiteturas Zero trust architecture e modelos de maturidade
Líderes de pensamento de órgãos governamentais e do setor privado publicaram artigos que ajudam a explicar a arquitetura de confiança zero e oferecem orientações sobre a melhor forma de adotá-la. A seguir, resumimos as ideias apresentadas nesses artigos. Observamos que a essência das ideias e sugestões neles contidas é examinar cada transação para avaliar Quem está tentando realizar Qual ação sobre Quem, e tomar uma decisão em tempo real de permitir ou impedir a transação com base no cálculo do risco associado a ela.
Instituto Nacional de Padrões e Tecnologia (NIST): Zero trust architecture
A equipe do NIST enumera os princípios da confiança zero e define uma arquitetura abstrata de confiança zero (ZTA) em seu artigo NIST SP 800-207.2 Além disso, eles discutem variações das abordagens de confiança zero e descrevem diferentes maneiras de implementar a arquitetura abstrata.
As principais abstrações discutidas no artigo são o Ponto de Decisão de Política (PDP) e o Ponto de Aplicação de Política (PEP), que atuam em conjunto. O Ponto de Decisão de Política é composto pelo Mecanismo de Política (PE) e pelo Administrador de Política (PA). O Mecanismo de Política usa um algoritmo de confiança para decidir se um sujeito deve receber acesso a um recurso. Essa decisão é executada pelo Administrador de Política, que se comunica com o Ponto de Aplicação de Política para permitir ou impedir uma nova sessão, bem como modificar ou encerrar uma sessão existente. Além disso, o artigo aborda variações do algoritmo de confiança, componentes de rede para um ambiente de confiança zero e diversos casos de uso ou cenários de implantação. Por fim, são analisadas as formas pelas quais invasores podem comprometer a arquitetura de confiança zero, para que os responsáveis pela implementação estejam cientes das ameaças e adotem as medidas adequadas para proteger os componentes dessa arquitetura.
Agência de Segurança Cibernética e de Infraestrutura (CISA): Modelo de maturidade de confiança zero
Com o objetivo de ajudar as agências a desenvolver seus planos de confiança zero, especialistas da Agência de Segurança Cibernética e de Infraestrutura (CISA) publicaram um modelo de maturidade de confiança zero (https://www.cisa.gov/zero-trust-maturity-model).3 O trabalho se baseia na arquitetura abstrata de confiança zero descrita no documento NIST SP 800-207. Os autores identificaram cinco áreas e recomendam que as organizações avancem de forma consistente na adoção dos princípios de confiança zero em cada uma delas. As áreas são: (i) identidade, (ii) dispositivo, (iii) rede, (iv) carga de trabalho de aplicações e (v) dados. Eles recomendam o uso de visibilidade e análise, bem como de automação e orquestração, em cada uma das cinco áreas.
O documento apresenta um modelo de maturidade de alto nível que abrange os cinco pilares fundamentais da confiança zero identificados anteriormente e, em seguida, aprofunda-se em cada área. As organizações podem usar o modelo de maturidade para compreender seu estado atual e definir um caminho iterativo rumo ao estado ideal.
Departamento de Defesa (DOD): arquitetura de referência de confiança zero
Após a descoberta dos ataques à SolarWinds, a Agência de Segurança Nacional (NSA) publicou orientações recomendando que as equipes de segurança cibernética adotassem um modelo de segurança de confiança zero no documento “Adoção de um modelo de segurança de confiança zero”.4 Especialistas da equipe conjunta de engenharia de confiança zero da Agência de Sistemas de Informação de Defesa (DISA) e da Agência de Segurança Nacional elaboraram a arquitetura de referência de confiança zero do Departamento de Defesa (DOD).5 Os autores expressam a necessidade de adotar a confiança zero com a seguinte declaração: “As vulnerabilidades expostas por violações de dados dentro e fora do DOD demonstram a necessidade de um modelo de segurança cibernética novo e mais robusto, que facilite decisões bem fundamentadas e baseadas em riscos.”6
Essa arquitetura de referência baseia suas recomendações nas abstrações definidas no documento de arquitetura de confiança zero NIST SP 800-207. O documento apresenta um modelo operacional de alto nível e descreve seus elementos em detalhes. Ele também inclui um modelo de maturidade de alto nível e o mapeamento das capacidades necessárias para aplicar os princípios de confiança zero a diversas áreas de interesse. Em conjunto, esses documentos ajudam as organizações a avaliar seu estado atual e elaborar um plano.
Gerenciamento de riscos e governança com princípios de confiança zero
Adotar uma postura que “pressupõe uma violação” e seguir os princípios de confiança zero pode ajudar as organizações em suas práticas de gestão de riscos e governança. Os princípios de confiança zero de “monitoramento contínuo” e “verificação explícita” dos agentes envolvidos nas transações permitem que as organizações criem uma pontuação dinâmica de risco para todos os agentes e suas atividades. Isso está alinhado à recomendação da Gartner de usar a metodologia de “avaliação contínua e adaptativa de riscos e confiança” (CARTA) para aprimorar os programas de segurança existentes. Adotar o princípio de permitir apenas o acesso com privilégios mínimos aos recursos reduz o risco de perdas, mesmo após uma violação. As informações geradas pelo monitoramento contínuo e pela verificação explícita também são úteis para a elaboração de relatórios de conformidade.
Mentalidade em mais detalhes
Esta seção se concentra na mentalidade — o sistema de crenças, o “porquê” — que orienta a estratégia e as decisões relacionadas às ferramentas e à arquitetura que uma empresa deve adotar para implementar a segurança de confiança zero. Na verdade, é possível resumir em quatro princípios fundamentais e simples a motivação por trás de todos os métodos e tecnologias que compõem as atuais soluções de confiança zero. Esta seção começa enumerando esses princípios e, em seguida, discute como eles podem ser aplicados no contexto mais amplo do ciclo de vida de desenvolvimento de aplicações — ou seja, como considerá-los desde o início, na fase de projeto, e também no âmbito operacional, durante a implantação e a execução da aplicação.
Princípios operacionais de confiança zero
Se as soluções de confiança zero forem entendidas como formas de estabelecer confiança nas interações entre sistemas – “Quem está fazendo O quê para Quem?” –, então o estabelecimento de um nível de confiança adequado à interação pode ser dividido em quatro componentes.
Verificar explicitamente
Como o nome sugere, a mentalidade de confiança zero segue o princípio: “Não confie cegamente; sempre verifique.” Portanto, qualquer agente no sistema — o Quem e o Com quem nas interações do sistema — deve ser capaz de:
- Comprovar sua identidade, incluindo o caso especial de uma identidade “anônima”, se o sistema permitir interações originadas de ou destinadas a identidades anônimas — como navegadores anônimos em um sistema de reservas de passagens aéreas. Para todas as outras identidades, o agente deve ser capaz de declarar quem é, em um namespace aceito pelo sistema.
- Receber e validar “provas” complementares da identidade declarada pelo agente (para qualquer identidade declarada não anônima). A natureza da “prova” — senhas, certificados, comportamentos etc. — pode variar, assim como sua robustez, mas o sistema deve ser capaz de determinar algum grau de confiança na declaração. Sistemas simples podem adotar uma avaliação binária de sim/não quanto à confiabilidade da prova, enquanto sistemas mais avançados podem usar uma pontuação numérica de confiança que possa ser explicitamente considerada como parte de uma política baseada em risco e recompensa. Observe que o sistema também pode aumentar ou reduzir a confiança por outros meios, como pela resposta a um desafio ativo ou até mesmo pela observação passiva do comportamento do agente.
- Avaliar e ajustar o nível de confiança na identidade declarada, com base na contextualização adicional do comportamento atual em relação aos comportamentos anteriores. Por exemplo, o sistema pode manter metadados históricos sobre o agente, como sua geolocalização anterior e atual, plataformas de hardware, endereços IP, reputação e assim por diante, a fim de aumentar ou diminuir a confiança na “prova” de identidade.
Além disso, o princípio de verificar explicitamente pode ser aplicado não apenas à identidade, mas também à ação — o “O quê” da transação. Um caso de uso comum ocorre quando a ação é expressa como uma chamada de API, como uma API para realizar uma consulta a um banco de dados. Neste exemplo, o princípio de verificar explicitamente pode ser usado não apenas para assegurar a identidade do agente que chama a API, mas também para verificar se a ação da API está sendo usada corretamente, por exemplo, confirmando se os parâmetros passados para a API estão em conformidade com as restrições apropriadas.
Em uma mentalidade madura de confiança zero, a “prova” quase nunca é absoluta. Credenciais de identidade podem ser roubadas e dispositivos podem ser comprometidos; as restrições de parâmetros de API muitas vezes são incompletas. Portanto, o termo “confiança”, no contexto de confiança zero, deve ser interpretado mais como uma indicação da probabilidade de a identidade atestada ou os parâmetros da transação serem legítimos. Assim, o nível de “confiança” deve ser considerado um fator importante, mas não o único, na decisão de permitir, bloquear ou inspecionar mais detalhadamente uma transação.
Privilégio mínimo
Depois que um nível aceitável de “confiança” é estabelecido nos atores que participam de uma transação, a abordagem de confiança zero exige que sejam concedidos ao ator (normalmente, o solicitante, o “Quem”) apenas os privilégios mínimos necessários para que ele possa fazer aquilo para o qual foi projetado nesse sistema. Esse princípio incorpora o que também é chamado de “modelo de segurança positivo” — uma abordagem na qual todas as ações são bloqueadas por padrão, e privilégios específicos são concedidos somente conforme necessário para a operação do sistema. Por exemplo, um sistema de reservas pode permitir que usuários anônimos consultem os horários dos voos, mas, de acordo com os requisitos de design da aplicação, um usuário anônimo pode não ter permissão para reservar um voo.
Esses privilégios podem se aplicar a atores individuais ou a classes de atores. Normalmente, os consumidores de uma aplicação são atores humanos ou representantes de seres humanos e são agrupados em classes, como “usuários anônimos”, “clientes”, “parceiros” ou “funcionários”. As classes de atores menos confiáveis geralmente precisam atingir um nível de confiança mais baixo para passar pela autenticação, mas também têm acesso a menos APIs ou a APIs menos sensíveis. Os atores internos à aplicação ou à sua infraestrutura, como serviços ou contêineres específicos dentro de uma aplicação, muitas vezes podem ter privilégios mais personalizados, como “somente os contêineres <X> e <Y> podem acessar o banco de dados; somente <X> pode gravar no armazenamento de objetos, mas <Y> e <Z> podem ler dados dele”.
Uma consideração importante para a implementação do privilégio mínimo é procurar aplicá-lo de maneira mais personalizada e criteriosa.7 Especificamente, em vez de aplicar um conjunto genérico de privilégios a todos os agentes ou a uma classe de agentes, uma implementação madura de confiança zero deve ter uma visão mais granular de Qual ação está sendo tentada. Por exemplo, em um nível muito abrangente, o privilégio de “acesso ao sistema de arquivos” pode ser concedido, mas “leitura do sistema de arquivos” é uma especificação mais precisa do privilégio realmente necessário, o que resulta em uma implementação de alta qualidade do modelo de segurança positiva.
Por fim, implementações mais sofisticadas do privilégio mínimo podem funcionar em conjunto com implementações maduras do princípio de “verificar explicitamente”, considerando os privilégios autorizados de um agente não como absolutos, mas como condicionados ao nível de confiança fornecido pela autenticação. Assim, os privilégios são concedidos somente se a confiança na identidade atestada (Quem) atingir um limite mínimo, com limites específicos para a ação que está sendo tentada. Por exemplo, uma ação de impacto particularmente elevado (como desligar o sistema) pode exigir um nível de confiança de 90% ou mais de que o agente seja um administrador. Nesse exemplo, se a confiança do sistema na identidade for de apenas 80% quando houver uma tentativa de desligamento, o sistema exigirá uma verificação adicional para aumentar o nível de confiança na identidade atestada antes de permitir a ação.
Avalie continuamente
A verificação explícita e o privilégio mínimo são conceitos fundamentais; no entanto, o princípio da avaliação contínua reflete o fato de que esses princípios devem ser avaliados continuamente, no sentido de que:
- Todas as transações devem estar sujeitas a verificação e controle de privilégios. Em outras palavras, não se deve inspecionar apenas um subconjunto das transações, como “a primeira transação em uma sessão de usuário” ou “as transações iniciadas por meio de uma carga de trabalho em contêiner Docker”. Embora isso possa parecer óbvio, muitas implementações de confiança zero não validam todas as transações, seja por falhas de projeto ou por falta de visibilidade. Deficiências comuns nessa área decorrem da aplicação da confiança zero apenas a agentes externos, mas não aos internos, e/ou da suposição de que uma decisão de confiança zero permanece válida por um longo período.
- Os principais fatores da avaliação – a confiança na identidade do agente e os direitos concedidos a ele – devem ser considerados dinâmicos e sujeitos a alterações. Por exemplo, a confiança em uma identidade pode aumentar ou diminuir ao longo do tempo, com base nos comportamentos observados e nos metadados de canal lateral; portanto, qualquer política baseada em confiança também deve se ajustar dinamicamente às mudanças no nível de confiança. Além disso, um limite de privilégio concedido anteriormente por uma política pode ser revogado pouco tempo depois, ou o nível mínimo de confiança exigido para determinada ação pode mudar. Embora os intervalos de tempo das alterações nas políticas variem – elas podem ocorrer lentamente (na escala de tempo dos processos operacionais humanos) ou rapidamente (por meio de agentes automatizados de governança) –, o sistema deve ser capaz de responder dinamicamente a essas alterações e respeitá-las.
Presuma uma violação
O princípio final se baseia na presunção de que existem adversários altamente motivados, em um contexto de paranoia saudável. Especificamente, a premissa é “presuma que você sofreu uma violação”, sendo “violação” definida como “uma transação que deveria ter sido negada (com conhecimento e execução perfeitos), mas que acabou sendo permitida”. A causa raiz dessa falha pode ser um conhecimento imperfeito (por exemplo, uma pontuação incorretamente alta de confiança na autenticação, decorrente de credenciais fraudulentas não detectadas), limitações de implementação (por exemplo, a falta de granularidade suficiente na especificação dos privilégios concedidos, como ter “abrir conexão de rede” como privilégio, mas sem a capacidade de diferenciar com base na geolocalização do destino da rede) ou uma implementação incompleta da confiança zero (por exemplo, não aplicar a confiança zero a componentes vulneráveis de código aberto usados internamente).
Portanto, a mentalidade de confiança zero também deve considerar a melhor forma de gerenciar e minimizar o impacto dessas violações.
A implementação desse princípio varia mais do que a dos demais, mas geralmente se manifesta das seguintes formas:
- Primeiro, identifique quaisquer transações que, embora tecnicamente permitidas pela política, sejam suspeitas. O que é considerado “suspeito” geralmente depende muito do contexto, mas algumas interpretações comuns são: (a) transações anômalas muito diferentes dos comportamentos observados anteriormente; (b) grupos de transações que são individualmente normais, mas coletivamente incomuns — por exemplo, ler e gravar um arquivo pode ser algo comum, mas fazer isso a uma taxa de 1.000 arquivos por segundo pode ser incomum; ou (c) ações correlacionadas a um impacto indesejado e até então inédito no sistema — um exemplo seria um padrão em que uma transação específica abre uma conexão de rede com um nó TOR ou faz com que a carga da CPU do sistema aumente significativamente.
- Em seguida, realize uma análise mais aprofundada, por meio de um fluxo de trabalho totalmente automatizado ou híbrido, controlado por humanos e assistido por aprendizado de máquina, para determinar se essas transações são inválidas. Caso sejam consideradas inválidas, aplique medidas de mitigação. Isso pode assumir a forma de uma atualização geral da política ou, como uma camada adicional de mitigação, de uma “salvaguarda” para as demais medidas de mitigação orientadas por políticas.
Se a abordagem escolhida for usar ajustes baseados em políticas, esses ajustes poderão ser aplicados utilizando qualquer uma das ferramentas de política estática disponíveis. Exemplos de ajustes baseados em políticas incluem restringir os privilégios de controle de acesso no nível da transação (ou seja, não permitir mais que Quem faça O quê a Quem) ou, alternativamente, aplicar um “padrão de comprovação” mais rigoroso (ou seja, exigir MFA ou uma pontuação de confiança mais alta) para que um agente (ou uma classe de agentes) execute uma ação específica.
Se, em vez disso, for escolhida a abordagem de usar uma camada adicional de “proteção”, essa estratégia também poderá ser implementada com granularidade fina ou grossa. A estratégia de granularidade mais fina seria bloquear exatamente e somente as transações que ultrapassassem uma relação risco-benefício específica, embora essa solução também possa adicionar níveis inaceitáveis de latência a algumas transações permitidas caso a implementação exija análises adicionais. Em vez disso, poderiam ser usadas estratégias de granularidade mais grossa, como colocar em sandbox as transações futuras desse agente ou até mesmo impedir totalmente o acesso do agente ao sistema. Em casos extremos, métodos de mitigação ainda menos granulares — como desativar as operações de E/S de arquivos — podem ser apropriados.
É claro que, em igualdade de condições, uma mitigação de último recurso mais granular geralmente é preferível. No entanto, muitas vezes é necessário fazer concessões com base nas limitações das tecnologias de solução disponíveis, e uma proteção de último recurso menos granular costuma ser melhor do que nenhuma. Por exemplo, se a resposta menos granular para impedir uma possível ação de ransomware for desabilitar as operações de E/S de arquivos, os efeitos colaterais dessa resposta ainda poderão ser preferíveis à alternativa — permitir que o agente continue operando livremente no sistema —, supondo que a inação resulte em um sistema de arquivos criptografado por ransomware.
Confiança zero: tudo realmente começa antes das operações
O melhor ponto de partida para o desenvolvimento seguro de aplicações com confiança zero é, sem surpresa, o início. Os princípios fundamentais que permitem colocar a confiança zero em prática devem ser incorporados à fase de design dos processos de desenvolvimento de aplicações. Portanto, qualquer discussão sobre uma solução operacional de confiança zero integrada ao pipeline de CI/CD deve começar pela compreensão desses elementos fundamentais, que devem ser considerados aspectos prioritários do design.
O cerne desses elementos fundamentais deve capturar o comportamento desejado/pretendido das interações entre os comportamentos do sistema, aliado a visibilidade e controle suficientes para detectar desvios e agir sobre eles. As interações pretendidas são usadas para definir o conjunto desejado de ações (O quê) de cada ator (Quem) em relação a cada alvo (A quem). Dito isso, pode haver cenários e ambientes em que os padrões de interação pretendidos sejam desconhecidos. Nesses casos, uma organização pode aproveitar uma visibilidade mais aprofundada para “descobrir” o conjunto de interações apropriadas,8 que poderá então codificar em uma política.
Por exemplo, nas soluções de ZTNA atuais, que se concentram no controle de acesso orientado por identidade às APIs externas de uma aplicação, é necessário ter visibilidade e controle sobre as APIs de autenticação. Já no contexto de uma plataforma de proteção de cargas de trabalho na nuvem (CWPP), a detecção de uma carga de trabalho de contêiner comprometida exige visibilidade das ações realizadas por cada contêiner — em tempo real, caso seja necessária uma correção imediata.
A seguir, apresentamos uma lista das “categorias” de alto nível relacionadas às considerações fundamentais que devem fazer parte do processo de design, com detalhamentos adicionais que trazem perguntas específicas a serem consideradas em cada um dos pontos principais:
- Quais são as interfaces de caixa-preta — entradas e saídas — do sistema?
- Quais são as categorias de usuários — administradores, usuários autenticados, usuários não autenticados e parceiros — que interagem com a aplicação, e o que eles precisam fazer?
- Todas as comunicações são realizadas por meio de uma API definida ou há comunicações de rede “brutas” ou comunicações por meio de um repositório de dados, como um banco de dados ou armazenamento de objetos?
- Para comunicações via API, quão bem definida é a API em relação a quais usuários podem interagir com ela e às restrições aplicáveis a essas interações (por exemplo, restrições de parâmetros, limites de taxa etc.)?
- Em qualquer comunicação de rede, todos os dados transmitidos são criptografados?
- Se houver interfaces de dados “brutos” (por exemplo, se as informações forem compartilhadas entre o cliente e a aplicação por meio de um armazenamento de objetos ou banco de dados), existem logs de auditoria para rastrear quem acessou quais informações e quando?
- Da mesma forma, no nível interno de “caixa-branca”, quais são os serviços componentes que constituem as aplicações como um todo, incluindo quaisquer serviços fornecidos externamente, e como eles se comunicam?
- Como esses serviços se comunicam — qual API é usada e quais são as restrições (funções, controles de acesso, limites de requisições, parâmetros etc.) aplicáveis a essas interações?
- Há questões semelhantes às mencionadas acima relacionadas à formalização da API, às suas restrições e à criptografia das comunicações.
- As comunicações “internas” (por exemplo, entre cargas de trabalho/contêineres) têm maior probabilidade de usar memória compartilhada e interfaces baseadas no sistema de arquivos; todas essas interfaces devem ser identificadas.
- Como esses serviços se comunicam — qual API é usada e quais são as restrições (funções, controles de acesso, limites de requisições, parâmetros etc.) aplicáveis a essas interações?
- Quais mecanismos de controle o sistema disponibiliza para limitar o acesso às interfaces de caixa-preta e aos caminhos de comunicação interna?
- Existe uma política que indique quem — quais funções — pode invocar APIs específicas e o que acontece se essa política for violada? Da mesma forma, que mecanismos existem para detectar e mitigar qualquer tipo de uso indevido das APIs, como o uso de parâmetros inválidos ou um número excessivo de invocações? Essas políticas podem ser atualizadas dinamicamente com base em informações contextuais provenientes de outros sistemas?
- De forma análoga, existem políticas que restrinjam as outras formas de comunicação entre cargas de trabalho — sistemas de arquivos, armazenamentos de objetos e tabelas de bancos de dados — quanto a quem pode acessar quais arquivos/armazenamentos/tabelas e que impeçam o uso indevido desses recursos (por exemplo, “SELECT * from <table>”)?
- Que recursos de visibilidade (painéis, logs, estatísticas) o sistema disponibiliza para limitar o acesso tanto às interfaces de caixa-preta quanto aos caminhos de comunicação internos?
- O sistema consegue identificar quem está invocando qual API e em que momento? Esses dados são retidos? Em caso afirmativo, por quanto tempo? Com que rapidez esses dados são disponibilizados (em tempo real, a cada hora etc.)? Quão fácil é consumir esses dados — trata-se de um log de arquivo não estruturado, de dados estruturados em JavaScript Object Notation (JSON) que podem ser enviados a um serviço de gerenciamento de eventos e incidentes de segurança (SEIM) ou de dados registrados em uma tabela de banco de dados de big data?
- Quais são as respostas para essas mesmas perguntas quando se trata de outros meios de comunicação — memória, arquivos, objetos e bancos de dados? Quem está fazendo o quê? Como esses dados são disponibilizados?
- Além dos caminhos de comunicação, que outros controles e mecanismos de visibilidade o sistema oferece para evitar a alocação excessiva ou o consumo excessivo de recursos?
- O sistema oferece visibilidade das métricas de consumo de recursos — CPU, memória, largura de banda, escalabilidade de pods etc.? Em caso afirmativo, qual é o nível de granularidade e quão fácil é utilizar esses dados?
- O sistema possui controles ou mecanismos de proteção para o consumo de recursos — limites de memória/CPU/E/S de arquivos por carga de trabalho, monitoramento de chamadas de sistema para criação de processos, limites para aumentar a capacidade ou a quantidade de pods e limites de taxa para APIs que invocam outros serviços?
Fazer essas perguntas explicitamente ajudará você a descobrir onde existem lacunas na base necessária para viabilizar a confiança zero. Muitas vezes, o simples ato de perguntar, logo no início do projeto, fará com que a lacuna seja solucionada com um esforço adicional mínimo de design. E, quando uma lacuna persistir, o simples fato de estar ciente dela ajudará a direcionar esforços adicionais de segurança ou a identificar superfícies de ataque vulneráveis.
Realizar esse tipo de análise prévia de desenvolvimento seguro é uma parte crucial da mentalidade de confiança zero. Apesar disso, grande parte do foco atual da confiança zero está no que acontece após o projeto inicial, e a maioria das empresas concentra seus esforços nos aspectos da confiança zero posteriores ao projeto. No entanto, considerar cuidadosamente, durante a fase de projeto, os requisitos para uma implementação eficaz da confiança zero evitará esforços adicionais muito maiores para “corrigir as brechas” após a implantação da aplicação.
Considerações sobre mitigação: agilidade, falsos positivos/negativos e risco
Conforme preconiza a premissa de “presumir uma violação” dessa mentalidade, um profissional de segurança deve partir do princípio de que algum adversário suficientemente motivado conseguirá executar uma transação maliciosa — uma ocorrência de Quem faz O quê a Quem que atendeu às regras da política, mas que, em um mundo perfeito, não deveria ter sido permitida. Nesses casos, o foco passa a ser a implementação de um mecanismo eficaz de “última linha de defesa” capaz de identificar essas ocorrências, geralmente com base na observação de padrões de transações e efeitos colaterais no sistema, conforme descrito anteriormente na seção “presumir uma violação”.
No entanto, assim como ocorre com o conceito de identidade, nunca será possível saber com total certeza se uma transação específica é maliciosa ou não. Portanto, tal como acontece com a identidade, uma solução de confiança zero ideal deve informar um grau de “confiança” na legitimidade da transação. Por exemplo, observar um daemon lendo e gravando arquivos a uma taxa 10 vezes maior que a normal durante 10 segundos pode resultar em um grau de confiança (de que se trata de uma atividade maliciosa) de 70%; porém, se essa taxa aumentar 100 vezes e se mantiver assim por 1 minuto, o grau de confiança poderá subir para 95%. Nesse exemplo, adotar a medida corretiva de impedir futuras gravações de arquivos ainda terá alguma chance (uma probabilidade de 30% ou 5%) de ser a resposta incorreta — um “falso positivo”. Portanto, a decisão de aplicar ou não a correção deve considerar o risco de falsos positivos em relação ao possível impacto de permitir um comportamento potencialmente malicioso.
O objetivo do exemplo é destacar que qualquer decisão de adotar uma medida corretiva perceptível pelo usuário é, na verdade, uma decisão de negócios que considera todos os riscos, custos e benefícios relacionados à atividade suspeita. Introduzir obstáculos adicionais à transação aumenta a probabilidade de que o valor não seja recebido, mas não intervir nem adicionar obstáculos gera o risco de comprometimento. Portanto, a decisão de agir (ou não) nesses casos depende de três fatores:
- Qual é o risco de permitir que transações possivelmente maliciosas continuem?
Esse risco pode ser diretamente financeiro, como no caso da transferência de fundos bancários, ou pode envolver custos indiretos, sejam eles operacionais (por exemplo, registros importantes criptografados e mantidos como reféns) ou relacionados à imagem da marca (por exemplo, a adulteração de um site). Também pode haver custos jurídicos ou de conformidade, como os decorrentes do vazamento de dados pessoais de clientes. Em essência, a avaliação de riscos é uma questão de governança, e uma boa governança compreenderá e quantificará os riscos para a aplicação. - Quais são os efeitos colaterais da adoção da medida corretiva?
Os efeitos colaterais podem ser expressos em duas dimensões: (a) o atrito introduzido e (b) o raio de impacto. O atrito indica o quanto se torna mais difícil realizar uma transação legítima, podendo variar de um pequeno inconveniente adicional (por exemplo, uma etapa extra de autenticação) até a impossibilidade de realizá-la (a transação simplesmente não é permitida). O raio de impacto indica se outras transações independentes também serão afetadas e, em caso afirmativo, quantas. Por exemplo, bloquear um usuário específico afetará apenas esse usuário, mas desativar um serviço de registro afetará a capacidade de auditoria de todos os usuários e transações. - Qual é o grau de confiança na hipótese de que a transação é maliciosa?
Aumentar a confiança geralmente implica coletar mais dados e correlacionar informações de mais fontes, e ambas as tarefas levam tempo. Por isso, na prática, essa ponderação costuma se resumir à pergunta: “Por quanto tempo devo observar antes de decidir agir?”
Portanto, embora uma estratégia de confiança zero deva reconhecer que violações ocorrerão, uma abordagem criteriosa adotará uma análise de risco versus benefício para a remediação de transações permitidas, mas que pareçam suspeitas. Essa análise levará em conta o nível de risco das diferentes transações do aplicativo e as consequências da aplicação da remediação, que só deverá ser realizada se o nível de risco superar o benefício esperado para o negócio.
1 https://www.whitehouse.gov/wp-content/uploads/2022/01/M-22-09.pdf
2 https://csrc.nist.gov/publications/detail/sp/800-207/final
3 https://www.cisa.gov/zero-trust-maturity-model
4 https://media.defense.gov/2021/Feb/25/2002588479/-1/-1/0/CSI_EMBRACING_ZT_SECURITY_MODEL_UOO115131-21.PDF
5 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
6 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
7 A reflexão prévia começa na fase de projeto, conforme descrito mais adiante.
8 Ou, pelo menos, o conjunto de interações “consideradas adequadas” que o sistema aparentemente exige. Sempre há o risco de que o conjunto de interações derivado da observação esteja incompleto ou apresente algum risco preexistente. Portanto, é sempre preferível refletir previamente durante o projeto.
PUBLICADO EM 04 DE MAIO DE 2022