Como ocurre con toda tecnología que acaba dominando las conversaciones sobre los centros de datos, DevOps sufre actualmente una cierta saturación en torno a su definición. De hecho, a estas alturas creo que se trata más bien de agotamiento, aunque resulta difícil distinguir entre ambos. Baste decir que DevOps está tan lejos como la nube y las SDN de contar con una definición aceptada universalmente.
Pero DevOps tiene la particularidad de que los conceptos que lo componen también suelen confundirse y mezclarse. Por ejemplo, CD puede entenderse como «entrega continua» o «despliegue continuo». No son lo mismo y no deberían confundirse ni mezclarse. Puppet Labs ilustró muy bien la diferencia en una entrada de blog:
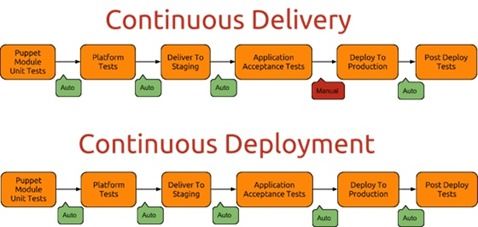
Observará que la diferencia fundamental radica en si el despliegue en producción es «manual» (entrega continua) o «automatizado» (despliegue continuo).
La cuestión es que hay una cantidad considerable de trabajo en ese pequeño recuadro naranja denominado «desplegar en producción» que debe automatizarse. No se trata solo de desplegar la aplicación y sus dependencias (bases de datos, otros servicios, infraestructura, etc.). También hay que desplegar todos los servicios de red y de aplicaciones necesarios para hacer llegar esa aplicación al consumidor final. Aquí es donde entran en juego los servicios de aplicaciones y donde la entrega de aplicaciones (en el sentido de producción, no de desarrollo) se incorpora al proceso de despliegue continuo.
Para automatizar el paso «desplegar en producción» dentro del proceso de despliegue continuo, es necesario aprovisionar, configurar y probar muchos componentes. Esto abarca desde los servicios básicos de red hasta los de seguridad (como los cortafuegos), disponibilidad (balanceo de carga) y rendimiento (aceleración, almacenamiento en caché, etc.). De media, las organizaciones utilizan 11 servicios diferentes de entrega de aplicaciones para satisfacer su necesidad de disponer de aplicaciones rápidas, seguras y disponibles. Cada uno de ellos debe desplegarse (aprovisionarse y configurarse), y algunos dependen del despliegue de otros.
Cada uno de esos servicios (esto es como el acertijo de St. Ives, para quienes estén siguiendo el hilo) tiene un número variable de características que deben configurarse, opciones que deben activarse o desactivarse, algoritmos que deben seleccionarse, rutas que deben establecerse, etc.
En otras palabras, pasar de «manual» a «automático» no es ni mucho menos tan fácil como parece.
¿Qué está frenando la red?
Un obstáculo importante para automatizar estos procesos radica en las diferencias entre los componentes compartidos y los específicos de cada aplicación. La infraestructura como código es posible en el ámbito de la infraestructura de aplicaciones precisamente porque podemos dedicar infraestructura (como un servidor web o un balanceador de carga) a una aplicación. Esto significa que su archivo de configuración funciona en cierto modo como un microservicio: está localizado y se centra en prestar servicios a una única aplicación.
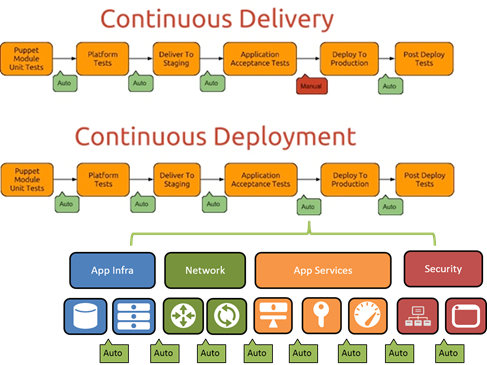
Cuando pasamos al mundo de las redes y los servicios de aplicaciones, no siempre es así. Un router o un switch, por ejemplo, está diseñado específicamente para proporcionar conectividad y servicios de reenvío a varias aplicaciones. Esto significa que los archivos de configuración incluyen necesariamente varias aplicaciones. Aunque el control de versiones puede resultar útil en este caso, lo cierto es que las configuraciones están estrechamente vinculadas a un dispositivo, no a una aplicación. Lo mismo ocurre con los servicios de aplicaciones y la seguridad.
Así que, aunque está muy bien que todos avancemos hacia un mundo en el que la API sea la CLI, también debemos abordar la necesidad de admitir un paradigma por aplicación (o centrado en la aplicación, si se prefiere) en el que las configuraciones puedan gestionarse por aplicación individual.
Esto implica avanzar hacia una arquitectura de red basada en microservicios, en la que los servicios se implementen y configuren para cada aplicación. Esto puede adoptar la forma de «dispositivos» dedicados (virtuales o físicos; el formato es irrelevante a efectos de este análisis) o de configuraciones específicas para cada aplicación, como las plantillas.
¿Ya hemos llegado?
Nos estamos acercando gracias a modelos declarativos de aprovisionamiento y gestión que utilizan API para desplegar plantillas (lo que se conoce como infraestructura como código) para cada aplicación, pero aún no hemos llegado a ese punto. Todavía queda mucho trabajo por hacer para determinar cómo orquestar la automatización necesaria para hacer plenamente posible un despliegue continuo satisfactorio.
Los silos de red, infraestructura, servicios de aplicaciones y seguridad deben incluirse si queremos pasar de «manual» a «automático» en esa fase de «despliegue en producción», que es fundamental para completar la transición de la entrega continua al despliegue continuo. Y eso implica más trabajo en la capa de automatización, así como la coordinación global necesaria para automatizar por completo los procesos que, en última instancia, impulsan el despliegue continuo en producción.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.