Las medidas de protección integradas en los modelos no bastan por sí solas para mantener seguros los sistemas de IA. Es algo que nuestro equipo de investigación constata cada mes al probar modelos de vanguardia (los resultados se publican en nuestra clasificación AI Security Leaderboards). Aunque las medidas de protección de los modelos son útiles para establecer límites de comportamiento, los atacantes no cejan en su empeño. Ante el constante aluvión de inyecciones de prompts, intentos de jailbreak y nuevos exploits, las organizaciones quedan expuestas a filtraciones de datos, incumplimientos normativos y manipulaciones maliciosas que estas medidas no están diseñadas para detener. Para proteger realmente las aplicaciones y los agentes de IA, las organizaciones necesitan medidas de protección en tiempo de ejecución que actúen en tiempo real para detectar y bloquear las amenazas en el momento en que se producen.
Por qué las empresas no pueden depender únicamente de las Guardrails del modelo
Las medidas de protección de los modelos de IA son herramientas preventivas que suelen integrarse en el entrenamiento, el aprendizaje por refuerzo o las reglas de los prompts. Definen el comportamiento previsto de los sistemas de IA, limitando lo que los modelos deben y no deben hacer. Sin embargo, una vez que un modelo está en producción, su uso en el mundo real pone de manifiesto sus limitaciones mediante situaciones como:
- Atacantes que idean nuevos prompts y exploits para eludir las restricciones de las barreras de seguridad
- Filtraciones de información confidencial, como datos de identificación personal (PII) o código fuente, incluso cuando los resultados parecen seguros
- Adaptación lenta, ya que las medidas de protección de los modelos suelen requerir un nuevo entrenamiento o una reconfiguración antes de poder hacer frente a nuevas amenazas
En otras palabras, las medidas de protección de los modelos sirven de guía, pero no garantizan la seguridad.
Las Guardrails en tiempo de ejecución detectan lo que las Guardrails del modelo pasan por alto
F5 AI Guardrails cubre las carencias que dejan las medidas de protección del modelo. Al operar en tiempo de ejecución, las medidas de protección en tiempo de ejecución inspeccionan tanto las instrucciones como las respuestas en tiempo real, bloqueando o marcando las interacciones de riesgo antes de que surjan problemas. Por ejemplo, las medidas de protección contra la inyección de instrucciones y el jailbreak pueden detectar instrucciones manipuladoras que intentan eludir las políticas. Del mismo modo, las medidas de protección contra la pérdida de datos impiden que los datos confidenciales salgan de la organización.
Las medidas de protección en tiempo de ejecución pueden funcionar en modo de bloqueo (para impedir infracciones) o en modo de auditoría (para registrar eventos con fines de supervisión). A diferencia de las medidas de protección del modelo, estas medidas de protección en tiempo de ejecución se actualizan continuamente, lo que garantiza que las defensas sigan el ritmo de la evolución de los ataques.
En pocas palabras, las barreras de protección del modelo son como las vallas que delimitan por dónde pueden moverse las personas alrededor de un edificio. Las barreras de protección en tiempo de ejecución son los controles de seguridad de la entrada—inspeccionan todo lo que cruza el umbral. Unas establecen los límites; las otras garantizan que no se cuele nada dañino.
Diferencias clave
Aunque tanto las medidas de protección en tiempo de ejecución como las del modelo contribuyen a la seguridad de la IA, funcionan de maneras fundamentalmente distintas. Esta tabla resume las diferencias de un vistazo.
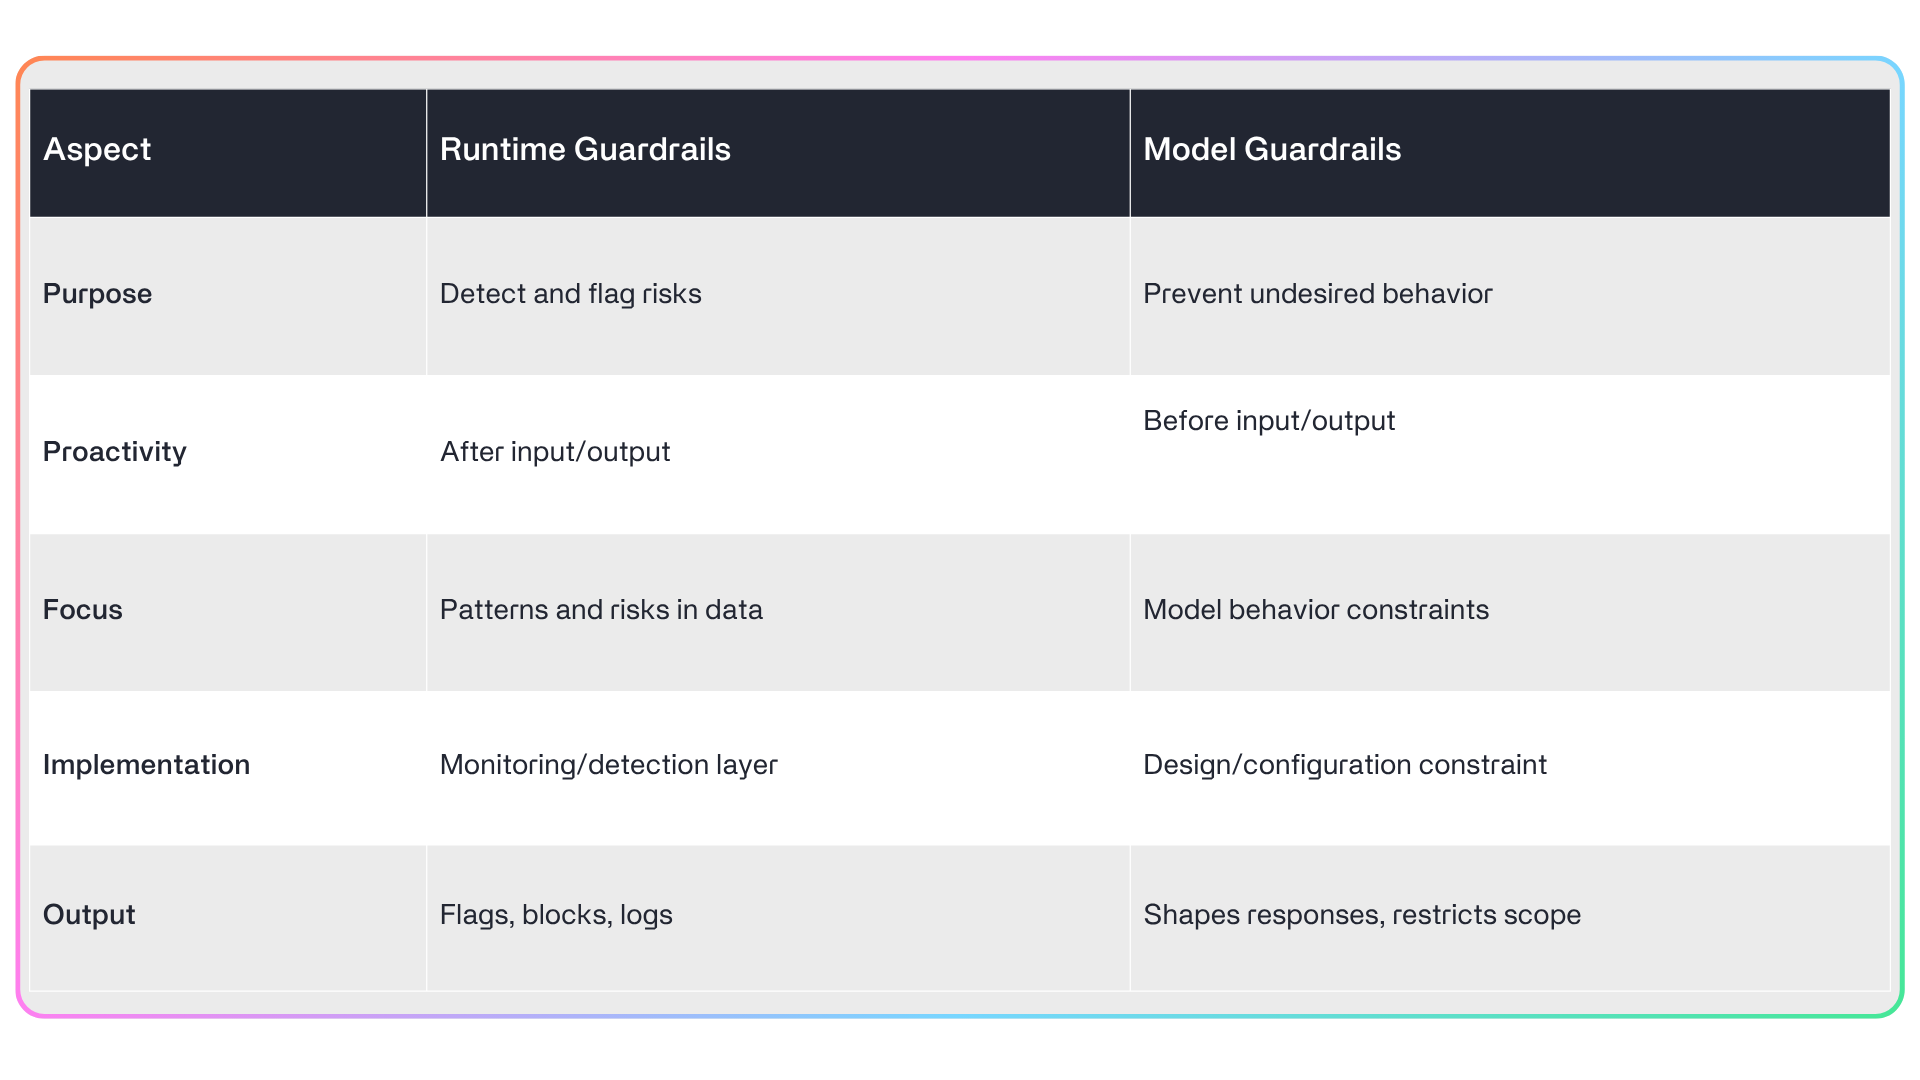
Este contraste deja algo claro: las medidas de protección del modelo ayudan a orientar la IA, pero son las medidas de protección en tiempo de ejecución las que realmente garantizan su seguridad en producción.
Por qué las empresas necesitan Guardrails en tiempo de ejecución para proteger la IA
Aunque las medidas de protección en tiempo de ejecución ofrecen capas de protección más sólidas durante la inferencia, su verdadero valor se manifiesta cuando se combinan con las medidas de protección del modelo, ya que ambas trabajan conjuntamente para crear una estrategia de defensa en profundidad.
Las medidas de protección del modelo establecen los límites básicos de su comportamiento. Las medidas de protección en tiempo de ejecución amplían esa protección, ya que detectan nuevas amenazas e intentos de elusión que las medidas de protección del modelo no pueden prever. Por ejemplo, una medida de protección del modelo podría impedir que este ofreciera asesoramiento médico, mientras que una medida de protección en tiempo de ejecución detectaría y bloquearía los intentos de eludir esa norma mediante formulaciones indirectas o instrucciones manipuladoras.
Este enfoque por capas ofrece la postura más sólida en materia de seguridad de la IA, lo que permite a las empresas innovar con confianza y mantener su resiliencia frente a riesgos en constante evolución.
Sobre el autor

Artículos relacionados del blog

El imperativo empresarial de la IA en un mundo de nube híbrida y multinube
Cómo la IA redefine los patrones de tráfico, el riesgo de las API y el cumplimiento normativo, y por qué el paquete Distributed Cloud Services Enterprise ofrece la profundidad necesaria en entornos híbridos multicloud.

STIG de F5 NGINX: un plan de seguridad para el sector público y los entornos regulados
Descubra cómo las STIG de F5 NGINX proporcionan un modelo de seguridad para el Departamento de Defensa de EE. UU. y los entornos regulados, ayudándole a cumplir la normativa mientras crea una infraestructura sólida de confianza cero con mayor visibilidad y resiliencia.

Cómo el marco AEGIS de Forrester valida un enfoque centrado en la inferencia
El auge de la IA agéntica está transformando el panorama de la seguridad empresarial. Estos agentes de IA autodirigidos funcionan de forma autónoma, toman decisiones en tiempo real y pueden interactuar entre distintos sistemas de maneras para las que las arquitecturas tradicionales de ciberseguridad no fueron diseñadas. Aunque esto abre nuevas posibilidades, también introduce riesgos sistémicos: fallos en cascada, secuestro de objetivos y superficies de ataque hasta ahora invisibles. El reciente […] de Forrester
La nueva superficie de riesgo de la IA: invisible, autónoma y ya está dentro
James White, vicepresidente de Ingeniería de F5 A mediados de 2025, es un buen momento para hacer balance de la adopción de la IA en las empresas y del estado de la seguridad de la IA. El uso de la IA generativa ya es habitual en las empresas En general, las empresas cuentan al menos con unos conocimientos básicos sobre la IA generativa. Entienden qué es y dónde puede […]
Protegiendo el futuro: cómo CalypsoAI se alinea con el Top 10 de OWASP para los LLM
Cuando OWASP publicó su Top 10 de 2025 para grandes modelos de lenguaje (LLM), proporcionó al sector un referente de seguridad muy necesario. Pero los referentes no sirven de nada si no se actúa. CalypsoAI aborda el 80 % del Top 10 de OWASP, dando prioridad a los riesgos reales más urgentes. La plataforma combina protección en tiempo real durante la ejecución y pruebas adversariales exhaustivas, ofreciendo una cobertura inigualable frente a las […]
Implementación de LLM en la empresa: mediante una API local
Por sí solos, sin medidas de protección ni protocolos adicionales de seguridad para la IA, el despliegue de modelos de IA generativa —en particular, modelos de lenguaje de gran tamaño (LLM)— en toda la empresa supone una oportunidad de alto riesgo y grandes beneficios para cualquier organización. Sin embargo, determinar exactamente cómo debe dar su organización este gran paso hacia el ámbito de la IA generativa requiere una planificación minuciosa. Quizá […]