
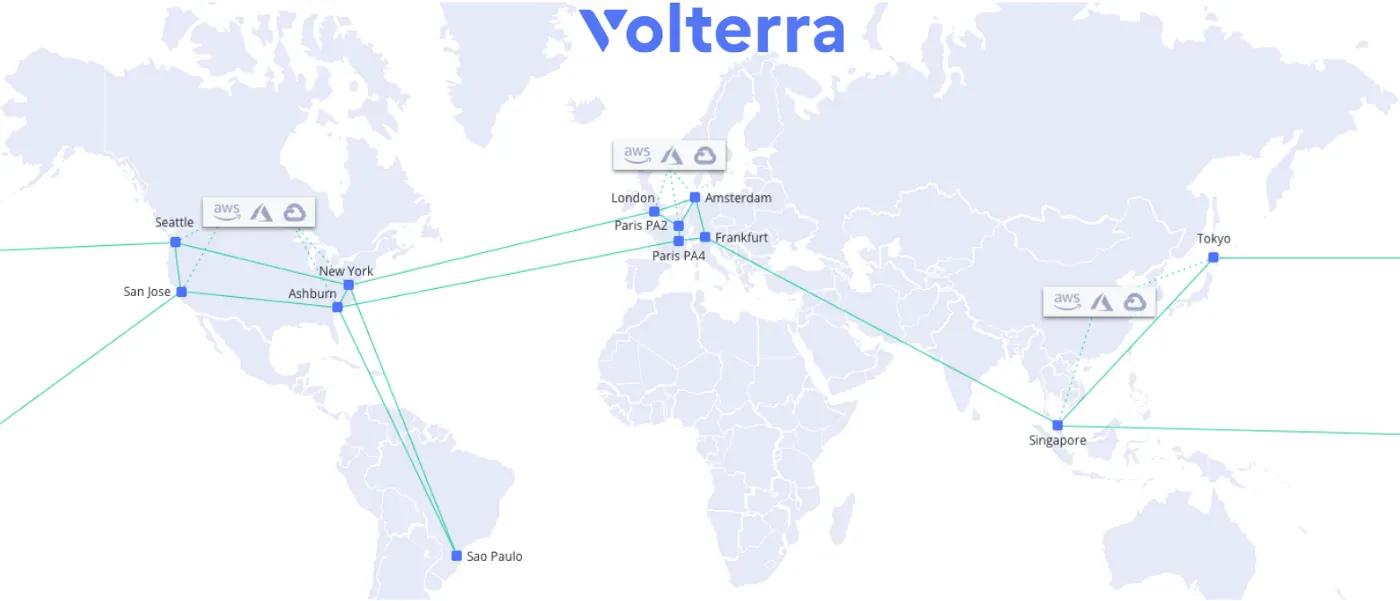
Como parte de nuestro plano de control basado en SaaS, hemos creado y operamos nuestra propia red troncal global (AS35280), utilizando múltiples enlaces de 100G y 400G entre nuestros PoP.
De este modo, tenemos un control total sobre la conectividad de extremo a extremo entre nuestros puntos de presencia regionales, lo que también nos permite ofrecer a nuestros clientes la misma conectividad de alto rendimiento y baja latencia en sus centros de datos privados, ubicaciones perimetrales, VPC de nube pública (AWS, Azure, GCP) y proveedores de SaaS.
El requisito
Nuestra presencia en Europa ya era bastante buena, con puntos de presencia en París, Londres, Ámsterdam y Fráncfort, pero tanto los clientes actuales como los nuevos necesitaban un nuevo PoP en Lisboa, Portugal.
Todo esto se acordó a principios de 2020 y el despliegue estaba previsto para el tercer trimestre de 2020. Por supuesto, esto fue antes de la COVID-19 :)
Con la crisis, observamos un aumento considerable del tráfico en nuestra red troncal (así como de los ataques DDoS, aunque hablaremos de ello en una futura entrada del blog), y lo mismo les ocurrió a nuestros clientes.
Nos pidieron que lo desplegáramos antes del tercer trimestre, porque necesitaban este PoP cuanto antes; más concretamente, antes de finales de mayo. Y como en Volterra somos buena gente y, además, nos gustan los retos, analizamos detenidamente cuánto tiempo necesitaríamos para satisfacer la petición del cliente:
- Necesitábamos al menos 2 semanas para realizar el despliegue y las pruebas,
- Y una semana para validar
Teniendo en cuenta que estábamos a principios de abril, nos pareció bien y decidimos seguir adelante y poner en marcha el proyecto, aunque en realidad era el peor momento posible para hacerlo, debido a:
- Prohibición de viajar,
- Sin acceso al centro de datos,
- Escasez mundial de componentes,
- Por no hablar de los riesgos para la salud.
¿Qué se necesita?
Desplegar un nuevo PoP no consiste únicamente en instalar routers, switches y cables. También es necesario:
- realizar tareas de ingeniería de redes para elegir la mejor ubicación y los mejores proveedores de circuitos de longitud de onda,
- llegar a un acuerdo/negociar con el centro de datos elegido (Equinix LS1 en ese caso),
- negociar con el IXP para conseguir puertos de peering,
- y, por supuesto, pedir el hardware y los materiales necesarios (routers, switches, cables, firewalls, etc.)
Cómo lo hicimos
Debido a la crisis actual, era imposible disponer a tiempo del hardware necesario. Por ello, decidimos reutilizar algunos equipos que teníamos disponibles, en su mayoría procedentes de nuestro laboratorio. Consideramos que era una solución de compromiso aceptable (por ejemplo, los routers utilizados serán Juniper QFX10K en lugar de los MX10K previstos).
La preparación, que normalmente llevamos a cabo, como es lógico, en un centro de datos (por la potencia eléctrica y el espacio en rack necesarios, pero también por… ¡el ruido!), tendría que hacerse en casa debido al confinamiento. Raphaël, nuestro director de Tecnología de Infraestructuras, disponía de un despacho lo bastante grande (y de un contrato de 60 amperios, algo que puede resultar útil al arrancar o alimentar equipos que consumen hasta 16 amperios), así que se encargaría él solo de toda la preparación, evitando además que otros empleados tuvieran que participar o salir de casa.
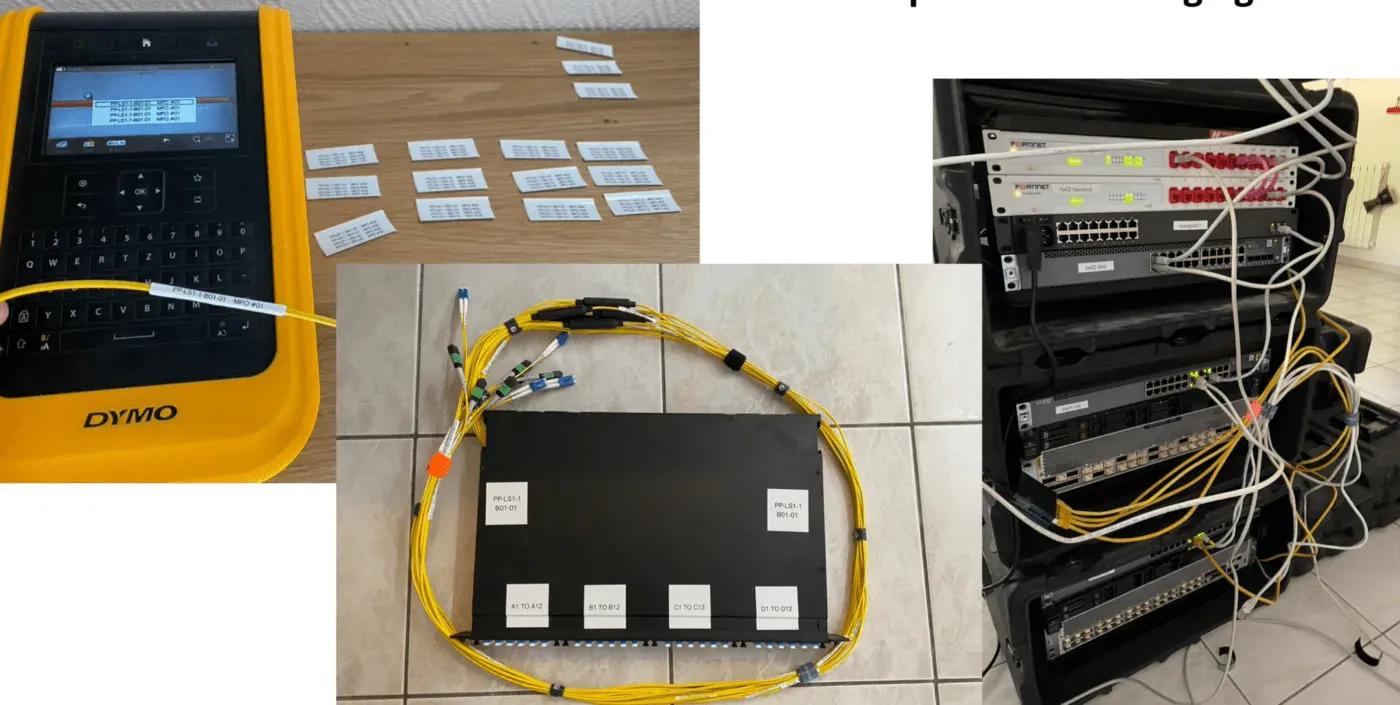
Una vez que todo estuvo configurado y se probó varias veces, lo enviamos a Lisboa:
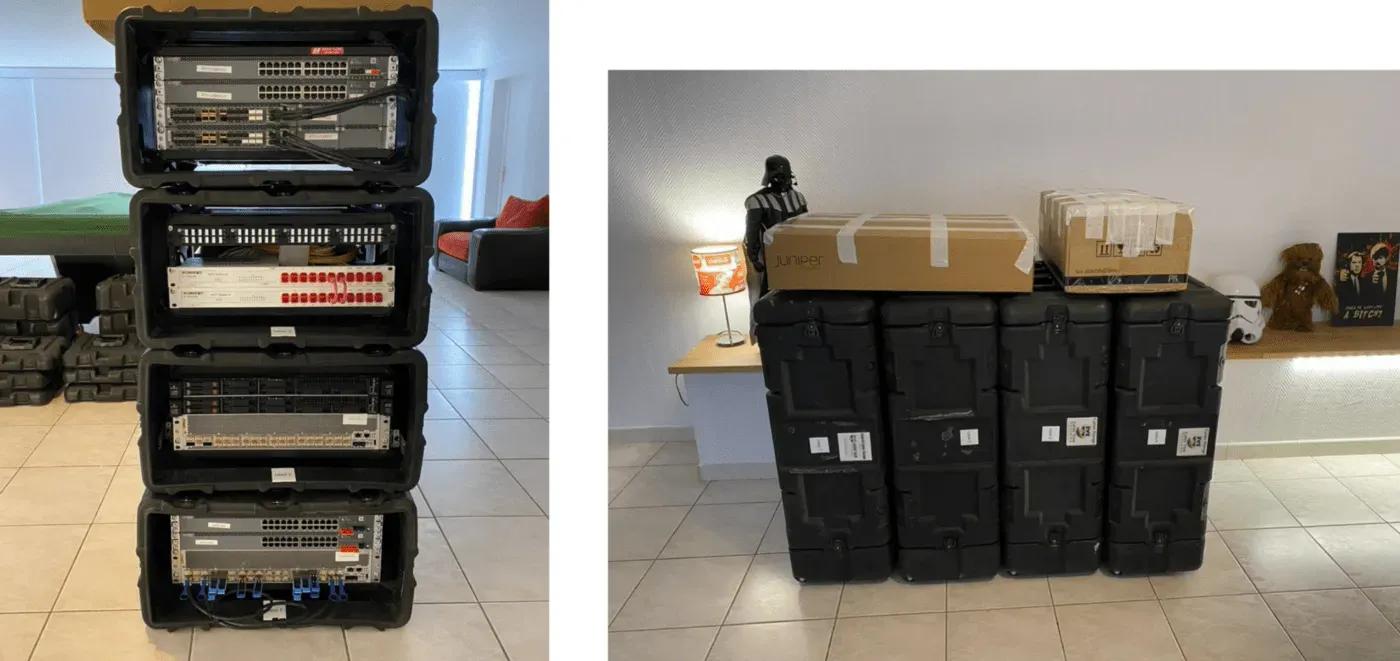
Instalación del rack en Lisboa por el servicio de manos remotas de Equinix
Aunque confiábamos en la configuración que habíamos realizado (y, en cualquier caso, teníamos acceso remoto mediante OOB o nuestra red troncal), esta era la primera vez que un nuevo PoP no lo desplegaríamos nosotros directamente, sino otra persona 😅
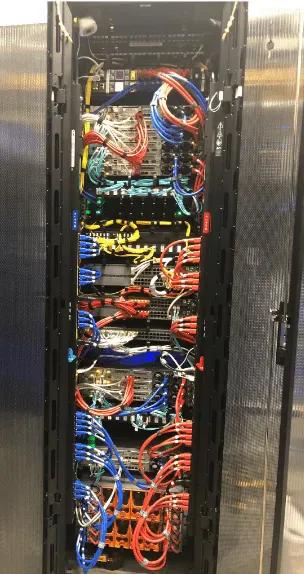
Utilizamos el mismo diseño de rack en todo el mundo, y el objetivo era mantener la coherencia y contar con la misma configuración en este nuevo PoP de Lisboa.
Así que tuvimos que ser extremadamente precisos con las instrucciones que dábamos al personal de asistencia remota de Equinix para que pudieran reproducir la configuración y solo tuvieran que «seguir la guía».
A continuación se muestra una parte del procedimiento que enviamos a Equinix para que pudieran instalar fácilmente todos los equipos en el rack y conectarlos.
Hay muchos componentes que gestionar: no solo los dispositivos de hardware (routers, switches, firewalls y servidores), sino también el cableado y, lo que es más importante, los puertos de los switches y servidores a los que conectar los cables.
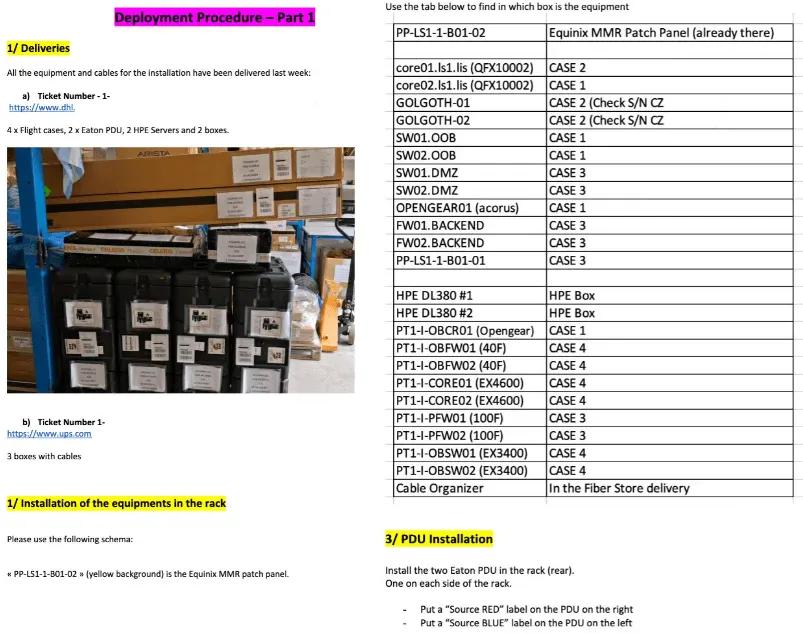
Como puede ver a continuación, el procedimiento se detalla al máximo, teniendo en cuenta que los técnicos de Equinix tienen muchas instalaciones que realizar, así que cuanto más precisos seamos, mejor.
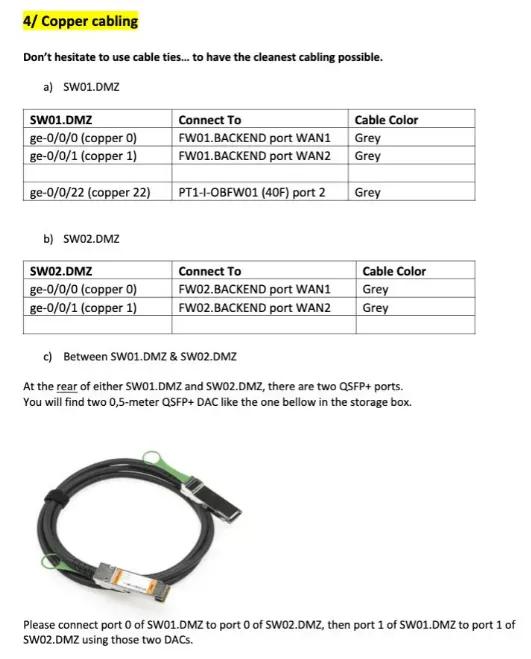
¿Ha funcionado?
¡Sí! La instalación comenzó el 5 de mayo, con todos los dispositivos montados en los racks y encendidos, y sin ningún fallo de hardware. Hemos tenido suerte, o quizá, gracias a nuestra experiencia, el envío y el embalaje se realizaron correctamente, o puede que ambas cosas; en cualquier caso, todo funcionó bien.
Al día siguiente, los técnicos de Equinix se encargaron del cableado (cobre/fibra) y, a las 23:30, ¡ya podíamos hacer ping a nuestro PoP de Lisboa desde París!
La instalación se completó el 7 de mayo, tras llevar a cabo las tareas finales, como la configuración de las PDU, la interconexión de los puertos OOB y la comprobación de extremo a extremo de los puertos IXP. Como la configuración de nuestros switches y del firewall era totalmente funcional, no tuvimos que solicitar a Equinix ningún cambio de configuración.
La instalación final tiene este aspecto:
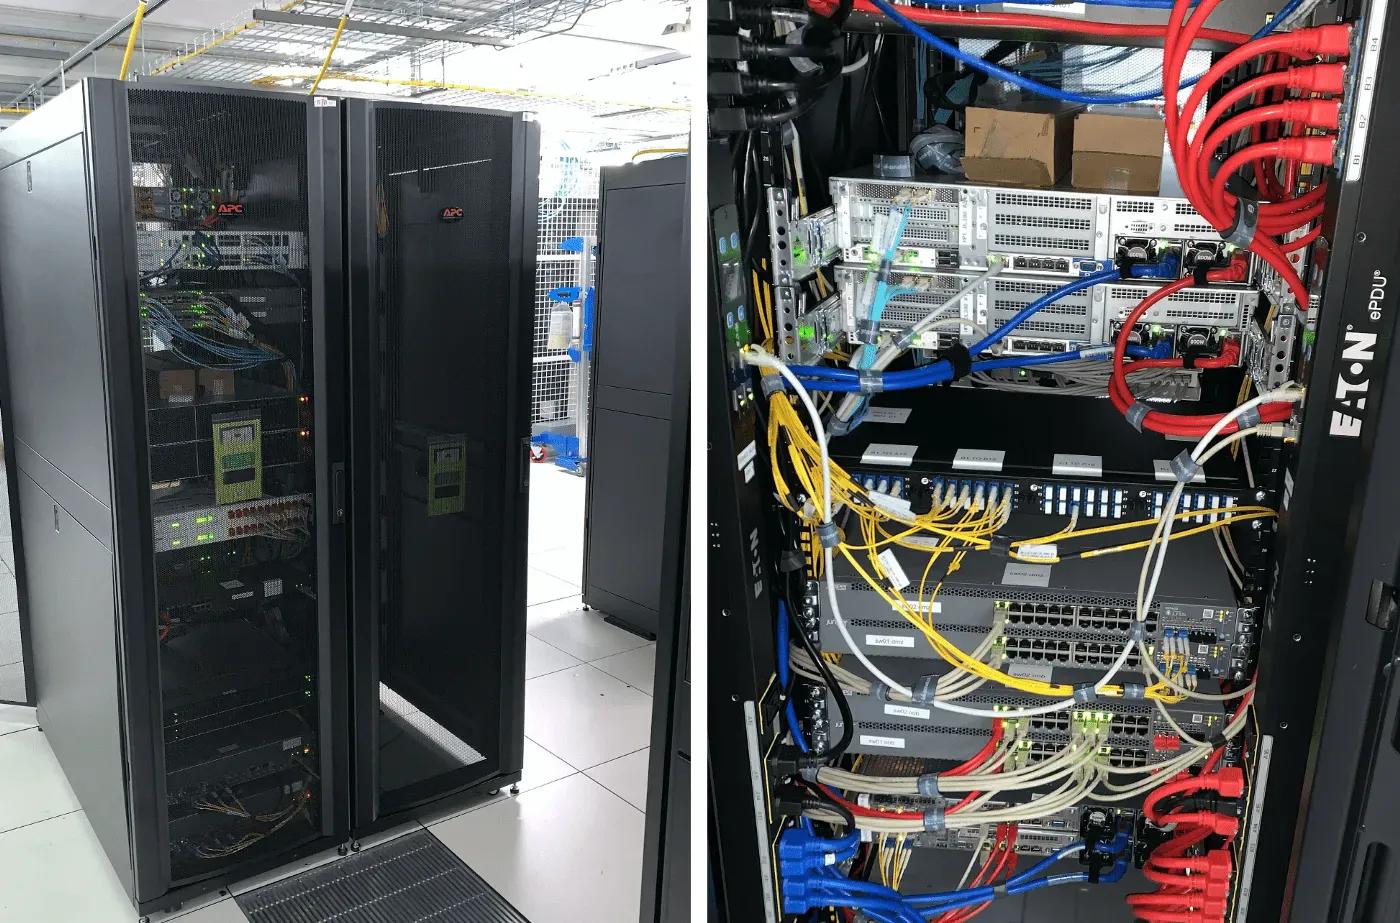
Como somos muy exigentes, no estamos satisfechos al 100 %; por ejemplo, el panel trasero del rack no está tan ordenado como nos gustaría, pero lo solucionaremos cuando la crisis se calme y podamos volver a viajar a Portugal.
«Post mortem»: qué funcionó, por qué y qué se puede mejorar
Aunque estamos enormemente felices y orgullosos de haber logrado superar el reto, nos gusta tomar perspectiva y reflexionar sobre lo que funcionó, pero, sobre todo, sobre lo que se puede mejorar.
Lo que funcionó:
- Equinix: es importante comunicar a un proveedor cuando las cosas no van bien, pero aún lo es más hacerlo cuando han ido bien e incluso han superado las expectativas, como ha ocurrido en este caso. Desde el equipo de Ventas y la Alta Dirección hasta los técnicos del centro de datos, el apoyo y la capacidad de respuesta que recibimos fueron sencillamente increíbles, especialmente durante aquellos momentos difíciles. Así que, de verdad, ¡enhorabuena a Equinix!
¿Por qué funcionó?
- Volterra ya era principalmente una empresa distribuida y orientada al trabajo remoto; en particular, nuestro equipo francés, responsable de NetOps, está repartido por toda Francia y está acostumbrado a trabajar a distancia utilizando herramientas colaborativas.
- Disponíamos de suficiente hardware de repuesto y de laboratorio, lo que nos permitió cumplir los plazos
- El procedimiento que hemos explicado brevemente más arriba es fruto de años de implementaciones y experiencia, con mejoras iterativas, y dio sus frutos.
- Mantener una buena relación con nuestros proveedores es fundamental para nosotros: una vez más, cuando algo sale mal, nos ponemos en contacto con ellos y no dudamos en decírselo, pero, por otro lado, esto les permite mejorar, no solo para nosotros, sino para todos sus clientes.
- Necesidad de rapidez/precio/calidad: hay que tener unas expectativas altas; esto implica invertir en recursos ANTES de necesitarlos.
¿Qué se puede mejorar?
- Nos dimos cuenta de que solo unas pocas personas (entre 3 y 4) de la empresa podían encargarse de un despliegue de este tipo; necesitamos encontrar una forma de escalarlo.
- Además, queremos mejorar la forma en que realizamos la preproducción para evitar tener que hacer primero una preproducción completa
- Por último, un despliegue de este tipo no es solo una cuestión técnica: los equipos de Ventas/Preventa deben saber cuánto tiempo se necesita para todo el proyecto y para cada una de sus fases, y no dar por sentado que NetOps puede resolverlo todo y, por tanto, asignarle proyectos sin evaluar adecuadamente los plazos.
Presentamos este despliegue durante la primera reunión remota de RIPE (RIPE 80). Puedes ver la grabación aquí:
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.