Mientras los clústeres de GPU y las fábricas de IA acaparan los titulares, las operaciones empresariales esenciales dependen de flujos de almacenamiento de objetos menos visibles. Los procesos de archivado y copia de seguridad de las bases de datos deben ejecutarse de forma fiable. Si estos flujos se bloquean, las aplicaciones pierden el acceso a datos críticos y los procesos de negocio se detienen de inmediato. Para los directores de sistemas de información (CIO), los cuellos de botella del almacenamiento no son meros detalles de infraestructura, sino amenazas para la continuidad del negocio. Estos flujos contribuyen al cumplimiento normativo y a la recuperación ante desastres.
El suministro de datos para la IA intensifica esta presión operativa. Los grandes modelos de lenguaje y los sistemas de generación aumentada por recuperación (RAG) requieren un acceso rápido y fiable a los datos. Por ello, el principal reto ya no es cuántos datos se pueden almacenar, sino con qué rapidez y seguridad se pueden transferir entre plataformas y modelos.
Los flujos de almacenamiento de objetos en los que nadie piensa hasta que fallan
El almacenamiento de objetos empresarial da servicio a distintas cargas de trabajo. Mientras que algunas sustentan proyectos de IA de gran visibilidad, otras mantienen las operaciones del día a día. Estos flujos operativos rara vez captan la atención de la dirección, pero determinan si es posible recuperarse de una interrupción y cumplir los objetivos de nivel de servicio.
Estos flujos de trabajo abarcan cuatro responsabilidades operativas fundamentales. Si alguno de ellos falla, las operaciones empresariales se detienen:
- Continuidad del negocio: Registros de escritura anticipada (WAL) de bases de datos y copias de seguridad. Tradicionalmente, los WAL se escribían en unidades de estado sólido (SSD) locales. Hoy en día, las bases de datos modernas en la nube pueden escribir los WAL en almacenamiento compatible con S3. En conjunto, estos flujos de trabajo permiten a los equipos restaurar los sistemas esenciales inmediatamente después de un fallo.
- Operaciones de seguridad: registros de SIEM y pruebas forenses. Los equipos de respuesta a incidentes y detección de amenazas se basan en estos datos para investigar ataques en curso.
- Cumplimiento normativo y gobernanza: Archivos normativos y repositorios inmutables. Para estas cargas de trabajo, la disponibilidad de los datos es una obligación legal estricta, no una preferencia operativa.
- Plataformas de datos empresariales: Lagos de datos y bases de conocimiento para RAG. Estos flujos de datos alimentan las aplicaciones y los motores de aprendizaje automático que impulsan tus productos.
Ninguna de estas cargas de trabajo de backend resulta especialmente atractiva. Sin embargo, son precisamente los conductos que determinan si tu empresa cumple la normativa y está preparada ante una crisis.
Los riesgos ocultos se encuentran en la ruta de los datos
Aunque tradicionalmente se ha gestionado como infraestructura de back-end, el almacenamiento de objetos moderno es, en realidad, un servicio de red activo. Tanto si se utiliza Amazon S3 como sistemas privados de almacenamiento de objetos, las aplicaciones realizan consultas al almacenamiento a través de HTTP/S mediante API REST. Esta realidad arquitectónica implica que los flujos de datos del almacenamiento de objetos heredan exactamente los mismos riesgos de rendimiento y seguridad que amenazan a las aplicaciones y los servicios web modernos.
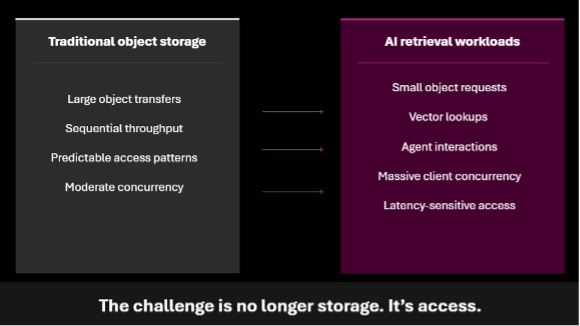
Los riesgos para la disponibilidad surgen cuando los picos de tráfico saturan las interfaces de red o fallan las controladoras de almacenamiento. Los cuellos de botella en el rendimiento son igual de perjudiciales. Los picos de latencia y la congestión de la red degradan los flujos de trabajo críticos del backend incluso cuando los discos de almacenamiento subyacentes funcionan correctamente. Por ejemplo, un retraso en el flujo de archivado de una base de datos puede detener los registros de escritura anticipada, lo que ralentiza el funcionamiento de la base de datos y provoca una interrupción repentina del servicio. El verdadero riesgo no radica en el fallo inicial, sino en hasta dónde se propaga. Sin aislamiento en la ruta de datos, un problema en un flujo de procesamiento se convierte en una interrupción que afecta a todo el sistema.
El uso de API web para acceder al almacenamiento amplía la superficie de ataque de tu empresa. Estos puntos de conexión son vulnerables a los ataques DDoS. Dado que los equipos de seguridad y los desarrolladores dependen del almacenamiento de objetos para alimentar los análisis en tiempo real y los modelos de IA, una brecha de seguridad en la capa de API de almacenamiento tiene graves consecuencias operativas.
La gestión de la capacidad bruta ya no es el principal obstáculo. El reto técnico fundamental es mantener el control sobre el movimiento de los datos entre aplicaciones y repositorios. Proteger y optimizar esta ruta de tránsito es ahora tan importante como mantener la plataforma de almacenamiento subyacente.
Aplicación del rigor de la ingeniería a los flujos de datos del almacenamiento de objetos
Modernizar la infraestructura de datos para la analítica y la IA implica dejar de tratar el almacenamiento de objetos como un repositorio pasivo. Debe gestionar la propia ruta de los datos. Del mismo modo que utiliza un controlador de entrega de aplicaciones (ADC) para proteger las aplicaciones web orientadas al usuario, necesita puntos de control equivalentes para los flujos de almacenamiento del backend que sustentan la entrega de datos para la IA. Al situar F5 BIG-IP delante de sus buckets de almacenamiento, transforma un punto de conexión de API pasivo y vulnerable en un flujo de entrega de datos seguro, acelerado y con alta disponibilidad.
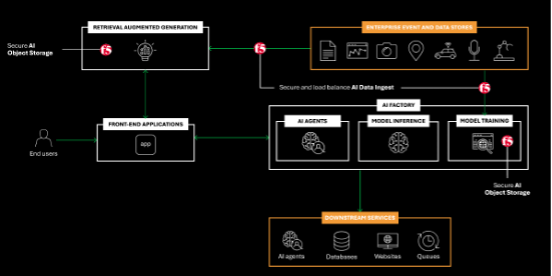
Dado que se accede al almacenamiento de objetos moderno a través de la red mediante API HTTP/S, este se comporta exactamente como una aplicación web. Esto significa que un ADC como F5 BIG-IP es la herramienta idónea para gestionarlo. Como capa de control entre las aplicaciones y los almacenes de datos, BIG-IP protege y estabiliza el movimiento de los datos.
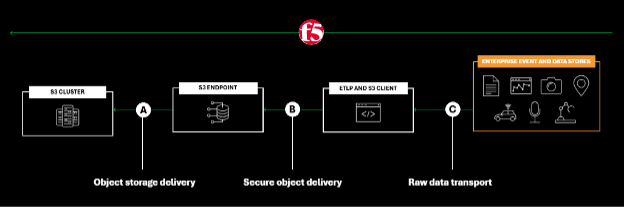
Esta arquitectura ofrece enormes ventajas operativas sin necesidad de refactorizar las aplicaciones ni rediseñar las plataformas de almacenamiento:
- Sin necesidad de reestructurar el almacenamiento: Actualizar el almacenamiento para añadir seguridad y enrutamiento es un proyecto costoso que lleva varios años. Situar BIG-IP delante del almacenamiento incorpora de inmediato funciones de enrutamiento y registro de nivel empresarial, sin necesidad de modificar el almacenamiento subyacente ni el código de las aplicaciones.
- Mayor rendimiento mediante la descarga de tareas de red: Los sistemas de almacenamiento están diseñados para leer y escribir datos, no para gestionar la sobrecarga de la red. BIG-IP asume tareas que requieren un uso intensivo del procesador, como el descifrado SSL/TLS. Al liberar a la cabina de almacenamiento de estas tareas con una elevada carga de red, la CPU del sistema de almacenamiento puede centrarse en las operaciones de E/S y reducir los tiempos de respuesta de las consultas de IA.
- Protección de seguridad activa: La seguridad tradicional del almacenamiento es pasiva y se basa en claves de acceso que no pueden detectar consultas maliciosas. BIG-IP actúa como un escudo activo e inspecciona el tráfico entrante de la API de almacenamiento mediante un cortafuegos de aplicaciones web (WAF) para bloquear las inyecciones SQL y los ataques DDoS antes de que estas amenazas lleguen a la capa de almacenamiento.
Para garantizar una alta disponibilidad, BIG-IP supervisa el estado de los puntos de conexión y redirige el tráfico para evitar los nodos fuera de servicio. También distribuye dinámicamente las consultas entre los centros de datos. Esto limita el alcance de los fallos de los componentes y mantiene unos niveles de servicio predecibles a medida que aumentan los volúmenes de datos y las exigencias de los modelos de IA.
La transferencia fiable de datos es ahora un requisito empresarial
Al situar una capa de control basada en un ADC entre las aplicaciones y el almacenamiento, se establece una ruta de datos resiliente y controlable. Esta decisión arquitectónica aplica a los flujos de datos del almacenamiento de objetos la misma disciplina de ingeniería rigurosa que ya se utiliza en las principales aplicaciones y API orientadas al cliente.
Los flujos de datos empresariales más críticos suelen ser los menos visibles. Tanto si gestionas la recuperación ante desastres como si velas por el cumplimiento normativo, la estabilidad operativa depende por completo de la fiabilidad con la que los datos circulan por tu red.
A medida que aumentan las exigencias de rendimiento, ya no se puede evaluar el almacenamiento de objetos únicamente por su capacidad y escalabilidad. Para los responsables empresariales, el objetivo no es solo almacenar más datos, sino también garantizar que los datos que sustentan las operaciones críticas y las iniciativas de IA estén siempre disponibles y protegidos. Almacenar datos es solo el primer paso; es necesario diseñar activamente la propia ruta de los datos para garantizar su resiliencia, control y contención.
La apuesta de F5 por la IA no termina aquí: descubre cómo F5 protege y distribuye aplicaciones de IA en cualquier entorno.
Sobre el autor
Artículos relacionados del blog
El imperativo empresarial de la IA en un mundo de nube híbrida y multinube
Cómo la IA redefine los patrones de tráfico, el riesgo de las API y el cumplimiento normativo, y por qué el paquete Distributed Cloud Services Enterprise ofrece la profundidad necesaria en entornos híbridos multicloud.
STIG de F5 NGINX: un plan de seguridad para el sector público y los entornos regulados
Descubra cómo las STIG de F5 NGINX proporcionan un modelo de seguridad para el Departamento de Defensa de EE. UU. y los entornos regulados, ayudándole a cumplir la normativa mientras crea una infraestructura sólida de confianza cero con mayor visibilidad y resiliencia.

Cómo el marco AEGIS de Forrester valida un enfoque centrado en la inferencia
El auge de la IA agéntica está transformando el panorama de la seguridad empresarial. Estos agentes de IA autodirigidos funcionan de forma autónoma, toman decisiones en tiempo real y pueden interactuar entre distintos sistemas de maneras para las que las arquitecturas tradicionales de ciberseguridad no fueron diseñadas. Aunque esto abre nuevas posibilidades, también introduce riesgos sistémicos: fallos en cascada, secuestro de objetivos y superficies de ataque hasta ahora invisibles. El reciente […] de Forrester
La nueva superficie de riesgo de la IA: invisible, autónoma y ya está dentro
James White, vicepresidente de Ingeniería de F5 A mediados de 2025, es un buen momento para hacer balance de la adopción de la IA en las empresas y del estado de la seguridad de la IA. El uso de la IA generativa ya es habitual en las empresas En general, las empresas cuentan al menos con unos conocimientos básicos sobre la IA generativa. Entienden qué es y dónde puede […]
Protegiendo el futuro: cómo CalypsoAI se alinea con el Top 10 de OWASP para los LLM
Cuando OWASP publicó su Top 10 de 2025 para grandes modelos de lenguaje (LLM), proporcionó al sector un referente de seguridad muy necesario. Pero los referentes no sirven de nada si no se actúa. CalypsoAI aborda el 80 % del Top 10 de OWASP, dando prioridad a los riesgos reales más urgentes. La plataforma combina protección en tiempo real durante la ejecución y pruebas adversariales exhaustivas, ofreciendo una cobertura inigualable frente a las […]
Implementación de LLM en la empresa: mediante una API local
Por sí solos, sin medidas de protección ni protocolos adicionales de seguridad para la IA, el despliegue de modelos de IA generativa —en particular, modelos de lenguaje de gran tamaño (LLM)— en toda la empresa supone una oportunidad de alto riesgo y grandes beneficios para cualquier organización. Sin embargo, determinar exactamente cómo debe dar su organización este gran paso hacia el ámbito de la IA generativa requiere una planificación minuciosa. Quizá […]