
En Volterra, el trabajo del equipo de SRE consiste en operar una plataforma perimetral global basada en SaaS. Tenemos que resolver diversos retos relacionados con la gestión de un gran número de clústeres de aplicaciones en distintos estados (es decir, en línea, sin conexión, deshabilitados por el administrador, etc.), y para ello aprovechamos el ecosistema y las herramientas de Kubernetes con un modelo declarativo basado en extracción mediante GitOps.
En este blog, describiremos:
Uso de GitOps para gestionar y supervisar eficazmente una gran flota de infraestructura (hosts físicos o en la nube) y clústeres de K8s
- Las herramientas que desarrollamos para resolver problemas relacionados con la CI/CD
- Orquestación de objetos y gestión de la configuración
- Observabilidad en todo el conjunto de clústeres de infraestructura y K8s
Profundizaremos en las lecciones aprendidas a gran escala (3000 ubicaciones en el extremo de la red), que también abordé en mi reciente charla en Cloud Native Rejekts, en San Diego.
TL;DR (Resumen)
- No pudimos encontrar una solución sencilla y lista para usar que permitiera desplegar y operar miles (y potencialmente millones) de clústeres de aplicaciones e infraestructura en ubicaciones de nube pública, locales o nómadas
- Esta solución debía proporcionar la gestión del ciclo de vida de los hosts (físicos o en la nube), el plano de control de Kubernetes y las cargas de trabajo de las aplicaciones, así como la configuración continua de diversos servicios. Además, debía cumplir nuestros requisitos de diseño de SRE: definición declarativa, ciclo de vida inmutable, GitOps y ausencia de acceso directo a los clústeres.
- Tras evaluar varios proyectos de código abierto —por ejemplo, Kubespray+Ansible (para el despliegue de Kubernetes) o Helm/Spinnaker (para la gestión de cargas de trabajo)—, llegamos a la conclusión de que ninguna de estas soluciones podía satisfacer los requisitos anteriores sin añadir una cantidad considerable de software innecesario en cada ubicación periférica. Por ello, decidimos desarrollar nuestro propio demonio de software basado en Golang, encargado de gestionar el ciclo de vida del host (físico o en la nube), el plano de control de Kubernetes y las cargas de trabajo de las aplicaciones.
- A medida que escalamos el sistema hasta alcanzar los 3000 clústeres y superar esa cifra (dentro de un único tenant), todas nuestras suposiciones sobre nuestros proveedores de nube pública, la escalabilidad de nuestros daemons de software, las herramientas de operaciones y la infraestructura de observabilidad fueron fallando sistemáticamente. Para superar estos retos, fue necesario rediseñar la arquitectura de algunos de nuestros componentes de software en cada uno de estos ámbitos.
Definición del edge
- Customer Edge (CE) — Se trata de ubicaciones de clientes en la nube (como AWS, Azure, GCP o una nube privada), ubicaciones locales (como plantas de producción, instalaciones de petróleo y gas, etc.) o ubicaciones móviles (como vehículos, sistemas robóticos, etc.). El equipo de SRE de Volterra gestiona CE, aunque los clientes también pueden implementarlo bajo demanda en las ubicaciones que elijan.
- Extremos regionales (RE) — Son puntos de presencia (PoP) de Volterra ubicados en instalaciones de coubicación de las principales áreas metropolitanas e interconectados mediante nuestra propia red troncal privada de alta densidad. Estos sitios de extremo regional también se utilizan para interconectar de forma segura ubicaciones de extremo del cliente (CE) y/o exponer servicios de aplicaciones a la Internet pública. Los sitios RE son propiedad del equipo de operaciones de infraestructura de Volterra (Infra SRE), que se encarga íntegramente de su gestión.
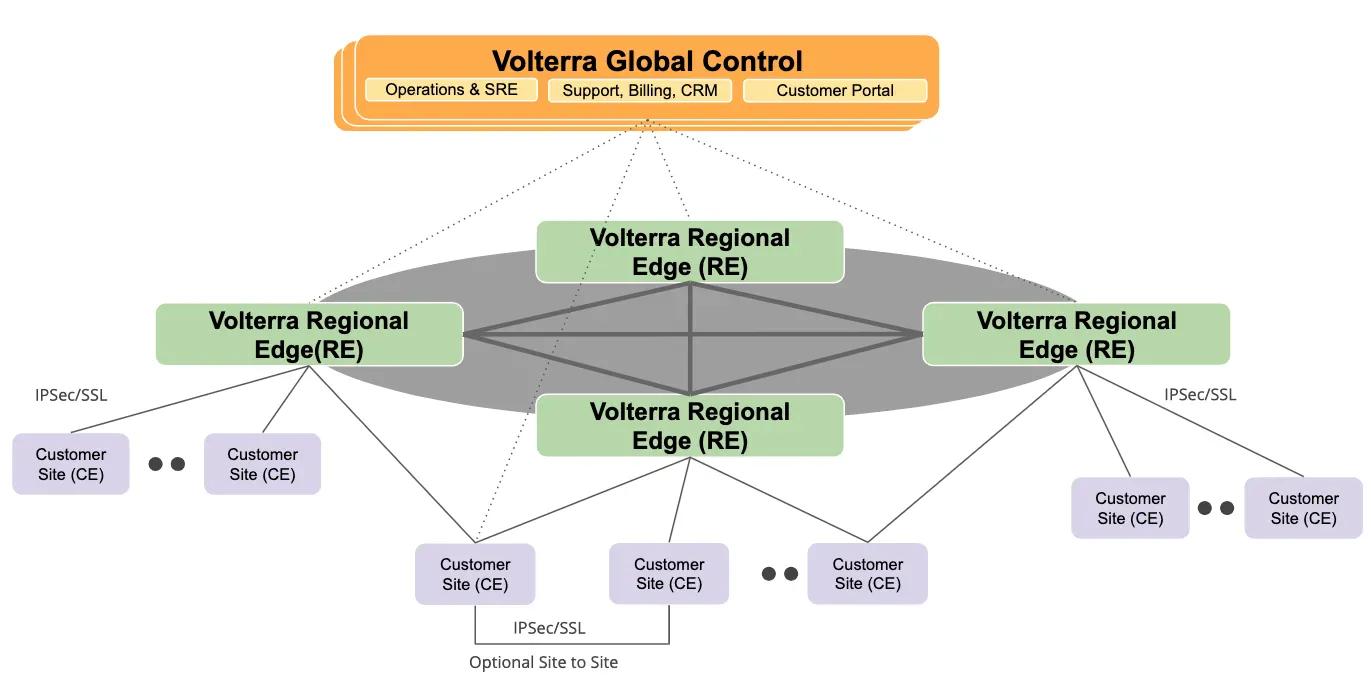
El diagrama de arquitectura anterior (Figura 1) muestra la conectividad lógica entre nuestros RE y CE, donde cada CE establece conexiones redundantes (VPN IPSec o SSL) con el RE más cercano.
Requisitos para la gestión del perímetro
Cuando empezamos a diseñar nuestra plataforma hace unos dos años, nuestro equipo de producto nos pidió que abordáramos los siguientes retos:
- Escalabilidad del sistema — nuestros clientes necesitaban que pudiéramos dar soporte a miles (y, con el tiempo, millones) de ubicaciones periféricas, algo muy distinto de gestionar unos pocos clústeres de Kubernetes en regiones de la nube. Por ejemplo, uno de nuestros clientes tiene unas 17 000 tiendas de conveniencia y otro gestiona más de 20 000 estaciones de carga. Esta escala implicaba que debíamos desarrollar nuestras herramientas de una forma muy distinta a la utilizada para gestionar unos pocos clústeres.
- Implementación sin intervención — ya que cualquiera debería poder desplegar un nuevo sitio sin necesidad de tener grandes conocimientos sobre el hardware, el software o Kubernetes. El sitio perimetral debía funcionar como una caja negra que se enciende, se conecta con la central y se pone en línea.
- Gestión de flotas — gestión simplificada de miles de sitios y cargas de trabajo sin necesidad de tratarlos individualmente. Cualquier sitio puede desconectarse o dejar de estar disponible cuando se solicita un cambio o una actualización. Por ello, los sitios deben obtener las actualizaciones cuando vuelven a conectarse.
- Tolerancia a fallos — las ubicaciones periféricas deben seguir operativas incluso si falla alguno de sus componentes. Todo debe poder gestionarse de forma remota y ofrecer funciones como el restablecimiento de fábrica o la reconstrucción de la ubicación en caso de fallo. Tuvimos que asumir que no habría acceso físico a la ubicación.
Principios de diseño (¡sin Kubectl, sin Ansible y sin paquetes!)
Teniendo en cuenta nuestros requisitos y los retos que plantea operar un sistema altamente distribuido, decidimos establecer varios principios que nuestro equipo de SRE debía seguir para reducir los problemas posteriores:
- Definición declarativa — todo el sistema debe describirse de forma declarativa, ya que esto nos permite crear un modelo de abstracción sencillo y realizar validaciones con respecto a dicho modelo.
- Gestión inmutable del ciclo de vida — en el pasado, trabajábamos en grandes instalaciones de nube privada utilizando herramientas de gestión del ciclo de vida mutables, como Ansible, Salt o Puppet. Esta vez, queríamos mantener el sistema operativo base muy sencillo e intentar distribuirlo todo como contenedores, sin gestión de paquetes ni necesidad de herramientas de gestión de la configuración.
- GitOps — proporciona un modelo operativo estándar para gestionar clústeres de Kubernetes. También nos permite disponer de forma inmediata de aprobaciones, auditorías y flujos de trabajo para los cambios, sin tener que crear un sistema adicional de gestión de flujos de trabajo. Por ello, decidimos que todo debía pasar por git.
- Sin kubectl — Este fue uno de los principios más importantes, ya que nadie tiene permitido acceder directamente a los clústeres de aplicaciones. Por ello, eliminamos la posibilidad de ejecutar kubectl dentro de clústeres perimetrales individuales o de utilizar scripts ejecutados desde ubicaciones centrales, incluidos los sistemas de CD centralizados. Los sistemas de CD centralizados con un método push son adecuados para decenas de clústeres, pero desde luego no para miles si no se garantiza una disponibilidad de red del 100 %.
- Nada de tecnologías (ni herramientas) de moda — nuestra experiencia previa ha demostrado que muchas de las herramientas populares de código abierto no están a la altura de las expectativas. Aunque evaluamos varios proyectos de la comunidad para desplegar infraestructura, K8s y cargas de trabajo de aplicaciones (como Helm, Spinnaker y Terraform), finalmente solo utilizamos Terraform para la parte de la infraestructura virtual y desarrollamos código personalizado que describiremos en las siguientes entregas de este blog.
Gestión del ciclo de vida del sitio
Como parte de la gestión del ciclo de vida de los sitios en el edge, tuvimos que resolver cómo aprovisionar el sistema operativo del host, realizar configuraciones básicas (por ejemplo, gestión de usuarios, autoridad de certificación, páginas de memoria de gran tamaño, etc.), poner en marcha K8s, desplegar cargas de trabajo y gestionar los cambios continuos de configuración.
Una de las opciones que consideramos, pero que finalmente descartamos, fue utilizar KubeSpray+Ansible (para gestionar el sistema operativo e implementar K8s) y Helm/Spinnaker (para implementar las cargas de trabajo). La descartamos porque nos habría obligado a gestionar entre dos y tres herramientas de código abierto y, posteriormente, a realizar modificaciones importantes para satisfacer nuestros requisitos, que seguían aumentando a medida que añadíamos más funcionalidades, como el escalado automático de los clústeres del edge, la compatibilidad con módulos TPM seguros, las actualizaciones diferenciales, etc.
Dado que nuestro objetivo era mantener la sencillez y reducir al mínimo el número de componentes que se ejecutan directamente en el sistema operativo (fuera de Kubernetes), decidimos desarrollar un daemon ligero en Golang llamado Volterra Platform Manager (VPM). Es el único contenedor Docker gestionado por systemd en el sistema operativo y actúa como una navaja suiza que desempeña numerosas funciones:
Ciclo de vida del host
VPM se encarga de gestionar el ciclo de vida del sistema operativo del host, incluidas la instalación, las actualizaciones, los parches, la configuración, etc. Hay muchos aspectos que deben configurarse (por ejemplo, la asignación de páginas de memoria de gran tamaño, /etc/hosts, etc.).
- Gestión de actualizaciones del sistema operativo — por desgracia, el edge no se limita a Kubernetes, y tenemos que gestionar la versión del kernel y del sistema operativo en general. Nuestro edge se basa en CoreOS (o CentOS, según las necesidades del cliente) y cuenta con una partición activa y otra pasiva. Cuando se programa una actualización, esta siempre se descarga en la partición pasiva. El último paso de la actualización consiste en reiniciar el sistema, momento en el que se intercambian las particiones activa y pasiva. El único aspecto delicado es la estrategia de reinicio (en clústeres de varios nodos), ya que no se pueden reiniciar todos los nodos al mismo tiempo. Implementamos nuestro propio bloqueo de reinicio de etcd (en VPM), que permite reiniciar uno a uno los nodos de un clúster.
- Gestión del acceso de los usuarios al sistema operativo — necesitamos restringir los usuarios y su acceso remoto mediante ssh y a la consola. VPM se encarga de todas estas operaciones, como la rotación de las CA de ssh.
- Dado que hemos desarrollado nuestra propia ruta de datos L3-L7, debemos configurar páginas enormes de 2 MB o 1 GB en el sistema operativo del host en función del tipo de hardware (o máquina virtual en la nube)
Ciclo de vida de Kubernetes
Gestión del ciclo de vida de los manifiestos de Kubernetes. En lugar de utilizar Helm, decidimos usar la biblioteca client-go de K8s, que integramos en VPM y de la que utilizamos varias funcionalidades:
- Despliegue optimista frente a pesimista — esta función nos permite clasificar las aplicaciones en las que debemos esperar hasta que estén en buen estado. Simplemente comprueba si el manifiesto de K8s contiene la anotación ves.io/deploy: optimistic.Optimista = crea el recurso y no espera a conocer su estado. Es muy similar al comando kubernetes apply con el que no se sabe si los pods llegan a iniciarse correctamente. Pesimista = espera a conocer el estado del recurso de Kubernetes. Por ejemplo, en un despliegue espera hasta que todos los pods estén listos. Es similar al nuevo comando kubectl wait.
- Acciones previas a la actualización, como la descarga anticipada — a veces no es posible confiar en las actualizaciones graduales de K8s, especialmente cuando se distribuye el plano de datos de red. Esto se debe a que el pod antiguo se destruye antes de descargar el nuevo. Sin embargo, en el caso del plano de datos, se pierde la conectividad de red. Por tanto, no se puede descargar la nueva imagen del contenedor y el pod nunca llega a iniciarse. La anotación de metadatos ves.io/prepull, junto con una lista de imágenes, activa la descarga antes de aplicar el manifiesto de K8s.
- Reintentos y reversiones en caso de que se produzcan errores durante la aplicación. Esta situación es muy habitual cuando un servidor de API de K8s sufre interrupciones intermitentes.
Configuración continua
Además de las configuraciones relacionadas con los manifiestos de K8s, también debemos configurar varios servicios de Volterra a través de sus API. Un ejemplo son las configuraciones de VPN IPsec/SSL: VPM recibe la configuración de nuestro plano de control global y la aplica en cada nodo.
Restablecimiento de fábrica
Esta función nos permite restablecer de forma remota un equipo a su estado original y repetir todo el proceso de instalación y registro. Es una función esencial para recuperar un sitio sin necesidad de acceder físicamente ni mediante la consola.
Aunque la gestión del ciclo de vida de K8s pueda parecer un tema de debate importante para muchas personas, para nuestro equipo probablemente solo represente entre el 40 % y el 50 % del volumen total de trabajo.
Aprovisionamiento sin intervención
El aprovisionamiento sin intervención del sitio perimetral en cualquier ubicación (en la nube, en las instalaciones o en un entorno perimetral nómada) es una funcionalidad esencial, ya que no podemos esperar tener acceso a cada uno de los sitios ni queremos contar con tantos expertos en Kubernetes para instalar y gestionar cada sitio. Sencillamente, no es escalable a miles de sitios.
El siguiente diagrama (Figura 2) muestra cómo interviene VPM en el proceso de registro de un nuevo sitio:
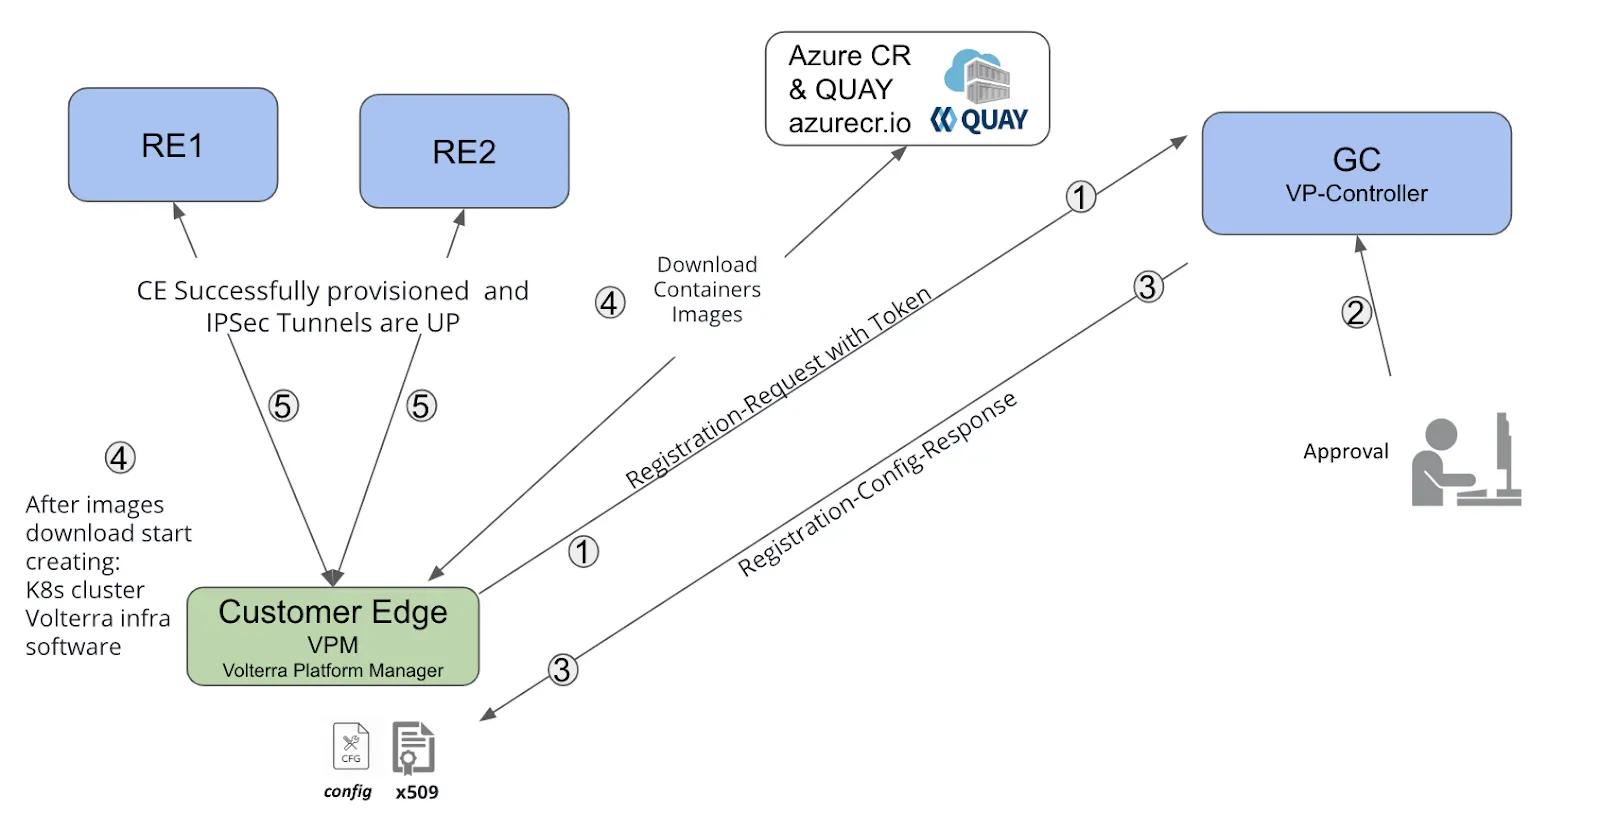
- Una vez encendido, el VPM que se ejecuta en el CE (representado por el recuadro verde) presentará un token de registro a nuestro plano de control global (GC) para crear un nuevo registro. El token de registro se proporciona como parte de cloud-init de la máquina virtual en la nube y puede ser una clave introducida por una persona durante el proceso de arranque o programada en el TPM en el caso del hardware perimetral.
- GC recibe la solicitud con el token, lo que le permite crear un nuevo registro para un tenant (codificado en el token). El operador del cliente puede ver inmediatamente el nuevo sitio perimetral en el mapa y aprobarlo, además de introducir un nombre y otros parámetros de configuración.
- VP-Controller dentro de GC genera la configuración (p. ej., decide qué nodo es el maestro de K8s, cuál es un nodo subordinado, etc.) y los certificados para etcd, K8s y VPM.
- VPM comienza a preparar el sitio, lo que incluye descargar imágenes de Docker, configurar páginas de memoria de gran tamaño, instalar el clúster de K8s e iniciar los servicios del plano de control de Volterra.
- VPM configura túneles redundantes (VPN IPSec/SSL) hacia los dos sitios de borde regional más cercanos, que se utilizarán para el tráfico de datos y la interconectividad entre sitios y a través de la red pública.
Como puede ver, todo el proceso está completamente automatizado y el usuario no necesita conocer los detalles de la configuración ni realizar ningún paso manual. El dispositivo tarda unos 5 minutos en estar totalmente operativo y listo para atender las aplicaciones y solicitudes de los clientes.
Actualizaciones del software de infraestructura
Las actualizaciones son uno de los aspectos más complejos que hemos tenido que resolver. Veamos qué se actualiza en las ubicaciones perimetrales:
- Actualizaciones del sistema operativo — esto abarca el kernel y todos los paquetes del sistema. Cualquiera que haya administrado una distribución estándar de Linux conoce las dificultades que entraña actualizar entre versiones menores (por ejemplo, pasar de Ubuntu 16.04.x a 16.04.y) y las dificultades mucho mayores que supone actualizar entre versiones principales (por ejemplo, pasar de Ubuntu 16.04 a 18.04). Cuando se trata de miles de ubicaciones, las actualizaciones deben ser deterministas y no pueden comportarse de forma distinta en cada una de ellas. Por ello, elegimos CoreOS y CentOS Atomic, que permiten realizar actualizaciones A/B con dos particiones y un sistema de archivos de solo lectura en las rutas. Esto nos permite revertir inmediatamente una actualización cambiando el orden de arranque de las particiones y mantener la coherencia del sistema operativo sin tener que gestionar sus paquetes. Sin embargo, ya no podemos actualizar componentes individuales del sistema, como el servidor openssh, simplemente instalando un paquete nuevo. Los cambios en componentes individuales deben publicarse como una nueva versión inmutable del sistema operativo.
- Actualizaciones de software — esto abarca VPM, etcd, Kubernetes y los servicios de control de Volterra que se ejecutan como cargas de trabajo de K8s. Como ya he mencionado, nuestro objetivo es que todo lo que haya dentro de K8s se ejecute como un contenedor de systemd. Por suerte, pudimos convertirlo todo en cargas de trabajo de K8s, excepto tres servicios: VPM, etcd y kubelet.
Existen dos métodos conocidos que podrían utilizarse para distribuir actualizaciones a los sitios periféricos:
- Basado en inserción — un método de inserción suele llevarse a cabo mediante una herramienta centralizada de CD (entrega continua), como Spinnaker, Jenkins o una herramienta de gestión de la configuración basada en Ansible. En este caso, la herramienta central debe tener acceso al sitio o clúster de destino y estar disponible para realizar la acción.
- Basado en extracción — un método basado en extracción obtiene la información de actualización de forma independiente, sin ningún mecanismo de entrega centralizado. Ofrece una mayor escalabilidad y, además, elimina la necesidad de almacenar en un único lugar las credenciales de todos los sitios.
Nuestro objetivo con las actualizaciones era maximizar la sencillez y la fiabilidad, de forma similar a las actualizaciones habituales de los teléfonos móviles. Además, la estrategia de actualización debía tener en cuenta otros aspectos: puede que la actualización solo pueda llevarla a cabo el operador del sitio, o que el dispositivo permanezca sin conexión o no esté disponible durante algún tiempo debido a problemas de conectividad, entre otros. Estos requisitos podían satisfacerse más fácilmente con el método de descarga y, por ello, decidimos adoptarlo para cubrir nuestras necesidades.
GitOps
Además, elegimos GitOps porque facilitaba proporcionar a nuestro equipo de SRE un modelo operativo estándar para gestionar los clústeres de Kubernetes, los flujos de trabajo y la auditoría de cambios.
Para resolver los problemas de escalabilidad de miles de sitios, diseñamos la arquitectura de SRE que se muestra en la Figura 3:
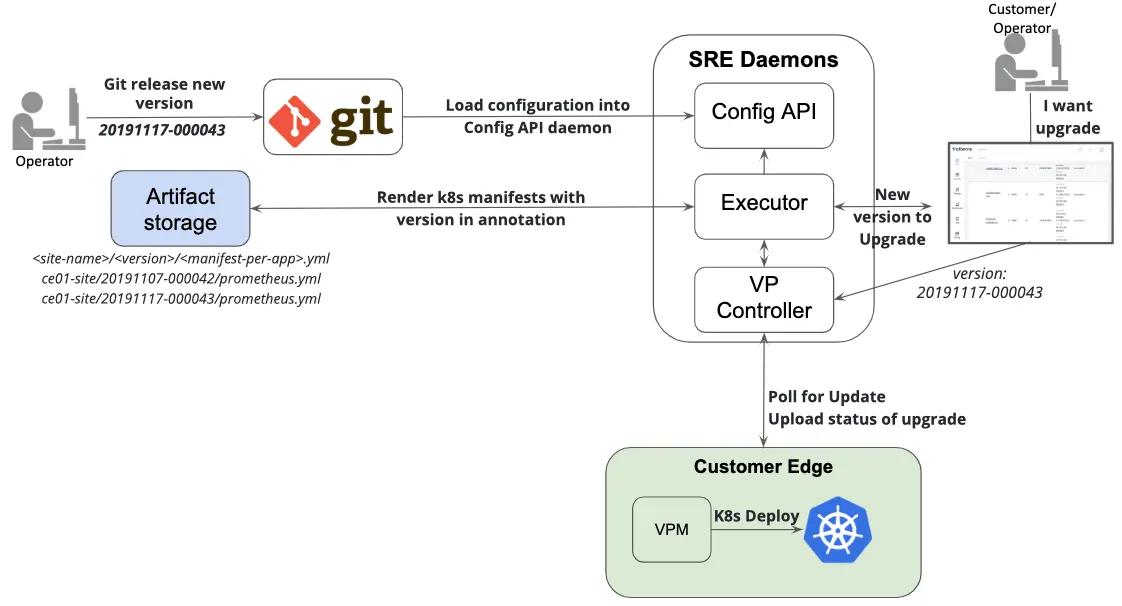
En primer lugar, quiero destacar que no utilizamos Git únicamente para almacenar el estado o los manifiestos. Esto se debe a que nuestra plataforma no solo tiene que gestionar los manifiestos de K8s, sino también las configuraciones activas de la API, las versiones de K8s, etc. En nuestro caso, los manifiestos de K8s representan aproximadamente el 60 % de toda la configuración declarativa. Por este motivo, tuvimos que crear nuestra propia abstracción DSL sobre ella, que se almacena en git. Además, como git no proporciona una API ni ninguna función para combinar parámetros, tuvimos que desarrollar daemons adicionales en Golang para SRE: Config API, Executor y VP Controller.
Veamos el flujo de trabajo para lanzar una nueva versión de software en el entorno perimetral del cliente mediante nuestra plataforma SaaS:
- El operador decide publicar una nueva versión y abre una solicitud de fusión (MR) en el modelo de Git
- Una vez que esta MR se aprueba y se fusiona, CI activa la acción para cargar una configuración del modelo de git en nuestro daemon SRE Config-API. Este daemon dispone de varias API para la fusión de parámetros, la configuración del DNS interno, etc.
- El daemon Executor supervisa Config-API; en cuanto se cargan los cambios de git, comienza a generar los manifiestos finales de K8s con la versión indicada en una anotación. A continuación, estos manifiestos se suben al almacenamiento de artefactos (similar a S3) en la ruta ce01-site//.yml
- Una vez que la nueva versión se ha generado y subido al almacenamiento de artefactos, Executor envía a la API del cliente un nuevo estado que indica que hay una versión disponible; es muy similar al aviso de nueva versión disponible en los teléfonos móviles
- El cliente (o el operador) puede programar la actualización de su sitio a la versión más reciente, y esta información se transmite a VP-Controller. VP-Controller es el daemon responsable de la gestión del sitio, incluidas su provisión, retirada o migración a otra ubicación. Esto ya se explicó parcialmente en el aprovisionamiento sin intervención y es el responsable de actualizar los sitios perimetrales mediante la API mTLS
- El último paso del diagrama tiene lugar en el sitio perimetral: una vez establecida la conexión VPN IPSec/SSL, VP-Controller notifica al VPM del sitio perimetral que debe descargar las actualizaciones de la nueva versión. Sin embargo, si se interrumpe la conectividad o se producen problemas intermitentes, el VPM comprueba si hay actualizaciones cada 5 minutos.
- Los nuevos manifiestos y configuraciones de K8s se obtienen y se despliegan en K8s. Mediante la función de despliegue pesimista descrita en la sección anterior, VPM espera hasta que todos los pods estén listos
- Como último paso, VPM envía el estado de la actualización a VP Controller, que a su vez lo remite como estado a la API del cliente.
Puedes ver una demostración de todo el flujo de trabajo aquí:
Lecciones aprendidas tras realizar pruebas en 3000 sitios edge
En las secciones anteriores, describimos cómo se utilizan nuestras herramientas para desplegar y gestionar el ciclo de vida de los sitios perimetrales. Para validar nuestro diseño, decidimos crear un entorno a gran escala con tres mil sitios perimetrales de clientes (como se muestra en la Figura 4).
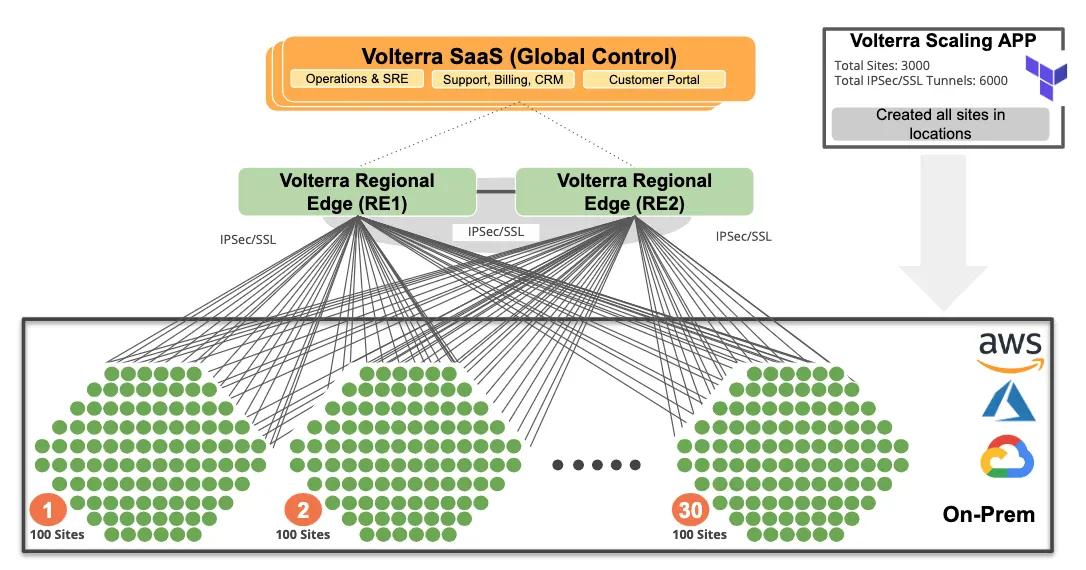
Utilizamos Terraform para aprovisionar 3000 máquinas virtuales en AWS, Azure, Google y nuestra propia nube local de servidores físicos, con el fin de simular el funcionamiento a gran escala. Todas esas máquinas virtuales eran CE independientes (sedes perimetrales de clientes) que establecían túneles redundantes con nuestras sedes perimetrales regionales (también conocidas como PoP).
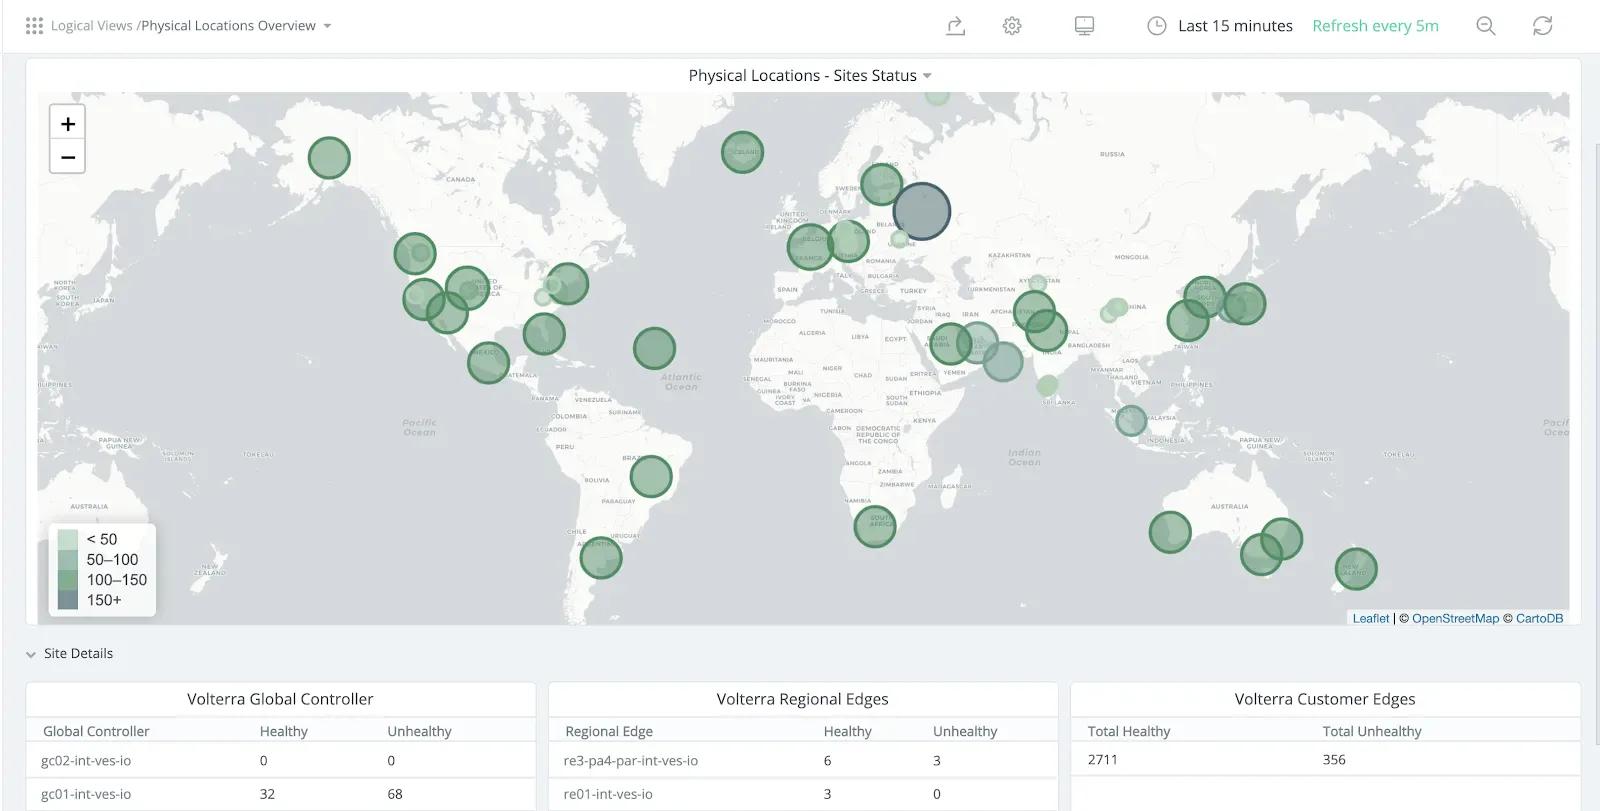
La siguiente captura de pantalla corresponde a nuestro panel de SRE y muestra el número de sitios de borde en cada ubicación, representado por el tamaño del círculo. En el momento de realizar la captura, teníamos unos 2711 sitios de borde operativos y 356 con problemas.
Conclusiones principales: Operaciones
Como parte del proceso de escalado, detectamos algunos problemas de configuración y funcionamiento que nos obligaron a modificar nuestros daemons de software. Además, tuvimos numerosos problemas con un proveedor de servicios en la nube que nos llevaron a abrir varios tickets de soporte; por ejemplo, la latencia de respuesta de la API, la imposibilidad de obtener más de 500 máquinas virtuales en una sola región, etc.
- Optimizar VP-Controller — al principio, procesábamos los registros de forma secuencial y cada uno tardaba unos dos minutos, ya que teníamos que generar varios certificados para etcd, kubernetes y VPM. Redujimos este tiempo mediante claves pregeneradas con mayor entropía y la paralelización con un mayor número de procesos. Esto nos permitió procesar el registro de 100 sitios en menos de 20 segundos. Pudimos dar servicio a los 3000 sitios periféricos consumiendo apenas una vCPU y 2 GB de RAM en nuestro VP-Controller.
- Optimizar la distribución de imágenes de Docker — cuando empezamos a escalar, nos dimos cuenta de que el volumen de datos transmitidos a los sitios periféricos era enorme. Cada sitio descargaba unos 600 MB (multiplicados por 3000), lo que suponía un total de 1,8 TB de datos transmitidos. Además, durante las pruebas reconstruimos los sitios periféricos varias veces, por lo que esa cifra sería en realidad mucho mayor. Por ello, tuvimos que optimizar el tamaño de nuestras imágenes de Docker y crear imágenes para la nube e imágenes ISO con las imágenes de Docker ya descargadas para reducir las descargas. Aunque seguimos utilizando un servicio público de registro de contenedores en la nube, estamos trabajando activamente en un diseño para distribuir nuestro registro de contenedores a través de los RE (PoP) y realizar actualizaciones incrementales (mediante diferencias binarias).
- Optimizar las operaciones de la base de datos de control global — todos nuestros servicios de control de Volterra se basan en el framework de servicios de Golang, que utiliza ETCD como base de datos. Cada sitio se representa como un objeto de configuración. Cada objeto de configuración de sitio tiene varios StatusObjects, como software-upgrade, hardware-info o ipsec-status. Estos StatusObjects los generan diversos componentes de la plataforma y todos ellos están referenciados en una API de configuración global. Cuando alcanzamos los 3000 sitios, tuvimos que realizar ciertas optimizaciones en nuestro esquema de objetos. Por ejemplo, limitar el número de tipos de StatusObjects aceptados por la API de configuración global o trasladarlos a una instancia de ETCD específica para reducir el riesgo de sobrecargar la base de datos de objetos de configuración. Esto nos permite ofrecer una mayor disponibilidad y un mejor tiempo de respuesta de la base de datos de configuración, además de reconstruir la base de datos de estados en caso de fallo. Otro ejemplo de optimización fue dejar de realizar operaciones innecesarias de listado de objetos de sitio en todos los tenants o introducir índices secundarios para reducir la carga de la base de datos.
Conclusiones clave: observabilidad
La observabilidad en un sistema distribuido planteó un conjunto de retos mucho mayor a medida que escalábamos el sistema.
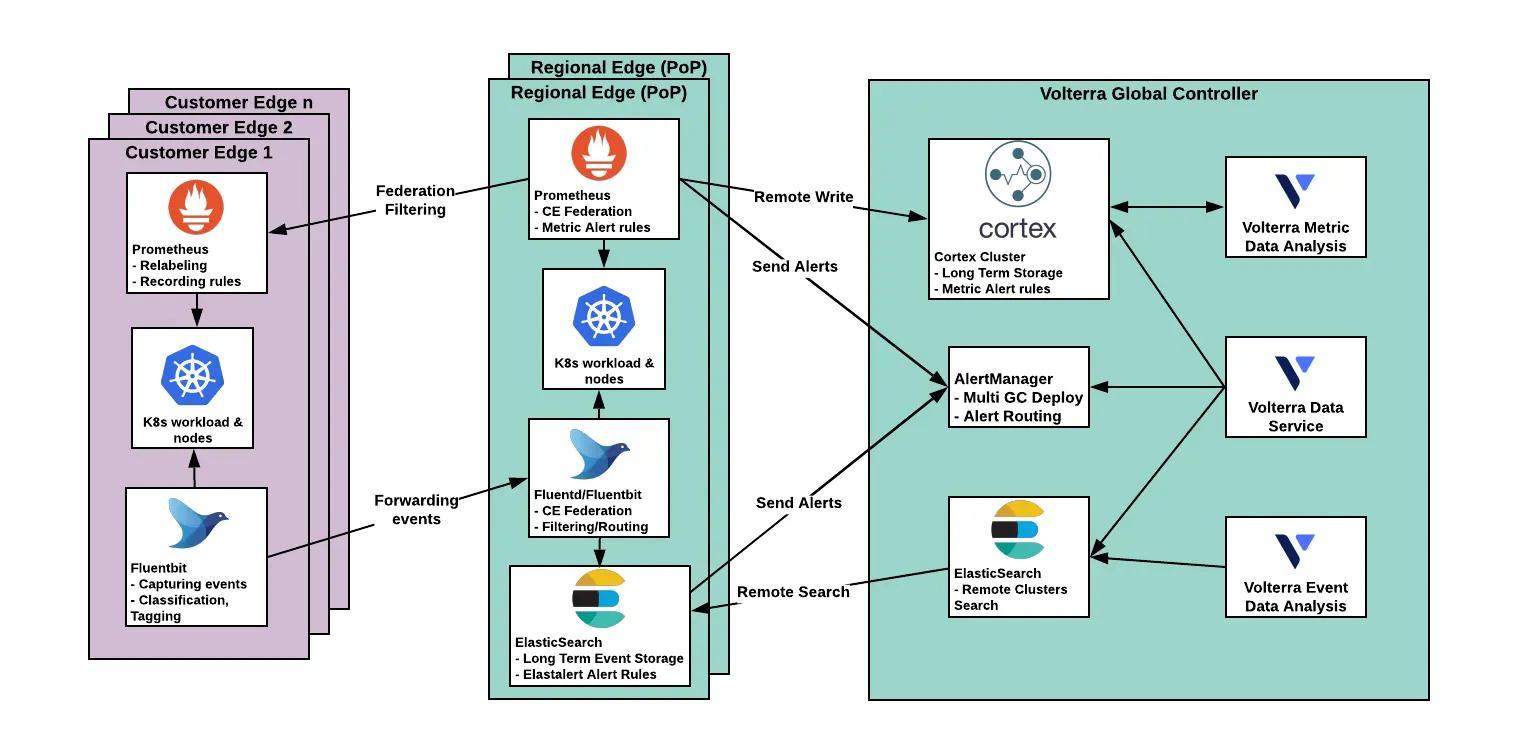
Al principio, para las métricas empezamos utilizando la federación de Prometheus: un Prometheus central en el control global federaba las instancias de Prometheus de los extremos regionales (RE), que recopilaban las métricas de sus servicios y federaban las métricas de los CE conectados a ellos. El Prometheus de nivel superior evaluaba las alertas y servía como fuente de métricas para análisis posteriores. Alcanzamos rápidamente los límites de este enfoque (en torno a 1000 CE) e intentamos minimizar el impacto del creciente número de CE. Empezamos a generar series precalculadas para histogramas y otras métricas de alta cardinalidad. Esto nos dio un margen de uno o dos días, tras lo cual tuvimos que utilizar listas blancas de métricas. Al final, logramos reducir el número de métricas de series temporales de unas 60.000 a 2000 por cada sitio de CE.
Finalmente, tras seguir escalando hasta superar los 3000 sitios CE y funcionar durante muchos días en producción, quedó claro que este enfoque no era escalable y que teníamos que replantearnos nuestra infraestructura de monitorización. Decidimos prescindir del Prometheus de nivel superior (en el control global) y dividir el Prometheus de cada RE en dos instancias independientes: una encargada de recopilar las métricas de los servicios locales y otra de federar las métricas de los CE. Ambas generan alertas y envían las métricas al almacenamiento central de Cortex. Cortex se utiliza como fuente para el análisis y la visualización, y no forma parte del flujo principal de alertas de monitorización. Probamos varias soluciones de métricas centralizadas, concretamente Thanos y M3db, y concluimos que Cortex era la que mejor se adaptaba a nuestras necesidades.
La siguiente captura de pantalla (Figura 7) muestra el consumo de memoria al recopilar métricas de prometheus-cef con 3000 endpoints. Lo interesante son los 29,7 GB de RAM consumidos, que en realidad no es tanto dada la escala del sistema. Se puede optimizar aún más dividiendo la recopilación entre varias instancias o trasladando la escritura remota en Cortex directamente al propio edge.
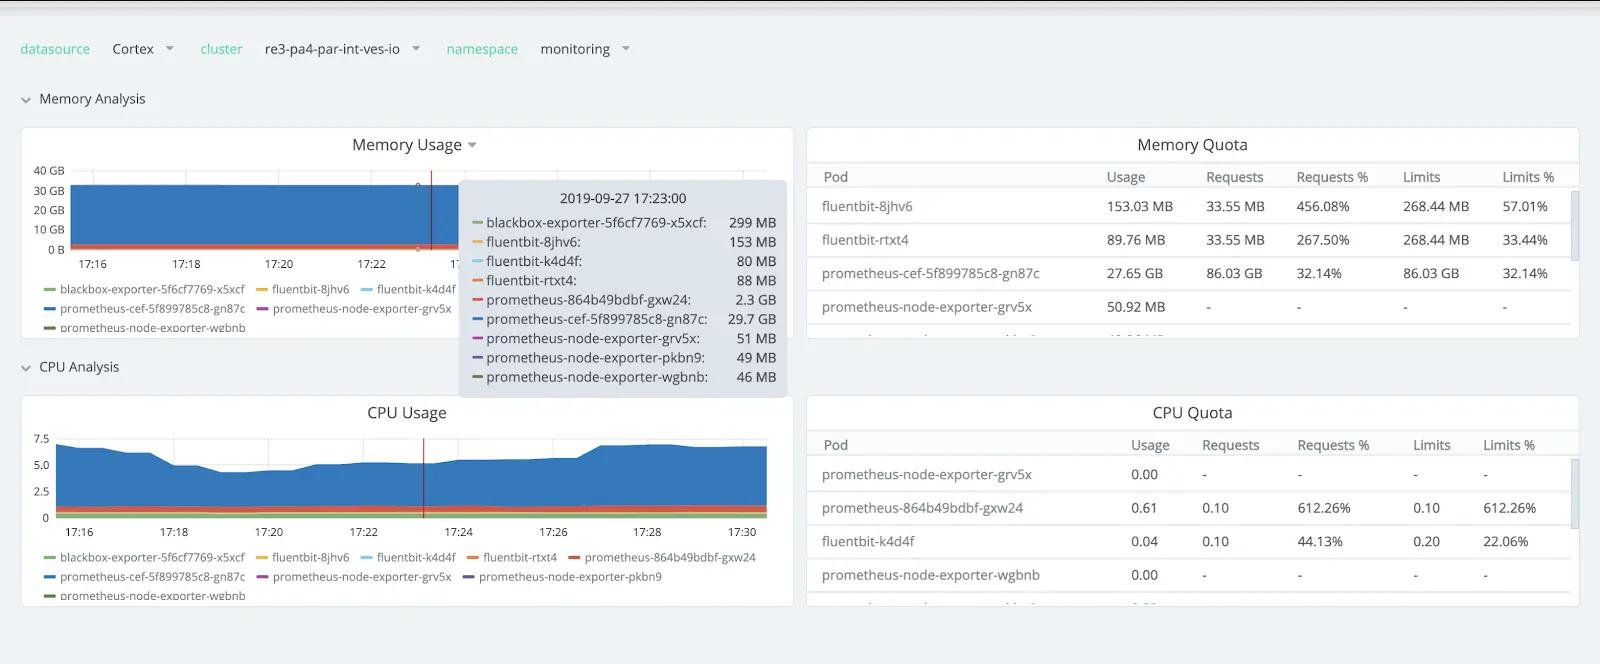
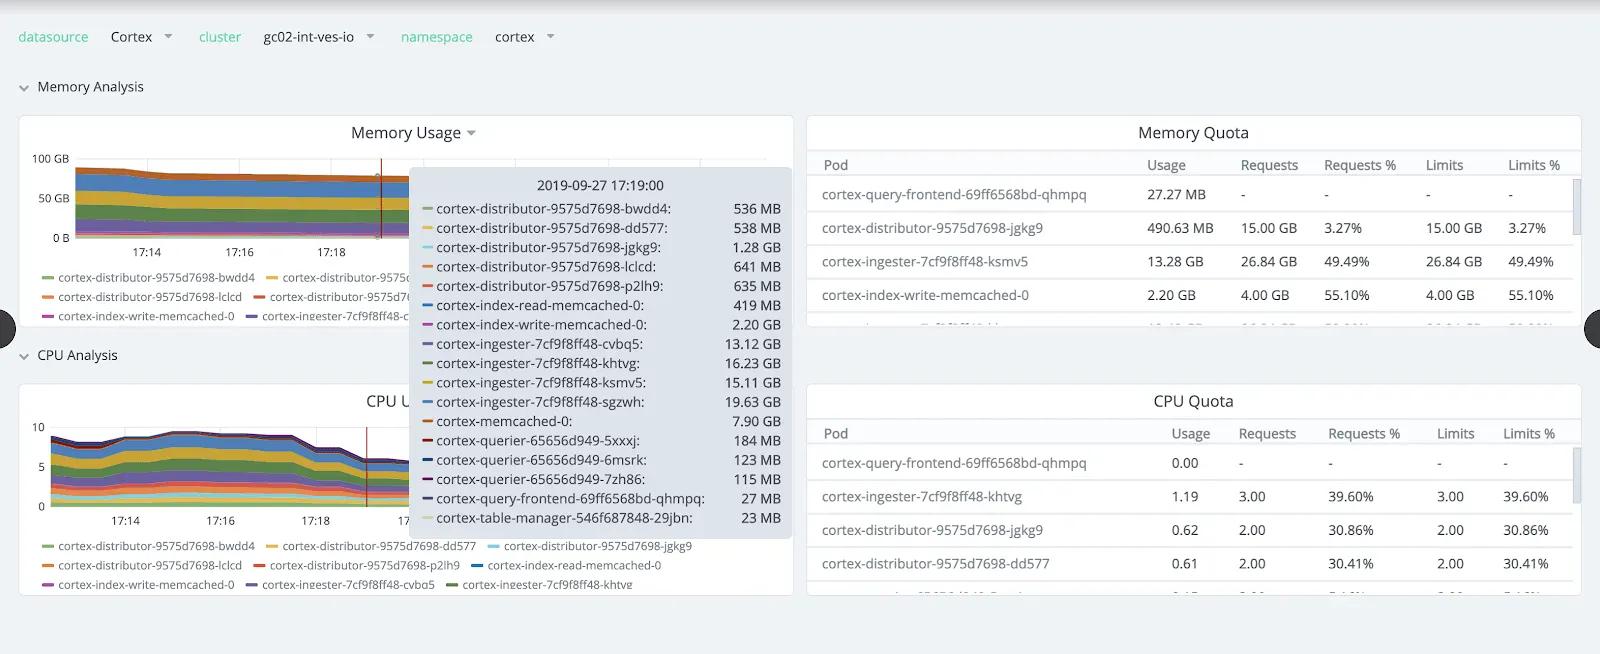
La siguiente captura de pantalla (Figura 8) muestra cuánta memoria y cuántos recursos de CPU necesitamos para los ingestors de Cortex (un máximo de 19 GB de RAM) y los distribuidores a esta escala. La mayor ventaja de Cortex es el escalado horizontal, que nos permite añadir más réplicas, a diferencia de Prometheus, donde el escalado debe realizarse verticalmente.
Para la infraestructura de registro en los CE y RE, utilizamos servicios de Fluentbit en cada nodo, que recopilan los eventos de registro de los servicios y del sistema y los reenvían a Fluentd en el RE conectado. Fluentd reenvía los datos a la instancia de ElasticSearch presente en el RE. Elastalert evalúa los datos de ElasticSearch y se configuran reglas para crear alertas de Alertmanager. Utilizamos nuestra integración personalizada de Elastalert con Alertmananger para generar alertas con las mismas etiquetas que genera Prometheus.
Los puntos clave de nuestra trayectoria de monitorización:
- Uso de nuevos filtros de federación de Prometheus para descartar métricas y etiquetas no utilizadas- Al principio teníamos unas 50.000 series temporales por CE, con una media de 15 etiquetas. Lo optimizamos hasta alcanzar una media de 2.000 por CE mediante sencillas listas blancas para los nombres de las métricas y listas negras para los nombres de las etiquetas
- Migración de la federación global de Prometheus a un clúster de Cortex- El Prometheus centralizado recopilaba datos de las instancias de Prometheus de todos los RE y CE. Al llegar a 1000 CE, la gestión del volumen de métricas se volvió insostenible. Actualmente tenemos Prometheus en cada RE (federado con las instancias de Prometheus de los CE conectados), con escritura remota (RW) en Cortex.
- Clústeres y registros de Elasticsearch- Arquitectura de registro descentralizada - Fluentbit, como recopilador en cada nodo, reenvía los registros a Fluentd (agregador) en el RE - ElasticSearch se implementa en cada RE y utiliza la búsqueda en clústeres remotos para consultar los registros desde una única instancia de Kibana
Resumen
Espero que este blog te ayude a comprender todo lo que hay que tener en cuenta para gestionar miles de ubicaciones perimetrales y clústeres desplegados por todo el mundo. Aunque hemos logrado cumplir y validar la mayoría de nuestros requisitos de diseño iniciales, todavía nos quedan muchas mejoras por delante…
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.